GPT-2 的一次前向:一条 768 维的向量,被改写 12 次,变成 50257 个分数
GPT-2 Small 的全部参数是 124,439,808 个。你输入一句话,它做一次前向,最后给你 50,257 个分数——你只需要其中一个。
中间发生的事,比想象中单调:一条 768 维的向量,被同样的结构改写 12 次,然后乘一个矩阵,摊成 50,257 个数。
本文只讲一件在别处很少被讲清的事:这条流水线里,什么是形状,什么是名字。因为“能在哪一步动手”这个问题的答案,全部由这两样东西决定——形状决定你能改什么,名字决定你的代码往哪插。
站内已经有两篇讲“看见”和“用库改”的文章:一篇是 Transformer Explainer,把这次前向画在浏览器里;一篇是 TransformerLens,用库去截获和改写。这篇讲第三种:不装任何可解释性库,用 25 行 torch 自己走一遍,顺便把库名翻译回模块路径。
一、分词:为什么这个实验必须用英文
GPT-2 的词汇表有 50,257 个记号,BPE 切出来的东西经常不符合直觉——visualization 是一个 token,empowers 却被切成 em + powers,而且第二个记号自带前导空格。
更要紧的是:它是字节级 BPE。这意味着任何 Unicode 都能被编码,但代价是中文基本没有进过它的词表。苹果有什么好处? 进去之后会碎成一串字节级记号,数量和你按词数猜的完全不是一回事。
所以本文的可跑实验用英文:
Apples are healthy because
→ ["Apple", "s", " are", " healthy", " because"]   # 大约 5 个记号
(具体切法随分词器版本略有出入,Apples 被拆成 Apple + s、每个词自带前导空格,这两点比较稳定。以你自己打印出来的结果为准。)
这不是崇洋。你在一个中文 prompt 上算出来的所有中间数字,都是“模型不认识这些字”时的数字——用它来演示“模型怎么理解苹果”,从一开始就跑偏了。真想看中文,请换一个中文词表训过的模型,别用 GPT-2。
二、Embedding:38.6M 个参数里,没有一维叫「水果」
Token ID 只是索引。模型查一张 $50257 \times 768$ 的表,把每个 ID 换成一个 768 维向量,再加上一张 $1024 \times 768$ 的位置表:
\[H_0 = E_{\text{tok}}(x) + E_{\text{pos}}(i)\]这张 token 表本身就有 38,597,376 个参数,占了整个模型的 31%。它和最后一层的输出矩阵是同一个矩阵(权重共享),所以 124M 里只算了一次,却用了两次。
有一个反复出现的误解值得当面拆掉:768 个维度里,没有任何一维单独表示“水果”或“营养”。数字不是被规定的,是被训练压出来的;语义是多个维度共同承载的,而且同一个维度在不同上下文里参与不同的概念——这正是后面要讲的特征叠加。
三、12 个 block:形状不变的那一段
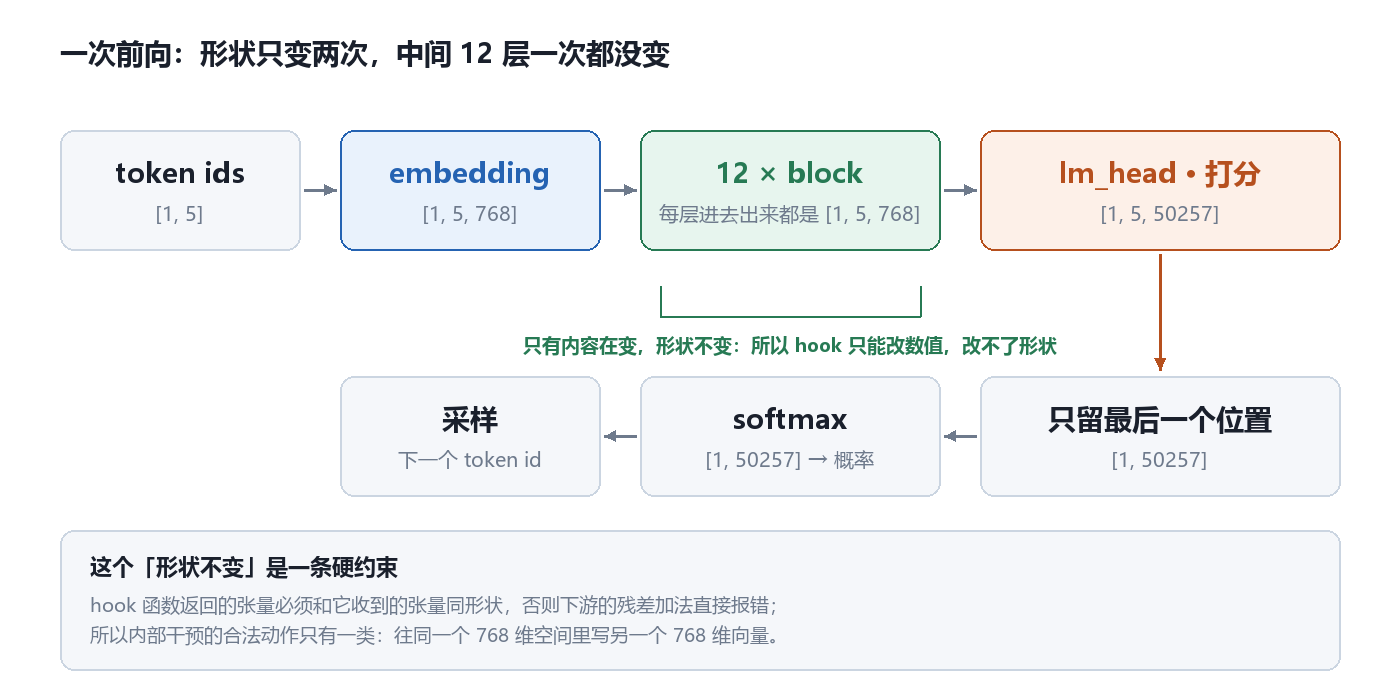
从 token ids 到分数,形状只变两次;中间 12 层,进和出都是 [1, 5, 768]。
GPT-2 的每一层是同一个模板:LayerNorm → Attention → 加残差 → LayerNorm → MLP → 加残差。写成式子(Pre-LN):
\[x \leftarrow x + \mathrm{Attn}(\mathrm{LN}(x)), \qquad x \leftarrow x + \mathrm{MLP}(\mathrm{LN}(x))\]注意残差是加法,不是覆盖:每层的输出被加进同一条向量里。这就是“残差流”这个名字的由来,也是所有干预的物理基础——你改的是这条流上的一次加法项,形状必须是 768,否则下游加不上。
参数量分布(按 GPT-2 small 的配置逐项算出来的):
| 部件 | 参数量 | 占比 |
|---|---|---|
| token embedding(50257 × 768) | 38,597,376 | 31.0% |
| position embedding(1024 × 768) | 786,432 | 0.6% |
| 12 个 block(含每层两个 LayerNorm) | 85,054,464 | 68.4% |
| ├ 每层 Attention | 2,362,368 | |
| └ 每层 MLP | 4,722,432 | |
| 末尾 LayerNorm | 1,536 | 0.001% |
| 合计 | 124,439,808 |
两个可以自己复核的比例:每层里 MLP 是 Attention 的两倍(4.72M 对 2.36M);整个模型的 68% 在 12 个 block 里,31% 在那一张查表里。大家盯着 Attention 看,但注意力只占全部参数的三分之一不到。
MLP 的中间维度是 3072,也就是 768 的 4 倍——这是 GPT-2 代码里的默认约定。换成 Llama-7B,那个数是 11008,同样是“隐藏维度的几倍”,只是倍数不同。这类数字记住量级就够,别记错对象。
四、Attention 的五步:这次只看形状
细节我在 Transformer Explainer 那篇里已经拆过(Q、K、V 怎么来、为什么除以 $\sqrt{d_k}$、遮罩为什么加在 softmax 之前),这里只补一件它没强调的事:形状怎么变。
768 维先被三个矩阵切成 Q、K、V,再拆成 12 个头 × 64 维(768 ÷ 12 = 64):
[1, 5, 768]  →  [1, 5, 2304]  →  [1, 12, 5, 64]   # Q, K, V 各一份
scores:  Q @ Kᵀ  →  [1, 12, 5, 5]                  # 5 个 token 两两相关
         ÷ 8(= √64),加因果遮罩,softmax
out:     scores @ V  →  [1, 12, 5, 64]  →  [1, 5, 768]
把某个头、某一行的权重单独拎出来,就是一张 5 个数、和为 1 的表。但如果这张表是“healthy”这一行,最后一列必须是 0:
| 当前处理位置 | Apple | s | are | healthy | because |
|---|---|---|---|---|---|
| healthy | 0.55 | 0.10 | 0.15 | 0.20 | 0.00 |
原因很硬:这是自回归模型,healthy 这一行看不到右边的 because。任何给出非零“未来权重”的示意图,画的都是编码器(BERT 那一类),不是 GPT。这一条经常被示意图画错,而它恰好是“能不能干预未来”的关键——遮罩决定了信息只能从左往右流。
五、输出:从 768 维到 50257 个分数
12 层走完,还有一个末尾 LayerNorm(Pre-LN 的代价,不补的话输出尺度不对)。然后乘上那个共享矩阵的转置:
\[\text{logits} = H_{12} W_{\text{tok}}^{\top}, \qquad [1, 5, 768] \times [768, 50257] \rightarrow [1, 5, 50257]\]到这里 5 个位置各有一份 50,257 维的分数,但生成下一个 token 只用最后一个位置。取 $\text{logits}[0, -1, :]$ 得 50,257 个数,softmax 之后才是概率。
分数不是概率,这句话有两个具体后果:一是绝对值没有意义,只有差值有意义(所以分析里常用 logit diff,而不是概率);二是 softmax 是单调的,所以“哪个 token 概率最高”和“哪个 token 分数最高”永远一致——采样策略改变的从来不是排序,是截断和随机性。
六、自回归:每个新 token 都要重走一遍
模型一次只生产一个 token。生成第二个 token 时,要把第一个 token 接回输入,再走一次完整的前向。
听起来是“每次都重算”,但实际不是:KV Cache 把前面每个位置、每一层的 K 和 V 存下来,第二次前向只喂 1 个 token,只算它自己的 Q、K、V,然后去和缓存里的 K、V 做注意力。所以第二个 token 计算量是 $O(n)$ 而不是 $O(n^2)$。
这也是为什么“模型内部状态”在推理时是个很具体的东西:它不在某个变量里,而在 12 层 × 每个头的一份 K/V 缓存里。你改它,等于改模型“记得什么”。
七、同一件事,三层名字
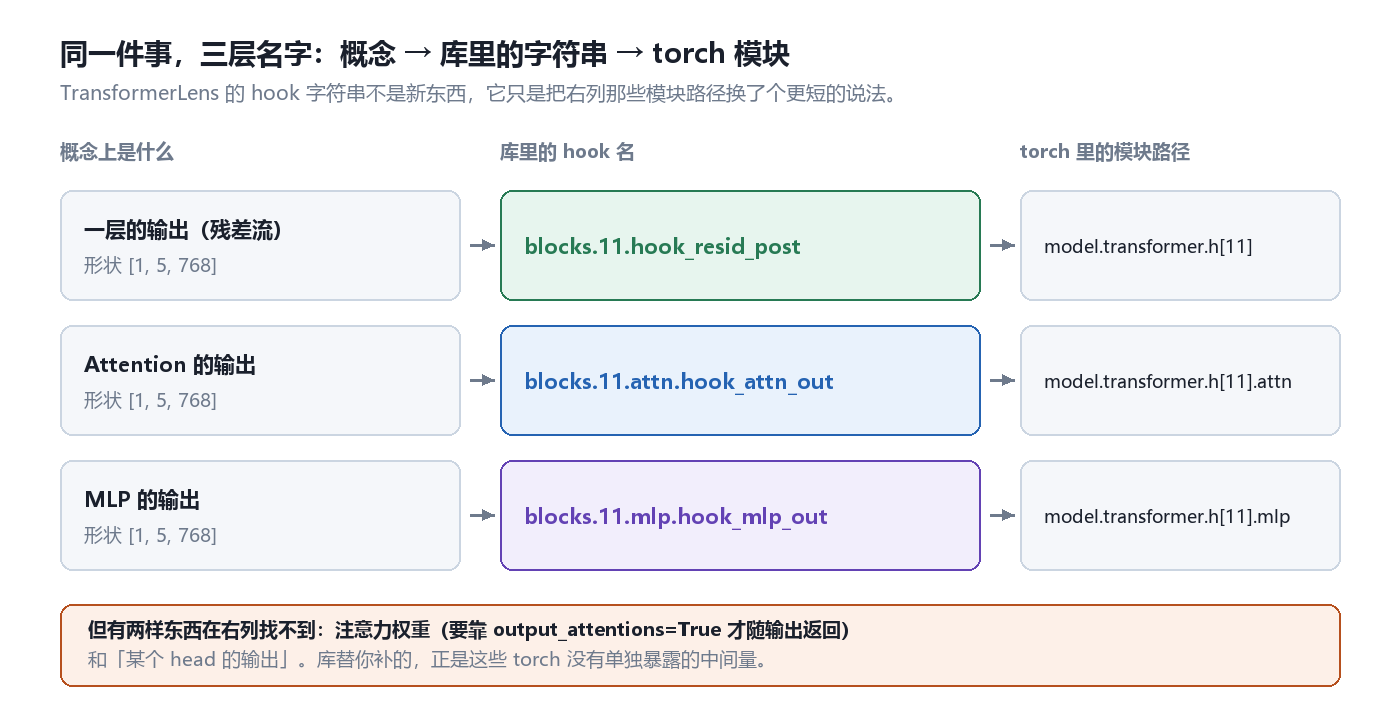
左列是论文里的概念,中列是库里的字符串,右列是 torch 里真能找到的模块。
TransformerLens 的 blocks.11.hook_resid_post 看起来很神秘,其实它就是一个位置加一个后缀:第 12 个 block(索引 11)的输出。
| 概念 | 库里的名字 | torch 模块 |
|---|---|---|
| 一层的输出 | blocks.11.hook_resid_post | model.transformer.h[11] |
| Attention 的输出 | blocks.11.attn.hook_attn_out | model.transformer.h[11].attn |
| MLP 的输出 | blocks.11.mlp.hook_mlp_out | model.transformer.h[11].mlp |
知道这张表,你就不需要库也能做同样的事:register_forward_hook 挂在右边那一列,做的正是中间那一列的事。
但右列并不完整。有几样东西 torch 不单独暴露:注意力权重要靠 output_attentions=True 才随输出返回,单个 head 的输出则根本没被单独返回过。库替你补的,恰恰是这些缺口——所以“库 = 模块路径 + 更细的切分”这个理解,比“库 = 一套魔法”准确得多。
八、25 行,自己走一遍
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM

tok = AutoTokenizer.from_pretrained("gpt2")
model = AutoModelForCausalLM.from_pretrained("gpt2").eval()   # eval 不能省,见下文

inputs = tok("Apples are healthy because", return_tensors="pt")
captured = {}

def grab(module, args, output):          # 只读:不返回,就不改变前向
    h = output[0] if isinstance(output, tuple) else output
    captured["h"] = h.detach()

handle = model.transformer.h[4].register_forward_hook(grab)   # h[4] = 第 5 个 block
with torch.no_grad():
    logits = model(**inputs).logits
handle.remove()

n = inputs["input_ids"].shape[1]
print(n)                     # 这条输入的 token 数
print(captured["h"].shape)   # [1, n, 768]
print(logits.shape)          # [1, n, 50257]
要真的动手,把 hook 改成“返回一个同形状的张量”,PyTorch 就会用返回值替换掉这一层的输出:
direction = torch.randn(1, 1, 768)       # 一个随机的 768 维方向

def steer(module, args, output):
    h = output[0] if isinstance(output, tuple) else output
    patched = h + 0.5 * direction        # 只改数值,不改形状
    if isinstance(output, tuple):
        return (patched,) + output[1:]   # tuple 要原样还原结构
    return patched

model.transformer.h[4].register_forward_hook(steer)
四个会直接毁掉实验的坑,按出现频率排:
- 忘了
.eval()。GPT-2 的配置里attn_pdrop、embd_pdrop、resid_pdrop都是 0.1,训练态下每层随机丢掉 10% 的激活。你的读数会每次都不同,而且不同得没有规律。 - 索引差一。
h[4]是第 5 个 block。说“第 5 层”时,最好同时说索引,否则复现时一定错一层。 - 返回值和输入形状/类型不匹配。残差是加法,形状不对就报错;模块输出是 tuple 时必须还原成 tuple,只返回张量会让下游解包失败。
- 拿中文验英文结论。见第一节。
九、随机方向也会改变输出
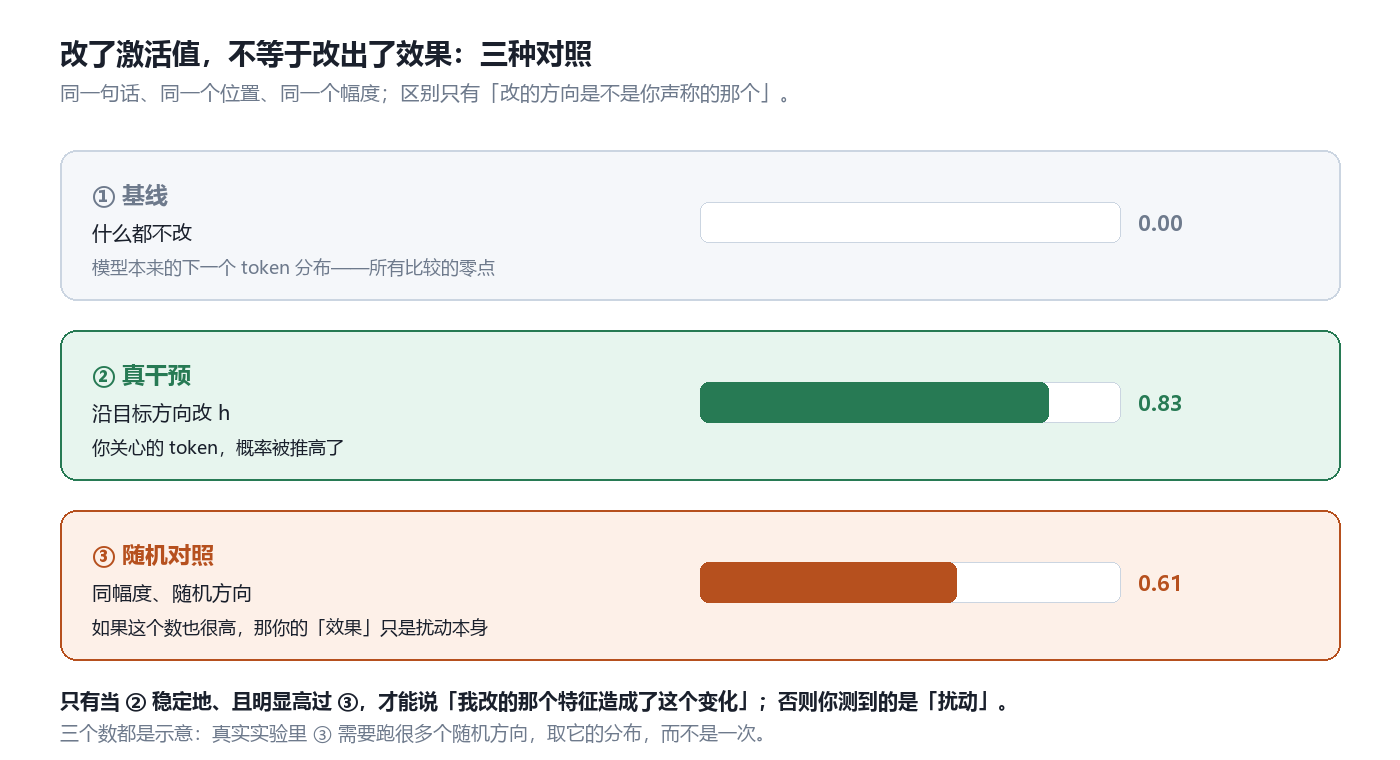
同一句话、同一个位置、同一个幅度;区别只有「改的方向是不是你声称的那个」。
这是这类实验里最容易自欺的一步。你改了一个向量,输出变了,然后写“这证明该位置编码了 X”。但输出总在变——随便加一个同幅度的随机方向,输出也会变。
所以最小可信协议是三条:
- 比什么:比 logit diff,不是比字符串。取目标 token 与对照 token 的分数差,它是一个连续的、可重复的数。
- 跟谁比:跑 $N$ 个随机方向(同范数、同位置),得到扰动本身的分布。真实方向的效果要落在非常靠外的位置才算数(经验上要跑几十次,不是一次)。
- 换条件还成立吗:换一个 prompt、换一层、换一个 token 位置。只在单个输入上成立的效果,通常是那条输入的特性,不是模型的结构。
这三条都不需要理解模型,只需要会做对照实验。恰恰因为如此,它们比“看起来解释得通”更可靠。
十、我的判断
这类“打开黑盒”的活,真正稀缺的不是工具,是记账意识:知道每一站的形状、参数从哪来、你的数字和别人的数字是不是同一个口径。
用这套记账,有一个十行的实验我建议每个刚上手的人都做一遍:把第 $l$ 层残差流的输出直接乘上那个共享矩阵,得到“这一层以为的下一个 token”,看 they(because they … 的后继)的概率从第几层开始爬升。
out = model(**inputs, output_hidden_states=True)
W = model.transformer.wte.weight          # [50257, 768],和 lm_head 共享
for layer in [0, 3, 6, 9, 11]:
    h = out.hidden_states[layer + 1][0, -1, :]   # [0] 是 embedding,[1] 才是第 1 层之后
    probs = torch.softmax(model.transformer.ln_f(h) @ W.T, dim=-1)
    print(layer, tok.decode(probs.topk(3).indices.tolist()))
如果 they 在中层就稳定排进前列,说明这个信息那时已经可用;如果到第 11 层才冒出来,说明它是最后才被组装出来的。这个“第几层”就是可干预性的第一个真实坐标——TransformerLens 里叫 Logit Lens,但你不装库也能算。
再往后才是干预:找到层,加一个方向,做三种对照,看效果是否稳定。这条路径的顺序不能颠倒——先能复现一个读数,再谈改一个读数。
回到那 124,439,808 个参数。它们不是“知识”存进去的容器,是一台把 768 维向量反复改写的机器;所谓“理解模型内部”,目前能稳定做到的,是看清这台机器每一步的形状和数值,并且有办法证明自己改动了哪一步。
项目与资料
- GPT-2 small 配置(768 / 12 层 / 12 头 / 1024 上下文 / 50257 词表):本文所有形状与参数量的来源
- Transformer Explainer:把这次前向画在浏览器里,配 本站文章
- TransformerLens:把 hook 变成字符串 API,配 本站文章
- NNsight(本站文章)与 pyvene(本站文章):把干预写进前向的两种方式
- SAELens:把激活换成特征,配 本站文章
数字来源:层数、头数、隐藏维度、词表大小、上下文长度、dropout 概率与激活函数取自 GPT-2 small 的 config.json;参数量表按该配置逐项相乘相加得出(token embedding 50257×768、位置表 1024×768、每层 Attention 2,362,368、每层 MLP 4,722,432、末尾 LayerNorm 1,536),合计 124,439,808,与公开的“124M”一致;注意力那一行权重之和为 1,遮罩位置为 0,是自回归模型的结构约束。第九节三个对照数字是示意值,不是实测。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- Blender Kiln:AI 建模缺的不是生成能力,是交付前的度量
- CineCode:每一帧都是时间的纯函数,所以电影可以被检查
- OhMyGame:AI 生成游戏不难,难的是让它自己发现游戏跑不起来
- SAELens:重建得越准,特征越不一定是真的
- TokenEconomizer:Coding Agent 的成本按仓库累积,不按任务计价
- Transformer Explainer:把 GPT-2 塞进浏览器,让模型边算边解释自己
- Boubou:本地语音 AI 缺的不是模型,是一层能借给全屋的运行时
- Hy-MT2:把翻译拆成语言家族分头训练,再蒸馏回一个模型
- NNsight:把干预写进前向传播,让同一段代码在 405B 模型上跑
- Safetensors:用 8 个字节和一段 JSON,重新设计大模型的权重文件