STE80 Humanizer:改写不难,改完事实还在才难
916 star。26 条 AI 特征。S1 到 S15 条结构规则。
STE80 Humanizer 是一个 Agent Skill:装进 Claude Code / Codex / Cursor,把 AI 写出来的技术文档改成更短的句子、更直的表述。2026-11-09 建库,十天 916 star,MIT,skills.sh 上有安装量徽章。
介绍它的文章通常落到「把写作质量拆成可执行规则」这个结论。我觉得那还不是它最特别的地方。仓库里 evals/ 那几行结果才是:
当提示里点名 ASD-STE100 时,基础模型本来就能把风格做对大半。加了 skill 之后的差别,主要在保真。
同一段 LinkedIn 改写,不带 skill 的那次编了一句引语、把 40+ customers 写成 40-odd;带 skill 的那次每个事实都保住了。README rewrite 那组,它留住了 you may need to,还标出了原文里的一处矛盾。
所以这篇的论点是:
风格不用它教。它的活是不让改写改坏事实。
一、先说来源:这不是项目自创的方法
草稿把 STE80 写成了项目的方法论。实际上「STE80」是 Karpathy 在 2026-10-02 那条推文里的说法,项目引用得很清楚:
Ask your LLM to explain something in ASD-STE100 … 有时我会把它软化一点,比如要求「到 ASD-STE100 的 80%」,因为规范相当严格。
那条推文的语境值得注意:LLM 干得越多,人花在读懂它产出上的时间越久。他的结论是工作会往「监督与理解」上移,而清晰的输出是瓶颈,写作是第一步。
项目做的是把这句话拆成两半来执行:第 1 遍借用 blader/humanizer 的 26 条 AI 特征目录(MIT,致谢写在 THIRD_PARTY_NOTICES.md),第 2 遍用 Karpathy 的「80% STE」重建句子。
二、真正的 STE 长什么样
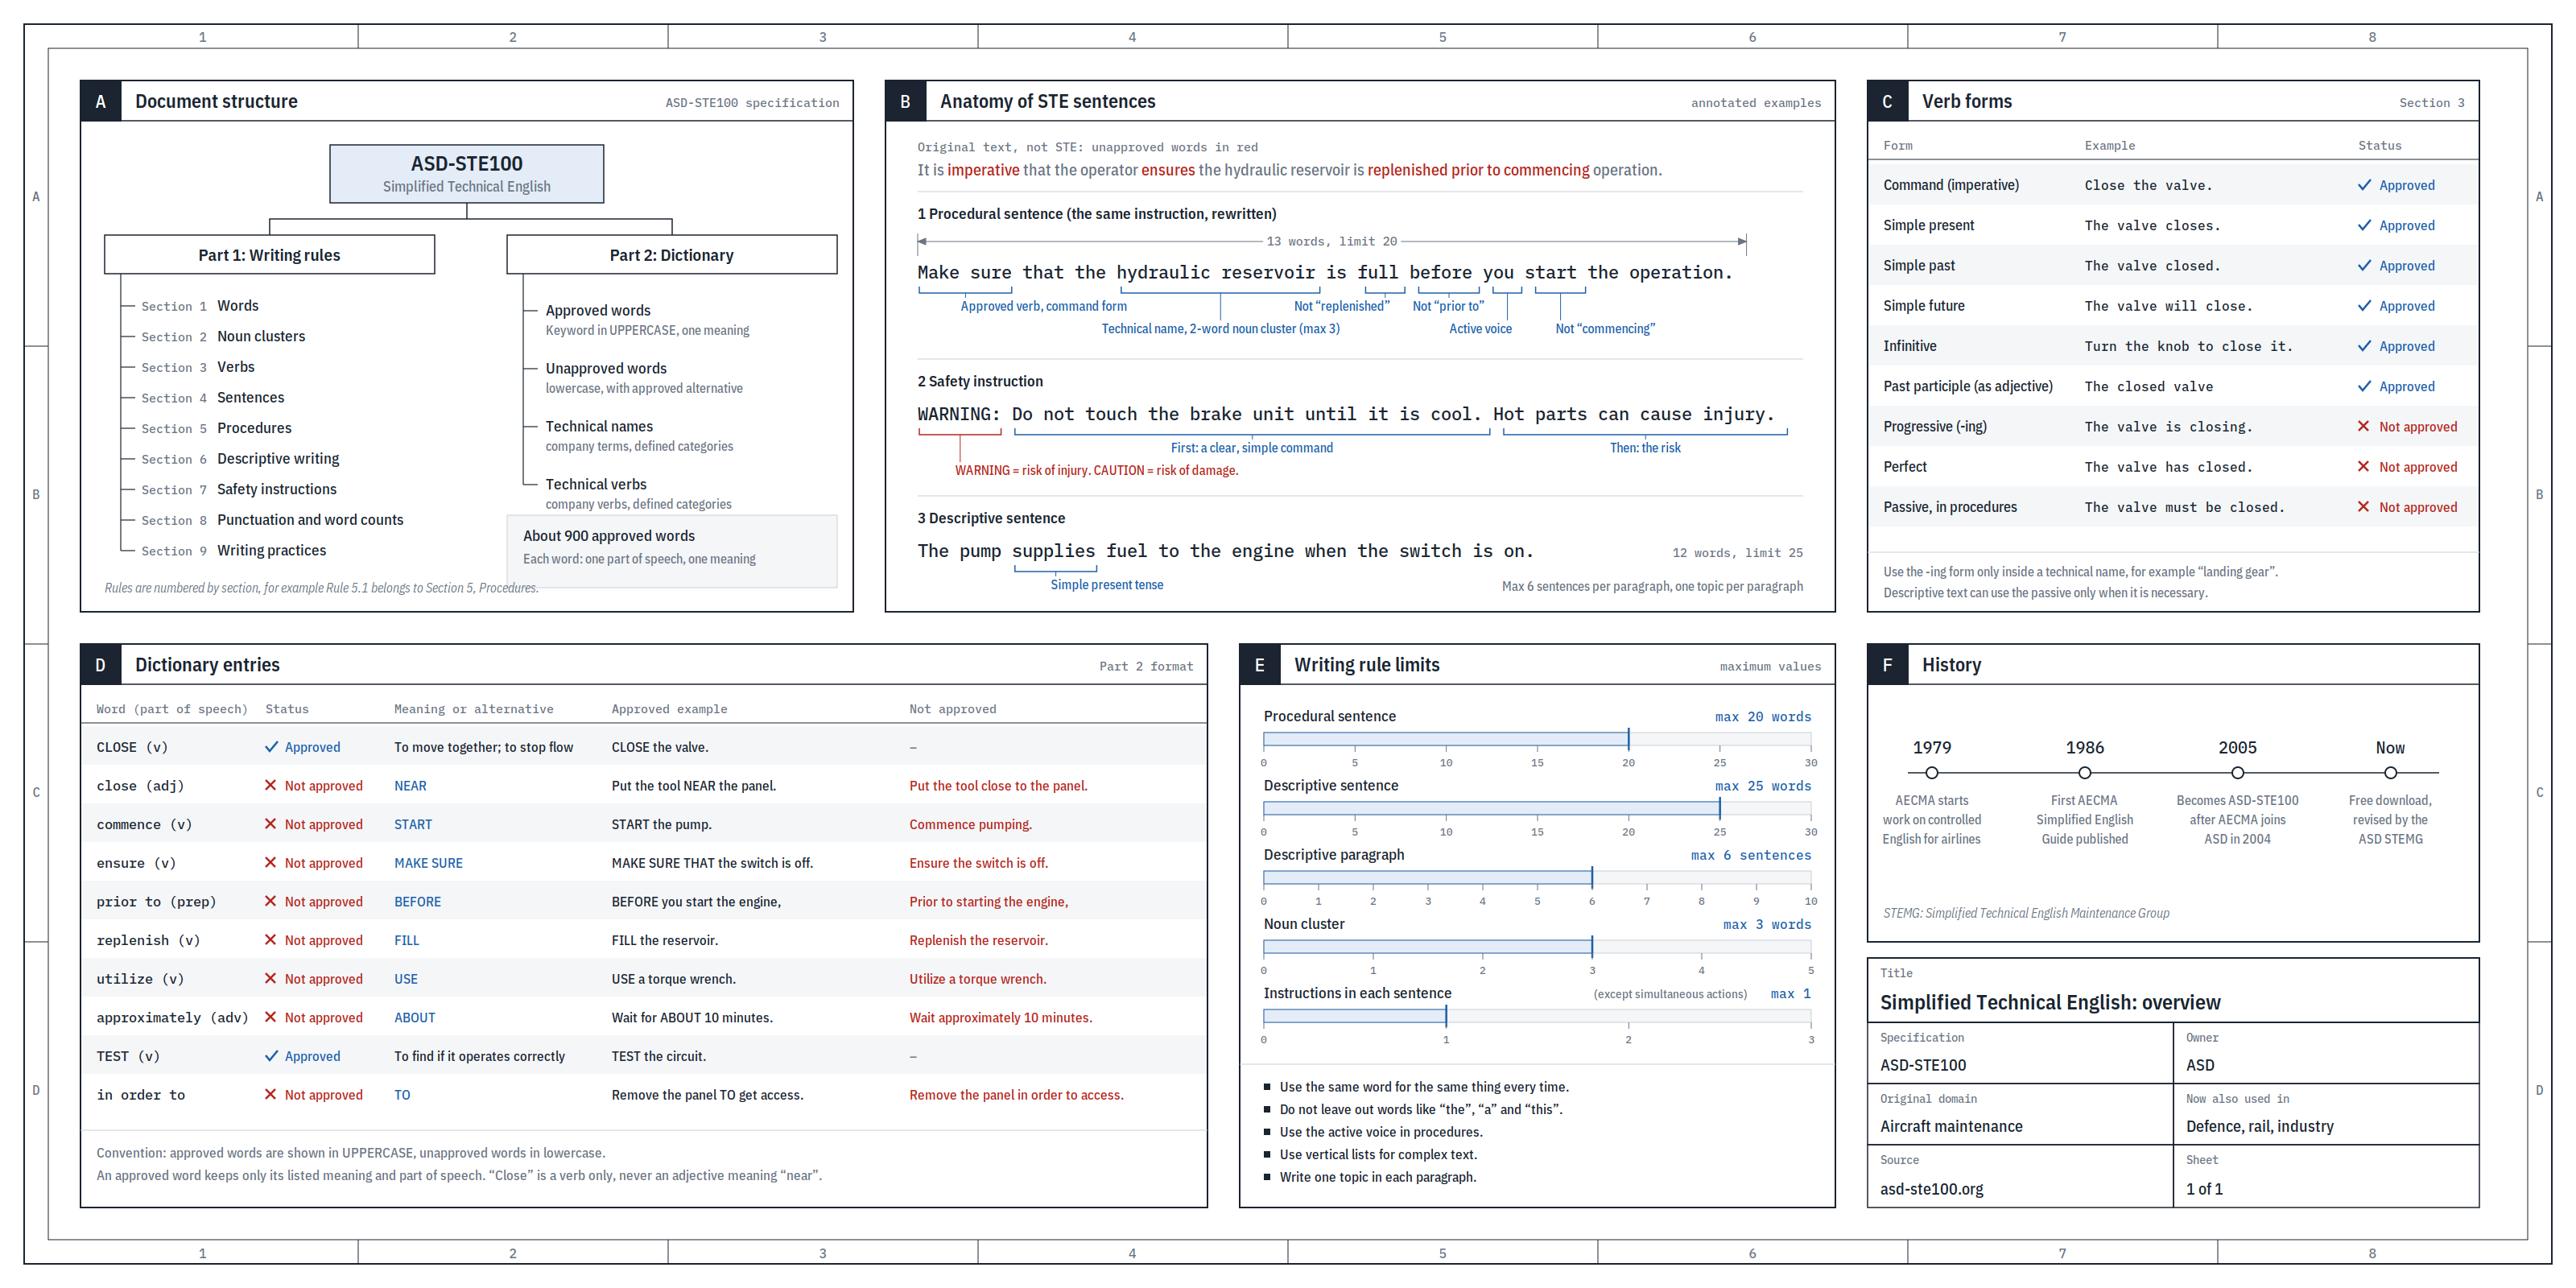
Karpathy 那条推文里的 STE 速览图,仓库放在 assets/ste100-overview.png。点开看大图。
这张图值得细看,因为它把「简化技术英语」拆成六个面板:文档结构、句子解剖、动词形式、词典条目、规则上限、历史。几个具体数字:
- 一句操作说明 20 词,一句描述 25 词;
- 一段最多 6 句,一个话题;
- 一个词只有一个意思,受控词典约 900 词;
- 名词堆叠最多 3 个词。
还有一处细节,能看出这个仓库的态度:README 在图注里主动更正了这张图——词典面板 D 有错:在 ASD-STE100 Issue 9 里,approximately 是批准词,TEST 只批准作名词(不作动词),而且根本没有 in order to 这一条。配图是别人的,错误照标。这在这个圈子里不常见。
三、为什么要两遍
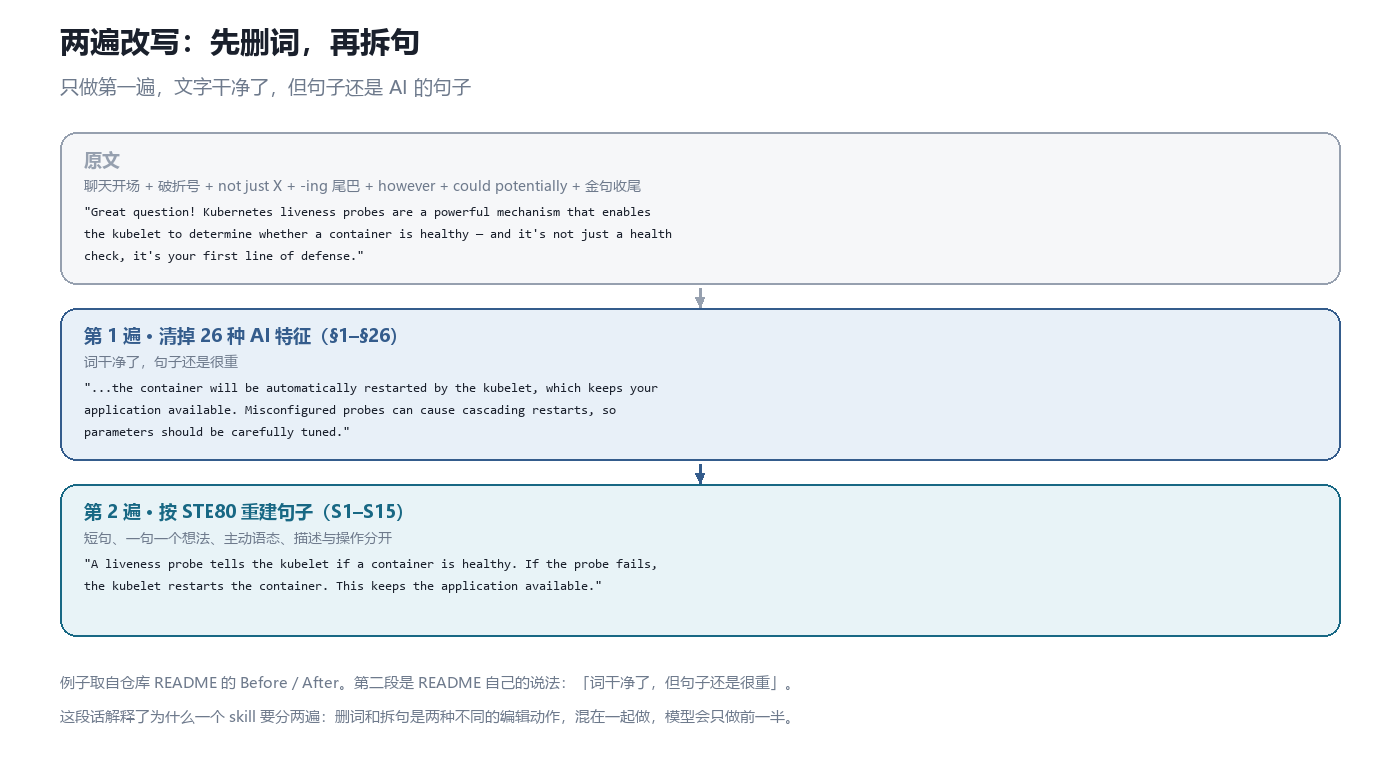
只做第一遍,字是干净了,句子还是 AI 的句子。
README 拿同一个例子分三步展示:
- 原文:聊天开场 + 破折号 +
not just X, it's Y+-ing尾巴 +however+could potentially+ 金句收尾; - 第 1 遍之后:这些词全没了,但剩下的是
the container will be automatically restarted by the kubelet, which keeps your application available——被动、从句、两个想法; - 第 2 遍之后:三句短句,一句一个想法,主动语态。
这就是「两遍」的理由:删词和拆句是两种不同的编辑动作。 混在一起让模型做,它会做便宜的那一半。大多数 humanizer 停在第 1 遍,所以读起来仍然像 AI——不是词的问题,是结构的问题。
四、26 条「AI 味」分六组
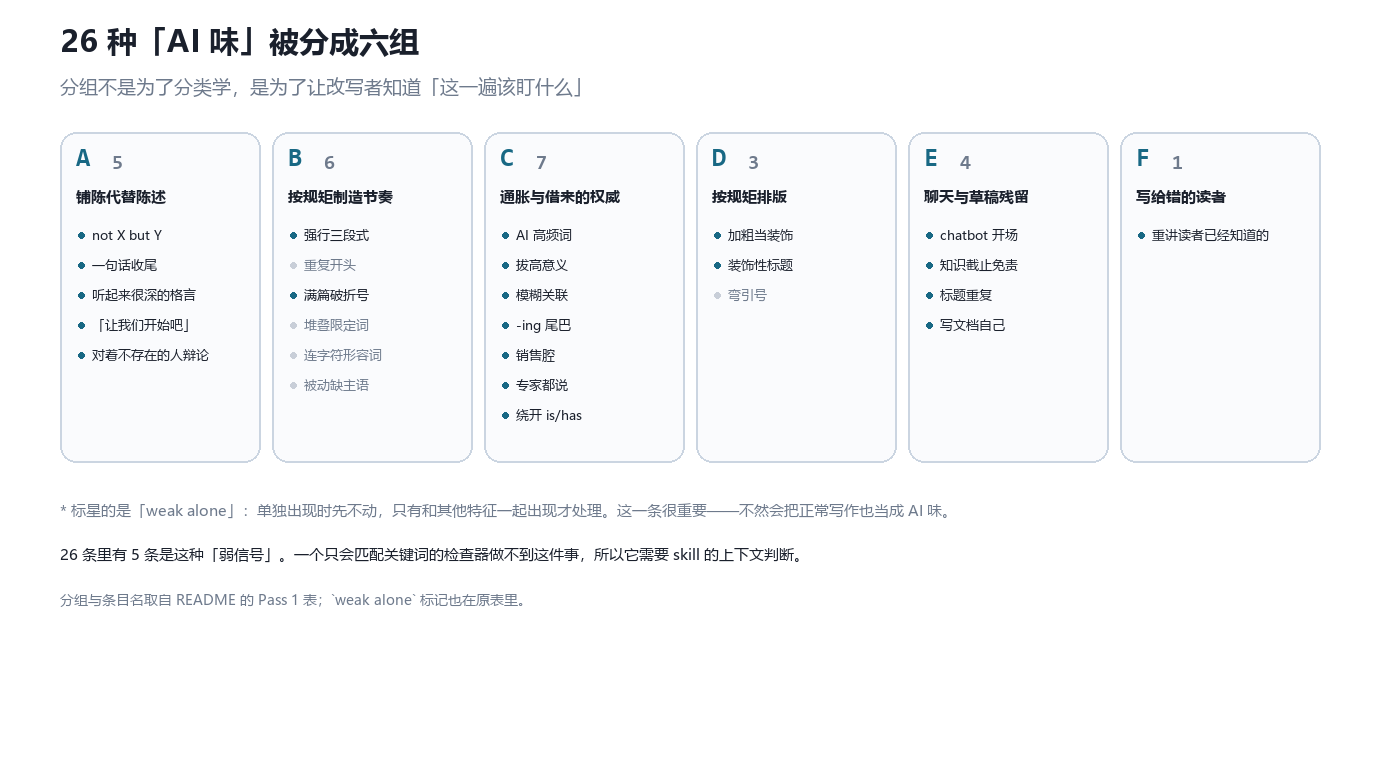
铺陈、制造节奏、通胀与借权威、排版、聊天残留、写错读者——六组 26 条。
分组的意义在于:改写时每一组对应一种「该盯什么」。
- A 铺陈代替陈述:
not X but Y、一句话金句收尾、「让我们开始吧」、对着不存在的人辩论; - B 按规矩制造节奏:强行三段式、满篇破折号、堆叠限定词;
- C 通胀与借来的权威:
revolutionary、marks a pivotal moment、experts agree、-ing尾巴; - D 按规矩排版:加粗当装饰、装饰性标题、弯引号;
- E 草稿残留:chatbot 开场、知识截止免责、标题重复;
- F 写给错的读者:重讲读者已经知道的东西。
其中 5 条标着 weak alone——单独出现时先不动,只有和其他特征一起出现才处理。这一条比想象中重要:It reads... It checks... 这种重复开头,正常人也会写;不加限制,检查器会把好文字也判成 AI。
五、S1–S15,和「80%」到底放宽了什么
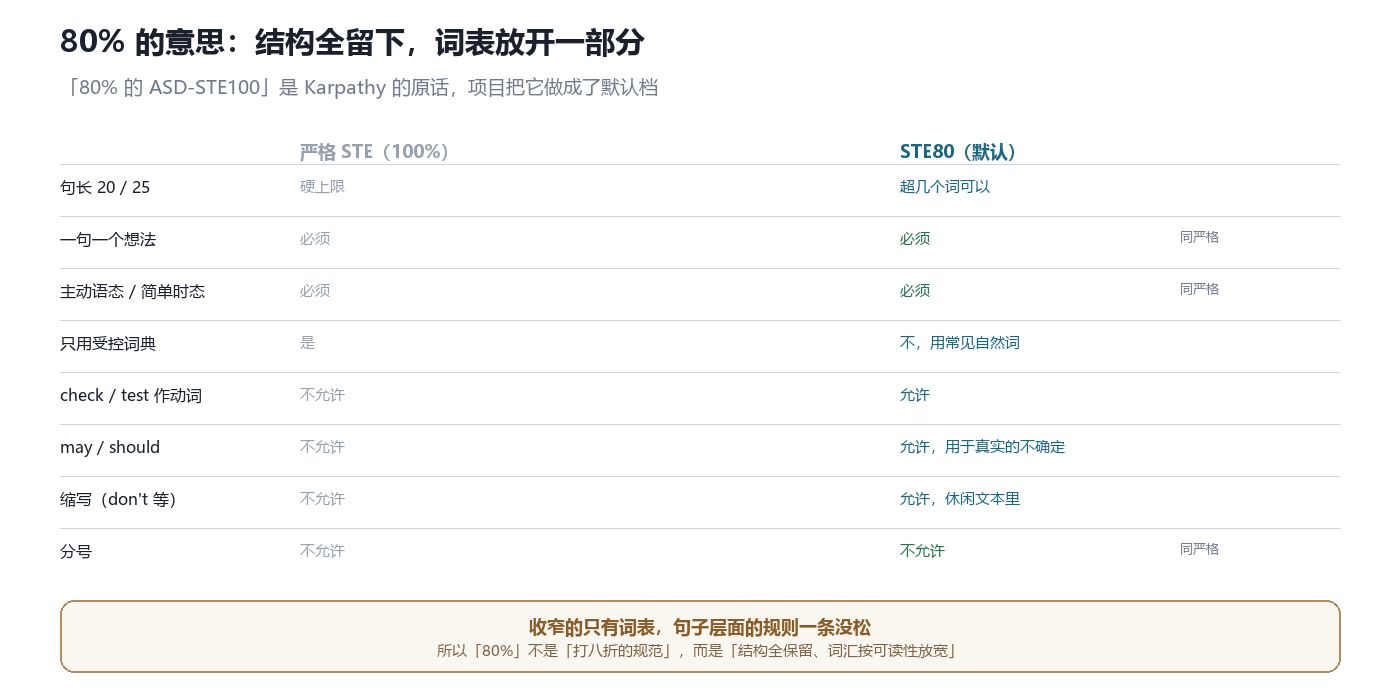
收窄的只有词表,句子层面的规则一条没松。
S1 到 S15 里,最核心的几条是:一句一个想法、句长上限、条件放前面、不省冠词、步骤用列表、主动语态、简单时态、用动词不用名词化、情态要诚实(can / must / will)、一个东西一个词、不要名词堆叠、一段一个话题、操作与描述分开、不用分号。
而「80%」放宽的是这些:
| 规则 | 100%(Strict) | 80%(默认) |
|---|---|---|
| 句长 20 / 25 | 硬上限 | 超几个词可以 |
| 只用受控词典 | 是 | 不,用常见自然词 |
| check / test | 只作名词 | 可作动词 |
| may / should | 不允许 | 允许,用于真实的不确定 |
| 缩写 | 不允许 | 允许,休闲文本里 |
结构一条没松,松的是词表。 所以「80%」不是「打八折的规范」,而是「结构全保留、词汇按可读性放宽」——这也解释了为什么它读起来不像机器翻译。
三种模式对应三种文档:Humanize(默认,第 1 遍全做 + 第 2 遍 80%)、Light(只清明显的 AI 痕迹)、Strict STE(操作手册与安全说明,100%)。
六、检查器,和它看不到的东西
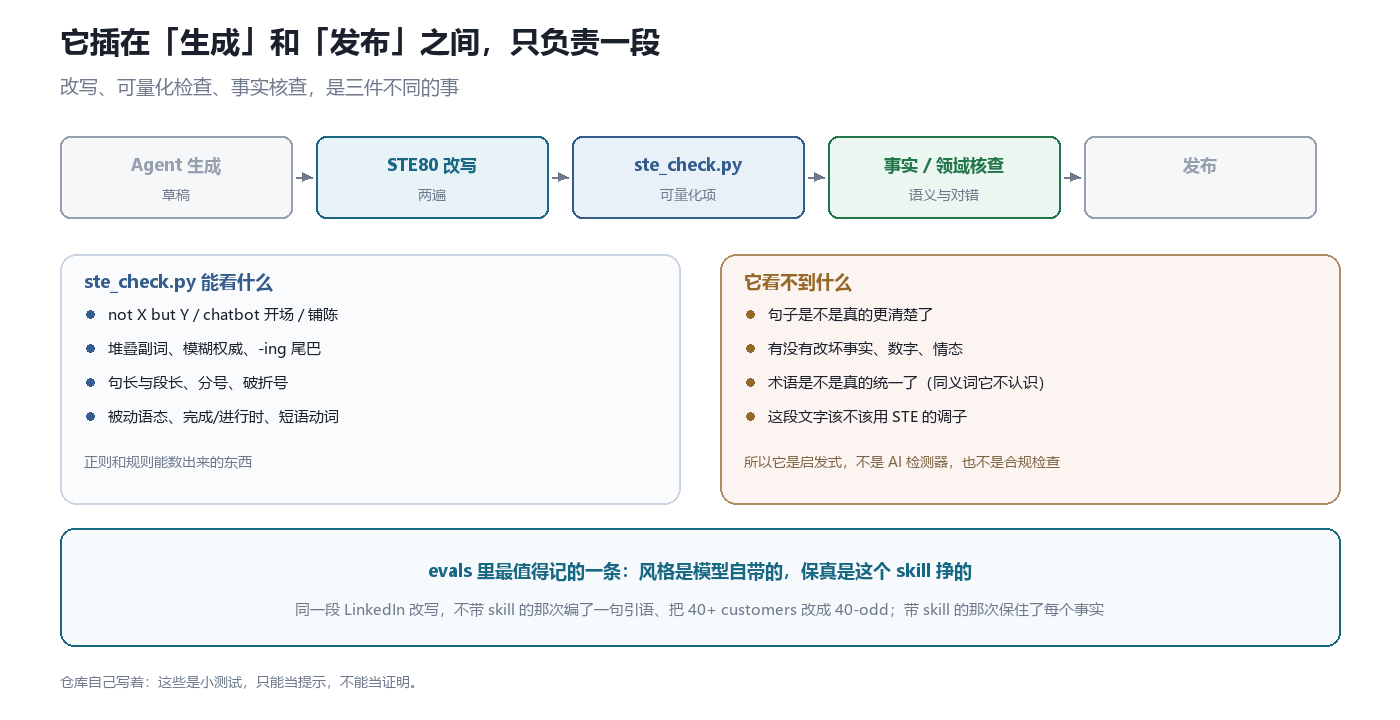
ste_check.py 只能数得出来的东西;对错和清楚与否,它管不了。
scripts/ste_check.py 无第三方依赖,支持 --strict 和标准输入:
python scripts/ste_check.py README.md
python scripts/ste_check.py --strict docs/runbook.md
cat draft.txt | python scripts/ste_check.py -
它能查:not X but Y、chatbot 开场、堆叠副词、模糊权威、-ing 尾巴、句长段长、分号破折号、被动语态、完成/进行时、短语动词。
它查不了:句子是不是真的更清楚了、有没有改坏数字和情态、术语是不是真统一(同义词它不认识)、这段文字该不该用 STE 的调子。
它是一个启发式检查器,不是 AI 检测器,也不是合规检查。这句话在文档里写了两遍,值得照抄。
七、那个反直觉的发现
evals/ 里四个 case,按 claude plugin eval 的格式写,运行方式是 claude plugin eval . --allow-tools Write,Edit,Bash。
结论分两半:
- 风格:当提示里点名 ASD-STE100 时,基础模型本来就能做对大半。skill 在这件事上的增量不大。
- 保真:不带 skill 的那次编了一句引语、把
40+ customers改成40-odd;带 skill 的那次每个事实都在,还标出了原文的一处矛盾。
这解释了 skill 里为什么反复强调 fidelity first:保留每个事实、may 还是 may、40+ 还是 40+、不加任何新信息、发现矛盾就标出来而不是自己改。
也解释了它为什么要求按编号报告改动——输出里会写 §1, §8, S2,你可以回到 references/ai-tells.md 和 references/ste80-rules.md 里逐条查:这句话为什么被改。
八、局限
- STE 是英语标准。 中文可以套用「一句一个想法、主动语态、一段一话题」,但受控词典那一层不适用。仓库自己也这么写。
- 「STE 风格」不是「STE 合规」。 合规要用官方词典、受过训练的写手和评审。项目不包含规范正文和词典,
ASD-STE100是 ASD 的商标,项目声明与 ASD 无关联。 - 测试很小。 四个 case,作者自己写着「只能当提示,不能当证明」。916 star 不能替代复现。
- 短句不是永远更好。 数学推导、因果关系链、法律条文,长句有时是必要的。仓库的说法是「小说、演讲、品牌文案只做第 1 遍」。
- 合规检查缺位。 linter 是启发式,误报和漏报都会有;要真做合规,得另找工具和评审人。
九、我的判断
如果把这类项目当「去 AI 味工具」看,会低估它,也会高估它。
低估的是规则体系:26 条特征分六组、5 条标 weak alone、15 条结构规则、每一条都有 80% / Strict 两档、输出按编号可回溯。这套东西的可维护性远高于一段「请写得自然一点」的提示词。
高估的是它的边界:它能让你写得更像人,但不能让你写对。evals 里最有价值的那条恰恰在说这个——模型改写时最危险的动作不是保留 AI 味,而是顺手把 40+ 变成 40-odd、把没有的引语补上。改写越流畅,这种损伤越难被发现。
所以它真正补的是一个很窄但很要命的缺口:改写时的保真契约。不是「写得更好」,是「别写坏」。
顺带说一句自我拆台的话:写这篇的时候我没有跑它。跑一遍的话,我这些破折号、「不是 X 而是 Y」、和结尾的金句,大概有一半会被它划掉。这也是我对它的保留——它标得准,但标完之后要不要改,仍然是你的事。
项目与资料
- 仓库:Dodaios/ste80-humanizer(MIT)
- 安装:
npx skills add Dodaios/ste80-humanizer(--global --agent claude-code|codex|cursor|'*') - 规则:references/ai-tells.md · references/ste80-rules.md · references/strict-mode.md
- 原始出处:Karpathy 2026-10-02 的X 推文;ASD-STE100 Issue 9
数据来源:star / fork / 建库时间 / 许可取自 GitHub REST API(2026-11-19);26 条特征、S1–S15、80% 与 Strict 的差异、evals 的结论、检查器能力与局限均取自仓库 README;STE 速览图取自仓库 assets/ste100-overview.png,图注里的词典勘误也是 README 原文。第一遍的规则目录来自 blader/humanizer(MIT),项目已在 THIRD_PARTY_NOTICES.md 致谢。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- StemStudio:给 AI 的不是代码,是能被检查的命令
- Blender Skills:能不能建出来不难,能不能过检查才难
- AnyCrawl:LLM-ready 不是模型给的,是默认值给的
- Cheetah:常驻内存不该由模型大小决定
- AI Filmmaking Camera Control:让模型只抄镜头,不抄人
- 认知博弈:形式化、求解与可辨识性综述
- 麦田(Maitian):平台改版那天,不该让每个用户升级一次
- The Software Engineering Handbook:把工程判断写成一份自由度账本
- Hypit:你编辑的是词,秒是编译出来的
- Omni LoRA:一个 671 MB 的修正,要背两个任务