NNsight:把干预写进前向传播,让同一段代码在 405B 模型上跑
给 GPT-2 一句 The Eiffel Tower is in the city of,它接 ` Paris`。这件事我们已经习以为常,但如果追问一句「第 6 层的隐藏状态长什么样、把它清零会怎样」,绝大多数人手上是空的——只有一个输入字符串和一个输出字符串。
同一天写的 TransformerLens 那篇讲的是这套观察工具的「零件目录」:hook 怎么命名、DLA 怎么算、patching 怎么做。这篇讲另一件事——同一个想法(把实验代码插到 forward 中间执行)可以有三种实现方式,而选哪一种,决定了你的实验能不能被打包、复制、寄到别人的 GPU 上跑。
NNsight 选的是第三条路:延迟执行。它带来一个很直观的编码体验,也带来一批完全不报错的坑。
一、先看它长什么样
from nnsight import TransformersModel

model = TransformersModel("openai-community/gpt2", dispatch=True)

with model.trace("The Eiffel Tower is in the city of"):
    model.transformer.h[0].output[:] = 0            # 写:清零第 0 层输出
    hidden = model.transformer.h[6].output.save()   # 读:第 6 层隐藏状态

print(hidden.shape)   # torch.Size([1, 10, 768])
没有 register_forward_hook,没有改模型源码,没有中途 print 调试。with 块里的代码按前向传播的顺序书写,读到的就是那一刻真实的张量,写进去的值会被接回计算图继续往下算。
关键在最后一句:这个 with 块并不是「现在就执行」的。 它是被捕获、编译、然后和模型的 forward 交错执行的。所有反常的行为、所有优雅的能力,都从这一个事实长出来。
二、它解决的是一个工程问题,不是算法问题
PyTorch 自己就有 hook。register_forward_hook 能拿到任意模块的输入输出,也能改。所以 NNsight 的存在理由不是「hook 做不到」,而是 hook 做不到下面三件事:
1. 组合。 一个 hook 是一个脱离上下文的回调函数,它的作用域属于它自己。想表达「读第 5 层、用它改第 8 层、再看最终 logits」,你得在回调之间维护闭包和可变状态,代码顺序和实际执行顺序是反的。写得越复杂,越像在调试事件驱动的 UI。
2. 模块内部。 hook 只能看到模块边界。attention 里 q @ k.T 得到的分数矩阵、softmax 之前的 logits、融合算子内部的中间量,hook 一律看不见——除非你去改模型源码。
3. 可传输。 一个 hook 是绑定在某个进程里的 Python 闭包,它没法被打包发给另一台机器。而大模型内部研究真正的瓶颈恰恰在这里:能读内部状态的模型,往往是你本地跑不动的那些。
NNsight 的论文(arXiv:2407.14561,2024 年,v4 更新于 2025 年 4 月)把第三条做成了架构核心,起名叫 intervention graph:把「实验」表达成一张可以存成 JSON、可以版本管理、可以序列化传输的图,而不是一段必须和模型同处一个进程的代码。
三种实现路径可以这样对照:
| 路径 | 代表 | 代价 |
|---|---|---|
| 重写模型结构,内置访问点 | TransformerLens 的 HookedTransformer、pyvene、baukit | 需要权重转换与架构适配,只覆盖支持的家族 |
| 注册回调,在回调里读写 | 原生 PyTorch hooks | 组合性差,只能看模块边界,无法远程 |
| 捕获代码 + 延迟执行 | NNsight | 依赖源码捕获,有一批隐式规则 |
论文里还有一个数字值得记住:他们统计了 184 篇可解释性论文,发现 2023 年 2 月之后仍有 60.6% 的工作在 MMLU 低于 40% 的模型上做研究——而开放权重模型早已远超这个水平。研究者不是不想研究大模型,是研究不起。远程执行要解决的正是这个落差,而它成立的前提,是实验本身能被打包。
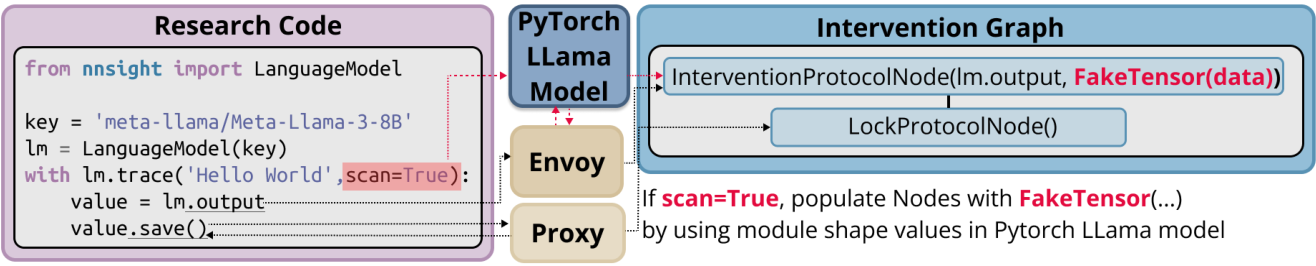
图片来源:NNsight and NDIF 论文。论文早期实现里的干预图:用户代码的每一次读写都变成一个协议节点,由 Envoy 与 Proxy 接到真实模型上;scan=True 时节点用 FakeTensor 填充,不真正算数。
三、延迟执行:with 块被捕获,而不是被执行
Python 执行到 with model.trace(...): 时,NNsight 干了五件事(对应 Tracer 的五个可覆写步骤):
capture   →  从调用栈取用户帧,读出 with 语句所在文件的源码
parse     →  切出这个 with 块的 AST 子树(只切块,不解析整个文件)
build     →  把块体包成一个 ast.Module
compile   →  编译成 code object,挂上原始文件名和行号
execute   →  交给 backend:本地就交错执行,远程就序列化发出
捕获发生在 __enter__ 里:它向上两层找用户帧(sys._getframe(2)),拿到文件名、行号、以及块被书写时所处的 globals/locals。然后把块体编译好,同时给这一帧装一个 trace hook,让 Python 一走到块体第一行就抛异常跳出去——所以块体不会在原地执行。
这里有两个直接后果,都是硬约束,都会报错(这点比后面那批静默失败好得多):
-
with的块体必须另起一行。with model.trace(x): y = model.output.save()会被拒绝,抛ValueError。原因很实在:写在with同一行的块体,会在原地执行一次、再通过 backend 执行一次。 - 必须能读到源码。 代码跑在真实文件里、Jupyter cell 里、
python -c "..."里都行(分别走linecache和sys.orig_argv);但从exec的字符串、heredoc、<stdin>里进来就不行,因为拿不到源码,抛出WithBlockNotFoundError。
捕获结果按 (filename, lineno, co_name, co_firstlineno) 缓存在进程级的 BLOCKS 里,所以写在循环里的 with 块只解析编译一次,后续每次迭代都是一次字典查找。
而这个「源码 + 它引用的变量」的捕获形式,恰好就是可序列化的形式。远程执行不是另写一套机制,是换一个 backend。
四、交错:模型和你的代码轮流跑,用 greenlet 而不是线程
块体被编译好之后,__exit__ 把控制权交给 interleaver。真正的执行是这样的:同一线程内,模型和你的代码严格轮流执行。
实现用的是 greenlet(协作式协程),不是线程,所以没有锁、没有队列、没有竞态——任意时刻只有一方在跑,控制权靠显式 switch 交还。每个干预块对应一个 Mediator,它在自己的 greenlet 里跑,一旦请求一个模型还没产出的值就「停车」,把控制权交回模型;模型跑到那个模块时,把张量递进去,再把控制权交还。
整个协议只有四种事件:
| 事件 | 含义 |
|---|---|
VALUE | 读这个位置的值,等到模型走到这里 |
SWAP | 在模型经过这里时用我的值替换 |
SKIP | 跳过这里的计算,用我的值当结果 |
BARRIER | 等其它块,不指向任何位置 |
envoy.output 是 VALUE,envoy.output = x 是 SWAP,envoy.skip(x) 是 SKIP。注意没有 END,也没有 EXCEPTION——worker 跑完就是 greenlet 自然结束,抛错就是异常往外传。协议小到这个程度,是因为它必须能在「模型侧」和「干预侧」之间来回穿越,每多一种事件就多一条路径要维护。
一个细节能说明这套设计的精度:同一个位置可以读一次再写一次,都在模型的同一次访问里完成。 handle 会循环,只要 worker 还在同一个位置上停车,就一直排空,然后模型才继续往下走。所以下面这种写法是安全的:
with model.trace("Hello world"):
    h = model.transformer.h[5].output      # 读
    model.transformer.h[5].output[:] *= 0  # 再写,同一个位置,同一次访问
反过来,顺序错了就会撞墙:在读到后面的位置之后再回头请求前面的位置,是物理上做不到的——那个模块已经跑过去了,它的下一次访问要等下一个 generation step。这种情况抛 OutOfOrderError,而且异常是「扔进」worker 的,所以 traceback 会指向真正在等的那一行。
同一位置在一次生成里会被访问很多次,所以请求带一个出现序号后缀 .i{n}。默认 n=0,绑定第一次访问;for step in tracer.iter[:5] 就是把 worker 钉在 k 上,序号不匹配的访问直接路过。
五、Envoy 树:模块路径就是 API
model.transformer.h[6] 返回的不是 nn.Module,是一个 Envoy:模块树的轻量镜像,在模型加载时构建一次,和真实模块一一对应。它提供 .input / .output / .inputs / .source / .skip() / .grad,每个都是「被 hook 住的值」。
这层间接有两处好处,都值得说清楚:
其一,别名免费。 不同家族的架构把同一角色放在不同路径下:transformer.h、model.layers、gpt_neox.layers。构造时传 rename={...} 装别名,别名指向同一个 envoy 对象而不是拷贝,所以迭代不会重复计数,dispatch 重新指向之后也依然有效。
其二,空闲时零成本。 每个模块的 forward 在构建 envoy 时就被替换成一个 controller,这个 controller 的第一行先问:当前有 interleaver 在跑、并且有 worker 在等吗?两个都没有,就直接跑原始 forward 返回。也就是说,没有 trace 的时候,插桩的模型和原模型速度基本一样,代价是一次函数帧和一次检查。这条性质是 NNsight 敢把插桩做成常驻的前提——同一次加载的模型,既能被 trace,也能被当普通模型用。
六、source:从模块边界钻到算子内部
hook 看不见 attention 内部的 q @ k.T。NNsight 的解法很直接:把模块的 forward 源码做 AST 改写,把每一个函数调用变成可寻址节点。
第一次访问 envoy.source 时触发改写(惰性、永久,且在 trace 之外完全无副作用),每个调用点分到一个名字:
print(model.transformer.h[0].mlp.source)
                    * def forward(self, hidden_states: ...) -> torch.FloatTensor:
 self_c_fc_0    ->  0     hidden_states = self.c_fc(hidden_states)
 self_act_0     ->  1     hidden_states = self.act(hidden_states)
 self_c_proj_0  ->  2     hidden_states = self.c_proj(hidden_states)
 self_dropout_0 ->  3     hidden_states = self.dropout(hidden_states)
                    4     return hidden_states
命名规则是「被调用者的完整点号路径 + 下划线 + 同名调用在运行时的出现序号」,所以 self.c_fc(...) 是 self_c_fc_0,torch.relu(...) 是 torch_relu_0。嵌套调用按内层优先编号,f(f(x)) 里的内层是 f_0。名字不用背——print(module.source) 就是地图,写错了会抛 AttributeError 并把可用的名字列出来。
于是可以读写到算子级别:
with model.trace("Hello world"):
    act = model.transformer.h[0].mlp.source.self_act_0.output.save()   # 读 SiLU 之后
    model.transformer.h[0].mlp.source.self_c_proj_0.output[:] = 0      # 清掉投影输出
source 还能再往下钻一层:attn.source.attention_interface_1.source 会进入被调函数的内部。但这个能力只在 trace 内可用,因为被调目标常常是局部变量(具体的 attention 实现),要从运行时流过的真实值里解析。
边界也很清楚:内置函数与 C 实现、闭包、加了装饰器的 forward,都会抛 SourceNotAvailable;而融合 CUDA kernel 的内部根本不在 Python 层面,.source 只能到它的输入输出。
七、把实验变成对象:edit / scan / cache / session
到现在为止,干预是一次性的。真正做研究时,你需要的是可复用、可预检、可批量的实验对象。NNsight 把这四件事都做成了原语:
edit():把干预装到模型上,反复生效。 默认装在一份浅拷贝的 envoy 上(模块、interleaver、子节点共享,只有编辑列表独立,权重不会复制),原模型保持干净:
with model.edit() as (tracer, edited):
    edited.transformer.h[0].output[:] = 0

with edited.trace("Hello world"):
    out = edited.transformer.h[0].output.save()   # 是零
with model.trace("Hello world"):
    orig = model.output.save()                     # 原模型,没被改
注意这里的 API 形状:当前版本是 with model.edit() as (tracer, edited)。网上大量教程还停留在 with model.edit(): model.transformer.h[0].output[:] = 0 的旧写法,0.8 的 pipeline 重写之后已经不适用了。model.edit(inplace=True) 才是直接装在原 envoy 上,model.clear_edits() 清空。
scan():不加载权重,先看形状。 它在 PyTorch 的 FakeTensorMode 下跑一遍 forward,只传播 shape / dtype / device,不 dispatch 真实权重:
model = TransformersModel("openai-community/gpt2")   # 只有 meta 结构,没权重
with model.scan("The Eiffel Tower is in"):
    dim = nnsight.save(model.transformer.h[0].output.shape[-1])
print(dim, model.dispatched)   # 768 False
这在写 shape 相关的代码(切片、reshape、按 head 索引)时非常有用——先验一遍形状,再去申请 GPU。但 save 依然必须写:scan 也是一个 tracing context,出口过滤器一样生效。而扫描出来的张量是 fake 的,出了 scan 就不可用,只该读 .shape / .dtype。
cache():批量采激活。 tracer.cache() 记录整轮里所有(或指定的)模块的激活,因为 interleaver 本来就把每次进出都过一遍 handle,缓存只是「干预后观察者」,不需要额外挂 hook:
with model.trace("The Eiffel Tower is in") as tracer:
    cache = tracer.cache()
cache["model.transformer.h.0"].output
两个容易踩的点:只有在 tracer.cache() 调用之后经过的模块才会被记录,所以要早开;同一模块被访问多次(生成循环)时返回的是按访问次数排的列表。
session():跨 trace 传值,不必每次 save。 每个 with model.trace(...) 是独立边界,值不跨 trace。session 把边界挪到外层:
with model.session():
    with model.trace("Madison Square Garden is in the city of"):
        hs = model.transformer.h[5].output[:, -1, :]     # 不需要 save
    with model.trace("_ _ _ _ _ _ _"):
        model.transformer.h[5].output[:, -1, :] = hs     # 直接流进去
        patched = model.output.logits.argmax(dim=-1).save()   # 这个要 save
规则是一致的:出口过滤只发生在最外层。session 是外层,所以内部 trace 的 locals 全部往上推;但 patched 要回到普通 Python,所以要 save。多个 trace 想合成一次远程作业时,remote=True 加在 session 上,不是加在内部 trace 上。
八、一次前向、多个 prompt:invoke 与 barrier
做 activation patching 时,最贵的不是干预,是前向次数。NNsight 的答案是把多个 prompt 拼成一次 batch:
with model.trace() as tracer:
    with tracer.invoke("The Eiffel Tower is in"):
        eiffel = model.transformer.h[-1].output[:, -1].save()
    with tracer.invoke("The Great Wall is in"):
        wall = model.transformer.h[-1].output[:, -1].save()
每个 invoke 拿到自己的 batch 行区间([start, size]),读的时候 narrow 切出自己那几行,写的时候 widen 拼回整张量。padding 由模型侧负责:因果解码器左填充,并用 mask 推导 position_ids,所以 output[:, -1] 永远是每行真正的最后一个 token。
机制是干净的,代价是顺序不再由书写顺序决定:worker 按「模型先走到谁要的东西」恢复,不按代码顺序。这就是批量之所以是批量、而不是串行的原因,但也意味着一个 invoke 读到的值,另一个 invoke 看不见——跨 invoke 传值会直接 NameError。
需要交接时用 barrier(n):
with model.pipe(max_new_tokens=3, do_sample=False) as tracer:
    barrier = tracer.barrier(2)
    with tracer.invoke("Madison Square Garden is in the city of"):
        embeddings = model.transformer.wte.output
        barrier()                                    # 声明:我已经读完
        result = tracer.result.save()
    with tracer.invoke("_ _ _ _ _ _ _ _ _"):
        barrier()                                    # 等对方读完
        model.transformer.wte.output = embeddings    # 再交过去
两个 invoke 都碰 wte.output;没有 barrier,第二个 worker 可能在第一个绑定名字之前就来替换,得到 NameError。barrier 是调用,不是上下文管理器,可以复用;参与方少于 n 时它永远不放行,运行结束时报未满足的数量。
顺带一个必须知道的限制:batched trace 里的 .skip() 必须覆盖所有行。共享的一次 forward 不能只给部分行跳过,否则抛 ValueError: A batched .skip() has to cover every row。
九、远程:为什么这段代码能寄出去
到这里,远程执行几乎是水到渠成的:块已经被捕获成「源码 + 引用的值」,模型只需要用一个 key("import.path.ClassName:model_key")来描述——服务器上早就加载好了,权重不过网。
from nnsight import CONFIG, TransformersModel

CONFIG.set_default_api_key("YOUR_NDIF_KEY")     # key 在 login.ndif.us 申请,有免费试用档

model = TransformersModel("meta-llama/Llama-3.1-70B")   # 本地只有 meta 结构

with model.trace("The Eiffel Tower is in the city of", remote=True):
    logit = model.lm_head.output[0][-1].argmax(dim=-1).save()

print(model.tokenizer.decode(logit))   # " Paris"
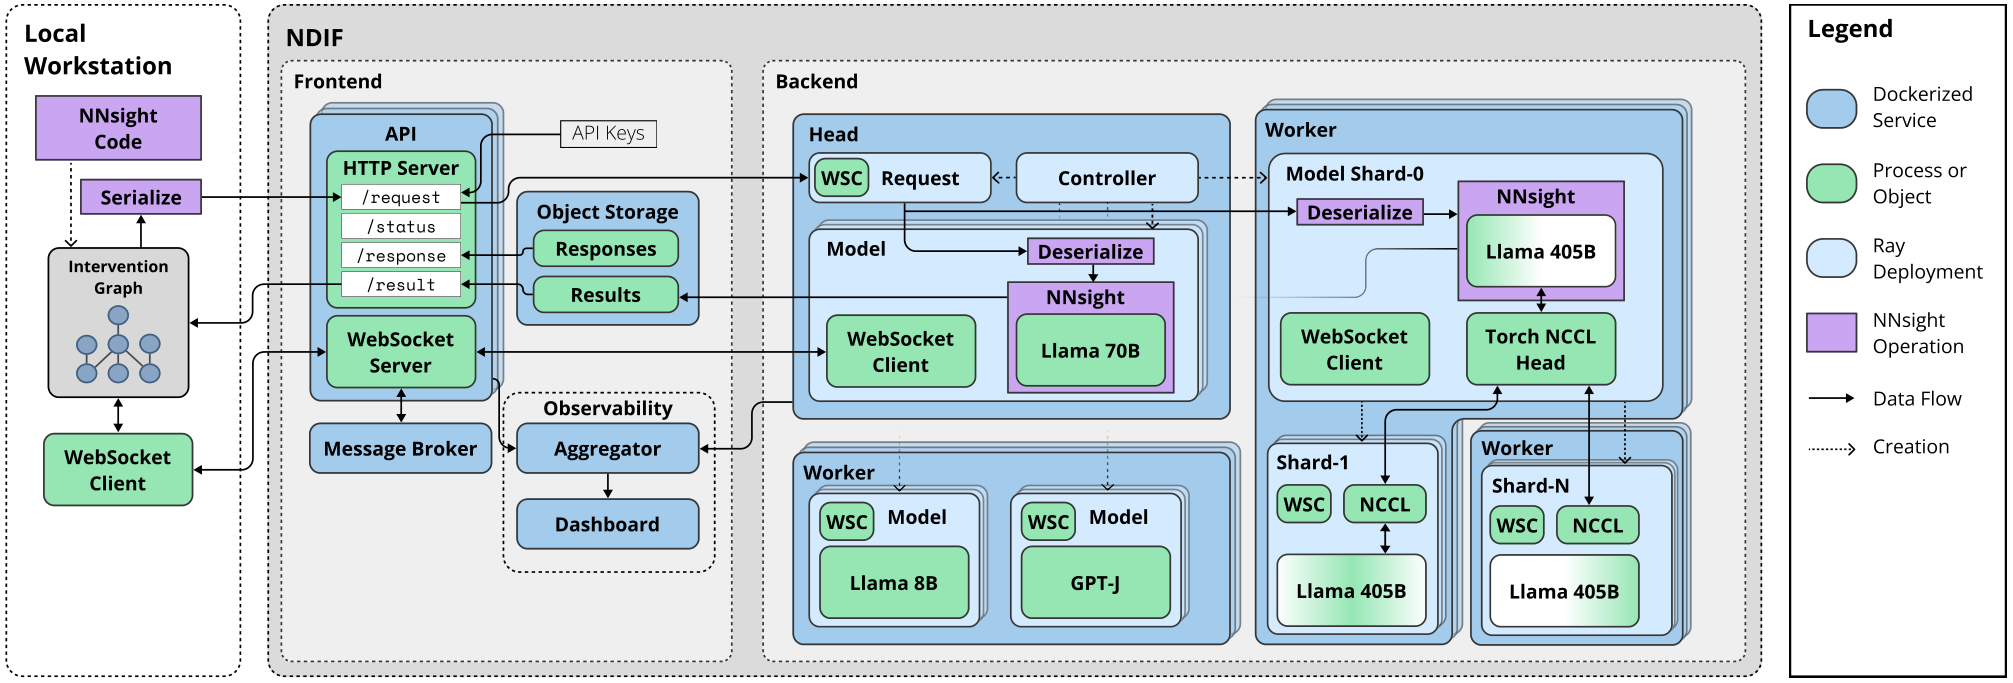
图片来源:NNsight and NDIF 论文 Figure 4
请求的生命周期是这样的:本地捕获块 → 序列化(可选压缩)→ 先订阅 websocket 再 POST 请求(先订阅才不会丢状态)→ 从 websocket 上读 RECEIVED / RUNNING / COMPLETED 之类的状态 → 结果可能内联在消息里,也可能给一个预签名 URL 让你下载 → 解压、torch.load(..., map_location="cpu")、按变量名塞回你的帧。
真正确立「实验与运行时解耦」的,是成本结构:
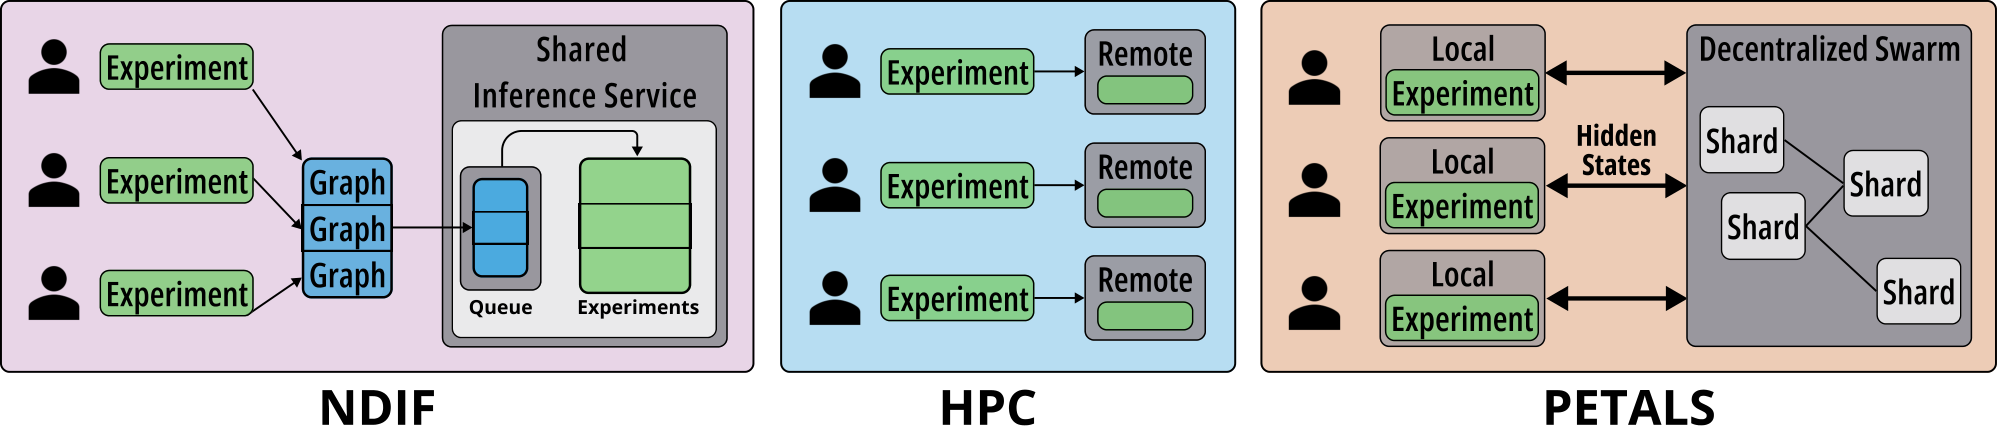
图片来源:NNsight and NDIF 论文 Figure 5
HPC 模式下,每个研究者独占机器,权重加载、模型存储、工程代码全得自己扛;Petals 这类 P2P 方案共享了 GPU,但干预需要反复跨节点传隐藏状态。NDIF 的做法是把实验代码送进集群、在集群内部执行,共享同一个预加载的模型实例——省掉的不只是权重加载,还有每步前向的数据往返。
论文的实测结论也比较克制:在 HPC 场景下,NNsight 的模型加载与 activation patching 耗时与 baukit、pyvene 相当(TransformerLens 的加载因为要做权重标准化,约慢三倍)。也就是说,本地跑的时候,选库应该看易用性和功能,而不是看这几毫秒;NNsight 的差异化收益出现在「你根本跑不动这个模型」的时候。
远程还有几条属于它自己的规矩:
- 只有
.save()过的值会回来,其余留在服务器上被丢弃。而且回来的张量统一在 CPU,通常是 float32;服务器上跑的可能是半精度、可能被切分,所以 device 和 dtype 要在代码里从激活本身取,别硬编码。 -
remote="local"是干跑。 它走完整的远程路径、在本地模拟执行,用来确认块能序列化、能发出去,再提交真请求。 -
print会变成远程日志。 服务器上的 stdout 以LOG状态回传,方便但别打印多兆的完整张量,会堵住 websocket。 -
nnsight.compare()能对比本地与服务端环境,nnsight.is_model_running("...")能确认某个模型在不在部署清单里——「本地能跑、远程报错」时,这两个是第一步。 - 发送的类必须写
super(MyClass, self).__init__()。裸super()依赖类体提供的__class__cell,而服务端是从源码重建类、不在类体里执行,会直接RuntimeError: super(): __class__ cell not found。
十、它和 PyTorch Hooks、TransformerLens 到底什么关系
把三种工具放在一张表里比,比「谁更强」有意义:
| 维度 | PyTorch Hooks | TransformerLens | NNsight |
|---|---|---|---|
| 读 / 写激活 | 支持 | 支持 | 支持 |
| 代码组织 | 回调 + 闭包 | hook 点名称 + 函数调用 | 顺序书写的 with 块 |
| 多层联合干预 | 自己维护状态 | 可行,需绕开 hook 生命周期 | 原生,写就行 |
| 模块内部算子 | 需改源码 | 部分(架构内置) | source(AST 改写) |
| 持久化干预 | 自己管理 | 不支持 | edit() |
| 远程执行 | 自己搭 | 不支持 | remote=True |
| 高吞吐服务 | 自己写 | 不适合 | vLLM runtime |
| 现成分析方法 | 无 | DLA、patching、SAE 工具链 | 少,方法自己写 |
结论并不复杂:TransformerLens 是「带分析工具箱的模型」,NNsight 是「一层执行基础设施」。 前者的价值在于它把一堆已经被验证过的方法(DLA、attribution patching、logit lens)做成了开箱可用的函数,代价是模型要被转换成它的结构;后者不提供方法,它提供的是「你想怎么干预就怎么干预」的执行能力,代价是方法论得自己搭。
如果你要跑的是标准实验、模型在支持列表里,TransformerLens 更省事;如果你要做的干预它表达不了、模型太大本地跑不动、或者你想把干预搬到 vLLM 的连续批处理里,NNsight 是更合适的底座。两者之间甚至有官方迁移教程(Tutorials → Migrating → From TransformerLens),没必要二选一。
十一、九个不报错的坑
这套设计最值得警惕的地方不是它做不到什么,而是它做错的时候往往什么都不说。下面这些在官方文档里被专门列成一页「症状索引」,我按踩到概率排序:
| 症状 | 原因 |
|---|---|
| 干预完全没效果 | 你重绑定了变量,而不是写穿张量 |
| 整块代码什么都没发生 | model.trace(x) 没加 with |
| 以为跑多步,实际只跑了一次 | 把生成参数传给了 trace() |
块后变量 UnboundLocalError | 没 save(),或块还没跑到那一行就结束了 |
| 远程回来一个空列表 | 你 save 了元素,而不是容器 |
.grad 是 None | 在 with metric.backward(): 之外读的 |
| 逐步循环里的写入晚一步 | 循环内先读了后面的位置 |
| 之后的每次 trace 都被改了 | 你写了 .weight,那是永久的 |
| 干预后指标一点没动 | 需要先跑一次「荒谬版本」的干预验证通路 |
挑三条展开,因为它们最反直觉:
1. acts = acts * 0 什么也没干。 读到位置拿到的是真实张量,但重新绑定这个名字只改名字,不改计算图——模型早已产出了那个值并继续往下算了。要写穿张量(output[:] = 0)或者赋值给属性(output = output * 0)。判断方法很朴素:先用一个荒谬的干预(把整个残差流清零)确认输出会变,再相信你的精细干预。
2. trace() 只跑一次前向,生成参数被静默忽略。 trace(prompt, max_new_tokens=5) 里的 max_new_tokens 会被转发给模型的 __call__,而它不认这个参数——不报错,只是没有多步生成。要多步就用 generate(),要取 token id 就从 tracer.result 读。
3. save 的语义是按对象身份标记,并且必须绑定名字。 x.save() 标记的是 x 本身并原样返回,所以 (x * 2).save() 是对的,h = x.save() * 2 标记的却是 x。更隐蔽的是「标记了但没有名字」:单独一行 model.output.logits.save() 会标记这个张量却不留任何局部变量,本地可能看不出问题,远程一定丢。收集多个值时规则只有一条:save 容器,往里塞原始值。
with model.generate("The Eiffel Tower is in", max_new_tokens=3) as tracer:
    xs = nnsight.save([])                                  # 保存容器
    for step in tracer.iter[:3]:
        xs.append(model.transformer.h[-1].output[:, -1, :]) # 塞原始值
    final = tracer.result.save()
十二、边界:这套工具不能替你做的事
观察不等于因果。 能读到 attention pattern 不代表这个 head 在干活;能改一个激活不代表这条通路是必需的。要谈因果,必须做干预 + 对照 + 重复,这是方法论问题,工具解决不了。
数值不是中立的。 论文之外的实践里,bf16 的归约顺序会随 batch 组成变化,temperature=0 只固定采样器、不固定算术。同一个 prompt 在两次运行里可能翻转一个几乎打平的 argmax。做 patching 时,正确做法是在同一次 trace 里读成对差值(clean 与 patched),而不是跑两次再相减。
vLLM 路径有一整套自己的限制。 每个 invoke 只能是一个 prompt;不支持梯度、不支持 scan()、不支持 barrier();.skip() 实际上不可用,且失败方式很暴力——ValueError 在 vLLM 眼里是致命的,会变成 EngineDeadError,把同一引擎上所有在途请求一起带走。另外,block 里读到的是引擎的活缓冲区,几个算子之后就被覆写,所以凡是要留存的值必须 .clone();忘了不会报警,只是拿回来一份「后面某一层的数据」。这跟 NNSIGHT_VLLM_CLONE_READS=1 那个开关的关系,官方文档写得很细,值得先读再跑。
source 到不了编译产物内部。 融合 kernel 是一个算子,不是一个 Python 函数,.source 只能到它的输入输出。
远程不是免费的。 有排队、有配额、有模型可用性限制,还有数据出境的合规问题;你的 prompt 和干预代码确实会离开本机。
十三、怎么上手
pip install nnsight
三条路径,按目的选:
- 想先摸一下手感:官方 Quick Start 的 GPT-2 例子,一行
dispatch=True就能跑。 - 想做研究:
Tutorials里的 activation patching、attribution patching、logit lens、DAS、SAE 评估,都是可运行的 notebook,改 prompt 就能用。 - 想用大模型:配好 NDIF key 之后,把
remote=True加到 trace 上,其余代码不用改。
值得放在一起看的,是本系列前面几篇的位置关系:
- Safetensors 解决的是权重怎么存;
- Deleting Weights 解决的是权重怎么删、删了能改变什么行为;
- TransformerLens 解决的是内部组件怎么被命名、被测量;
- NNsight 解决的是实验怎么被执行、被执行在哪里。
四者叠起来,才是一个完整的「大模型内部工程」栈:存得下、改得动、看得见、跑得起。
十四、总结
NNsight 最聪明的地方,不是它让你能写 model.transformer.h[6].output,而是它把「让你能写这一行」的代价转移到了架构上:因为块是被捕获的,所以它可以被序列化;因为可以被序列化,所以它可以被寄到一台你没有的机器上;因为模型和代码严格轮流执行,所以顺序书写的代码不会和异步前向打架。
代价同样清楚:with 块必须能读到源码、写入必须写穿张量、留存必须 save、读取顺序必须顺着前向、vLLM 上还多一层缓冲区语义。它把这批规则藏在了「看起来就是普通 Python」的外表下,这是它好用和难调教的同一个原因。
如果只记一句话:NNsight 不是又一个可解释性工具箱,它是一层执行层——让「干预」这件事从一次性的调试脚本,变成可以保存、复制、远程运行的对象。
项目与参考资料
- GitHub 仓库(MIT,Copyright © 2023-2024 Northeastern University)
- 官方文档
- NNsight 设计文档(NNsight.md)——讲清 tracing、interleaving、envoy 树与 0.8 重写,比 API 文档更值得先读
- 论文:NNsight and NDIF: Democratizing Access to Open-Weight Foundation Model Internals
- NDIF 基础设施仓库
- NDIF 状态与模型清单 / API key 申请
- 从 TransformerLens 迁移
- TransformerLens
本文的 API 细节、限制与失败模式依据官方文档与仓库当前实现整理;NNsight 处于 0.8 阶段仍在快速演进,具体行为请以仓库当前代码为准,尤其是 vLLM 集成——它直接依赖 vLLM 内部实现,版本漂移会静默改变结果。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- Blender Kiln:AI 建模缺的不是生成能力,是交付前的度量
- CineCode:每一帧都是时间的纯函数,所以电影可以被检查
- OhMyGame:AI 生成游戏不难,难的是让它自己发现游戏跑不起来
- GPT-2 的一次前向:一条 768 维的向量,被改写 12 次,变成 50257 个分数
- SAELens:重建得越准,特征越不一定是真的
- TokenEconomizer:Coding Agent 的成本按仓库累积,不按任务计价
- Transformer Explainer:把 GPT-2 塞进浏览器,让模型边算边解释自己
- Boubou:本地语音 AI 缺的不是模型,是一层能借给全屋的运行时
- Hy-MT2:把翻译拆成语言家族分头训练,再蒸馏回一个模型
- Safetensors:用 8 个字节和一段 JSON,重新设计大模型的权重文件