Blender Skills:能不能建出来不难,能不能过检查才难
22 → 0。34% → 0.02%。28 个技能。
前两个数字来自仓库自己做的对比实验:同一个模型、同一句提示、一次成型不重试,只差「有没有装这套 skills」。第三个是它的规模——28 个 Agent Skills,覆盖建模、UV、材质、烘焙、绑定、动画、服装、毛发、环境、优化、导出、渲染、后期、天气、模拟和 QA。
Blender Skills 是 EL4CTEO 维护的仓库,2026-10-14 建库,一个月 2,288 star、204 fork,MIT,Python,面向 Blender 5.2 LTS 以上(在 5.3 上验证)。
大多数介绍会停在「把专业流程封装成技能」这句话上。但翻完仓库的对比页之后,我觉得它的重点在别处:
它改变的不是模型能不能建出东西——那个本来就能——而是建出来的东西能不能过检查。
一、仓库自己做了一份受控对比
这一点值得先说,因为多数「AI + 3D」的项目不会做这件事。
对比页写清了实验条件:同一个模型(Opus 5.5 medium)、同一个 Blender(5.2)、一次成型、不重试、不手工修改、五个任务,分别在「装了 skills」和「隔离环境里不装」两种条件下跑。提示词也放出来了,两句只差一句:
Create a 4k PBR concrete wall in Blender then render it, don’t use any skills and don’t sneak peek in other folders, isolated environment.
Create a 4k PBR concrete wall in Blender then render it, use any of the existing 20 Blender skills before proceeding.
而且它写了一条自我拆台的备注:两次结果都没保住颜色——颜色贴图在隔离目录之外,两次都读不到;只是两者都保留了颜色的 UV 图,所以颜色可以无返工地接回去。
这种「把对自己不利的条件也写进实验记录」的做法,比多少张漂亮的渲染图都有说服力。
二、最能说明问题的六个数字
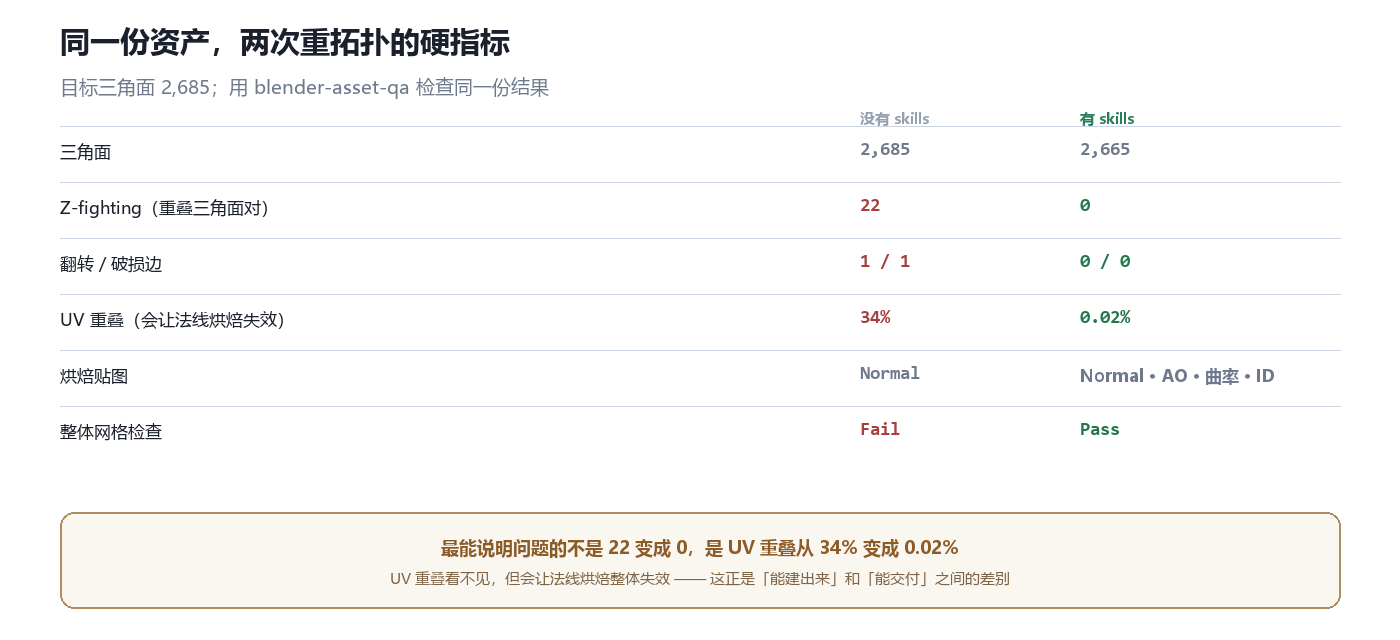
同一份资产(Nova.blend,5,370 面)重建到目标 2,685 面,用 blender-asset-qa 检查结果。
其中最值得看的不是 z-fighting 从 22 变成 0——那只是显眼。真正致命的是 UV 重叠从 34% 变成 0.02%:UV 重叠肉眼看不见,但会让法线烘焙整体失效;烘焙废了,低模就没有高模的细节,整个「重拓扑 + 烘焙」的流程白做。
还有一行很小的差别:烘焙贴图从 Normal 一张变成 Normal / AO / 曲率 / ID 四张。这正是一个懂流程的技工和一个不懂流程的技工的区别——不是画得好不好,是知不知道要出哪几张。
三、混凝土那组:差别在哪
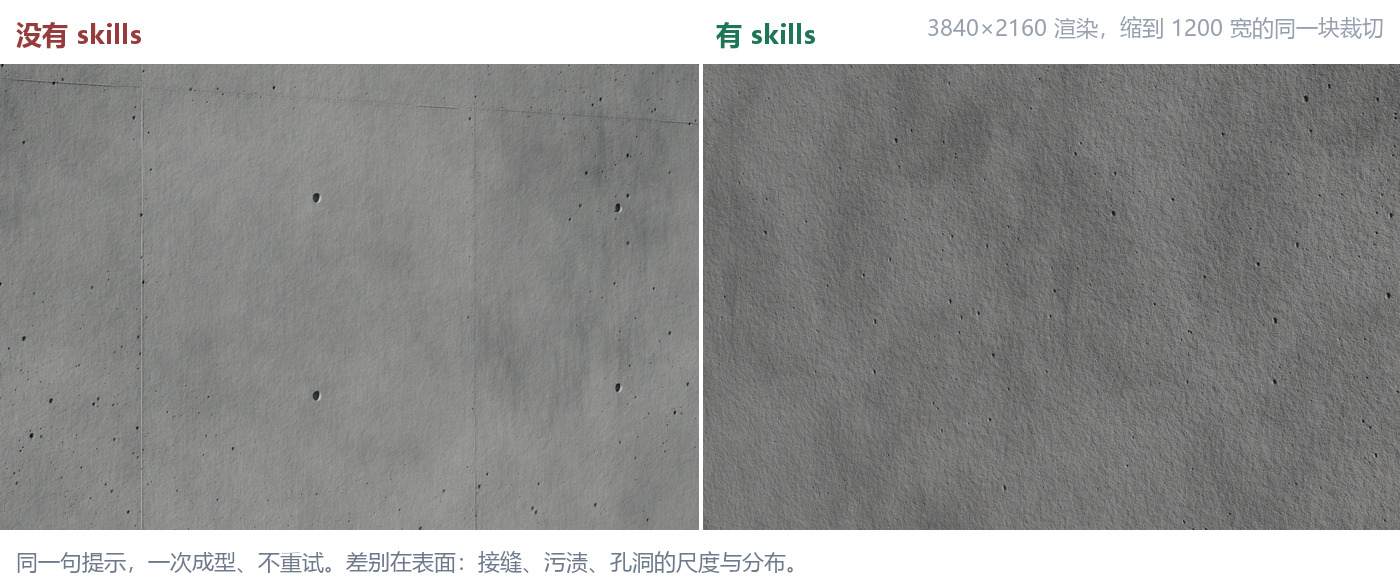
提示完全一样,一次成型。差别在表面:接缝的处理、污渍的走向、孔洞的尺度。
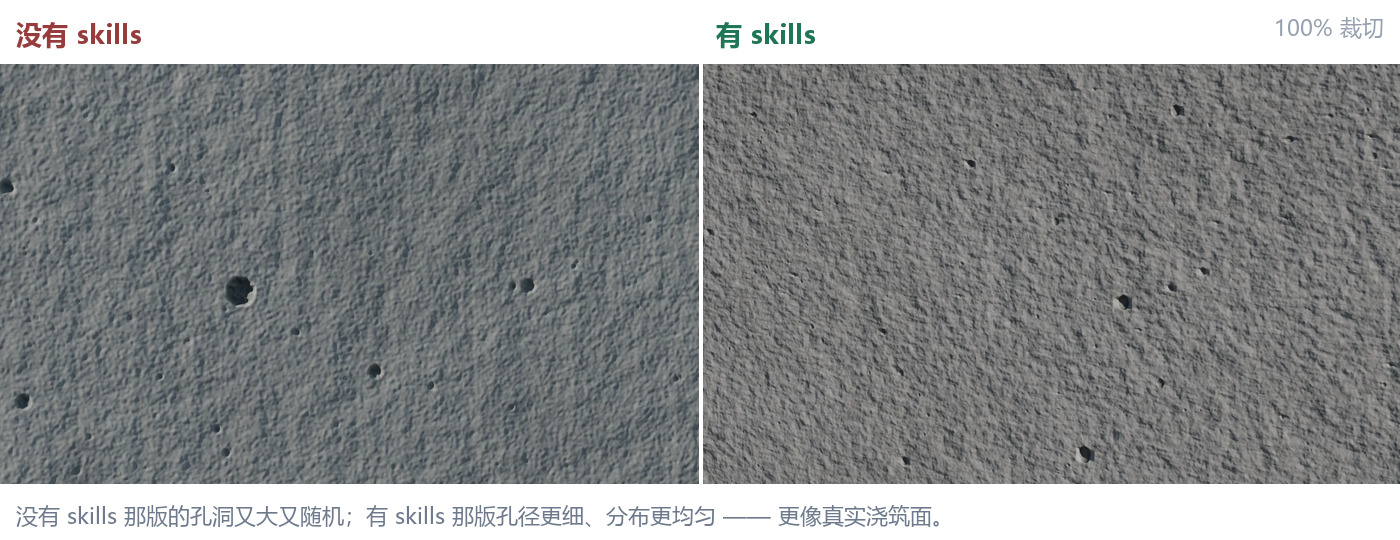
放大到 100% 之后能看清:没有 skills 那版的孔洞偏大、分布随机;有 skills 那版孔径更细、更均匀。
说实话,这组对比不像 Nova 那组有说服力。两张图都像混凝土,差别是质感取向:一边是「随机噪声感」,一边是「浇筑面的细密气孔」。哪个更像真的,是判断不是数据——真实预制混凝土的气孔细而密,所以我倾向后者,但这话没有测量支撑。
两组对比放在一起,恰好说明 QA 能管什么、不能管什么:Nova 那组是能不能用(可测),混凝土这组是好不好看(不可测)。
四、28 个技能,六个环节
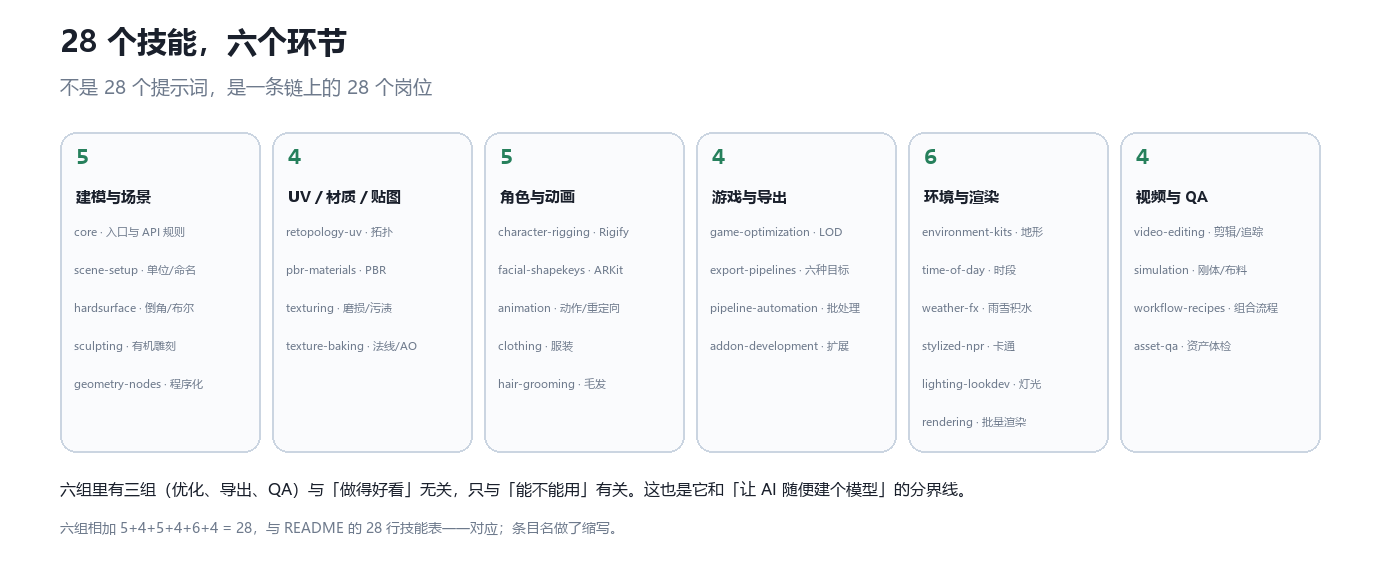
5 + 4 + 5 + 4 + 6 + 4 = 28,和 README 的 28 行表一一对应。
分组本身没太多可讲的,值得讲的是哪几组跟「好看」无关:
-
blender-game-optimization:面数预算、LOD、draw call; -
blender-export-pipelines:Roblox / Unity / Unreal / Godot / web / USD 六种目标; -
blender-asset-qa:z-fighting、悬空部件、法线、权重、贴图。
这三组是「能交付」和「做出来好看」之间的分界线。一个只会建模型的 agent 和一个能交付资产的 agent,差别就在这三组里。
五、QA 是主功能,不是收尾
blender-asset-qa 检查的东西,都是「模型在视口里看着没问题、导进引擎就出事」的那一类:
| 症状 | 后果 |
|---|---|
| Z-fighting(面重叠) | 引擎里闪烁,跑起来才看得见 |
| 悬空 / 分离部件 | 动画一播就飞出去 |
| 法线反向 | 背面剔除后模型内部朝外 |
| 非流形几何、重复顶点 | 烘焙和 LOD 生成都会失败 |
| UV 重叠 | 法线烘焙失效(就是上面 34% 那条) |
| 权重 / 骨骼问题 | 蒙皮一变形就撕裂 |
它还会生成多角度检查图。这一点很关键:让 agent 自己看检查图,比让它自己「觉得没问题」可靠得多——这也是为什么五个案例里,带 skills 的那几次都多出了 review sheet、wireframe 渲染和 QA 渲染。
六、Skills 和 MCP 不是一回事
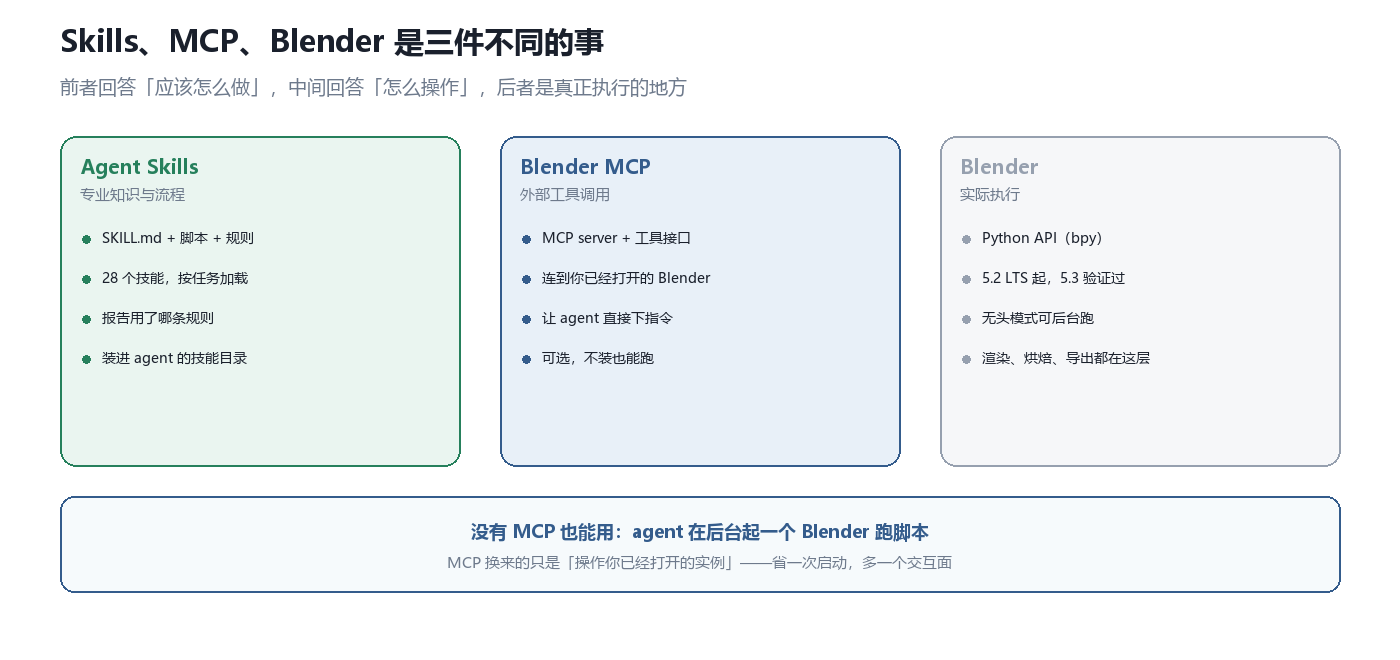
前者回答「应该怎么做」,中间回答「怎么操作」,后者真正执行。
这个区分经常被混掉,但实践里差别很大:
- Skills 是知识层:SKILL.md 里写什么时候用、按什么步骤、注意什么、怎么验证;
- MCP 是通道层:让 agent 操作你已经打开的那个 Blender 实例;
- Blender 是执行层:
bpy脚本、无头渲染、烘焙、导出。
没有 MCP 也能用——agent 在后台起一个 Blender 跑脚本就行。MCP 换来的只是「操作你已经开着的那个实例」,省一次启动,多一个交互面。
七、工程细节
这些细节决定了它是不是真能跑,而不只是文档好看:
-
python tools/validate_skills.py:检查技能规范和 token 预算。给 agent 用的技能必须控制上下文大小,这一条很少见但很务实。 -
python tools/run_tests.py:67 个无头 Blender 测试,BLENDER_EXE可覆盖路径。也就是说验证的是脚本在真实 Blender 里跑不跑得通,不只是提示词格式对不对。 - 安装矩阵:Claude Code 走
/plugin marketplace add;其他 agent 用install.sh/install.ps1,--agent claude|codex|opencode|gemini|copilot|cursor|all,默认落到~/.claude/skills和~/.agents/skills,支持--project和--uninstall。 - 版本策略:面向 5.2 LTS,全部在 5.3 上验证;README 明确建议升 5.3,因为多了 KTX2 web 导出、合成器特效栈和 Gaussian splats。
八、局限
- 只有五个任务、一次成型。样本很小,且是作者自己的选题;这能说明「有差别」,不能说明「稳定更好」。
- 对比页的技能数与仓库不一致。提示词里写的是「existing 20 Blender skills」「20+」「22」,而 README 现在是 28。合理推测是技能陆续加进来、旧实验没重跑——但这也意味着那批结果跑在更小的一套技能上。
- QA 是规则,不是审美。它能拦住 z-fighting 和 UV 重叠,拦不住「这个造型很丑」。
- 门槛不低。要 Blender 5.2+、要装 Blender、要给它跑无头渲染的机器;所谓「AI 建模」在这里等于「AI 写脚本 + 本机渲染」。
- 迁移性没被验证。五个案例都是同一个模型、同一个 Blender 版本;换模型、换版本会怎样,仓库没说。
- 它是技能库,不是产品。没有 GUI,没有项目管理,没有版本控制——那些是你的事。
九、我的判断
我认为这套东西最值得抄的不是「28 个技能」,而是两件更小的事。
第一件:把验收标准写进流程,而不是写进验收环节。blender-asset-qa 的价值不在它查得全,而在它是技能——agent 在做资产的过程中就会调用它,而不是等交付时被人退回。UV 重叠 34% 和 0.02% 的差距,本质上是「什么时候发现问题」的差距。
第二件:给 agent 一套能自己看的证据。多角度检查图、wireframe、review sheet——这些不是给人看的报告,是给 agent 自己复核用的输入。让模型「检查自己的产出」这件事,只有把产出变成它能读的图才成立。
我唯一保留的是「一次成型」这个设定。它让实验很漂亮,但也回避了真实工作里最常见的动作:发现问题、改、再看。真到了产线上,判断这套技能值不值钱的,是它在第二轮迭代里能不能把问题定位到具体那一步,而不只是第一轮能不能过。
项目与资料
- 仓库:EL4CTEO/blender-skills(MIT)
- 对比实验全部五个案例:el4cteo.github.io/blender-skills/comparison
- 技能列表与安装:README
数据来源:star / fork / 建库时间 / 许可取自 GitHub REST API(2026-11-19);28 个技能名、安装参数、67 个测试、token 预算检查与版本要求均取自 README;Nova 那六项数字、五个案例的实验条件与「两次都没保住颜色」的备注取自对比页原文。混凝土的两张对比图取自仓库 docs/comparison/media/,我只做了等宽拼接与标注,没有调色或改裁。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- StemStudio:给 AI 的不是代码,是能被检查的命令
- STE80 Humanizer:改写不难,改完事实还在才难
- AnyCrawl:LLM-ready 不是模型给的,是默认值给的
- Cheetah:常驻内存不该由模型大小决定
- AI Filmmaking Camera Control:让模型只抄镜头,不抄人
- 认知博弈:形式化、求解与可辨识性综述
- 麦田(Maitian):平台改版那天,不该让每个用户升级一次
- The Software Engineering Handbook:把工程判断写成一份自由度账本
- Hypit:你编辑的是词,秒是编译出来的
- Omni LoRA:一个 671 MB 的修正,要背两个任务