AnyCrawl:LLM-ready 不是模型给的,是默认值给的
3,568 star。377 fork。四个默认值。
AnyCrawl 是 any4ai 做的抓取工具包:Node.js + TypeScript,Safetensors 之于推理引擎的那套「格式约定」,在这里变成了「网页进、Markdown 出」。2025-03-31 建库,MIT,官网 anycrawl.dev,文档 docs.anycrawl.dev。
它的宣传语是 turn websites into LLM-ready data。我读完 README 和 Scrape 的文档之后,觉得这句宣传语落在一个比它听起来更具体的地方:
「LLM-ready」不是模型做的,是一组默认值做的。
具体是这四个:
-
engine默认auto; -
only_main_content默认true; -
formats默认["markdown"]; -
store_in_cache默认true。
下面逐个说,以及每个默认值各自要你付什么。
一、界面:五个入口,不是四个
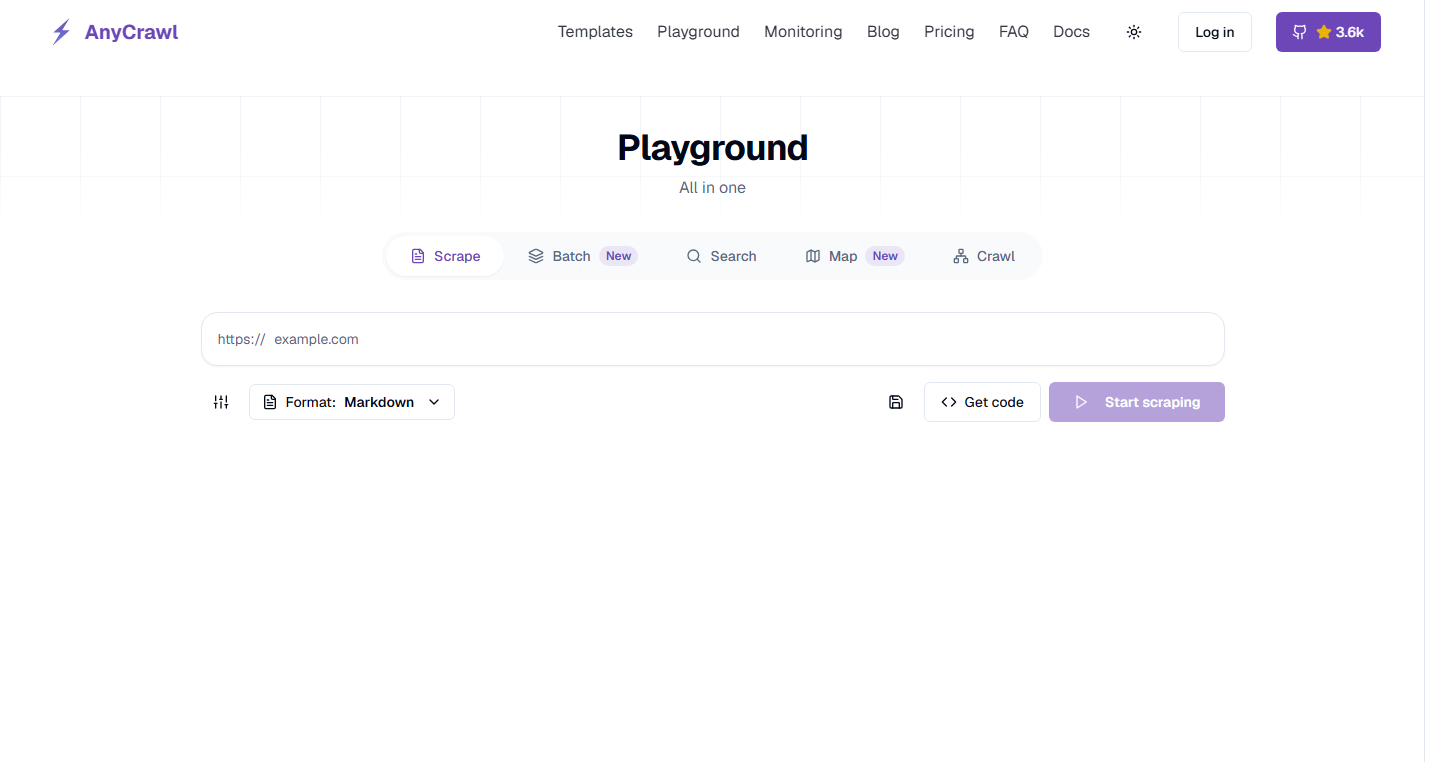
anycrawl.dev/playground 的实际界面,2026-11-19 用无头 Chrome 截的。
顶上那排 tab 是 Scrape、Batch、Search、Map、Crawl——比多数人以为的「抓 + 爬」多两个。导航里还有 Templates 和 Monitoring,文档的 Features 一组列的是 Scrape / Crawl / Cache / Search / Map / JSON mode / Templates,Automation 一组是 Scheduled Tasks / Monitors / Webhooks。
也就是说:这不是一个「给个 URL 拿段文本」的库,而是一个带产品面的服务——同一个后端,既能当库用(自托管 API),也能在页面上试。
二、默认值一:auto 先探一次,再决定开不开浏览器
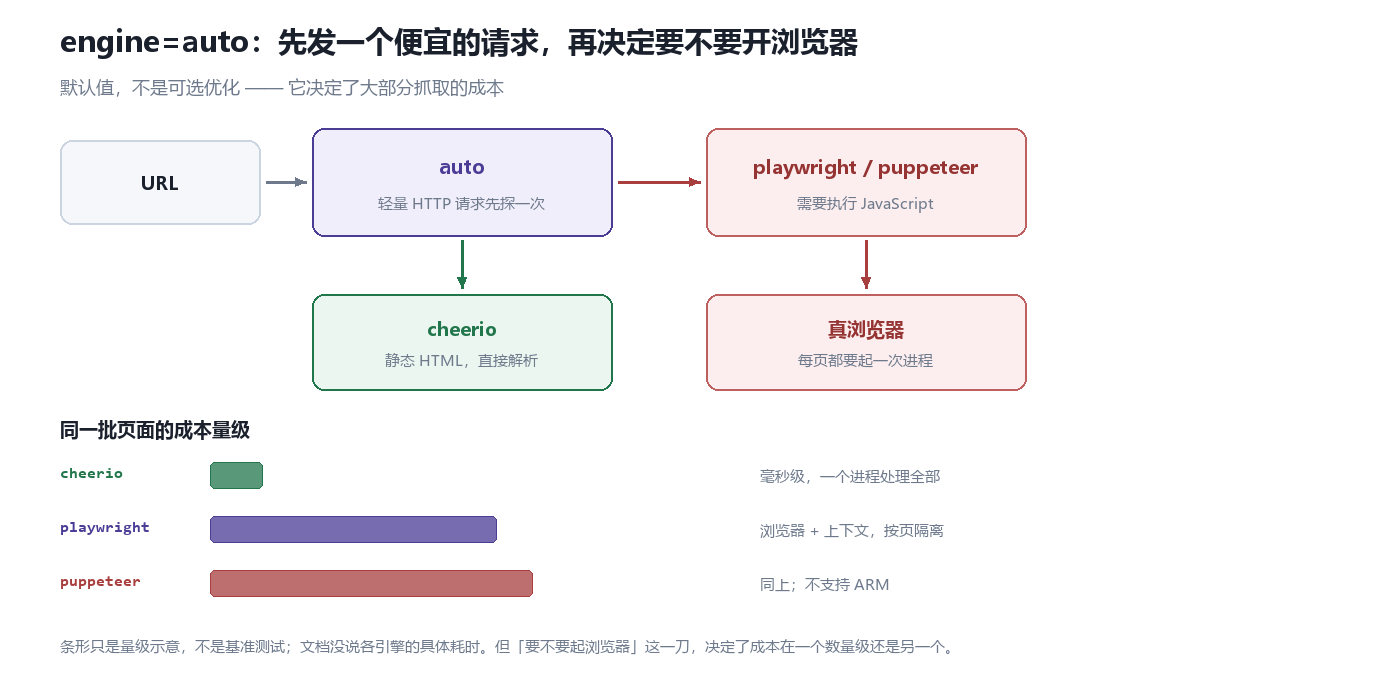
先发一个便宜的 HTTP 请求;是静态页就用 cheerio,要执行 JS 才升级到 playwright / puppeteer。
文档对 auto 的描述很具体:先做一次轻量 HTTP 请求分析页面,如果发现需要 JavaScript 渲染,再升级到浏览器引擎。
这一刀决定了成本在哪个数量级。cheerio 是纯解析,一个进程能吃一整批;playwright / puppeteer 每页都要起浏览器上下文。抓一千个页面,引擎选错一次,账单差一个数量级。
顺带两个容易被忽略的约束:
-
puppeteer不支持 ARM——在树莓派或 ARM 服务器上,这条路直接不通; - 自托管时
playwright/puppeteer默认通过 CloakBrowser 启动(浏览器指纹、时区、语言按代理出口解析),但不能把cloakbrowser当engine的值传进去——文档专门写了这一句,因为从外部看它像是第四个引擎。
三、默认值二:删掉什么,留下什么
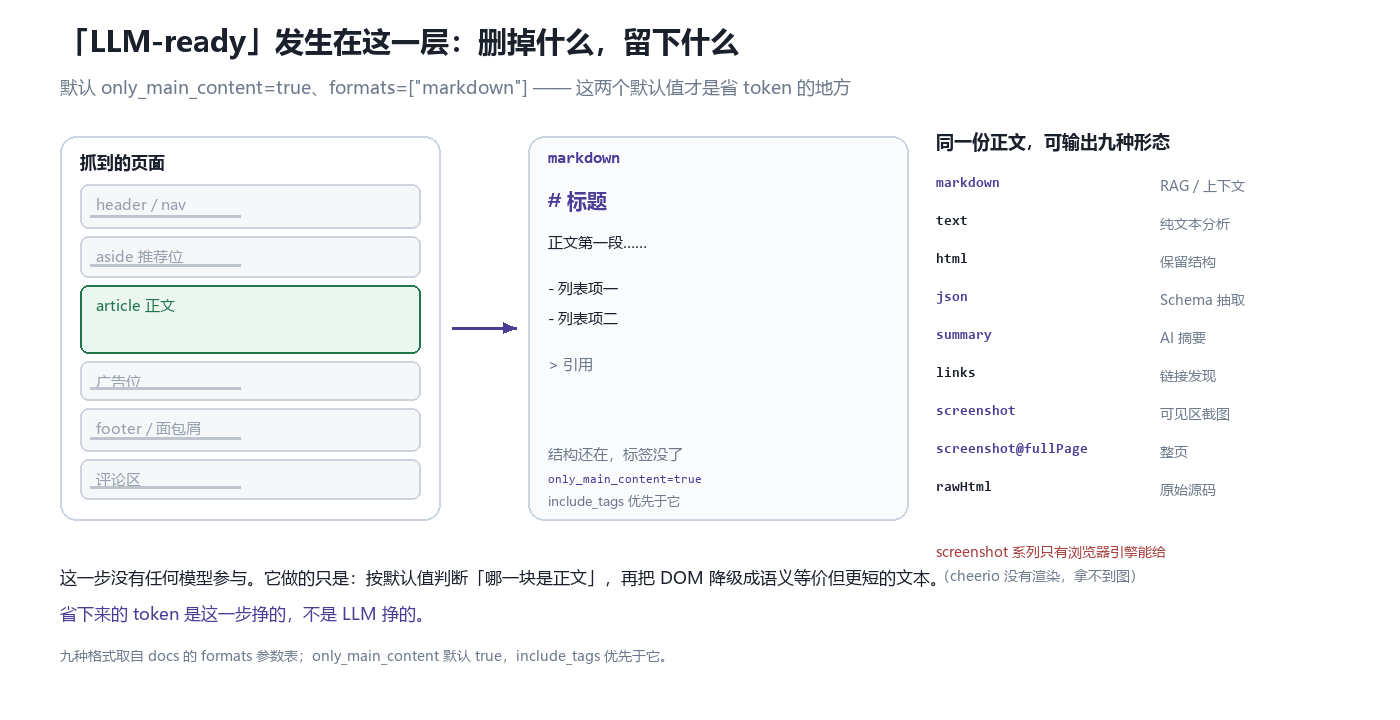
only_main_content=true 会在抽取前把 header、nav、aside、footer、评论区全部排掉;include_tags 优先于它。
这一步没有任何模型参与。它做的只是按默认值判断「哪一块是正文」,再把 DOM 降级成语义等价但更短的文本:标题变成 #,列表变成 -,引用变成 >,标签全没了。
省下来的 token 是这一步挣的,不是 LLM 挣的。这也解释了为什么一个抓取工具会反复强调「LLM-ready」——它真正卖的是删减规则,而不是模型。
输出有九种形态:markdown、html、text、json、summary、links、screenshot、screenshot@fullPage、rawHtml。其中截图系列只有浏览器引擎能给,cheerio 没有渲染,拿不到图。
四、默认值三:一页同步,一趟异步
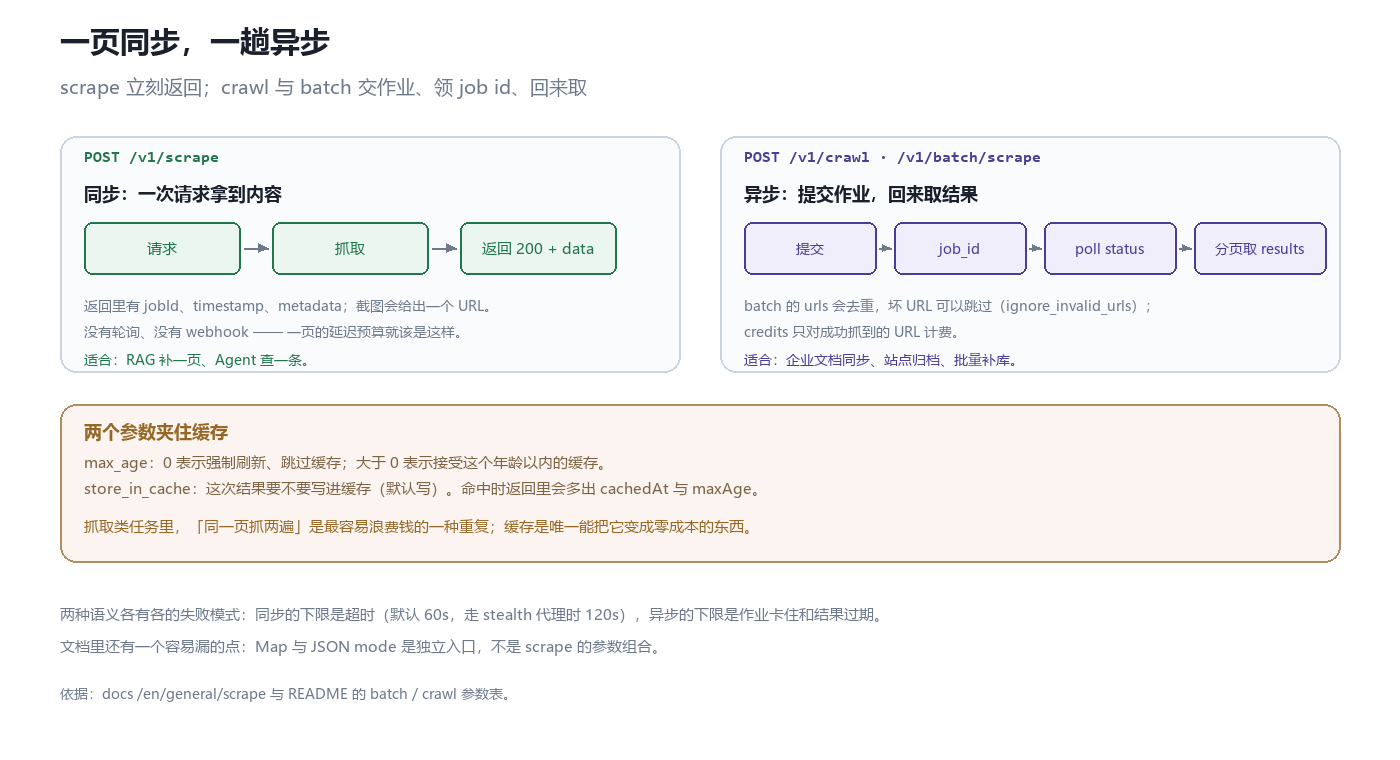
同一个服务里有两套延迟语义,按「一页」和「一趟」分开。
POST /v1/scrape 是同步的:一次请求,拿到 200 和 data,返回里带 jobId、timestamp、metadata,要截图的话给一个 URL。没有轮询、没有 webhook。
POST /v1/crawl 和 /v1/batch/scrape 是异步的:提交拿到 job_id,轮 status,再分页取 results。batch 的 urls 会去重,坏 URL 可以用 ignore_invalid_urls 跳过,credits 只对成功抓到的 URL 计费。
这个切分看着平淡,但它对应两种完全不同的失败模式:同步的下限是超时(默认 60 秒,走 stealth 代理时 120 秒);异步的下限是作业卡住、结果过期、以及你忘了轮询。
缓存被两个参数夹住:max_age(0 表示跳过缓存强制刷新,正数表示接受这个年龄以内的缓存)、store_in_cache(这次结果要不要写缓存,默认写)。命中时返回里会多 cachedAt 和 maxAge。
抓取类任务里,「同一页抓两遍」是最常见的一种浪费;缓存是唯一能把它变成零成本的东西。
五、Schema 抽取:把解析规则换成一次模型调用
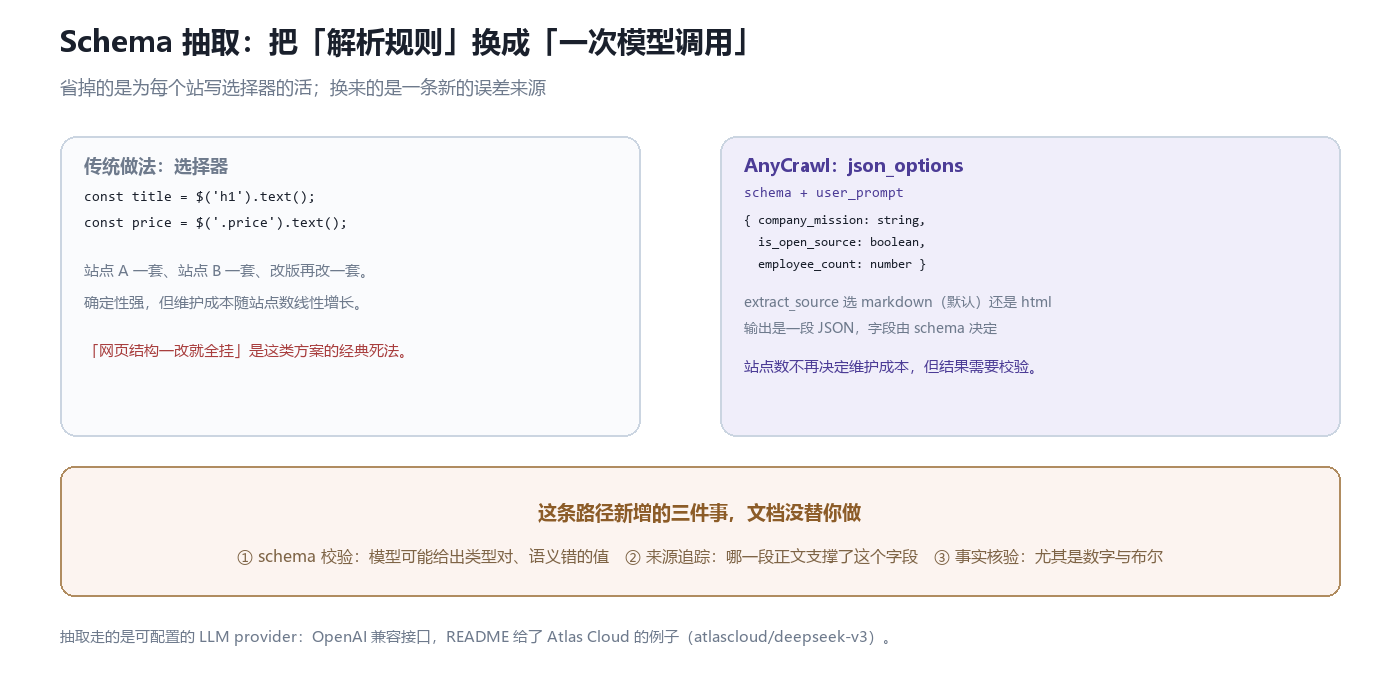
传统做法要替每个站写选择器;schema 把这活换成一次模型调用,也换来一条新的误差来源。
json_options 接受 schema(JSON Schema)、user_prompt,以及可选的 schema_name / schema_description;extract_source 决定从 markdown(默认)还是 html 里抽。
好处很直接:站点数不再决定维护成本。网站改版不再让你的选择器全挂,因为根本没有选择器。
但这条路径新增三件事,文档没替你做:
- schema 校验——模型可能给出类型对、语义错的值;
- 来源追踪——哪一段正文支撑了这个字段;
- 事实核验——尤其是数字和布尔,这两类最容易被「合理推断」出来。
抽取走的是可配置的 LLM provider(OpenAI 兼容接口),README 给了 Atlas Cloud 的例子(atlascloud/deepseek-v3)。这意味着你的抽取质量同时取决于两件你控制不了的事:网页本身写没写清楚,以及你选的模型那天状态如何。
六、在 RAG 里,它只占最前面那一段
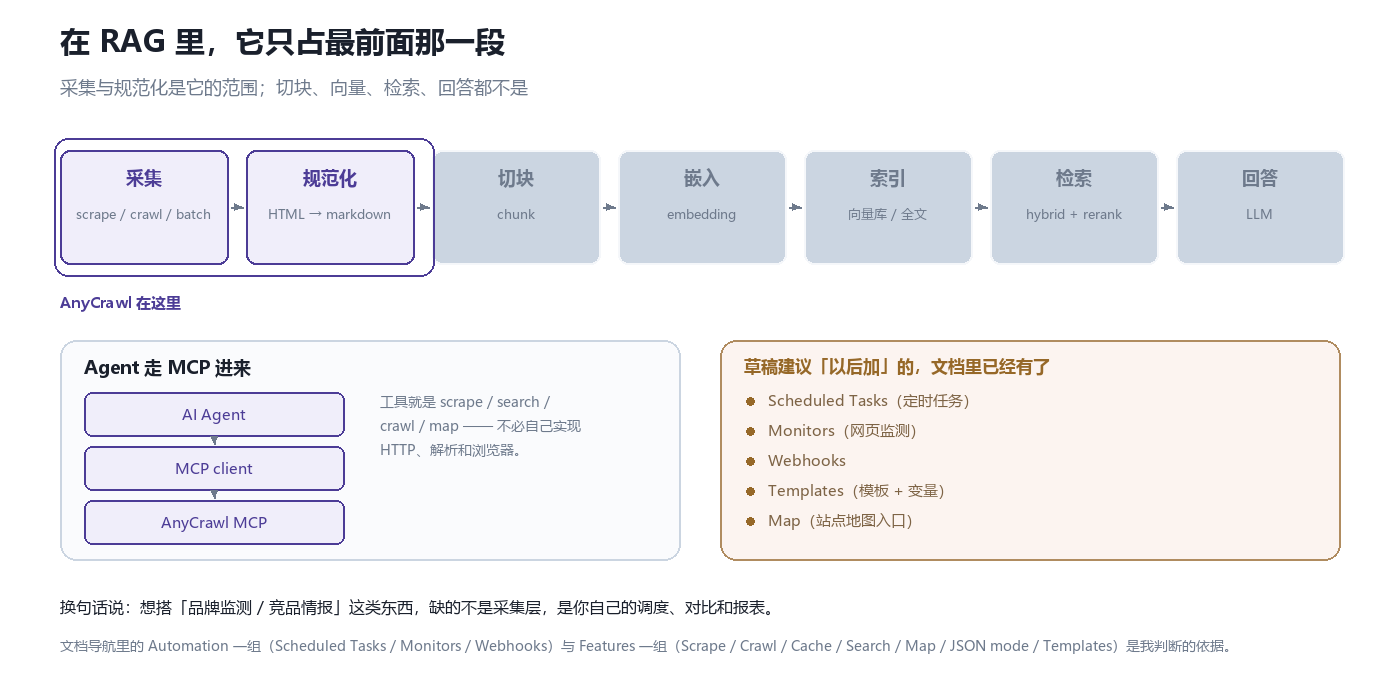
采集与规范化是它的范围;切块、嵌入、索引、检索、回答都不是。
RAG 的完整链路上,它负责的是「拿到干净的文本」这一段。剩下的切块、embedding、向量库、hybrid 检索、rerank、生成,都得你自己接。把它当成 RAG 解决方案会失望;把它当成 RAG 的第一段会顺很多。
Agent 那条路走 MCP:文档里有独立的 MCP Server 页面,Agent 把 scrape / search / crawl / map 当工具调,不用自己写 HTTP、解析和浏览器。
这里我要纠正一下常见的期待:很多介绍会说「可以再加个定时监测、做成品牌监测平台」。文档里已经有了——Automation 一组列着 Scheduled Tasks、Monitors、Webhooks,Features 里还有 Templates(模板 + 变量)和 Map(站点地图入口)。所以缺的从来不是采集层,而是你自己的对比逻辑、存储和报表。
七、局限
按重要性排:
- SERP 实际只有一个引擎。README 的项目简介和仓库 description 写的是 Google / Bing / 百度等,但
/v1/search的参数表里engine只有google,文档也写着「Supported search engines: Google」。这三处口径不一致,能确认的只有 Google。 - 文档自己也不统一。README 的 Scrape 参数表把
engine默认值写成cheerio,文档写auto(而且 batch 表里默认又确实是auto)。按文档为准:默认auto。这类不一致在小步快跑的项目里很常见,但它会让你对「默认行为」的判断出错。 - 抽取的准确率没有基准。没有任何公开的抽取评测。「schema 比选择器省维护」成立,「schema 比选择器准」不成立——后者要看你的字段和站点。
- 反爬是军备竞赛。项目有一套 browser-score 的实测(BrowserScan、CreepJS、Sannysoft、reCAPTCHA demo),说明作者在意指纹一致性;但能过检测不等于能过所有站点的风控,代理和指纹都不保证。
- 自托管的隐性成本。浏览器运行时(Node 20+、CloakBrowser 二进制;Docker 镜像预装)、Redis、Postgres 都要自己管;GeoIP 库首次使用要下 ~70 MB。云端则受并发和 credits 限制。
- 需要登录的页面文档没展开。scrape 的参数表里没有会话 / 登录态字段,只有
proxy;这类页面得自己带 cookie 或代理,属于「文档没承诺」的范围,不是「支持」。 - 合规是你的事。robots.txt、服务条款、版权、个人信息,工具都不替你判断。
八、我的判断
如果只从这个项目里拿三样东西:
第一样:把「省成本」做进默认值,而不是写进最佳实践。auto、only_main_content、markdown、缓存四个默认值,决定了 90% 的账单和 90% 的 token。大多数工具把这类选择留给用户,然后写一页「最佳实践」;AnyCrawl 直接把它们设成默认,再给需要的人留参数。
第二样:按「一页」和「一趟」分接口,而不是按「同步/异步」分。这不是技术偏好,是延迟预算的差异:查一页要的是即时返回,同步就够;跑一趟要的是可恢复、可分页、可计费,那就得是作业。
第三样:把「解析」换成「推理」时,同时承认它换了误差。schema 抽取不是「更聪明的选择器」,是一次成本转移:维护成本下降,验证成本上升。愿意在文档和字段上把这件事说清楚的项目不多。
我也有点保留。「LLM-ready」这个说法把两件事混在了一起——清洗(删标签、留正文,确定性、便宜)和理解(schema 抽取,不确定、按 token 计费)。前者是这个项目真正扎实的部分,后者是它最有想象力的部分。把它们捆在一个词里卖,容易让人高估后者的稳定性。
这和我最近拆的几个项目是同一个动作:把不确定性推到边界上,然后用一种新的证据去接住它。Cheetah 把常驻内存推给一个预算参数,Hypit 把时间轴推给编译器,AnyCrawl 把解析推给模型调用——每一次推,都要多付一层验证。区别只在于,有的项目把那一层写进了文档,有的没有。
项目与资料
- 仓库:any4ai/AnyCrawl(MIT)
- 文档:docs.anycrawl.dev · Scrape · MCP Server
- Playground:anycrawl.dev/playground
数据来源:star / fork / 建库时间 / 许可取自 GitHub REST API(2026-11-19);引擎、默认值、formats 九种取值、only_main_content、缓存参数与 SERP 引擎列表取自 docs 的 Scrape 与 Search 页面;批量计费与去重规则取自 README 的 Batch 参数表。截图是 2026-11-19 用本机无头 Chrome 访问 anycrawl.dev/playground 得到的,裁掉了 Cookie 提示条,未做其他修改;项目截图版权归 any4ai,本文按评论用途引用。文中标注「推断」的地方是我从文档参数表反推的,不是官方承诺。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- StemStudio:给 AI 的不是代码,是能被检查的命令
- Blender Skills:能不能建出来不难,能不能过检查才难
- STE80 Humanizer:改写不难,改完事实还在才难
- Cheetah:常驻内存不该由模型大小决定
- AI Filmmaking Camera Control:让模型只抄镜头,不抄人
- 认知博弈:形式化、求解与可辨识性综述
- 麦田(Maitian):平台改版那天,不该让每个用户升级一次
- The Software Engineering Handbook:把工程判断写成一份自由度账本
- Hypit:你编辑的是词,秒是编译出来的
- Omni LoRA:一个 671 MB 的修正,要背两个任务