麦田(Maitian):平台改版那天,不该让每个用户升级一次
7 个平台。8 个出口。4 个能自动提交,4 个永远等你按。
麦田(Maitian) 2026-11-14 建库,四天后 1,170 star、379 fork、5 个 open issue,MIT,纯 JavaScript。作者麦当(mdldm)是讲 AI Agent 入门的博主,这个项目是他照着自己每周的发布流程一点点搭出来的——仓库提交里带着 Co-Authored-By: Claude Opus 5.5,它本身也是用 agent 写的。
一个多平台发布工具,核心功能是「把同一期内容填到七个后台」。听起来是个体力活的外包,没什么可讲的。
但我翻完 README 和发布 skill 之后,觉得它最值得抄的地方根本不在功能表上:
它先回答了一个架构问题——哪一层会变、由谁负责跟进——然后才决定功能怎么切。
这个选择的产物,是下面这句话:平台改版那天,用户不需要升级麦田。
一、发布自动化真正难的三件事
写真机自动化的人通常先想「怎么点」。这个项目先想的是「谁会变」。
| 层 | 多久变一次 | 变了谁负责 |
|---|---|---|
| 平台上传页 | 随时,且不通知你 | 插件作者(发一版更新) |
| 平台填写逻辑 | 跟着页面走 | Chrome 插件(自动更新) |
| 调度与数据账本 | 几乎不变 | 麦田主程序 |
三层的变化频率差了一个数量级。如果把它们写在一起,最脆的那层就会决定整个软件的发布节奏——B 站换一次上传页,所有人都得升级一次麦田,而大部分人装完就不会再动它。
所以它把平台适配挪进了 Chrome 插件,主程序只负责「什么时候跑、跑到哪、记了什么」。这个决定后来还顺手解决了另外两件事:复用你浏览器里已经登录的状态,以及不去碰平台的内部接口。
二、八个出口,两种收尾
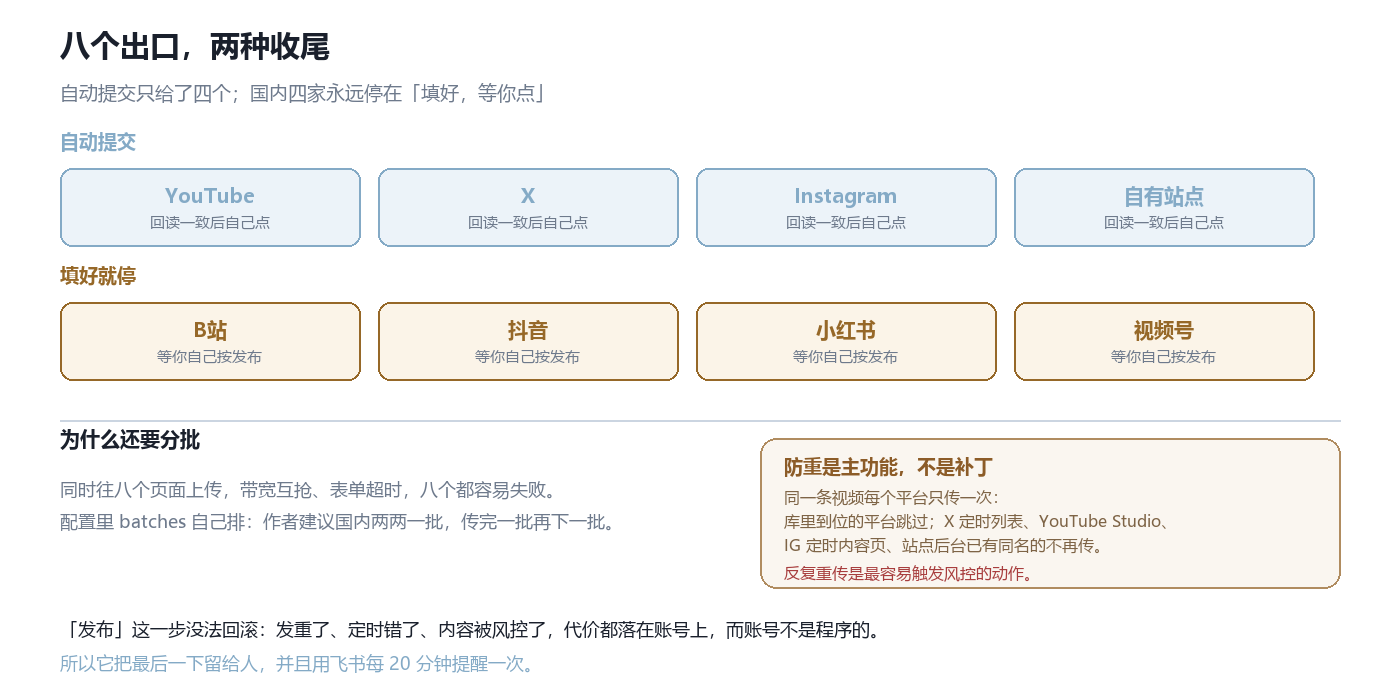
自动提交只给了四个;国内四家永远停在「填好,等你点」。
YouTube、X、Instagram、自己的站点:回读一遍文案和定时,对得上就自己点提交,只点一次。
B 站、抖音、小红书、视频号:填完就停,等你自己按「发布 / 定时发布」,守护进程每 20 分钟提醒一次。
这不是能力不足,是代价分配。发重了、定时设错了、内容撞了风控,后果都落在账号上,而账号不是程序的。程序可以承担「没发出去」,不能承担「发错了」。这条线一划,剩下的自动化才好设计。
两个配套的工程细节:
- 分批:同时往八个页面上传会互相抢带宽、表单超时,配置里的
batches自己排,作者建议国内两两一批。 - 防重:库里已经到位的平台直接跳过;X 的定时列表、YouTube Studio、Instagram 的「定时内容」页、站点后台,已有同名的不再传。反复重传是最容易触发风控的动作。
三、适配器住在会自己更新的容器里
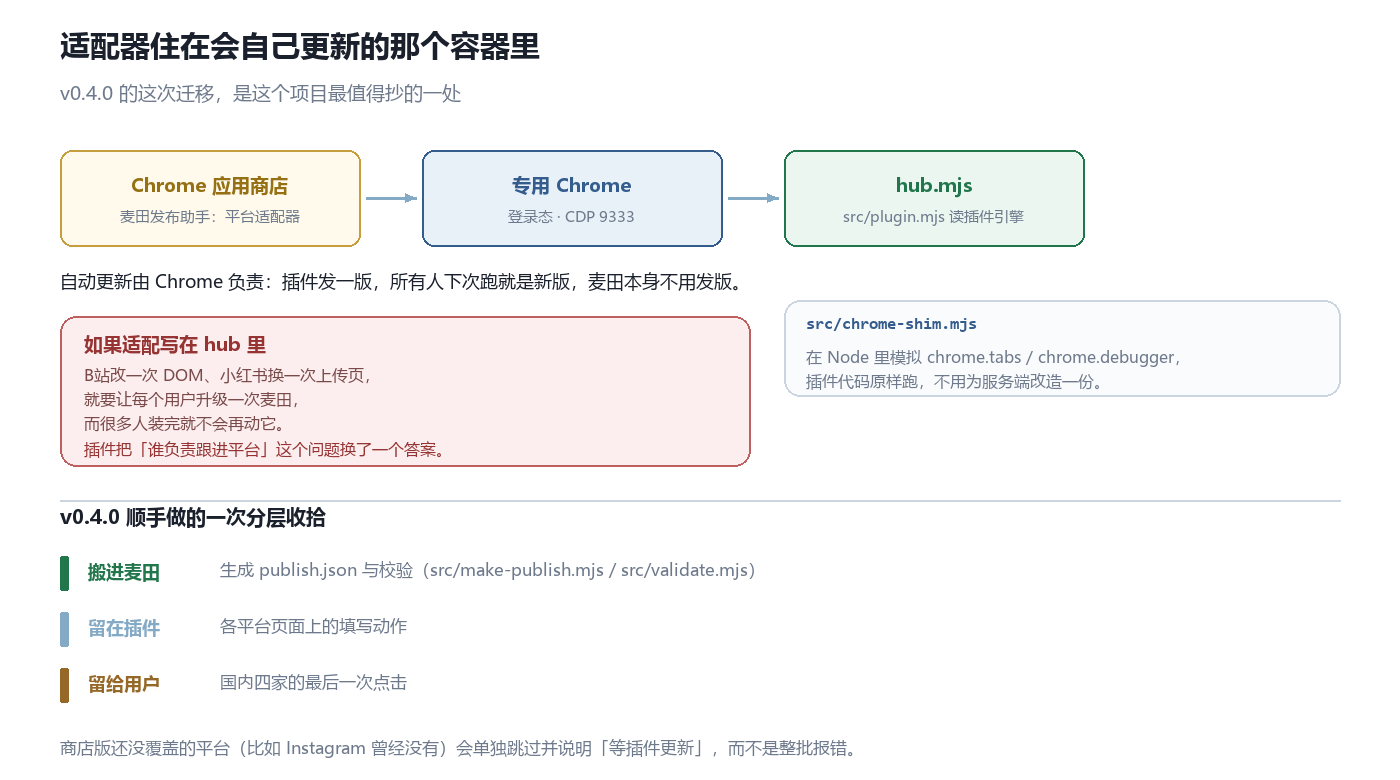
v0.4.0 的这次迁移,是整个项目最值得抄的一处。
2026-11-17 的 v0.4.0 提交把这件事做实了:src/plugin.mjs 默认从麦田专用 Chrome 里那份从应用商店安装的插件读取发布引擎。插件由 Chrome 自动更新,平台改版时作者发一版商店更新,所有人下次跑就是新版,麦田本身不用发版。
为了让插件代码能原样在 Node 里跑,还有一个 src/chrome-shim.mjs,模拟 chrome.tabs 和 chrome.debugger。插件不需要为服务端改造一份,主程序也不需要理解每个平台。
同一次提交还顺手做了一次职责收拾:
- 生成
publish.json和校验(make-publish.mjs、validate.mjs)搬进麦田,不再依赖插件仓库; - 页面上「填写」的动作留在插件;
- 国内四家的最后一次点击留给用户;
- 商店版还没覆盖的平台单独跳过并说明「等插件更新」,而不是让整批任务报错。
最后这条尤其值得记:能力没跟上时,降级要降在任务粒度上,而不是让一次执行整体失败。
四、一期内容的一生
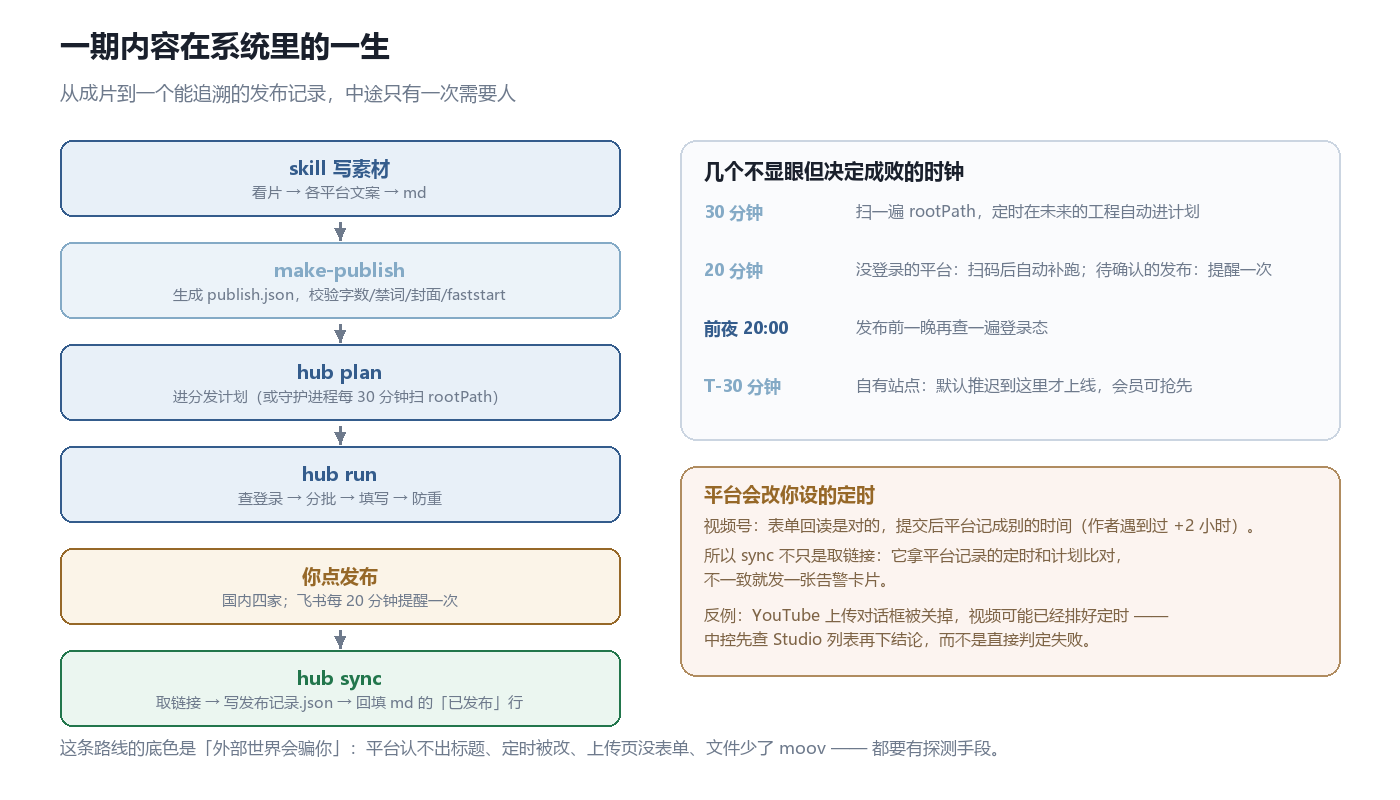
这条路线的底色是「外部世界会骗你」,所以每一步都得有探测手段。
发布 skill 先看片、写各平台文案,产出一份 发布素材.md;make-publish 把它变成 publish.json 并校验(字数、禁词、封面比例、成片是否 faststart);hub plan 进分发计划;hub run 分批填写;国内四家你点;hub sync 取链接,写回 发布记录.json,并回填 发布素材.md 里的「已发布」行。
最后这个回填很小,但它让「这个 md 就是这个视频的档案」这件事成立了——下次打开不用再翻平台后台。
几个不显眼但决定成败的时钟:守护进程每 30 分钟扫一遍 rootPath,定时在未来的工程自动进计划;没登录的平台扫码后 20 分钟内自动补跑;发布前一晚 20:00 再查一遍登录;自有站点默认推迟到定时前 30 分钟才上线。
还有一类设计是我没想到的:平台会改你设的定时。视频号的表单回读是对的,提交后平台却记成别的时间(作者遇到过 +2 小时)。所以 sync 不只是取链接,它拿平台记录的定时和计划比对,不一致就发一张告警卡片。
反方向的坑也有:YouTube 上传对话框被关掉时,视频可能已经排好定时了——中控会先查 Studio 列表再下结论,而不是直接判定失败。
五、账本:横轴是「发布后第几天」
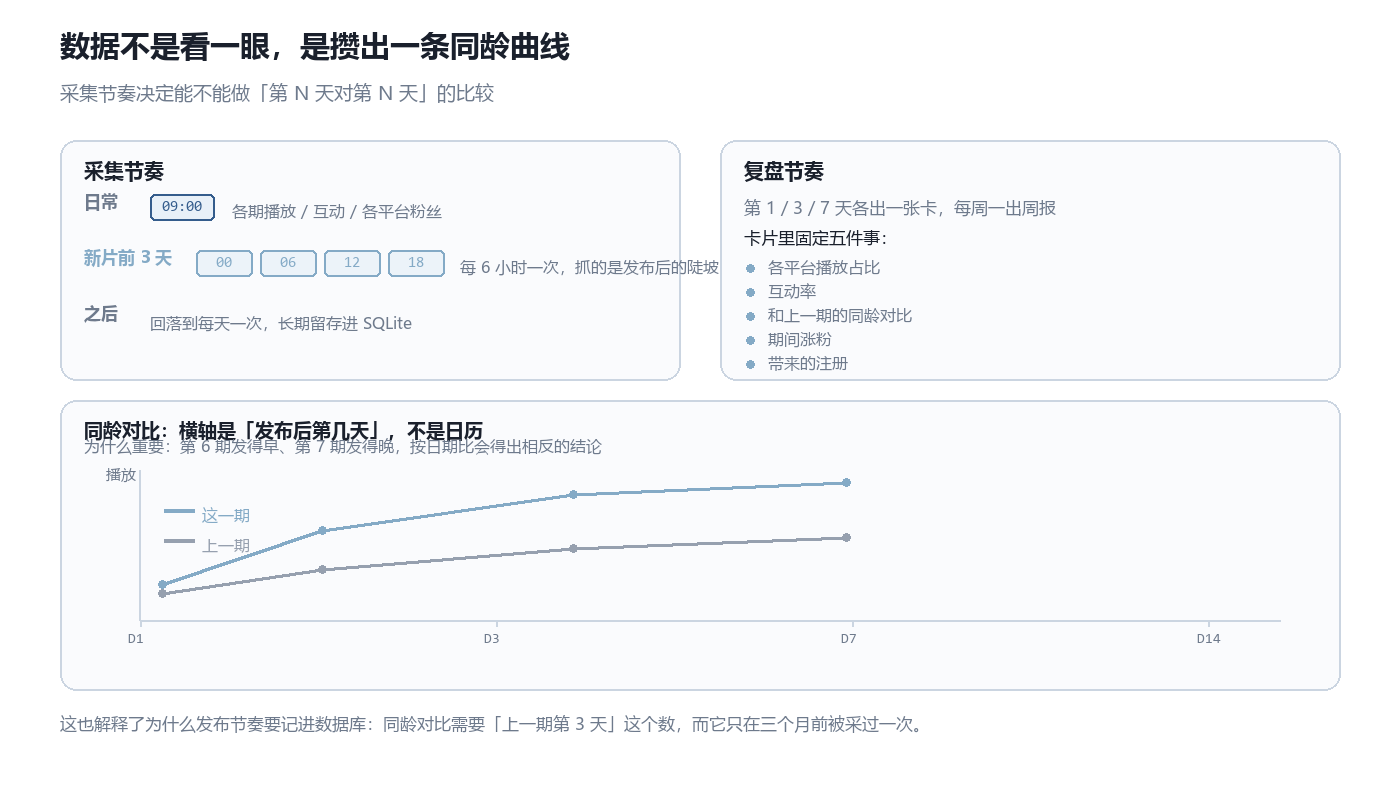
同龄对比把「发布时间不同」这个混杂变量消掉了。
采集节奏:日常每天上午一次;新内容发布后前三天每 6 小时一次,抓的是发布后的陡坡;之后回落到每天一次,长期留在 SQLite 里。
复盘节奏:第 1/3/7 天各出一张卡,每周一出周报。卡片里固定五件事:各平台播放占比、互动率、和上一期的同龄对比、期间涨粉、带来的注册。
其中「同龄对比」是这个项目里我最喜欢的一个小设计:横轴是「发布后第几天」,不是日历。第 6 期发得早、第 7 期发得晚,按日期比会得出相反的结论;按天数比才可比。
代价也在这里:要做「上一期第 3 天」这个对比,那个数必须是三个月前就被采过的。所以采集不是「看一眼」,是在攒一条以后能用的曲线。
六、收成:播放量不是收成,漏斗才是
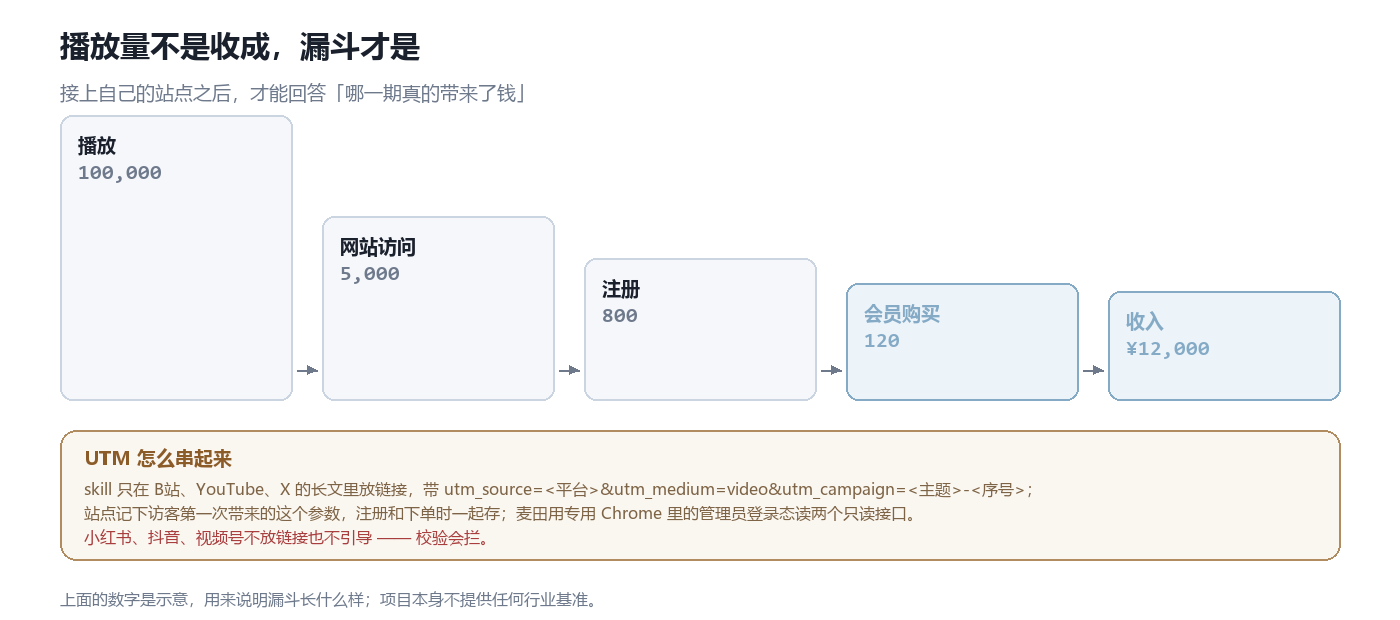
图里的数字是示意的,用来说明漏斗长什么样;项目本身不提供任何行业基准。
接上自己的站点后,链路上多了一段:发布 skill 只在 B 站、YouTube、X 的长文里放链接,带 utm_source=<平台>&utm_medium=video&utm_campaign=<主题>-<序号>;站点记下访客第一次带来的这个参数,注册和下单时一起存;麦田用专用 Chrome 里的管理员登录态去读两个只读接口。
小红书、抖音、视频号不放链接也不做引导——skill 的校验会拦。这条规则不是洁癖:在这几个平台放站外链接本身就是风险行为。
于是「哪一期真的带来了钱」变成一个可以查的问题,而不是一句感慨。
七、工程细节
这些细节比功能表更能说明作者是真的每天在用:
| 细节 | 为什么 |
|---|---|
| 成片必须 faststart(moov 在文件头) | 否则小红书报「无视频流信息」、抖音不出表单,校验会拦 |
| 音频响度标准化到 -16 LUFS | 只重编码音频,各平台播放响度一致 |
| 封面出 3:4 和 4:3 两张,16:9 由 4:3 补模糊生成 | 手机缩略图要够大,YouTube 又是 16:9 |
拷到 NAS 用 cp -X,报 fcopyfile failed 就 cat | macOS 元数据拷贝的坑 |
web.key 口令,所有页面和接口没有口令一律 401 | 它会把数据端暴露到公网(可配 Cloudflare 隧道 + 飞书验证码) |
| 端口 8787 / 8788 / 9333 | 网页、演示、专用 Chrome 的 CDP |
| Node ≥ 22.5 | 用了内置的 node:sqlite,不用装数据库 |
平台字数规则也写进了 skill 和校验:小红书标题 ≤20 字、抖音 ≤30、视频号短标题 6–16、YouTube ≤100、X 280(中文按 2 字符计)、Instagram 配文 ≤2200 且话题 ≤30。禁词表里包括「去主页」「评论区领」「私信我」这类引导。
八、它不给你什么
按重要性排:
- 不是一个多租户 SaaS。它是单机工具:一台常开的 Mac、一个专用 Chrome、一个口令。没有账号体系、没有权限模型、没有队列。想做成团队版得自己补一层。
- macOS 优先。README 的徽章写的就是 macOS-only;Windows 安装脚本是社区贡献的(作者致谢了 ajin558),开机自启没适配,得用任务计划程序指向
4-start.bat。 - 平台适配永远在追。插件把「改版」压缩成一次商店更新,但没消除它。作者自己的应对是把风险限制在插件层,并且让没覆盖的平台「跳过并说明」,而不是崩掉。
- 数据不是官方 API。它读的是你自己账号的创作者后台页面,能采到什么取决于页面渲染什么。平台不给的字段,它也拿不到。
- 国内四家仍然要人。对追求「全自动」的人是缺陷;对账号安全是设计。这两者只能选一个。
- 它依赖一台你愿意一直开着的机器。断电、睡眠、Chrome 卡死都会影响发布;README 甚至写了「卡住了用
curl 127.0.0.1:9333/json/close/<id>关掉标签页」这种急救法。 - 作者有导流。安装向导结尾、出错通知和没接站点时的「转化」页里有带 utm 的作者知识站链接;README 明确写了这一点,并给了
learnLinks: false关掉。这点做得很体面——披露了,也给开关。
九、我的判断
如果只从麦田里拿三样东西,我会拿这三样。
第一样:把易碎的那一层放进能自动更新的容器。大多数自动化项目把适配写在主程序里,然后被外部世界的改版节奏拖死。这里换了个问法——「谁负责跟进平台」——答案就变成了插件商店,而不是每个用户。这个思路对任何爬取、RPA、对接第三方后台的系统都成立。
第二样:自动化停在不可回滚的那一步之前。「没发出去」可重试,「发错了」不可。程序负责前者,人负责后者。这条线一旦画清楚,很多纠结(要不要加验证码识别、要不要模拟点击确认)就不需要讨论了。
第三样:把时间归一化。同龄对比、第 1/3/7 天复盘,都是在把「发布时间不同」这个混杂变量消掉。所有做内容分析的人都知道这个坑,但愿意为此在采集节奏上付出代价(前三天每 6 小时一次)的项目不多。
我也有一点保留。插件即更新通道,同时也把「平台适配」变成了一个中心化的单点:所有平台的适配都在作者的商店账号下,商店审核和单一维护者是这个设计的成本。对一个个人项目来说这没问题,但它也解释了为什么这类工具很难长成公司——真正的护城河不在代码里,在那个「一直有人盯着平台改版」的位置上。
这和我之前拆过的几个系统其实是同一个问题:哪一层的失败可以回滚,哪一层的失败不可回滚,然后把人放在不可回滚的那一侧。麦田的版本是「最后一次点击」,Hypit 的版本是「时间轴的编译」,SE Handbook 的版本是「证据够不够交付」。说法不同,问的是同一件事。
项目与资料
- 仓库:CzzzzzzJ/mdldm-maitian(MIT)
- 发布 skill:skills/maitian-publish/SKILL.md
- 插件:麦田发布助手(Chrome 应用商店)
数据来源:star / fork / issue / 建库时间取自 GitHub REST API(2026-11-18);版本号与分层迁移取自仓库 v0.4.0 的提交与 README;发布流程、字数规则、禁词与时钟取自发布 skill 原文;文中所有平台数字、端口与配置项均照 README 与 skill 抄录,未做估算。图为示意,转化漏斗的数字不是项目实测。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- The Software Engineering Handbook:把工程判断写成一份自由度账本
- Hypit:你编辑的是词,秒是编译出来的
- Omni LoRA:一个 671 MB 的修正,要背两个任务
- Omni-Quantized:12 个构建,两套布局,省的是显存不是时间
- video-shotcraft:150 个镜头名,就是 Agent 的接口
- Jina-OCR-v1:赢在少写,不在写快
- MNN-Pocket-0.3B:不是把大模型缩小,是从两个预算反推形状
- rust-anything:语言迁移不是翻译,是一场可以判负的比较
- SFT 与 RLHF:教接口,选口味,然后收窄
- Mainline:工程判断该住在 Git 里,不该住在数据库里