pyvene:深入模型内部,理解并干预神经网络行为的开源工具
我们使用大语言模型时,通常只看到两头:输入一句「苹果有什么好处?」,输出一段关于膳食纤维和植物化合物的回答。
中间那几十层计算被折叠掉了。Token Embedding 把文本变成向量,Attention 计算 token 之间的关联,MLP 做非线性变换,Hidden States 在层与层之间传递信息,最后 Logits 给出下一个 token 的分数。结果由这些内部状态决定,但我们没有任何接口去碰它们。
于是问题变得很具体:能不能在前向传播的某一层读出内部表示?能不能把 A 输入的表示换成 B 输入的表示?能不能把某组神经元置零,看行为怎么变?
这正是 pyvene 要解决的问题。它是 Stanford NLP 团队开源的 Python 库,把「干预(Intervention)」做成可配置、可组合、可训练的操作,用来研究 PyTorch 模型的内部机制。论文发表在 NAACL-HLT 2024 的 System Demonstrations,采用 Apache-2.0 许可证。
一、为什么只盯着输入输出不够
传统开发围绕三样东西转:改输入、改数据、改参数。
output = model(input_ids)
这套方法能改变行为,却很难回答一个更细的问题:内部究竟哪个环节导致了这次输出?
比如模型答错了,你可能想知道:
- 错误是从哪一层开始出现的?
- 某个 Attention Head 有没有参与这次判断?
- 某组神经元是否编码了这条知识?
- 把某一层的表示换掉,答案会不会变?
- 去掉某个特征,行为会不会崩?
这些问题的共同点是:它们都需要在模型运行过程中动手,而不只是看最终结果。
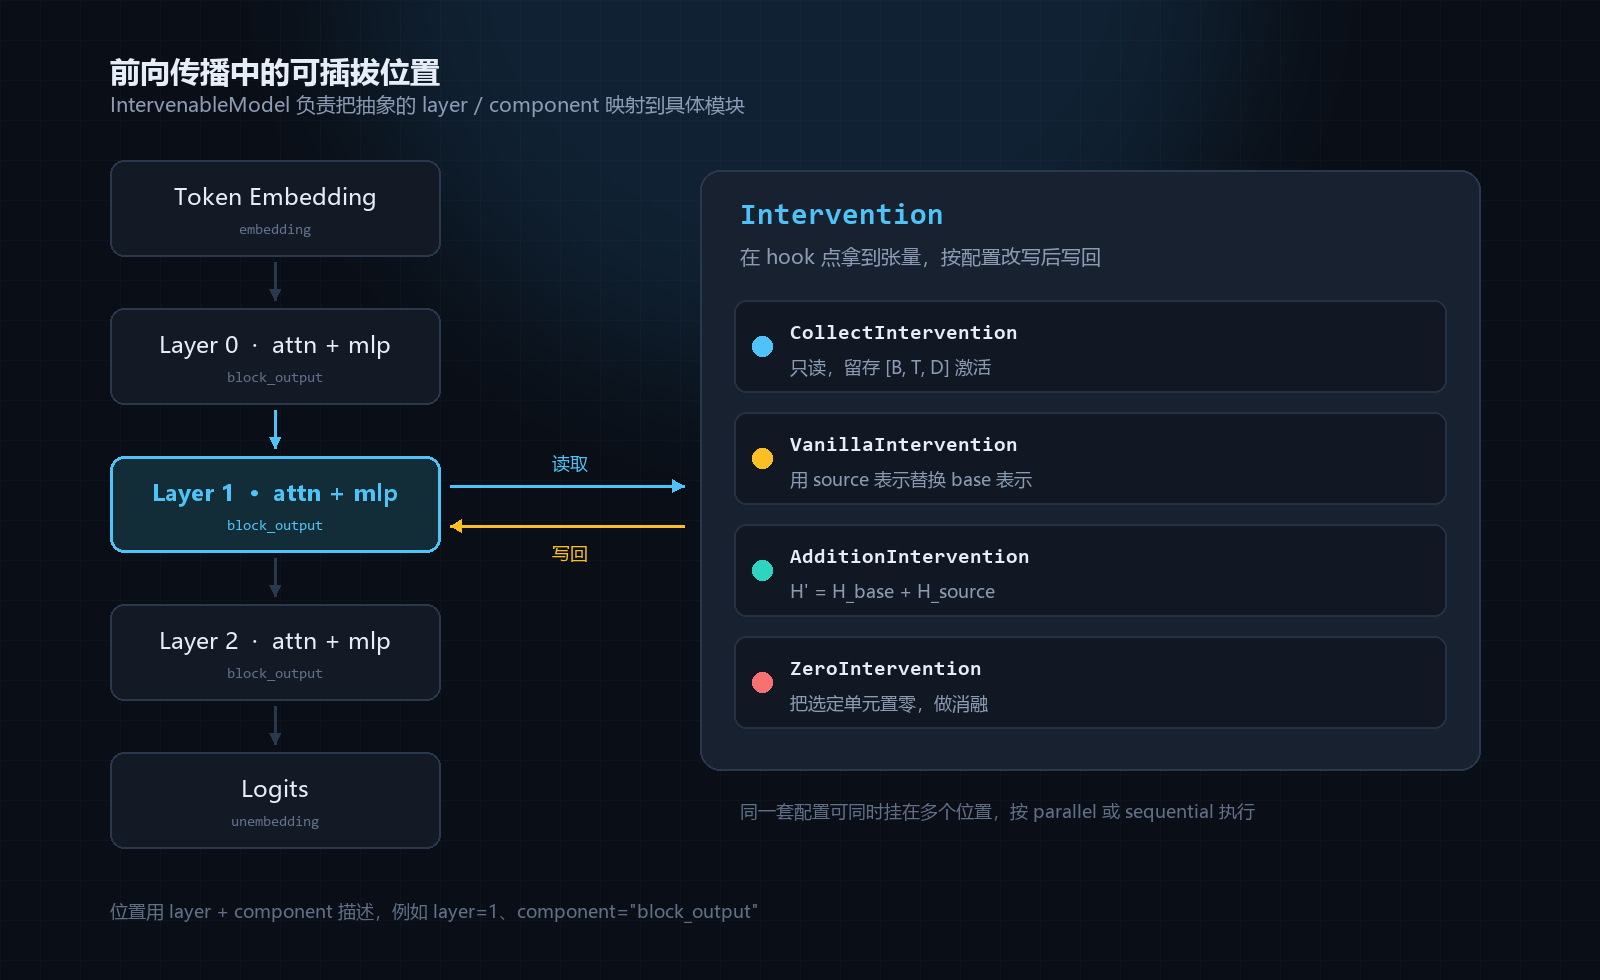
示意:pyvene 在 embedding、每层 block_output、attention / mlp 输出等位置留下 hook 点,把张量交给 Intervention 改写后再放回去。
二、核心思想:把干预当作基本操作
pyvene 的设计取向,是不去重写模型,而是在模型内部留出可操作的接缝。
普通执行是一条单向流水线:
输入 → Embedding → Layer 1 → Layer 2 → Layer 3 → 输出
接入 pyvene 之后,流水线上多了几个可以伸手进去的窗口:
输入 → Embedding → Layer 1 → Layer 2 ─┬─ 读取内部表示
                                      ├─ 替换内部表示
                                      ├─ 修改特征激活
                                      └─ 注入其他输入的表示
                                       ↓
                                    Layer 3 → 输出
关键在于「不重写模型」。你不需要为了做一次消融实验去 fork 一份 modeling_llama.py,也不需要自己维护一套 hook 注册与生命周期管理。干预被描述成一份结构化配置,挂在模型上执行。
三、Intervention 能做什么
某一层产生的张量通常写作:
\[H \in \mathbb{R}^{B \times T \times D}\]其中 $B$ 是 batch size,$T$ 是序列长度,$D$ 是隐藏维度。pyvene 的操作对象就是这个张量(或它的子集)。
1. Activation Patching:激活值替换
准备两个输入:
输入 A(base):  法国的首都是哪里?
输入 B(source):德国的首都是哪里?
分别跑一遍模型,拿到同一层的表示 $H_A$、$H_B$,然后把 A 在某个位置的表示换成 B 的:
\[H'_A = H_B\]继续前向,观察输出是否从「巴黎」变成「柏林」。
这类实验叫 Activation Patching,也叫 Activation Interchange。它是判断「某个内部表示是否参与了某个行为」最直接的实验手段。
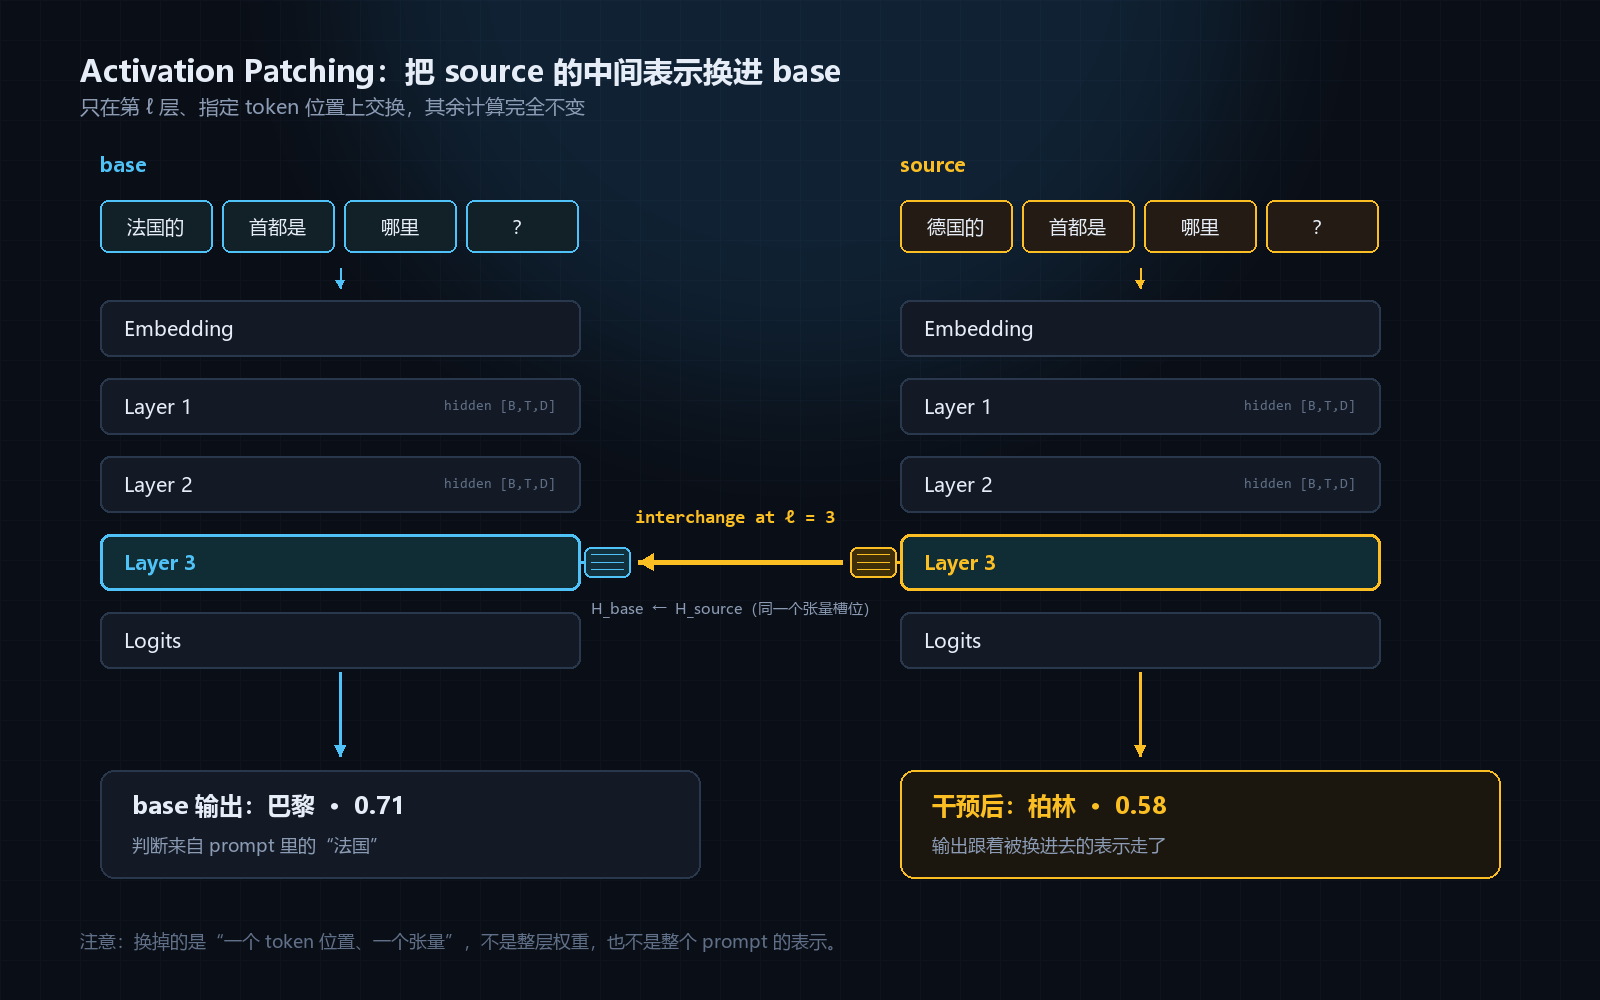
示意:只在第 3 层、单个 token 位置上交换表示,其余计算完全不变;输出跟着被换进去的表示走了。
2. Zero Intervention:把激活置零
想知道某个特征重不重要,最粗暴的办法是把它清零:
\[H' = 0\]然后比较输出。如果原来答对、置零后答错,这个位置就值得进一步查。
注意一件事:置零激活值不等于删除模型权重。 它改的是一次前向计算中的中间表示,不是磁盘上的参数文件。这两件事经常被混为一谈。
3. Addition Intervention:激活相加
除了替换和置零,还可以往表示里加东西:
\[H' = H_A + H_B\]这是很多 Steering 实验的起点。但要清醒:直接相加不代表模型会按人类预期理解新增的信息,是否出现目标行为必须靠实验验证,而不是靠直觉。
4. Trainable Intervention:可训练干预
pyvene 不只提供固定操作,也提供带可训练参数的干预模块,把「怎么改表示」本身变成学习目标。仓库里目前有一批实现:
| 干预类型 | 主要用途 |
|---|---|
ZeroIntervention | 将选定表示置零,做消融 |
VanillaIntervention | 用 source 表示替换 base 表示 |
AdditionIntervention | 将 source 表示加到 base 上 |
SubtractionIntervention | 从 base 中减去 source 表示 |
CollectIntervention | 只收集、不改写,用于读取激活 |
RotatedSpaceIntervention | 在学习到的旋转空间中做干预(DAS) |
BoundlessRotatedSpaceIntervention | 不依赖低维瓶颈的旋转干预 |
LowRankRotatedSpaceIntervention | 低秩旋转,参数更省 |
SigmoidMaskIntervention | 学习一个软掩码,再按阈值离散化 |
AutoencoderIntervention | 在自编码器潜在空间中干预 |
NoiseIntervention | 注入噪声,做鲁棒性测试 |
这些实现覆盖了原始表示空间、旋转后的表示空间和自编码器潜在空间三种位置。这一步让 pyvene 从「观察工具」跨到了「研究如何改写行为」。
四、四个组成部分
pyvene 把干预拆成四个互相独立的关注点:在哪里干预、怎么干预、谁负责执行、如何复用。
1. Representation:指定干预位置
首先要说清楚干预挂在哪个组件上。常见粒度包括:
- 某一层;
- 某个 Attention Head;
- 某个 MLP 模块;
- 某一组神经元(维度子空间);
- 某个 token 位置的表示。
不同模型的内部结构不一样,pyvene 负责把这种抽象描述映射到具体的 PyTorch 模块上。这也是它最容易被低估的部分——跨架构的定位逻辑比干预算子本身更难写。
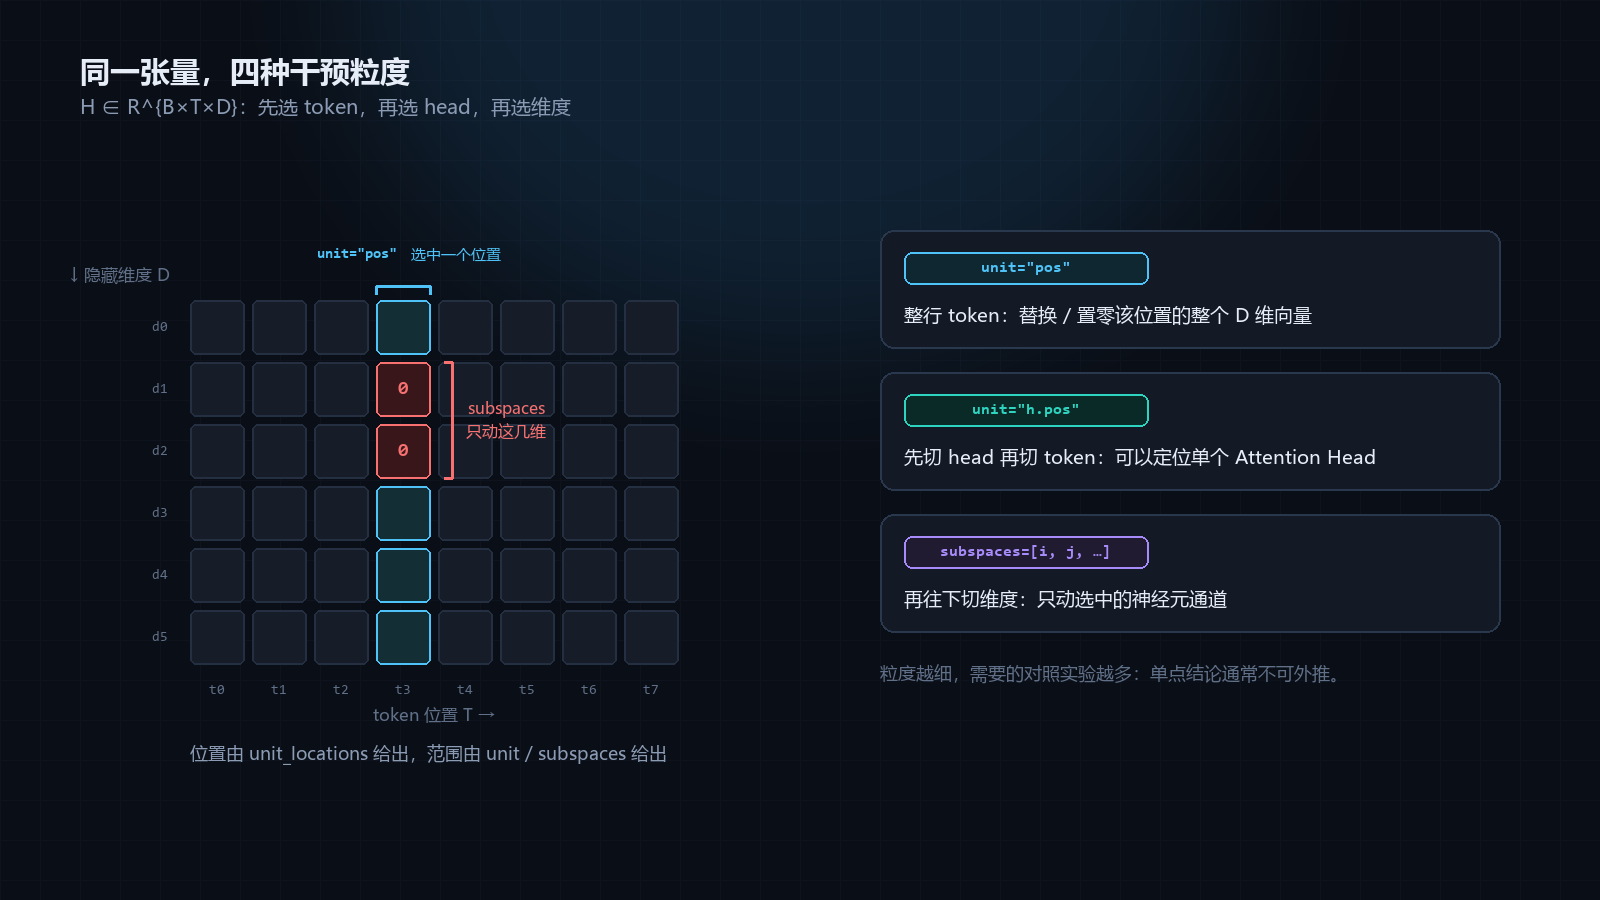
示意:unit="pos" 选整行 token,unit="h.pos" 再切 head,subspaces 再切维度通道。粒度越细,需要的对照实验越多。
2. Intervention:指定干预方式
干预方式决定张量如何被改写:置零、替换、相加、相减、只收集,或者经过一个可训练变换。上表已经列过,这里不重复。
3. IntervenableModel:负责执行
IntervenableModel 把原始模型和干预配置绑在一起,负责一整套脏活:
- 创建干预模块;
- 定位目标组件;
- 注册与管理 hook;
- 取出目标表示;
- 执行干预;
- 把改好的表示写回计算过程;
- 返回干预前后的结果。
有了这一层,你不需要为每种干预重写一套模型结构。
4. Configuration:让实验可复用
干预被描述成结构化配置(IntervenableConfig + RepresentationConfig),可以保存、加载、分享,而不是散落在一次性脚本里。
对一个需要反复做对照实验的研究者来说,这一点比多几个算子更重要:配置能序列化,实验才能比较。
五、实际怎么用
1. 安装
pip install pyvene
官方建议的导入方式:
import pyvene as pv
依赖上要注意 PyTorch 与 Transformers 的版本:pyvene 直接挂在 Hugging Face 模型的模块树上,Transformers 的大版本变化有时会连带影响组件命名。
2. 一个能跑的最小例子:置零消融
pyvene 提供 pv.create_gpt2() 这个 helper,省掉 tokenizer 与模型的样板代码:
import pyvene as pv

_, tokenizer, gpt2 = pv.create_gpt2()

config = pv.IntervenableConfig(
    representations=[
        pv.RepresentationConfig(
            layer=3,
            component="block_output",
            unit="pos",
            intervention_type=pv.ZeroIntervention,
        )
    ]
)

model = pv.IntervenableModel(config, model=gpt2)

clean, ablated = model(
    base=tokenizer("The capital of France is", return_tensors="pt"),
    unit_locations={"base": 5},          # 只对第 5 个 token 位置动手
    output_original_output=True,          # 同时拿到未干预的输出
)
这里表达的意思是:在第 3 层的 block_output 上,把第 5 个 token 的表示置零,其余位置与其余层完全不动。
3. 一次 Activation Patching
把 intervention_type 换成 VanillaIntervention,并给出 sources:
import pyvene as pv

_, tokenizer, gpt2 = pv.create_gpt2()
tokenize = lambda s: tokenizer(s, return_tensors="pt")

config = pv.IntervenableConfig(
    representations=[
        pv.RepresentationConfig(
            layer=8,
            component="block_output",
            unit="pos",
            intervention_type=pv.VanillaIntervention,
        )
    ]
)
model = pv.IntervenableModel(config, model=gpt2)

clean, patched = model(
    base=tokenize("The capital of France is"),
    sources=[tokenize("The capital of Germany is")],
    unit_locations={"sources->base": 5},
    output_original_output=True,
)
unit_locations 里的 sources->base 表示「把 source 的这个位置换进 base 的这个位置」;这里 5 指两个输入的第 5 个 token。多 batch、多 source 时改写成嵌套列表即可。
4. 研究两个输入之间的因果关系
真实实验不会只跑一次。一个可用的流程大致是:
- 跑 base,记录原始输出与目标 token 的 logit;
- 跑 source,拿到来源表示;
- 选一层、选一个位置做交换;
- 逐层重复,得到「层 → 输出变化」的曲线;
- 加对照组:交换无关 token、交换同义表述、随机置换,确认变化不是噪声。
注意第 5 步。 只跑一次干预、看到输出变了,就宣称「找到了知识存储的位置」,是这类实验里最常见的过度解读。位置对齐、多样本、对照实验、统计检验,一个都不能省。
六、值得关注的研究方向
1. 机制可解释性
传统解释关注输入输出之间的相关性;机制可解释性关心的是「内部通过什么计算过程产生了这个行为」:
- 哪些神经元对应某种语义特征?
- 哪些 Attention Head 在传递特定信息?
- 某个概念是分布在一层,还是分散在多层的多个特征里?
- 模型如何把输入信息一步步转成输出预测?
pyvene 的价值在于:它让「干预」成为验证机制假设的默认手段,而不是无法执行的猜想。
2. 知识定位
大模型有很多参数,但没人说得清哪部分对应哪条知识。通过在不同层、不同位置做干预,可以看到知识相关信息的分布。
但要强调:知识通常不是存放在单个神经元里的。 它更可能分布在多层、多特征之间,任何「一个神经元 = 一个概念」的结论都需要极强的证据。
3. 模型行为引导(Steering)
如果能定位某种行为对应的表示方向,就可以尝试修改它:
- 改变某些语义特征的强度;
- 研究模型对特定概念的响应;
- 比较不同 steering 策略的效果。
AdditionIntervention 和可训练干预可以作为这类实验的基础设施,但 pyvene 本身不是一套生产级的行为控制系统,效果必须针对具体模型和任务验证。
4. 鲁棒性
主动扰动内部状态,测试模型在不同条件下的稳定性:
原始输入 → 正常推理 → 记录输出
              ↓
         修改内部表示
              ↓
         再次推理 → 比较输出变化
系统性地扫不同层的激活扰动,可以画出模型对内部扰动的敏感度分布。这类结果对模型压缩、量化和对抗鲁棒性都有参考价值。
七、pyvene 与 NNsight 的区别
两者都能碰模型内部,但抽象层次不同:
| 对比维度 | pyvene | NNsight |
|---|---|---|
| 核心定位 | 内部表示干预框架 | 内部追踪与干预的执行基础设施 |
| 主要抽象 | Intervention(配置化) | Trace(代码化) |
| 内部状态读取 | 支持 | 支持 |
| 激活值替换 | 支持 | 支持 |
| 激活值置零 | 支持 | 支持 |
| 可训练干预 | 多种内置实现,直接接优化器 | 可用追踪与修改机制自行搭建 |
| 干预配置 | 结构化、可序列化、可分享 | 以追踪代码与执行流程为核心 |
| 研究重点 | 因果干预、表示修改、ReFT | 执行模型内部代码、远程运行大模型 |
| 典型用户 | 机制可解释性、模型编辑研究者 | 模型分析、调试、大模型内部状态研究者 |
两者不是替代关系。
想系统比较不同的内部表示干预方式,pyvene 的抽象更省事;想在执行过程中灵活读写中间变量、甚至把干预搬到远程的大模型上跑,NNsight 更合适。博客里另有一篇专门讲 NNsight 的文章,可以对照看。
八、从干预走向 ReFT
pyvene 还有一个值得关注的方向:ReFT(Representation Fine-Tuning,表示微调)。
传统微调直接更新参数:
\[\theta' = \theta + \Delta\theta\]ReFT 的思路是把可训练变换放在内部表示上:
\[h' = h + \Delta h, \qquad \Delta h = R(h)\]其中 $R$ 是一个低秩的可训练模块。基座参数完全冻结,只有 $R$ 需要训练和保存。
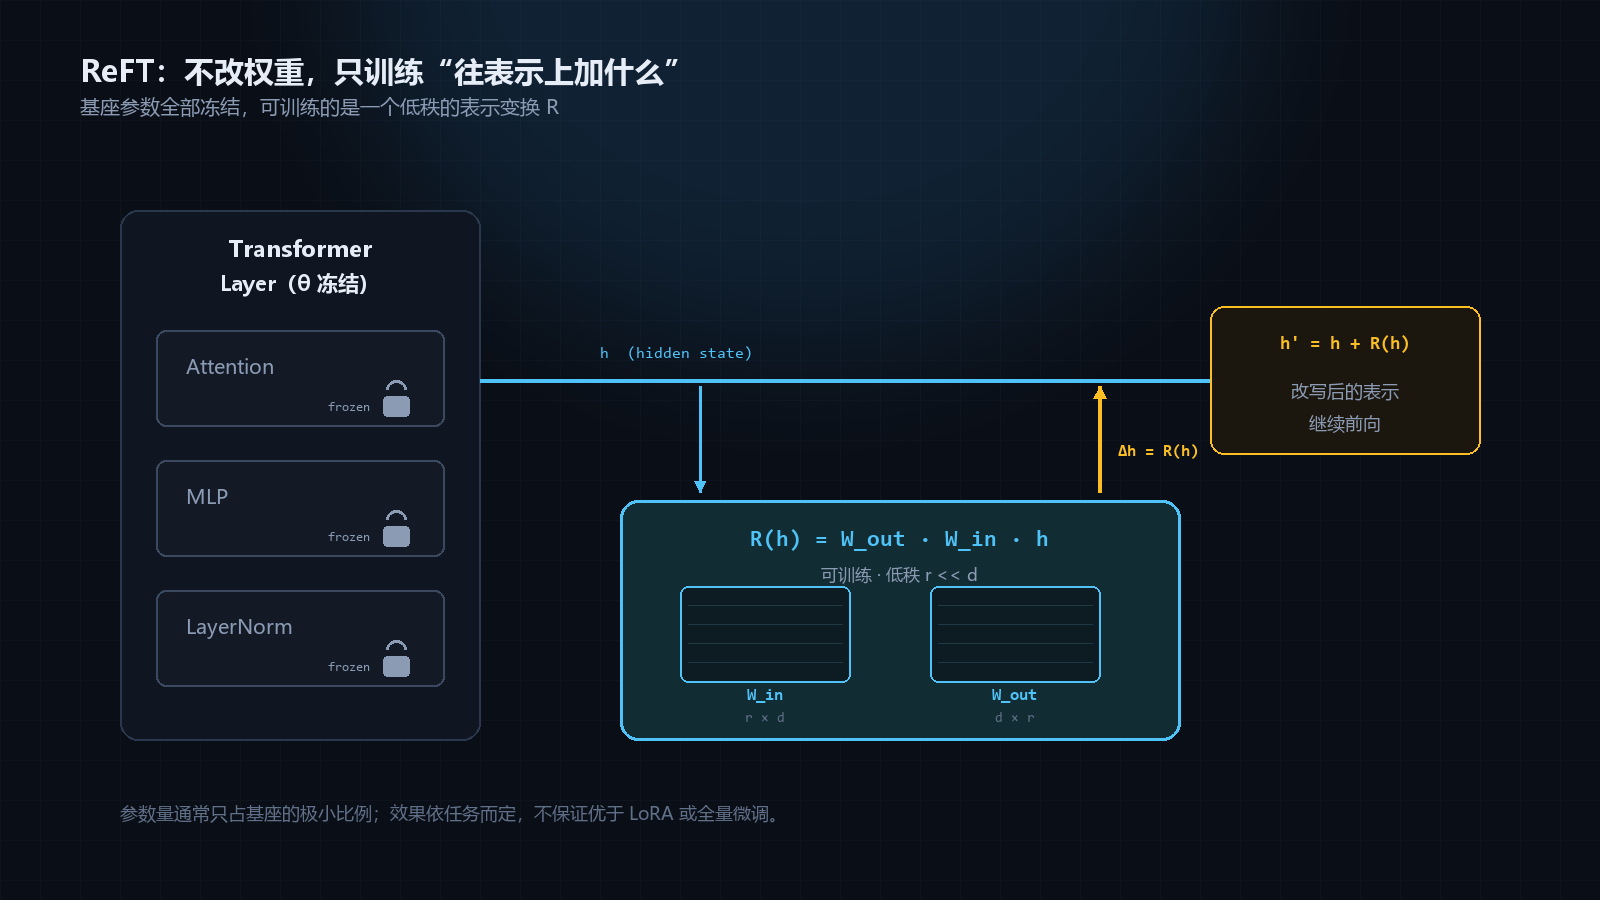
示意:冻结的 Transformer 层 + 可训练的低秩表示变换,改动发生在 hidden state 上,而不是权重上。
这条路的研究价值在于:
- 探索比全参数微调更轻量的适配方式;
- 研究内部表示与任务行为之间的对应关系;
- 降低模型编辑的参数与存储成本;
- 让表示干预策略可以独立保存、组合和复用。
同样要克制:ReFT 不意味着不用训练,也不保证在所有任务上优于 LoRA 或全量微调。 它改变的是「在哪里学」,不是「要不要学」。
九、优势与局限
优势
- 不需要重写模型。 官方目标是支持多种 PyTorch 架构:RNN、ResNet、CNN、Mamba、Transformer 都在覆盖范围内。
- 干预有统一抽象。 不同的干预方式共享同一套配置与调用接口。
- 支持组合。 可以在多个位置、不同神经元粒度、不同执行顺序上安排干预。
- 支持可训练干预。 不只是静态替换,也能训练表示变换。
- 适合复现。 结构化配置可以保存和分享,实验不再是「某个人电脑上的一段脚本」。
局限
- 需要理解模型内部结构。 pyvene 屏蔽了一部分差异,但复杂架构仍然要求你知道模块名与张量布局。
- 干预结果不等于因果结论。 输出变了,不代表某个神经元独立承担了某种知识。
- 跨模型兼容性有差异。 模型结构、hook 位置、输出格式、KV cache 机制、Transformers 版本都可能影响实际行为。
- 有运行开销。 加 hook、存激活、做额外变换都要花时间与显存。
- 不是训练或部署平台。 它只负责内部表示干预,不提供训练、推理服务与评估体系。
十、怎么学:一条不那么容易放弃的路径
不建议一上来就啃复杂的模型编辑算法。
第一阶段:先看懂内部表示。 拿一个小 Transformer,把 embedding 输出、每层 hidden states、attention 输出、MLP 输出、最终 logits 都打印一遍,弄清楚每个张量的形状和含义。
第二阶段:把基础干预跑一遍。 按顺序做 Collect、Zero、Addition、Subtraction、Interchange,每个实验都记录原始输出、干预输出和激活变化。
第三阶段:做 Activation Patching。 设计一对只差一个因素的输入(法国的首都 / 德国的首都),逐层替换,画出「层 → 输出变化」的曲线。再细到 token、head、神经元子空间。
第四阶段:碰可训练干预。 从 RotatedSpaceIntervention 和 LowRankRotatedSpaceIntervention 入手,再往 BoundlessRotatedSpaceIntervention、AutoencoderIntervention 和 ReFT 走。
十一、总结
pyvene 最有价值的地方,不是提供了几个改激活值的函数,而是提供了一套研究神经网络内部机制的统一实验框架。
过去我们只能通过数据、参数和提示词去影响模型;现在可以进一步问:
- 哪些内部表示参与了某种行为?
- 替换某一层的表示会发生什么?
- 删掉某些激活特征,输出会不会变?
- 能不能学一个新的表示变换模块?
- 能不能在不改基础模型参数的前提下完成适配?
如果做一个类比:Safetensors 让我们更方便地理解和操作模型权重,NNsight 让我们能观察和追踪模型的运行过程,pyvene 则给出了一个结构化的内部干预框架。
对希望研究大模型可解释性、模型调试、知识定位、Activation Patching 和表示微调的开发者来说,这是一个值得认真读一遍的项目。
如果只记一句话:pyvene 把「干预」从一次性的调试脚本,变成了可以描述、比较、训练和复用的对象。
顺着这个思路,一个值得动手的练习是搭一个小小的「内部干预实验台」:加载一个几亿参数的小模型,把每一层的激活值可视化出来,让干预位置、干预算子和干预前后的差异在同一个界面里对照。它比读十篇教程更能让人理解——模型在运行时究竟是如何一步步算出答案的,以及我们在哪一步动了手。
项目与论文
项目使用 Apache-2.0 许可证。本文的接口名称与调用形式依据仓库代码、官方 notebook 与 PyPI 上的 0.1.x 版本整理;仓库 main 分支的接口仍在演进(例如返回对象正在向命名字段迁移),具体字段请以你安装的版本为准。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- Blender Kiln:AI 建模缺的不是生成能力,是交付前的度量
- CineCode:每一帧都是时间的纯函数,所以电影可以被检查
- OhMyGame:AI 生成游戏不难,难的是让它自己发现游戏跑不起来
- GPT-2 的一次前向:一条 768 维的向量,被改写 12 次,变成 50257 个分数
- SAELens:重建得越准,特征越不一定是真的
- TokenEconomizer:Coding Agent 的成本按仓库累积,不按任务计价
- Transformer Explainer:把 GPT-2 塞进浏览器,让模型边算边解释自己
- Boubou:本地语音 AI 缺的不是模型,是一层能借给全屋的运行时
- Hy-MT2:把翻译拆成语言家族分头训练,再蒸馏回一个模型
- NNsight:把干预写进前向传播,让同一段代码在 405B 模型上跑