认知博弈:形式化、求解与可辨识性综述
当两个部分可观测的主体各自维护对方的模型,并且各自的行动会改变对方获得的观测时,单主体的 POMDP 框架就失效了。这类问题在不同社区有不同的名字:多智能体规划里叫交互 POMDP,行为博弈论里叫层级推理,强化学习里叫对手建模与非平稳性,机器学习里叫 performative prediction 的一个特例。
本文按四条线梳理:形式化(状态如何表示、递归在哪里截断)、表示与求解(信念如何参数化、可计算性边界在哪)、动态(长期行为能否被判别)、可辨识性(如何证明对方确实在建模你)。最后列出未解决的问题。
范围限定:只讨论双主体、部分可观测、行动可被对方观测的设定。不讨论完全信息博弈的均衡计算、机制设计,以及以大语言模型为对象的心理理论评测。
一、问题设定
两个主体 $i\in{A,B}$,状态 $s\in S$,动作 $a_i\in A_i$,观测 $o_i\in\Omega_i$。与 POMDP 的唯一差别在转移核:
\[P(s'\mid s,a_A,a_B)\]它无法再写成 $P(s’\mid s,a_i)$,因为 $a_B$ 由 B 的信念决定,而 B 的信念由 A 的历史动作决定。转移核依赖于对手的内部状态,而这个状态不可观测,这一条就是全部困难的来源。
把这件事写开,是两个耦合式:
\[a_B=\pi_B(b_B),\qquad b_B'=\tau_B\big(b_B,\ o_B(a_A,s)\big)\]第一式说对手按自己的信念选动作,第二式说对手的信念由「他看到了什么」更新,而他看到什么取决于 A 的动作。把两式代回转移核,闭环就出现了。读法:$P(s’\mid s,a_A,a_B)$ 里的 $a_B$ 不是外生噪声,是另一个主体的策略输出。
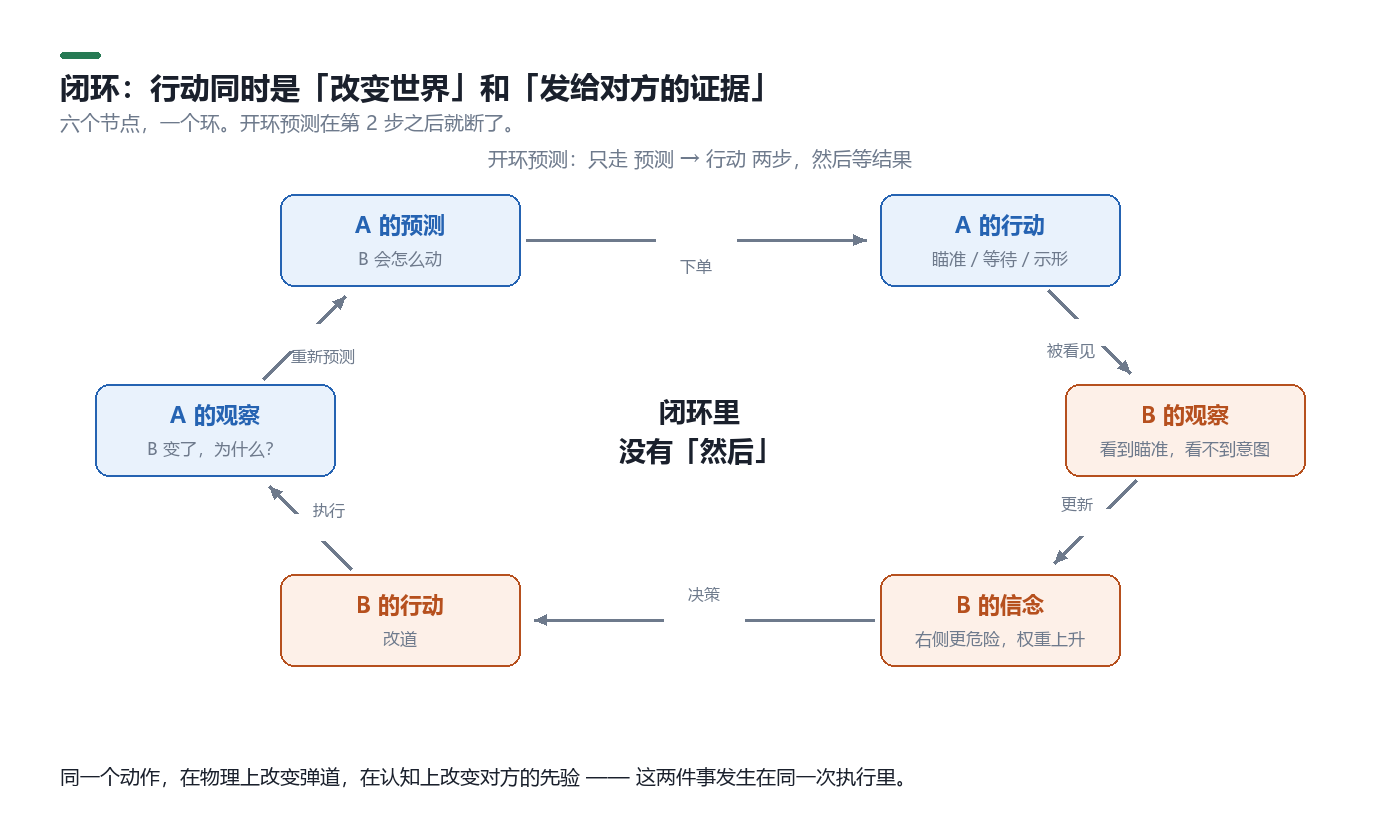
交互闭环。开环预测在第二步就终止;闭环里行动同时是状态转移和信号。
由此产生三个后果,后文依次展开:
- 最优策略不再是 POMDP 意义下的最优,因为环境在适应你;
- 对手模型的误差会通过闭环放大或衰减,方向取决于对方如何响应;
- 从观测数据中辨识对手模型是欠定的,除非引入干预。
二、形式化谱系
2.1 从 POMDP 到交互状态
POMDP 的标准形式见 Kaelbling、Littman 与 Cassandra 的经典表述(doi:10.1016/S0004-3702(98)00023-X):信念是状态空间上的分布,策略是信念到动作的映射。
I-POMDP 的改动只有一处:把对手的心理状态并入状态(Gmytrasiewicz & Doshi, 2005, doi:10.1613/jair.1579)。交互状态定义为
\[\mathrm{IS}_{ij}=S\times M_j,\qquad M_j=\Theta_j\times B_j\]其中 $\Theta_j$ 是 $j$ 的类型(目标、能力、策略类),$B_j$ 是 $j$ 的信念。主体 $i$ 的信念 $b_i$ 定义在 $\mathrm{IS}_{ij}$ 上,策略是 $b_i$ 的函数。由于 $M_j$ 中含 $b_j$,而 $b_j$ 又定义在包含 $M_i$ 的空间上,定义天然是递归的。
信念的更新式与 POMDP 同形,只是求和跑在交互状态上:
\[b_i'(\mathrm{IS}')\ \propto\ O_i\big(o_i\mid \mathrm{IS}',a_i\big)\sum_{\mathrm{IS}}T\big(\mathrm{IS}'\mid \mathrm{IS},a_i,a_j\big)\,b_i(\mathrm{IS})\]读法:$O_i$ 是观测似然,$T$ 是交互状态之间的转移,$a_j$ 由对手在该交互状态下的策略给出。与单主体的差别只有一处 —— 求和同时也在更新「对手的模型」,因此 $b_i$ 的支撑集包含 $M_j$,维度随嵌套层数增长。
2.2 递归与截断
处理递归有两条路,工程上常用第一条。
有限嵌套(finitely nested):第 0 层主体的模型是普通 POMDP,第 $\ell$ 层主体的模型里包含第 $\ell-1$ 层的对手模型。这是 I-POMDP 的标准做法,解概念是对应的贝叶斯纳什均衡。
类型空间:不完全信息博弈里,无限层信念由类型空间刻画,其存在性有一般结论(Harsanyi 的类型空间)。代价是空间连续、层级无界,直接求解不可行。
截断的代价目前没有统一界。少一层,等价于假设对手不建模你;多一层,引入一条无法直接验证的假设。层数在实践中是超参数,不是推导出来的量。
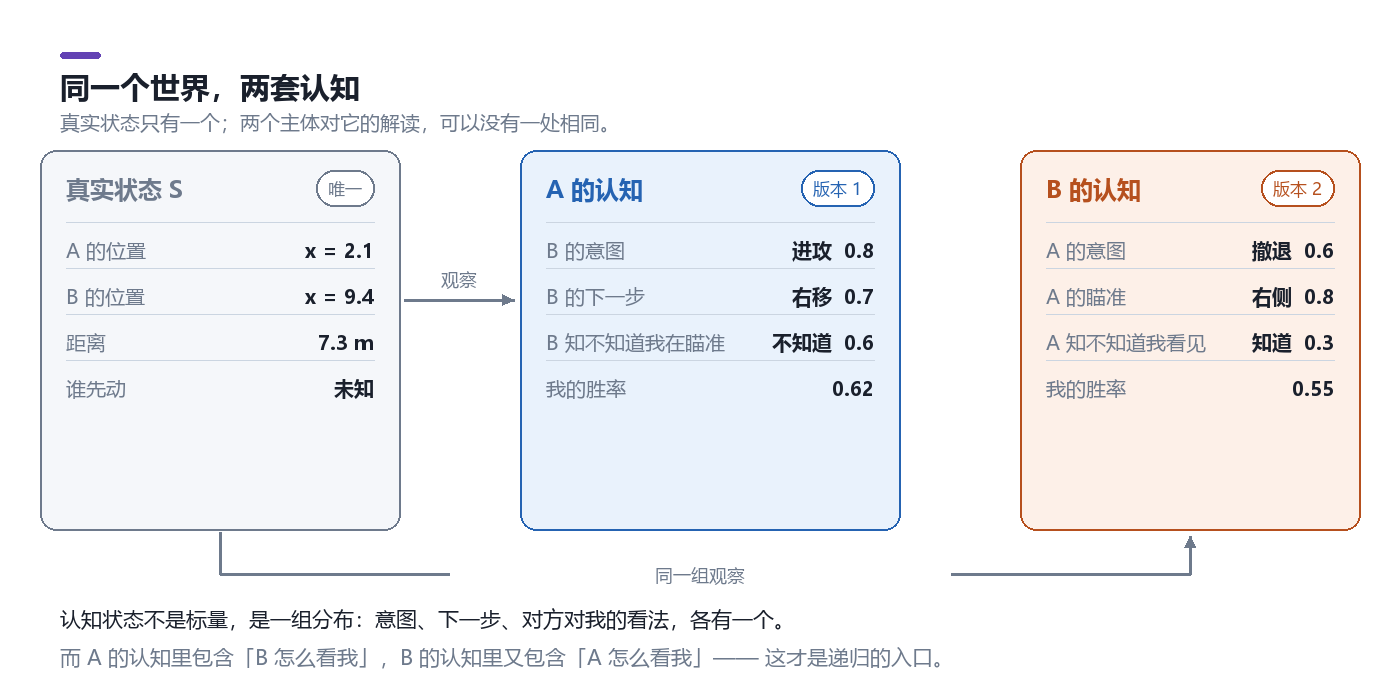
左侧是物理状态,中间与右侧是两个主体各自的交互状态。同一个 $S$,两个 $M$,三栏没有一行相同。
2.3 层级模型
行为博弈论给出了另一条截断路径:不建模完整信念,只建模推理深度。
- level-k:$L_0$ 外生给定(随机、均匀或固定启发式),$L_k$ 对 $L_{k-1}$ 做最优反应。$L_0$ 不含任何关于对手的推理,这一点常被写错:把「根据对手历史行为预测」当作 $L_0$,实际上已经引入一层对手模型,它是 $L_1$(Nagel, 1995;Stahl & Wilson, 1995, doi:10.1006/game.1995.1031)。
- 认知层级(CH):把对手的层级视为一个分布,$L_k$ 对该分布的加权组合做最优反应,并截断到 $K$(Chong, Ho & Camerer, 2016, doi:10.1016/j.geb.2016.08.007)。
两者的差别不只是记号:level-k 是确定性的相邻层反应,CH 是分布式的加权反应。CH 多一个可估参数(层级分布的均值),也因此更容易过拟合实验数据。二者共享同一个识别困难:估出来的层级分布依赖于 $L_0$ 的设定,换一个锚,结论就变。
写成递推,差别一目了然:
\[a_k=\operatorname{BR}\big(a_{k-1}\big),\qquad a_{\mathrm{CH}}=\operatorname{BR}\Big(\textstyle\sum_{k\ge 1}p_k\,a_k\Big)\]读法:左边每次只对上一层做最优反应,链条是确定的;右边对「层级的混合」做最优反应,$p_k$ 常取截断泊松,其均值 $\tau$ 就是那个多出来的参数。$\tau$ 让模型能拟合「多数人停在一到两层」这类分布,代价是它同时吸收了一部分本该由 $L_0$ 解释的方差。
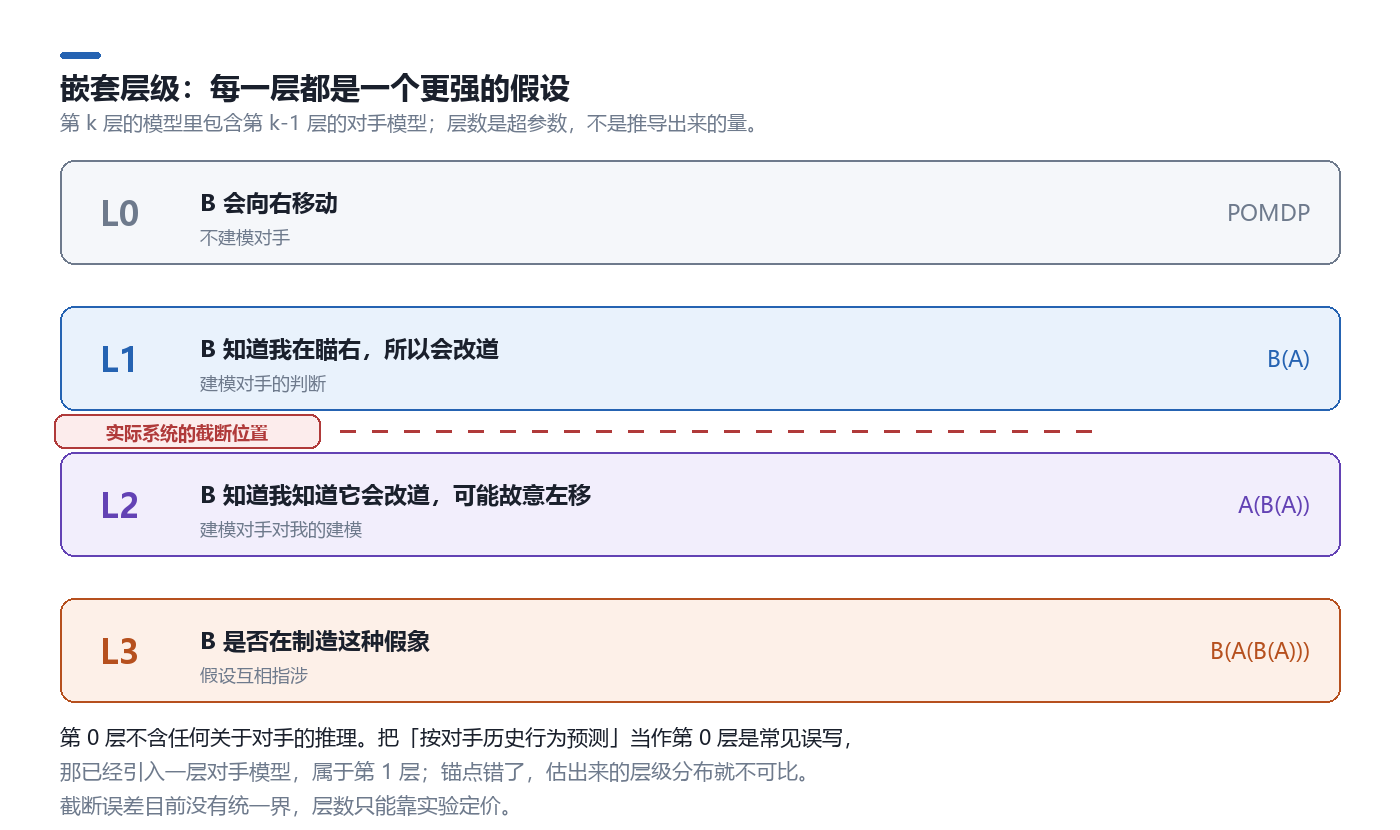
四层推理。实际系统通常在一到两层截断,截断位置没有原则性的选择依据。
2.4 框架对照
| 框架 | 状态 | 对手模型 | 解概念 | 主要限制 |
|---|---|---|---|---|
| POMDP | $S$ | 无 | 信念上的最优策略 | 对手被并入环境,转移核非平稳 |
| I-POMDP | $S\times M_j$ | 类型 + 信念,有限嵌套 | 分层贝叶斯纳什均衡 | 模型空间连续,精确解不可行 |
| level-k | 无显式状态 | 离散层级假设 | 逐层最优反应 | 层级需外生指定,不解释学习 |
| CH | 无显式状态 | 层级分布 | 对混合分布最优反应 | 分布参数需拟合,识别性弱 |
| 对手建模 + RL | 学习到的隐表示 | 参数化网络 | 近似最优 | 表示无语义约束,可辨识性未知 |
三、对手模型的表示与更新
3.1 三类表示
类型:假设对手属于有限假设集(激进/保守、合作/背叛)。更新是对假设集的贝叶斯更新,计算便宜,但假设集之外的对手无法表示。
策略类:假设对手属于某个参数化策略族,学习其参数。表达力强,但需要假设族的正确性。
信念:直接维护对手对交互状态的分布。这是 I-POMDP 的做法,语义最清楚,代价是维度最高。
3.2 多模态与维度代价
对手的未来很少是单峰的。常用高斯混合:
\[P(X_B\mid H_A)=\sum_{k=1}^{K}w_k\,\mathcal{N}(\mu_k,\Sigma_k)\]其中 $X_B$ 同时包含物理量与认知量(位置、速度、意图、目标、对 A 的信念)。三个符号各管一件事:$w_k$ 是第 $k$ 个假设的权重($\sum_k w_k=1$),$\mu_k$ 是它预测的位置,$\Sigma_k$ 是不确定性的形状与朝向。
读法:单个高斯说的是「他会往这个方向走,误差有这么大」;混合权重说的是「我有多相信这一种可能」。前者是几何,后者是赌注。
分量数大致按「方向数 × 意图数 × 嵌套层数」相乘增长:三方向、三意图、两层已经是 18 个分量,每个分量还要维护协方差。
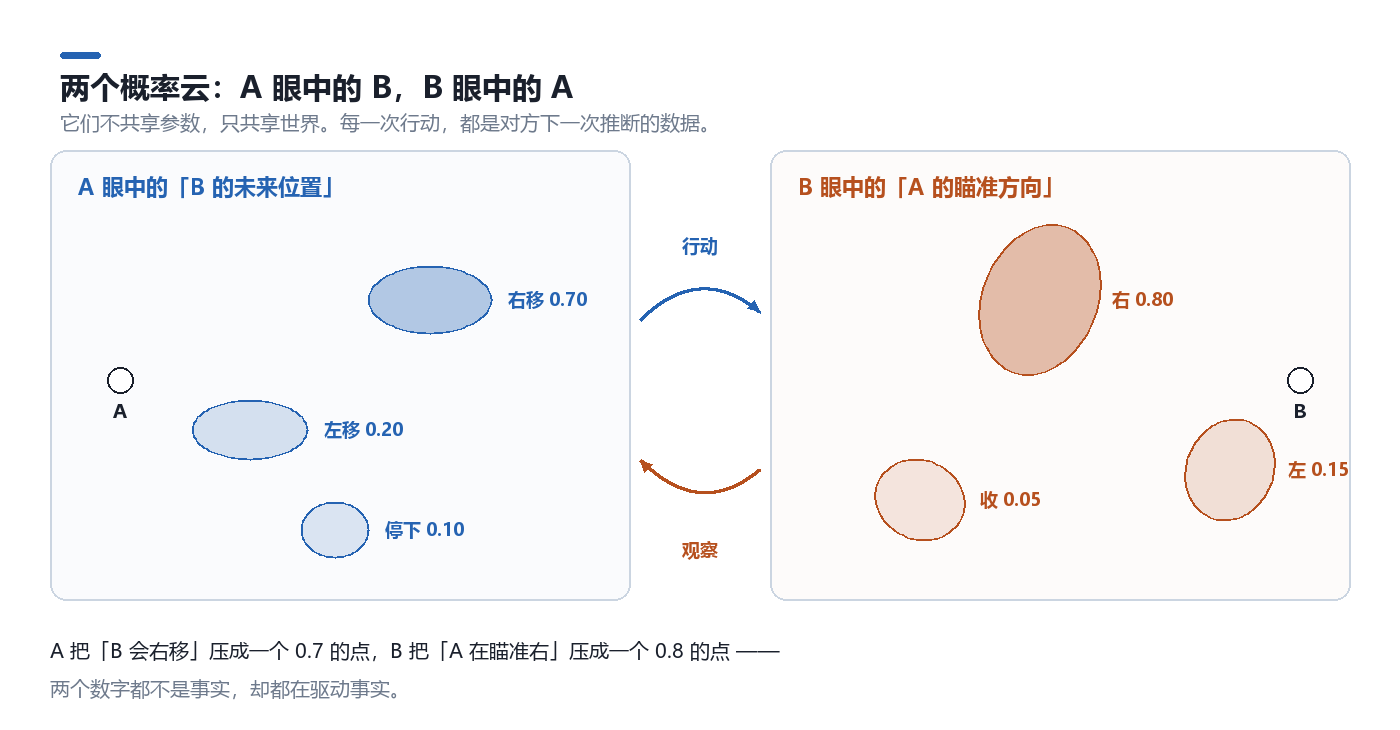
两个主体的信念互不共享参数。注意它们没有共同坐标系:A 的云里有一块是「B 认为我在瞄左」,B 的云里有一块是「A 认为我会右移」。
这带来一个常被回避的问题:两个信念分布在数学上不可直接比较。 要让它们可比,必须先声明一个距离:
\[D_{\mathrm{KL}}(p\,\|\,q)=\sum_{x}p(x)\log\frac{p(x)}{q(x)}\]读法:它衡量「用 $q$ 编码 $p$ 的样本要多付多少比特」,所以 $D_{\mathrm{KL}}(p|q)\neq D_{\mathrm{KL}}(q|p)$,也不满足三角不等式。用它做「收敛」判据时,交换两个参数会得到不同的结论;换成对称化版本又会改变收敛点的位置。这不是实现细节,它决定了第五节判据能否成立。
3.3 学习式对手模型
另一条路线是不显式建模信念,直接用元学习从行为中抽取对手表示。ToMnet 是代表工作:用少量行为轨迹生成 agent embedding,再做后续预测,并在 Sally-Anne 一类错误信念任务上验证(Rabinowitz 等, ICML 2018, arXiv:1802.07740)。
优点是免去手工类型设计;代价是表示没有语义约束。一个能预测行为的 embedding,不一定是信念。 它可能编码了对手的策略相关性,而在对手改变策略后失效。这一点第七节会形式化。
四、求解与学习
4.1 可计算性边界
POMDP 的规划问题已经是 PSPACE-hard(Papadimitriou & Tsitsiklis, 1987, doi:10.1287/moor.12.3.441)。I-POMDP 在此基础上又乘上一个连续的模型空间,精确解在一般情形下不可行。这不是工程优化能绕开的问题,只能靠截断与近似。
4.2 规划式路线
做法固定:限定嵌套层数、近似信念更新、在每层上解一个有限的 POMDP。复杂度大致随层数与对手动作空间相乘增长,因此实际系统多在一到两层截断,或用一个标量摘要对手(如「激进程度」)替代完整模型。
4.3 学习式路线
MARL 把同一困难表述为环境的非平稳性:每个智能体的策略都在变,别人的策略因此不构成环境的一部分。MADDPG 用集中训练、分散执行缓解这一点,并指出 Q-learning 在此设定下直接失效(Lowe 等, NeurIPS 2017, arXiv:1706.02275)。
LOLA 更进一步,把对手的参数更新写进自己的梯度:每个智能体对「我的策略会如何改变对方的更新」求导(Foerster 等, AAMAS 2018, arXiv:1709.04326)。它属于对手学习感知,与 I-POMDP 的差别在于:前者建模对手的学习动力学,后者建模对手的信念。
4.4 主动推断的边界
主动推断把策略选择写成期望自由能的最小化。离散状态空间上的标准写法是:
\[G(\pi)=\mathbb{E}_{q(o,s\mid\pi)}\Big[\log q(s\mid\pi)-\log p\big(o,s\mid C\big)\Big]\]读法:$q(s\mid\pi)$ 是在策略 $\pi$ 下对状态的推断,$C$ 是偏好(先验偏好结果)。第一项惩罚「被迫改变看法」,对应认知价值;第二项惩罚「偏离偏好的结果」,对应实用价值。最小化 $G$ 因此既在追目标,也在收集信息。具体分解成几项,取决于生成模型如何因子化,因此不同教材写出的形式并不完全一致(详见 Da Costa 等的综述,doi:10.1016/j.jmp.2020.102447)。
这条线里与递归最接近的是 sophisticated inference:对「我将来的信念」做递归树搜索,把未来的认知状态计入当前价值(doi:10.1162/neco_a_01351)。
需要明确边界:sophisticated inference 递归的是自己的未来信念,不是另一个主体的信念。 它提供的是「如何把信息寻求写进目标函数」,不提供对手模型。把主动推断直接等同于认知博弈,会把一个可检验的建模问题变成不可检验的叙事。
五、长期行为的判别
两个主体持续互相更新时,系统的长期行为是经验问题,不是定义问题。常见五类,每类需要一个判据和一个必须排除的替代解释:
| 模式 | 判据 | 需要排除的解释 |
|---|---|---|
| 收敛 | 信念间距离趋于 0,策略切换停止 | 双方都不再行动,死锁同样满足 |
| 振荡 | 自相关出现周期峰,行动相位差接近 $\pi$ | 环境本身有周期,需无对手基线 |
| 分歧 | 距离单调上升,双方置信度同时上升 | 观测噪声增大导致的漂移 |
| 适应 | 切换频率稳定,胜率回归 0.5 附近 | 固定探索率也会产生同样形状 |
| 失稳 | 误差自相关为正,方差随时间放大 | 数值不稳定,需降学习率重跑 |
与动力系统语言对应:收敛是不动点,振荡是极限环,分歧与失稳对应轨线发散。这个对应有用,但它要求先有一个显式的状态转移模型;纯学习的系统没有闭式转移核,「不动点」只能事后从轨迹估计。
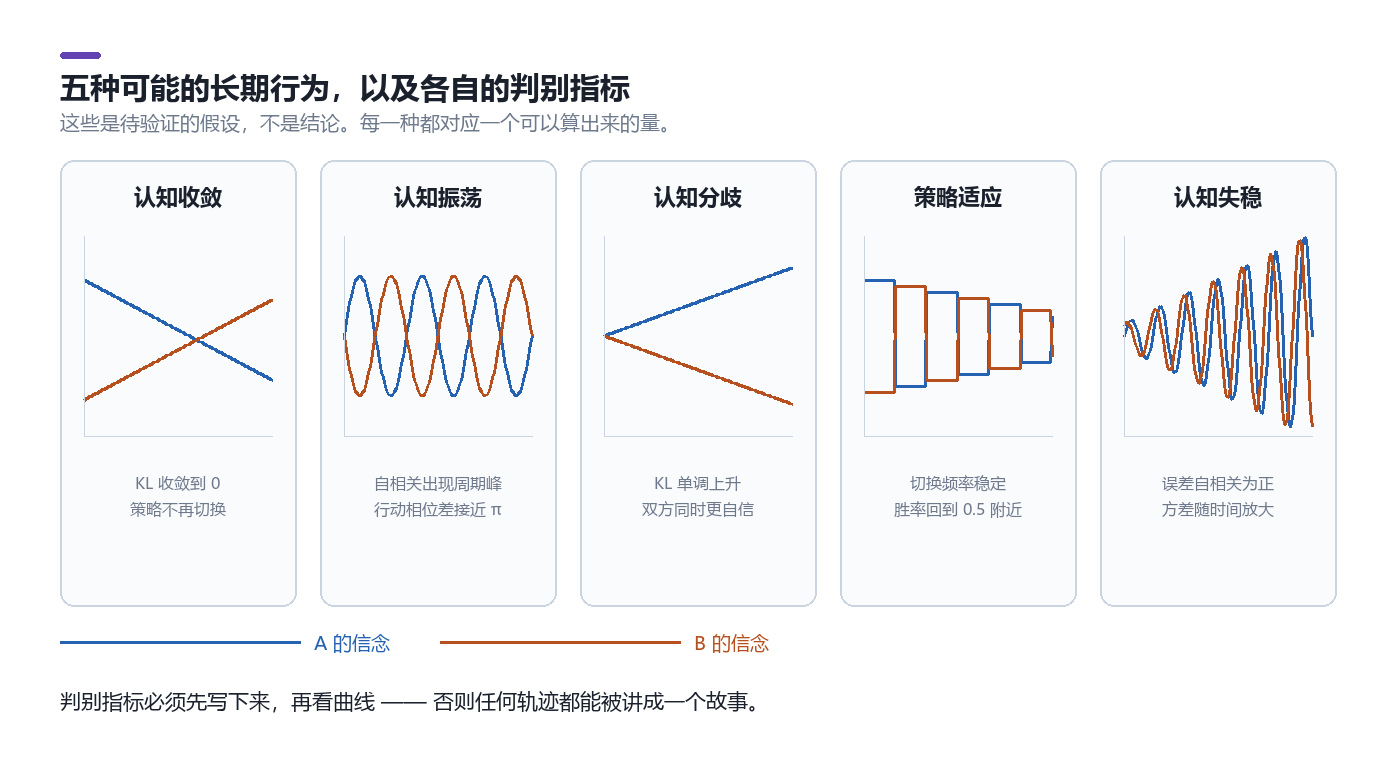
五类模式。曲线是示意,判据才是可操作的部分。
要确认其中任何一类,三个前提缺一不可:显式转移模型、足够多的随机种子、跑之前定好的指标。缺一项,结论只能停在定性描述。
六、反身性:部署即干预
预测进入决策之后,会改变被预测的对象。这件事在机器学习里有形式化定义。
Performative prediction:数据分布是模型参数的函数 $D(\theta)$,训练目标是在部署分布上最小化风险。对应的稳定点称为 performative stability,即
\[\theta_{\mathrm{ps}}\in\arg\min_{\theta}\ \mathbb{E}_{z\sim D(\theta_{\mathrm{ps}})}\big[\ell(z;\theta)\big]\]注意期望取自 $D(\theta_{\mathrm{ps}})$ 而非 $D(\theta)$:预测不是对过去标定,而是对「按这个预测行动之后出现的结果」标定(Perdomo 等, ICML 2020, arXiv:2002.06673)。
读法:$\theta$ 同时出现在目标函数和采样分布里,所以这不是一个普通的最小化问题,而是求不动点 —— 参数决定了部署分布,部署分布又决定了这个参数的最优值。存在性与唯一性都需要额外条件,这正是该文讨论收敛性的地方。
相关的一条线是 strategic classification:个体在特征上做最优反应以通过分类器(Hardt 等, ITCS 2016)。二者的差别在于,前者是分布整体随模型移动,后者是个体层面的策略性操纵;在双主体设定里,两者同时发生。
与 I-POMDP 的接口是直接的:对手的策略更新,等价于转移核随时间的漂移。I-POMDP 假设转移核固定、对手模型演化;performative prediction 假设模型固定、分布演化。 两者是同一件事的两个视角,合并起来才是完整的闭环。
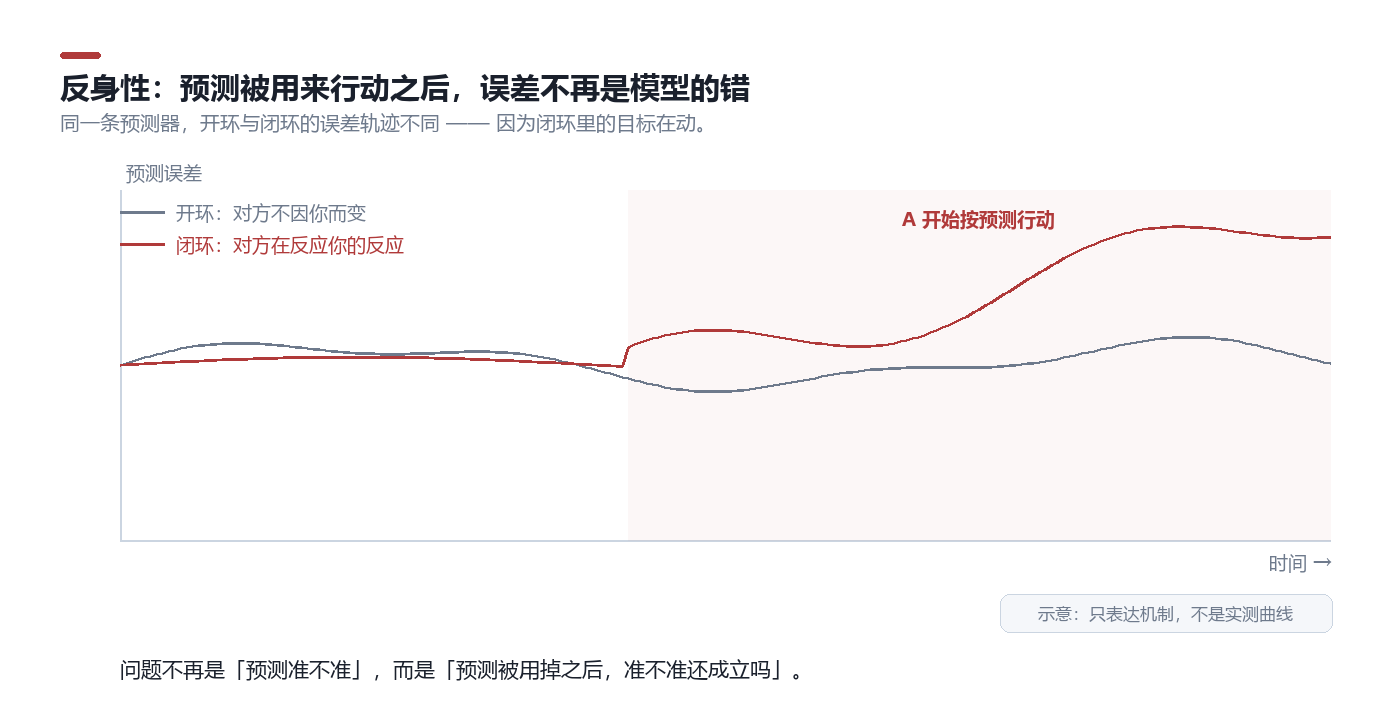
示意图。闭环可能放大误差,也可能缩小误差;它改变的是误差轨迹的形状,不是符号。
七、可辨识性
7.1 观测等价
设两个候选对手模型 $m,m’$,策略集 $\Pi$。若对一切 $\pi\in\Pi$,两者诱导的动作分布相同,则称 $m$ 与 $m’$ 在该策略集上观测等价。
具体到层级模型:一个 $L_0$ 的 B(不读 A)与一个 $L_1$ 的 B(读 A 的瞄准),在「A 的瞄准不可观测」或「A 的行动与预测无关」的条件下观测等价。纯观测数据无法区分二者,这是构造性的,不是样本量问题。
7.2 最小干预设计
要打破等价类,必须移动到使二者行为分叉的策略上。最小设计是 2×2:
| B 看得见 A 的瞄准 | B 看不见 | |
|---|---|---|
| A 按预测调整瞄准 | 有反应的证据 | 反应依赖观测 |
| A 不调整(只观察) | 反应依赖 A 的行动 | 基线 |
估计量是差分中的差分:$\big(R_{11}-R_{10}\big)-\big(R_{01}-R_{00}\big)$,其中 $R_{st}$ 是「调整瞄准 $s$、可见性 $t$」两格里的反应幅度。
读法:先在行内做差,消掉 B 的一般反应倾向;再跨行做差,消掉 A 的动作本身带来的机械影响。剩下那一项才是「B 专门针对被预测这件事」的反应。只有这一项显著,才能支撑「B 在读 A 的预测」。
但这仍有混淆:B 可能在对威胁做反应,而非对「被预测」做反应。区分需要一次证伪性探测:A 瞄准一个它认为 B 不会去的位置。 若 B 仍回避,则其在反应威胁;若不回避,甚至朝真实预测方向移动,则其读的是预测。
这一步的作用是约束假设空间,不是提高估计精度。它把「对方在建模我」从一句叙事,变成一个可以被证伪的断言。
7.3 与逆强化学习的对照
从行为反推目标,是逆强化学习的标准问题,其奖励函数在观测等价意义下欠定(Ng & Russell, ICML 2000)。认知博弈的辨识问题更弱:不仅要反推目标,还要反推「对方认为我的目标是什么」。后者没有行为层面的直接对应物,只能通过干预改变自己的策略来暴露。
7.4 报告清单
鉴于上述困难,建议这类实验至少报告:嵌套层数与截断依据、对手模型的假设集、四种对照下的行为差异(含置信区间)、信念距离的轨迹而不只是终点、随机种子数量、以及预注册的判据。缺少任何一项,跨工作的比较都不成立。
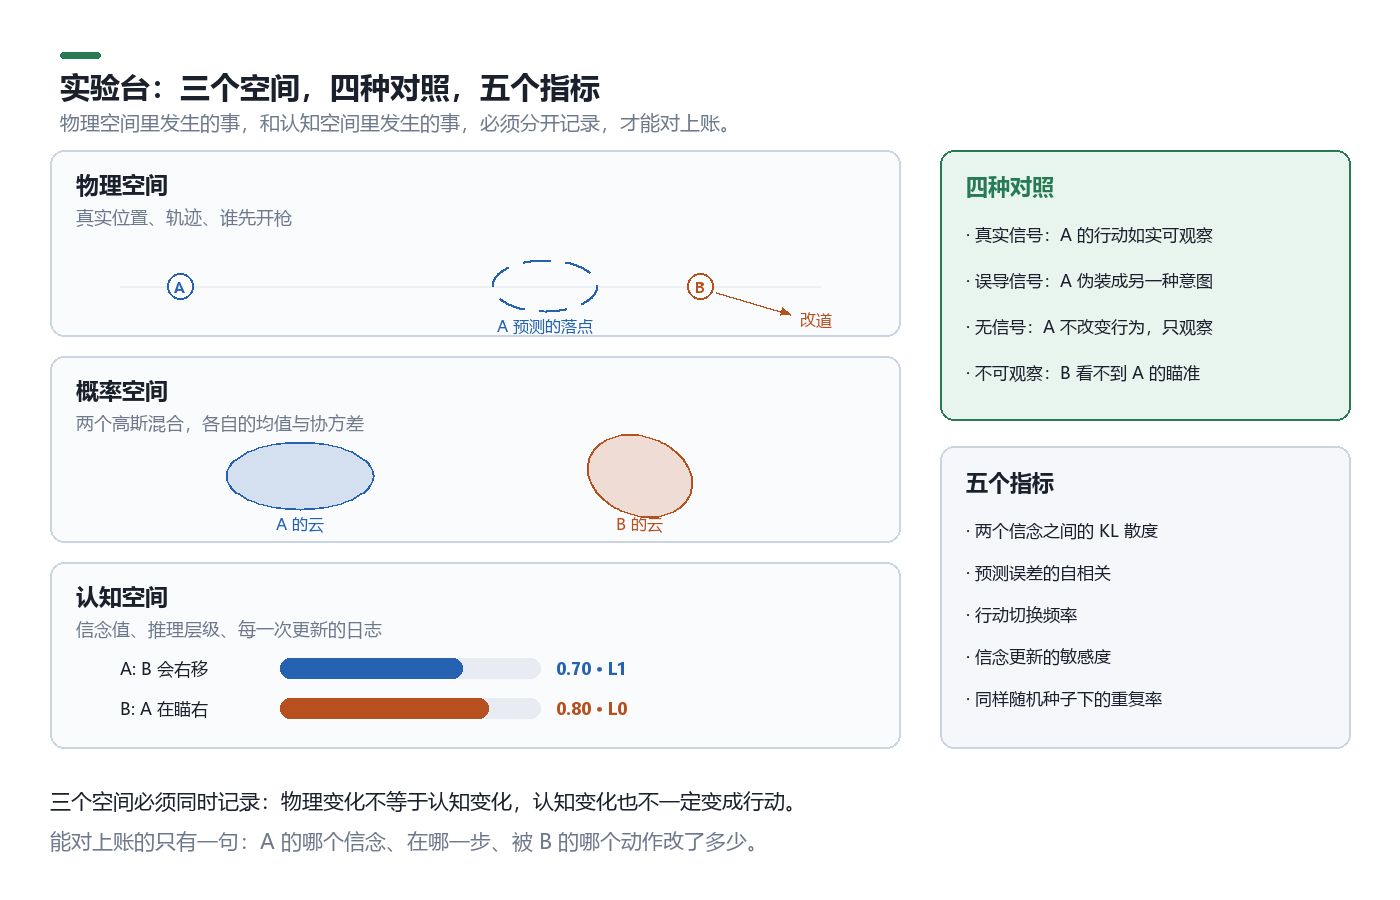
三层记录与四组对照。只记物理层是最常见的错误:物理不变不代表信念不变,信念变了也不一定转化为行动。
八、开放问题
层级选择缺乏原则。 目前层数是超参数。是否存在一个由可辨识性决定的准则,例如「当新增层的假设不能被任何干预区分时停止」?这个问题没有答案。
学习式对手模型的表示缺乏保证。 ToMnet 一类方法能拟合行为,但没有约束隐表示对应信念。需要的是可辨识性条件,而不只是预测精度。
无限层级的可计算近似缺少误差界。 截断误差目前只能经验评估。
多主体下的嵌套爆炸。 $n$ 个主体时交互状态空间随组合增长,双主体的结论不能直接外推。
基准缺失。 没有公认的环境与指标,导致「出现了振荡」这类结论无法跨工作比较。
人作为对手。 人类层级分布不稳定,实验室里测出的深度能否迁移到开放环境,证据不足。
九、参考文献
- Kaelbling, Littman & Cassandra. Planning and acting in partially observable stochastic domains. Artificial Intelligence 101:99–134, 1998. doi:10.1016/S0004-3702(98)00023-X
- Gmytrasiewicz & Doshi. A framework for sequential planning in multi-agent settings. JAIR 24, 2005. doi:10.1613/jair.1579
- Nagel. Unraveling in guessing games: an experimental study. American Economic Review 85(5):1313–1326, 1995.
- Stahl & Wilson. On players’ models of other players. Games and Economic Behavior 10:218–254, 1995. doi:10.1006/game.1995.1031
- Chong, Ho & Camerer. A generalized cognitive hierarchy model of games. Games and Economic Behavior 99:257–274, 2016. doi:10.1016/j.geb.2016.08.007
- Albrecht & Stone. Autonomous agents modelling other agents: a comprehensive survey and open problems. Artificial Intelligence 258:66–95, 2018. doi:10.1016/j.artint.2018.01.002
- Rabinowitz 等. Machine theory of mind. ICML 2018. arXiv:1802.07740
- Papadimitriou & Tsitsiklis. The complexity of Markov decision processes. Mathematics of Operations Research 12(3):441–450, 1987. doi:10.1287/moor.12.3.441
- Lowe 等. Multi-agent actor-critic for mixed cooperative-competitive environments. NeurIPS 2017. arXiv:1706.02275
- Foerster 等. Learning with opponent-learning awareness. AAMAS 2018. arXiv:1709.04326
- Da Costa 等. Active inference on discrete state-spaces: a synthesis. Journal of Mathematical Psychology 99:102447, 2020. doi:10.1016/j.jmp.2020.102447
- Friston 等. Sophisticated inference. Neural Computation 33(3), 2021. doi:10.1162/neco_a_01351
- Perdomo 等. Performative prediction. ICML 2020. arXiv:2002.06673
- Hardt 等. Strategic classification. ITCS 2016.
- Ng & Russell. Algorithms for inverse reinforcement learning. ICML 2000.
- Premack & Woodruff. Does the chimpanzee have a theory of mind? Behavioral and Brain Sciences 1:515–526, 1978. doi:10.1017/S0140525X00076512
这份综述的核心判断可以压成一句:双主体互相建模的困难,不在递归有多深,而在「对方在建模我」这句话能否被证伪。 缺少干预,再精细的层级模型也只是在等价类内部做选择。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- Cheetah:常驻内存不该由模型大小决定
- AI Filmmaking Camera Control:让模型只抄镜头,不抄人
- 麦田(Maitian):平台改版那天,不该让每个用户升级一次
- The Software Engineering Handbook:把工程判断写成一份自由度账本
- Hypit:你编辑的是词,秒是编译出来的
- Omni LoRA:一个 671 MB 的修正,要背两个任务
- Omni-Quantized:12 个构建,两套布局,省的是显存不是时间
- video-shotcraft:150 个镜头名,就是 Agent 的接口
- Jina-OCR-v1:赢在少写,不在写快
- MNN-Pocket-0.3B:不是把大模型缩小,是从两个预算反推形状