TransformerLens:打开大模型的黑盒,用 Hook 和因果干预研究 Transformer 内部
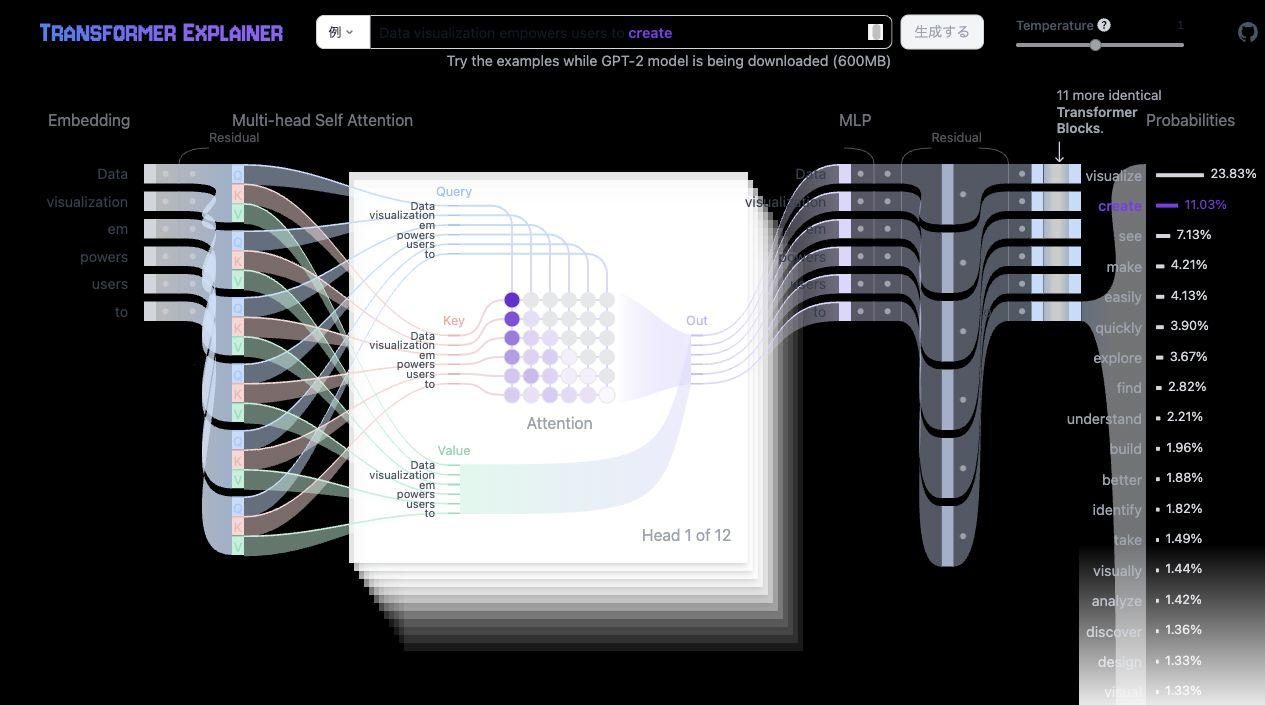
给模型一句 The capital of France is,它输出 Paris。
这件事我们已经习以为常。但如果你追问一句:它是怎么算出 Paris 的? 我们手上其实什么都没有——只有一个输入字符串和一个输出字符串,中间那几十层矩阵乘法是一团不透明的黑箱。
机制可解释性(Mechanistic Interpretability)想做的事,就是把这团黑箱拆成可以命名的零件:哪个 Attention Head 把 France 的信息搬到了最后一个位置?哪一层 MLP 把“国家”改写成“首都”?这些零件之间是不是构成了一条稳定的计算路径?
开源库 TransformerLens 就是为此而生的工具。它由 Neel Nanda 创建,目前由 Bryce Meyer 和 Jonah Larson 维护,是这个领域事实上的基础设施。
一、它是什么:给模型装一台显微镜
先把定位说清楚,避免误解:
| 工具 | 你用它做什么 |
|---|---|
Hugging Face transformers | 加载和使用模型 |
| vLLM | 高吞吐地跑推理 |
| TransformerLens | 看懂模型内部发生了什么 |
它不训练模型,不部署服务,也不提供 API。它的全部价值集中在一件事上:把前向传播过程中的每一个中间张量变成可寻址、可读取、可修改的一等公民。
官方 README 的说法是:支持 15,000+ 开源模型、140+ 架构家族,可以缓存任意内部激活,并在模型运行时编辑、移除或替换这些激活。
这句话里有两个关键词,构成了整个库的设计骨架:
- 可缓存:你能拿到
blocks.5.attn.hook_pattern这样的张量,而不需要自己改模型源码加print。 - 可干预:你能在指定位置把激活置零、替换、缩放,然后观察输出怎么变。
前者是观察,后者是实验。机制可解释性之所以是一门实验科学而不是文学批评,靠的就是后者。
二、它到底暴露了什么
一个 Transformer 前向传播产生的中间量,大致是这些:
Token Embedding
      │
      ▼
┌─────────────────────────────┐
│  Block 0                    │
│   ├── LayerNorm             │
│   ├── Attention (Q/K/V)     │
│   │      └── Pattern        │
│   ├── Attention Output (z)  │
│   ├── MLP                   │
│   └── Residual Stream       │
└─────────────────────────────┘
      │
     ...
      │
      ▼
  Final LayerNorm
      │
      ▼
    Logits
TransformerLens 给每个位置都起了名字,称为 Hook Point。命名规则本身值得记住,因为你后面写的每一行分析代码都要靠它:
| Hook 名 | 含义 |
|---|---|
hook_embed | Token embedding 输出 |
blocks.{i}.attn.hook_q / hook_k / hook_v | 第 i 层的 Q、K、V |
blocks.{i}.attn.hook_pattern | 第 i 层的注意力概率矩阵 |
blocks.{i}.attn.hook_z | 第 i 层各 head 的输出(未过 $W_O$) |
blocks.{i}.hook_resid_pre / _mid / _post | 第 i 层残差流的三处快照 |
blocks.{i}.hook_mlp_out | 第 i 层 MLP 写入残差流的分量 |
ln_final.hook_normalized | 最终 LayerNorm 的输出 |
4.0 之后,桥接层(TransformerBridge)还提供了更贴近上游架构的原生命名,例如 blocks.5.attn.q.hook_out、embed.hook_out,同时把上面这套旧名字保留为别名,指向同一个 Hook Point。这意味着大量基于旧教程写的代码仍然能跑——只要它只用到名字,不用到被删除的类。
这些张量被收集进一个叫 ActivationCache 的对象。它长得像一个字典,但带了几个专门为分析准备的方法,比如 decompose_resid()(把残差流拆成 embedding + 各层 attn/mlp 分量)和 apply_ln_to_stack()(把一组向量统一过一遍 LayerNorm,方便和 unembedding 比较)。
三、Hook 系统:三种用法,一个陷阱
HookPoint 本质上是一个 nn.Identity 模块,插在模型的固定位置。运行时它原样传递输入,但你可以挂一个函数上去:
def hook_fn(tensor, hook):
    # 读它、改它、或者整个换掉
    return tensor  # 返回 None 表示不修改
基于这个机制,库提供了三种使用层次。
第一种:run_with_cache,跑一遍,全都拿回来。
logits, cache = bridge.run_with_cache("Hello, world")

cache["blocks.0.attn.hook_pattern"]   # [batch, head, q_pos, k_pos]
cache["blocks.5.hook_resid_post"]     # [batch, pos, d_model]
这是九成实验的起点。但要注意内存:GPT-2 small 缓存全部激活还好,一个 7B 模型缓存全量激活会直接把显存吃穿。所以实际使用时几乎总要加过滤器:
logits, cache = bridge.run_with_cache(
    "Hello, world",
    names_filter=lambda name: name.endswith("hook_resid_post"),
    pos_slice=-1,   # 只留最后一个位置
)
pos_slice 对长 prompt 尤其重要——注意力模式是 [batch, head, seq, seq],序列长度翻倍,这个张量就是四倍。
第二种:run_with_hooks,只在这一个前向里动手。
def zero_head_3(z, hook):
    z[:, :, 3, :] = 0
    return z

logits = bridge.run_with_hooks(
    "The capital of France is",
    fwd_hooks=[("blocks.5.attn.hook_z", zero_head_3)],
)
Hook 在这一次前向结束后自动移除。这是做消融实验最常用的形式。
第三种:add_hook,手动管理生命周期。
跨多次前向存在的 Hook(比如训练中)需要走这一层,并且要自己负责清理。
那个陷阱是:通过 add_hook 添加的临时 Hook 不会自动清理,必须调用 model.remove_all_hook_fns();而带 is_permanent=True 的 Hook 又不会被这个调用清掉,得再加 including_permanent=True。这个细节看起来琐碎,但它导致的 bug 极其隐蔽——你以为在做干净的对照实验,实际上上一次的 Hook 还挂着。
四、四个因果分析工具,回答四类不同的问题
有了读取和干预能力,接下来就是方法论问题:怎么从“能改激活”走到“能下结论”。
TransformerLens 的 tools.analysis 里有一组工具。它们看起来都在回答“哪个组件重要”,但测的其实是完全不同的量。这一点如果搞混,结论就会错得离谱。
| 我想知道 | 用哪个 | 它到底测量了什么 |
|---|---|---|
| 哪些组件在给答案 token 加分? | Direct Logit Attribution | 残差流读出的一次分解 |
| 把某个激活换回干净版本,答案能恢复吗? | Activation Patching | 一次因果干预的实际效果 |
| 哪些位置值得做完整 patching? | Attribution Patching | 干预效果的一阶近似 |
| 某条 head→head 的路径是否影响指标? | Direct Path Patching | 一条边的精确干预 |
1. Direct Logit Attribution:分解,不是消融
残差流是一个不断累加的过程。最后一层的残差,等于 embedding 加上每一层 attention 和 MLP 写进去的分量。既然最后的 logits 是残差过一个线性 unembedding 得到的,那就可以把这个 logit 按来源拆开:
\[\text{logit}_{\text{Paris}} = \sum_{c \in \text{components}} \langle c,\ W_U[\text{Paris}] \rangle\]这就是 DLA。它能告诉你:在这一条 prompt 上,Paris 的分数里有多少来自 embedding,多少来自第 5 层某个 head,多少来自第 9 层 MLP。
但有个必须记住的限定:DLA 分数不是消融效应。 把一个组件从模型里删掉,下游计算会跟着变,最终影响可能远大于它当场的直接贡献,也可能反向。DLA 测的是“它此刻往答案方向推了多少”,不是“没有它会怎样”。
官方文档还有一个容易踩的坑:unit="layer" 返回的是累计读数(每一层之后的残差状态),不是可以相加的独立贡献。想要可加的分量,用 unit="component" 或 unit="head"。
2. Activation Patching:干净答案能不能被搬回来
这是机制可解释性里最核心的实验范式,也是最能体现“因果”二字的:
Clean:      "The capital of France is"   →  Paris
Corrupted:  "The capital of Germany is"  →  Berlin
先跑干净输入,缓存所有激活;再跑污染输入,但在某一个位置把干净激活替换进去;看 Paris 的分数恢复了多少。
_, clean_cache = bridge.run_with_cache(clean_tokens)
target = clean_cache["blocks.5.hook_resid_post"]

def patch(resid, hook):
    return target

logits = bridge.run_with_hooks(
    corrupt_tokens,
    fwd_hooks=[("blocks.5.hook_resid_post", patch)],
)
对每一层、每一个位置都这么干一遍,就得到一张恢复率热图:哪个位置是信息瓶颈,一目了然。
4.0 的 patching 工具比早期版本多了一层统计能力。传入返回 [batch] 的 metric 和 reduce="none",每个格子的结果会保留逐样本值,并附带均值、标准误、bootstrap 置信区间,以及在 baseline=True 时的效应量和置换检验 p 值。
这层统计很值得用,但也要正确理解:bootstrap 区间描述的是“在这批 prompt 上重采样,这个格子的均值会怎么浮动”。它不告诉你结论能否推广到这批 prompt 之外。四到八个样本的区间会非常宽,这是诚实的表现,不是工具的缺陷。
3. Attribution Patching:先筛,再验
完整 patching 的代价是每个格子一次前向。层数 × 位置数一乘,很快就跑不动了。
Attribution Patching 用一阶泰勒展开做近似:
\[\text{score} \approx (\text{clean} - \text{corrupt}) \cdot \nabla_{\text{corrupt}}\]也就是“激活差”乘“污染运行时的梯度”。一次前向加一次反向,就能给所有节点打分。
它有两种粒度:node(某个 hook 点的激活)和 edge(某个 writer 到某个 reader 的路径)。边粒度的分数规模随 O(seq_len × (layers × heads)²) 增长,这个量级要心里有数。
关键在定位:Attribution Patching 是筛子,不是秤。 线性近似在激活变化大、下游非线性强的时候会失准。官方文档的建议很明确:拿它挑候选,再用真实的激活替换去测量。
4. Direct Path Patching:把一条边钉死
如果你已经锁定“第 5 层第 0 个 head 通过 K 分支影响了第 12 层”,那就需要一个只改这一条路径的工具。
get_act_patch_direct_path 做的就是这件事:固定 source head,扫描后续层的 Q 头或 K/V 组,只把干净运行中该 source head 写进残差的分量加到目标分支上,其余读者仍然看到污染版本。
from transformer_lens.patching import get_act_patch_direct_path

scores = get_act_patch_direct_path(
    bridge, corrupt_tokens, clean_cache, corrupt_cache,
    metric_fn, src_layer=5, src_head=0, component="k",
)
# shape: [n_layers, n_kv_heads]
在 pre-norm 架构上,这个分数就是精确的边干预效果。在 post-norm(Gemma 2/3、OLMo 2/3)、缩放残差(Granite)或并行 mixer(Falcon-H1)结构上,因为 head 的写入不再是简单的 hook_z @ W_O,工具会直接拒绝执行——这种“拒绝”比给一个错误答案要好得多。
5. faithfulness:把“电路”从故事变成假设
做完一轮 patching,你手上会有一份“重要边”的排序。但排序不是结论。
faithfulness() 提供了一个可证伪的检验:把候选电路之外的所有边全部消融,看这个电路能恢复多少 clean 与 corrupt 之间的差距。
from transformer_lens.tools.analysis import (
    EdgeAttributionConfig, attribution_patch, faithfulness,
)

ranked = attribution_patch(
    bridge, clean, corrupt, metric_fn,
    config=EdgeAttributionConfig(granularity="edge"),
)
report = faithfulness(bridge, clean, corrupt, metric_fn, ranked.top_edges(k=50))

print(report.recovered, report.circuit_size, report.total_edges)
recovered 是分数不是百分比:1.0 表示电路完整复现了干净指标,0.0 表示它复现的是污染指标。超出 [0, 1] 也可能出现且有含义——电路可以“过冲”。
而且,判读这个数字时必须配一个同规模的随机边集合做基线。否则你无法区分“这个电路有意义”和“任意 50 条边也能恢复这么多”。
五、读残差流:Logit Lens 与 Jacobian Lens
上面那组工具都在问“谁导致了结果”。还有另一类问题更朴素:模型在第 6 层的时候,“以为”答案是什么?
Logit Lens 的做法很直接:把每一层的残差,用模型自己的 ln_final 和 W_U 投影回词表,看每一层的“临时预测”。
from transformer_lens.tools.analysis import logit_lens

result = logit_lens(bridge, "The capital of France is")
result.rank_trajectory(" Paris")   # 每层 Paris 的排名
有一个细节很漂亮:最后一层的读数精确等于模型自己的 logits(在 raw weights 模式下)。这给了这个工具一个自洽性保证。而在兼容模式下,因为 center_unembed 会给每个位置的 logit 加一个常数,跨模式比较时应该比 log-prob 或排名,而不是比原始 logit。
Jacobian Lens 则是它的进阶版:不再假设“残差直接过 unembedding”,而是拟合一个从某层到输出的传输映射。代价是需要训练或加载一个 lens artifact,并且必须和模型版本严格匹配。
这里有一条贯穿全文的纪律,官方文档写得非常克制但很重要:
中间层的读数是观察,不是干预。第 6 层排名第一的 token,只说明“如果模型在这里停下,unembedding 会这么说”,它不证明后面的层没有在工作。
六、从单个 head 到计算电路
机制可解释性真正有意思的成果,几乎都是“电路”级别的:不是“某个 head 重要”,而是“这几个组件这样配合,完成了这个任务”。
几个经典研究对象:
- Induction Heads:
A B ... A之后预测B的机制,被认为是 in-context learning 的基础组件之一。 - Indirect Object Identification(IOI):
When Mary and John went to the store, John gave a drink to ___填Mary。这个任务小到可以在 GPT-2 small 上完整拆解,是学习整套方法论的经典教材。 - Copying / 复制机制:低层 head 把信息原样搬运到后续位置。
研究路径通常是:先用 DLA 看哪些组件在给答案加分,用 Attention Patching 找信息瓶颈层,用 Path Patching 锁定具体路径,最后用 faithfulness() 检验这条电路是否真的能解释行为。
这条链路里,每一步都能被证伪。这正是它比“看注意力图讲故事”更可靠的原因。
七、4.0 的变化:把执行引擎也抽象掉
这里必须讲清楚版本问题,因为网上大量教程还停留在旧 API 上。
2026 年 9 月 21 日发布的 4.0,核心变化是 Driver(执行后端)系统。
3.0 已经用 TransformerBridge + 架构适配器,解决了“不同模型实现”的问题——把 Hugging Face 的模型映射到统一的组件树和 Hook 接口上。4.0 解决的则是“不同执行引擎”的问题:同名的 Hook、同一份 cache、同一套干预接口,现在可以跑在 vLLM 上,或者跑在 inspect_ai 的评估流程里。
        TransformerLens API(统一 hook 名 / cache / 干预)
                          │
                          ▼
                   TransformerBridge
                          │
        ┌─────────────────┼─────────────────┐
        ▼                 ▼                 ▼
  transformers         vLLM            inspect_ai
  (本地全量 hook)  (高吞吐捕获)    (评估内捕获)
三个后端的能力边界并不相同,这张表很关键:
| 后端 | 梯度 | Attention Pattern | 干预方式 | 安装 |
|---|---|---|---|---|
transformers | ✅ | ✅ | 任意 Hook 函数 | 默认 |
| vLLM | ❌ | ❌ | 声明式(suppress/scale/add/set) | [vllm] extra,仅 Linux |
| Inspect | 视 provider 而定 | 部分 | 声明式 / solver | [inspect] extra |
为什么 vLLM 后端没有 attention pattern?因为它的 kernel 把 $QK^\top \to \text{softmax}$ 融合掉了,中间矩阵根本不落地。这不是实现偷懒,是推理引擎为了速度必然做的取舍。
from transformer_lens.model_bridge import RemoteBridge

bridge = RemoteBridge.boot_vllm("meta-llama/Llama-3.2-1B", dtype=torch.float16)
logits, cache = bridge.run_with_cache("Hello, world")

logits2, cache2 = bridge.run_with_cache(
    "Hello, world",
    intervene={"embed.hook_out": {"op": "suppress"}},
)
旧 API 已被删除
4.0 移除了全部 Hooked* 类:HookedTransformer、HookedEncoder、HookedEncoderDecoder、HookedAudioEncoder、BertNextSentencePrediction,以及配套的 loading_from_pretrained、组件树和权重转换器。
迁移本身很小:
# 4.0 之前
from transformer_lens import HookedTransformer
model = HookedTransformer.from_pretrained("gpt2")

# 4.0 之后
from transformer_lens.model_bridge import TransformerBridge
bridge = TransformerBridge.boot_transformers("gpt2")
bridge.enable_compatibility_mode()   # 需要旧版数值行为时
HookedRootModule 和 HookPoint 被保留了下来——它们是给任意 nn.Module 挂 TransformerLens 风格 Hook 的官方途径。
兼容模式:一个容易混淆的数值开关
这个点很值得单独说,因为它会让不同实验的结果对不上。
默认的 bridge 保留 Hugging Face 的原始权重,logits 和激活与 HF 完全一致。而旧的 HookedTransformer 默认会做 LayerNorm folding 和权重居中,两者数值不同。
enable_compatibility_mode() 复现的是旧版的数值约定。于是出现了一个有点反直觉的局面:
- DLA 需要兼容模式,因为它依赖标准的残差分解约定。
- Jacobian Lens 需要原始权重,兼容模式会破坏它的前提。
所以官方建议:做这类对比时,用分别加载的模型,并且不要在不同权重处理模式之间混用 cache。这一条如果忽略,debug 会非常痛苦——数字都对得上一点,但就是不一致。
另外 4.0 有两处已知能力缩减:Qwen-1 的 use_logn_attn / Dynamic-NTK 长上下文缩放,以及 GQA 模型上的 ungroup_grouped_query_attention,在新架构中都没有等价实现。
八、不只 Transformer:Mamba 与 SSM
TransformerLens 的适配器已经覆盖 Mamba-1、Mamba-2,以及 gated-delta-net(Qwen3.5 / Qwen3-Next)、NemotronH、GraniteMoeHybrid 等混合架构。
对 Mamba 这类状态空间模型,最自然的对照物是“等效注意力矩阵”。ActivationCache.compute_ssm_effective_attention(layer=...) 可以把 SSD 推导出的注意力矩阵显式地生成出来,直接和 Transformer 的 attention pattern 比较。
README 把这块标为实验性支持。能跑通前向、能挂 Hook、能生成,不等于所有分析工具都已经适配——官方在每类工具下都写了明确的架构限制(比如 DLA 会拒绝 Mamba/SSM/Mixer/LinearAttention 的混合布局)。工具会报错,是好事。
九、上手:从加载到第一次干预
安装:
pip install transformer_lens
加载受限模型(Llama、Gemma 等)需要 HF_TOKEN,并先在 Hugging Face 上接受模型协议。
from transformer_lens.model_bridge import TransformerBridge

bridge = TransformerBridge.boot_transformers("gpt2", device="cpu")

logits, cache = bridge.run_with_cache("The capital of France is")
pattern = cache["blocks.0.attn.hook_pattern"]
print(pattern.shape)   # [batch, n_heads, q_pos, k_pos]
做一次零消融,看第 5 层第 3 个 head 是不是真的在干活:
clean_logits, _ = bridge.run_with_cache("The capital of France is")

def zero_head(z, hook):
    z[:, :, 3, :] = 0
    return z

ablated_logits = bridge.run_with_hooks(
    "The capital of France is",
    fwd_hooks=[("blocks.5.attn.hook_z", zero_head)],
)

paris = bridge.to_single_token(" Paris")
print(clean_logits[0, -1, paris].item(), "->", ablated_logits[0, -1, paris].item())
几个实践中的注意点:
-
model.eval()不等于torch.no_grad()。 前者关掉 dropout 等训练行为,后者关掉梯度记录。梯度类分析(Attribution Patching、Jacobian Lens)如果在no_grad()里跑,会直接失败。 - 答案 token 必须是一个 token。 ` Paris
和Paris` 的 tokenization 可能不同,前导空格经常是坑。 - 比较用差值,不要用单点。 常见做法是
logit(Paris) - logit(Berlin),把问题变成“模型更偏向哪个”,比绝对分数稳定得多。
十、方法论上的几个坑
这部分不是 API 问题,是研究纪律问题,但比 API 更容易出错。
1. 观察不等于因果。 注意力权重高,不代表这个 head 影响了输出。要证明影响,必须干预。这是整个领域从 2021 年到现在最大的方法论转变。
2. DLA 不是消融。 DLA 分数低的组件,删掉后可能影响巨大;DLA 分数高的组件,删掉后可能被其他路径补偿。两者回答的是不同问题。
3. 单个 prompt 的结论不算结论。 一两个例子上得到的“第 9 层关键”,很可能只是这两个句子的巧合。至少用一批 prompt,并且看逐样本结果,不要只看均值。
4. 置信区间不负责外推。 bootstrap 区间只描述这批 prompt 的重采样波动。要谈“模型的一般机制”,需要在留出集上再验一次。
5. 记录复现信息。 模型和 tokenizer 的 revision、dtype、是否开启兼容模式、hook 名、位置、metric 定义、随机种子——这些不记,三个月后你自己也复现不出来。
6. 兼容模式和原始权重的 cache 不能混用。 换权重处理方式就要重新采 cache。这条违反起来毫无报错,只会给你一堆“看起来差不多但统计上显著不同”的诡异结果。
十一、总结
TransformerLens 解决的问题很基础,也很少被认真对待:让“看模型内部”这件事变得像调用一个函数一样简单。
它提供的东西可以归成三层:
- 读取层:统一的 Hook 名 +
ActivationCache,把中间张量变成可寻址对象。 - 干预层:
run_with_hooks、patching 工具,把“如果改这里会怎样”变成可执行的实验。 - 推断层:DLA、Attribution Patching、faithfulness、Logit Lens,把干预结果转成关于组件的定量陈述。
而 4.0 的 Driver 架构,把它的适用范围从“本地 Hugging Face 模型”扩展到了“任何能跑前向并触发 Hook 的引擎”。它对机制可解释性的意义,类似于 PyTorch 对深度学习的意义:不是提出新理论,而是让一整类实验变得便宜。
当然,工具再好也只是工具。这个领域最难的从来不是“怎么读激活”,而是“怎么设计一个能证伪的实验”。TransformerLens 把前者的成本压到接近零,剩下的部分,还是得靠人。
项目与参考资料
项目使用 MIT 许可证。本文的 API 名称、版本行为和架构限制依据上述官方文档与仓库 README 整理;具体版本差异请以仓库当前代码为准,尤其是 4.x 系列仍在快速迭代。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- FreeToken:让消费级电脑跑起 284B MoE,一次把整机当成推理集群的系统设计
- Sub2API:把 Claude、OpenAI、Gemini 统一接入,一个开源 AI API 网关的设计与边界
- Train LLM From Scratch:从零开始训练自己的大语言模型
- DeepSeek-V4.1-Flash-1017-Uncensored:不重新训练模型,直接修改权重,让 AI 改变回答行为
- Idol:一张图片生成百万级 3D 高斯模型,AI 正在重新定义三维建模
- Windows 上「保存失败」:文件被占用时原子替换为什么会报错
- 一次 CSS 压缩把整站布局打散
- 把个人站从「魔改模板」改成「薄启动器」
- 从这里开始