SAELens:重建得越准,特征越不一定是真的
SAELens 的文档里有一张表,能让「SAE 帮我读懂了模型」这句话立刻降温。
同一份合成数据、同一个 L0、同样的训练设置,五种稀疏自编码器架构:重建质量最高的是 Matching Pursuit(解释方差 $R^2 = 0.835$),它的特征恢复 F1 只有 0.446,全场最低;F1 最高的是 Matryoshka(0.879),重建反而最差(0.779)。
这两个指标本该同向,实测反着走。所以本文只讲一件事:判断一个 SAE 好不好,不能看它重建得多准。
- GitHub:decoderesearch/SAELens(MIT,
pip install sae-lens) - 文档:decoderesearch.github.io/SAELens
- 特征浏览:neuronpedia.org
它由 Joseph Bloom、Curt Tigges、Anthony Duong、David Chanin 四人维护,仓库挂在 decoderesearch 组织下。当前主线是 v6——一次破坏性重构,v5 及更早的教程里的 API 有一半已经对不上了。
一、为什么不能直接读神经元
每个 Transformer 层在每个位置都留下一个向量:Gemma 2 2B 是 2304 维,GPT-2 small 是 768 维。这个残差流里编码了模型此刻「在想什么」,但没有哪一维对应「法国」。
原因叫叠加(superposition):模型要表示的概念比维度多,于是把概念压成近似正交的方向叠在一起。后果就是多义性——一个神经元参与好几个概念,一个概念摊在好几个神经元上。你盯着第 1024 个神经元看,看到的是三四个概念叠加后的和。
SAE 的赌注是:激活可以写成「少数几个稀疏方向的线性和」。于是训练一个过度完备的字典(宽度远大于 $d_{in}$),同时要求重建准确和稀疏——把「混在一起的方向」重新拆开。
但这只是假设,不是定理。2024 年那篇讲 feature absorption 的工作(arXiv:2409.14507,NeurIPS 2025 Oral)在数百个 LLM SAE 上验证了一件事:稀疏分解在层级特征上并不稳健。看起来单义的父特征,会在它该触发的地方不触发,而是被「吸收」进子特征。作者的结论很直白:调整 SAE 宽度或稀疏度都不足以解决这个问题。
所以一台 SAE 的产出不是「概念清单」,是「一批候选方向,加一套验证流程」。这个区别后面每一节都会回到。
二、一台 SAE 到底在算什么
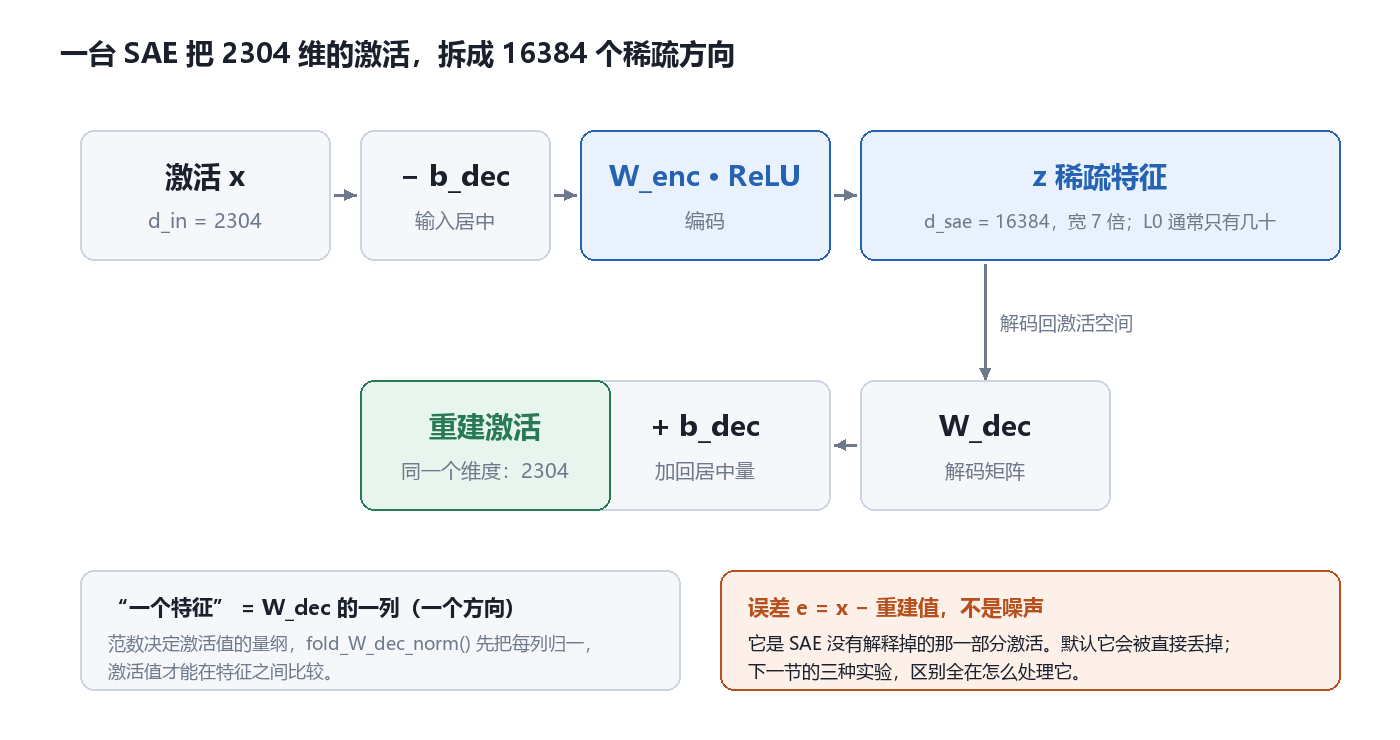
编码器把激活挤进稀疏空间,解码器把它铺回原维度;中间那个 $e$ 才是所有争论的起点。
写成两行就是全部:
\[z = \mathrm{ReLU}\left(W_{\text{enc}}(x - b_{\text{dec}}) + b_{\text{enc}}\right), \qquad \hat{x} = W_{\text{dec}}z + b_{\text{dec}}\]- 一个「特征」就是 $W_{\text{dec}}$ 的一列,也就是激活空间里的一个方向。
- 稀疏性只加在特征向量上:$z$ 是唯一的稀疏量,经典做法是 $L = \lVert x - \hat{x}\rVert_2^2 + \lambda \lVert z \rVert_1$,现代架构改成固定 $L_0$(TopK 家族)或用可学习阈值(JumpReLU)。
- $b_{\text{dec}}$ 同时出现在两端:编码前减掉(输入居中),解码后加回来,所以 SAELens 的配置里有个
apply_b_dec_to_input。
v6 的默认值顺手替你做了一堆决定,值得知道它们是什么:$b_{\text{dec}}$ 一律初始化为 0;解码器初始化用 Anthropic 2024 年 4 月更新里那套启发式;L1 损失按解码器范数缩放(文档原话是 “this is always the right thing to do”);激活可以走 expected_average_only_in 归一化(官方教程用的就是它),也可以换成协方差白化(arXiv:2511.13981),并在训练结束时把它折进权重。
这些不是可有可无的细节。窄宽度 L1 SAE 有个已知病叫 shrinkage:输出范数系统性小于输入范数,惩罚越强越明显。SynthSAEBench 干脆把 shrinkage 做成了一个评测指标。
三、四个数字说清 SAELens 是什么
| 数字 | 含义 |
|---|---|
| 38 | 注册表里可一键加载的模型数 |
| 1731 | 光是 gemma-2-2b,就有 20 个 release、1731 个训练好的 SAE |
| 8 | 支持的 SAE 架构数(三种 legacy、三种 SOTA、两种 research) |
| 4 | 维护者人数;MIT 许可;纯 Python,pip install sae-lens |
1731 这个数字本身就说明问题:SAE 不是「训练一次就完事」的模型,而是「每个模型 × 每一层 × 每个 hook × 每种宽度」的一族工件。换一层就要换一个 SAE。
v6 的破坏性变更里,有五条最容易踩:
| 变更 | 旧写法会怎样 |
|---|---|
from_pretrained() | 现在只返回 SAE;旧的三元组解包会给弃用警告 |
| 训练配置 | 拆成运行配置 + 嵌套的架构配置 + 日志配置三层 |
| 训练器类名 | SAETrainingRunner → LanguageModelSAETrainingRunner |
| CLI | 变成 python -m sae_lens.llm_sae_training_runner |
| 默认值 | JumpReLU 带宽 0.001 → 0.05,初始阈值 0.001 → 0.01 |
最后一条最值得注意:默认值本身就是一个研究结论。改一个阈值默认值,等于改了别人论文的可复现性。
四、三个会让分析悄悄失真的默认值
这部分是我读文档时停留最久的地方,因为三条都属于同一类错误:你以为你在看模型,其实你在看自己的管线。
| 坑 | 你会看到什么 | 正确做法 |
|---|---|---|
TransformerLens 4.0 删了 HookedTransformer | HookedSAETransformer 直接不可用 | 装 transformer-lens<4,或改用 SAETransformerBridge(支持 Gemma 3) |
用 from_pretrained 加载模型 | 激活被默认后处理过,SAE 效果莫名变差 | 用 from_pretrained_no_processing:SAE 是在原始激活上训的 |
| 没归一化解码器范数 | 特征激活值不可比,和 Neuronpedia 上的数字对不上 | 加载时传 fold_W_dec_norm=True |
第三条值得单独展开,因为它最隐蔽。多数 SAE 训练时解码器的行不是单位范数,于是「激活多大」和「这个方向有多长」纠缠在一起:两个特征都说自己激活了 3.0,但它们的分量根本不是一个量级。fold_W_dec_norm() 是一个重参数化——把每一行的范数搬进编码器权重——重建结果完全不变,但激活值被拉到了可比的尺度上。
而 Neuronpedia 的仪表盘显示的正是 fold 之后的值。所以不 fold,你永远对不上,还会以为是自己的 bug。
from sae_lens import SAE

sae = SAE.from_pretrained(
    release="gemma-scope-2b-pt-res-canonical",
    sae_id="layer_12/width_16k/canonical",
    fold_W_dec_norm=True,   # 想和 Neuronpedia 对上,就加上这一行
    device="cuda",
)

feature_acts = sae.encode(activations)   # (batch, seq, 16384)
reconstructed = sae.decode(feature_acts)
五、error term:让干预可证伪的那一行
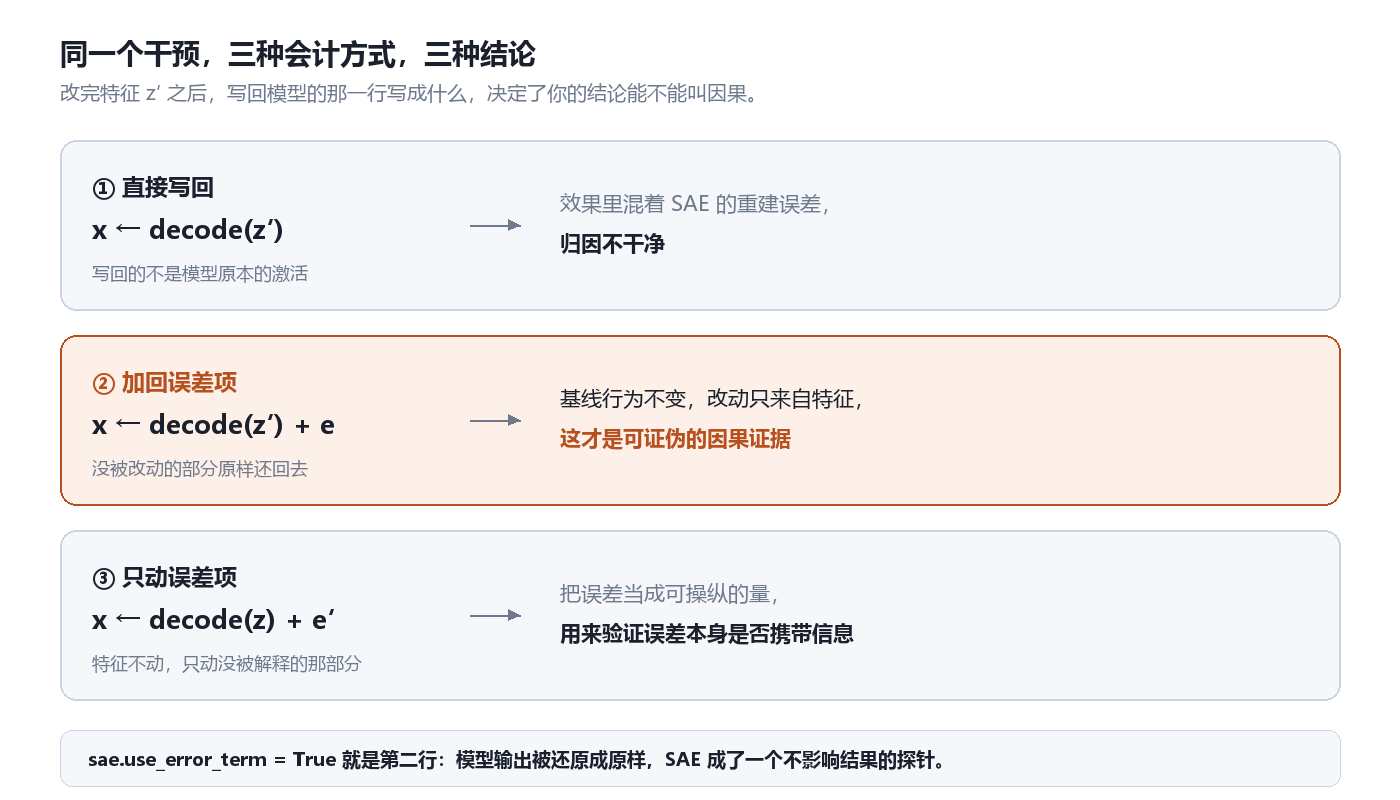
改的是特征,写回的是激活;写法不同,结论的可信度完全不同。
做特征消融时,效果其实有两个来源:你改掉的那个特征,和 SAE 丢掉的那块误差。不分开,你没法排除「其实是重建误差造成的」这个解释。
SAELens 的处理很干净——use_error_term:
sae.use_error_term = True
model.add_sae(sae)
# 输出 = SAE(x) + e = x:模型行为和没装 SAE 时完全一致
此时 SAE 成了一个不影响结果的探针:你消融某个特征,模型行为的变化只能来自这个特征,因为误差项被原样加回去了。误差本身还能被单独 hook(blocks.12.hook_resid_post.hook_sae_error),所以第三种实验也成立:特征不动,只动误差,看误差里到底有没有信息。
这是「可证伪性」在代码里的落点。没有这一行,所有特征干预实验都在同时改两个变量。
顺带一个推论:重建误差小,不等于误差无害。误差是有结构的(shrinkage、吸收都在里面),不是白噪声;把它当成随机扰动加回去,会系统性地掩盖掉你想找的东西。
六、架构不是选项,是假设
八种架构,官方给了三种标签:legacy、SOTA、research。但读的时候要清楚,这些标签回答的是「你想研究什么」,不是「哪个分数最高」。
| 架构 | 稀疏怎么控制 | 官方标签 | 它想解决什么 |
|---|---|---|---|
| Standard L1 | L1 惩罚 | legacy | 经典起点,最好懂 |
| Gated | 门控 + L1 类惩罚 | legacy | 减轻 L1 的 shrinkage |
| TopK | 每个样本固定 K | legacy | 用结构约束代替惩罚 |
| BatchTopK | 一批内平均 L0 固定 | SOTA | 批量层面控稀疏,训练更稳;存盘时转 JumpReLU |
| JumpReLU | 可学习阈值 + L0 惩罚 | SOTA | Gemma Scope 与 Anthropic 用的就是这一支 |
| MatryoshkaBatchTopK | 多宽度嵌套重建 | SOTA | 抗 feature absorption,但更易 feature hedging |
| AbsTopK | 保留绝对值最大的 K 个,保留符号 | research | 让一个特征表示双向概念(男/女两端) |
| Matching Pursuit | 串行逐个选方向 | research | 更强的非线性;慢 10–100 倍 |
有个细节很能说明这个领域的现状:BatchTopK 训练时按批次固定平均 L0,保存成 JumpReLU 才能推理——否则推理时必须提供一批输入。训练时的架构和推理时的架构可以不是同一个,这在别的工具链里很少见。
七、SynthSAEBench:唯一有真值的地方
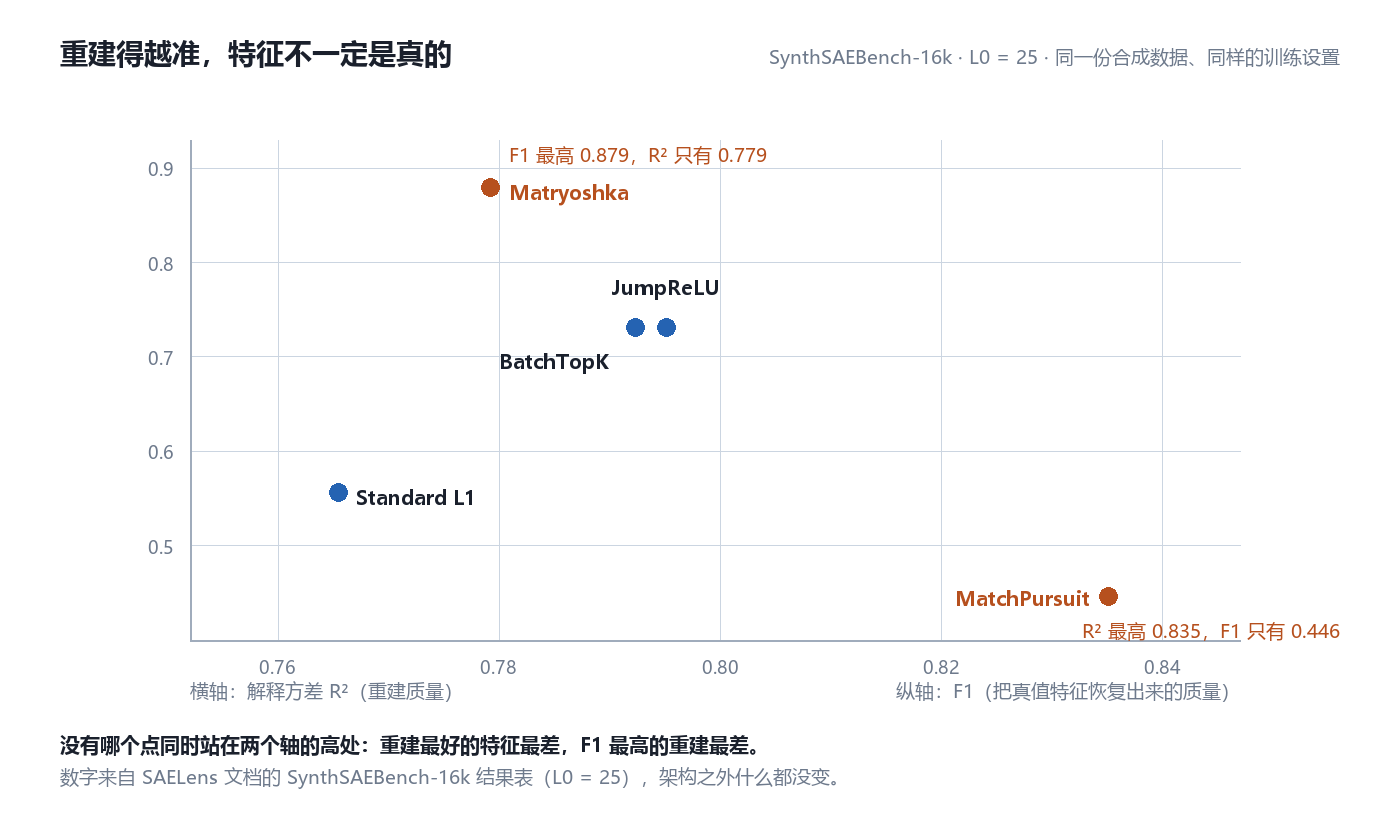
五个点,两个轴,没有哪个架构同时站在两轴的高处。
在真模型上你没有真值,只能用代理指标:重建损失、下游探针、自动解释。这些代理太吵,吵到分不清一个架构是「真的更好」还是「只是不同」。
SynthSAEBench 换了个办法:造一个特征已知的模型。16,384 个真值特征挤在 768 维里(21 倍过度完备),发射概率服从 Zipf(指数 0.5),并带一棵 128 个根节点 × 分支 4 × 深度 3 的层级树,兄弟节点互斥,还有低秩相关和 100 步正交化。平均 L0 约 34。
官方推荐的训练设置是:SAE 宽度 4096(刻意比真值窄,模拟现实),2 亿样本,batch 1024,BatchTopK 取 k=25。同一份数据上五个架构的结果(L0 = 25):
| 架构 | F1 | MCC | 唯一性 | 解释方差 |
|---|---|---|---|---|
| Matryoshka | 0.8793 | 0.7927 | 0.9987 | 0.7792 |
| BatchTopK | 0.7316 | 0.7574 | 0.9837 | 0.7923 |
| JumpReLU | 0.7317 | 0.7527 | 0.9885 | 0.7951 |
| Standard L1 | 0.5562 | 0.6039 | 0.8976 | 0.7654 |
| MatchPursuit | 0.4464 | 0.6930 | 0.8281 | 0.8351 |
三条读法,一条比一条不舒服:
- 没有架构赢两个轴。重建冠军 MatchPursuit 的 F1 是全场最低;F1 冠军 Matryoshka 的重建是全场最差。
- 经典 L1 的重建几乎追平 SOTA。0.7654 对 0.7923,只差 0.027;但 F1 差了 0.18。重建这一点差距,逼不出特征质量。
- MCC 天花板是 0.79。即使有真值、有干净的层级结构、有 2 亿样本,最好的架构也只恢复到平均余弦相似度 0.79。真模型上的结构只会更脏,而你没有真值。
还有一处错位值得记下来:文档在训练指南里把 BatchTopK 和 JumpReLU 标成 SOTA,并推荐给大多数场景,但同一份文档的这张表里,F1 最高的是 Matryoshka(BatchTopK 的变体,代价是每步多次前向)。「推荐」是默认值求稳,「最优」是特定指标下的赢家——这两件事在 SAE 领域还没合并成一件。
八、局限
- 合成基准不能直接搬到真模型。层级、互斥、Zipf 都是构造出来的;真实语料的概念结构未必长这样。它是必要条件,不是充分条件。
- 吸收是结构性的。上面那篇 NeurIPS Oral 的结论是:稀疏优化本身会导致父特征被拆进子特征。所以你读到的「概念」可能只是碎片,而且加宽、调稀疏度都救不回来。
- 误差有结构。shrinkage 与吸收都藏在 $e$ 里,而默认它会直接被丢掉。
- 代码半年就过期。v6 是破坏性重构,教程、博客、Colab 一半还停在 v5 的写法。
- 解释仍然靠人和代理。没有 token 级真值,也就没有自动判对错的办法。
- 成本不是一点。Matryoshka 每步多次前向,Matching Pursuit 慢 10–100 倍,SAE 宽度动辄 16k 到 1M。
- 一件工件绑一个位置。模型、层、hook、宽度任一改变就要重训,注册表里那 1731 个 SAE 就是这么来的。
九、我的判断
大多数人用 SAELens 的方式,是加载一个 SAE、找一个激活很高的特征、读几条样本,然后给它起个名字。这个流程能产出观察,但产不出结论——因为缺的那一步不是「多看几个样本」,是校准。
我会把它当测量仪用,顺序是三条:
- 先校准。
fold_W_dec_norm、from_pretrained_no_processing、use_error_term三件套。这三行决定了你的数字能不能和别人对上、你的消融是不是只改了一个变量。 - 再测量。
encode找候选特征,用激活和不激活的对照样本估它的触发条件,别急着命名。 - 然后证伪。打开 error term 做同一组消融,看效果是否还在。还在,才轮到讨论这个特征「是什么意思」。
顺着这条线,有三个我认为可测、而且可以证伪的下一步:
- 量出误差贡献了多少效果。同一组消融,error term 开一次、关一次,差出来的那部分就是重建误差的贡献。这个数在文献里没有被系统报告过(我的推断),但它直接决定已有结论的可信度。
- 把合成层级换成真实语料的层级统计。SynthSAEBench 的层级树是构造的;用代码语料里函数/类/模块的嵌套统计重造一棵,看 Matryoshka 的优势还在不在。
- 跨层一致性。同一个事实在不同层是否落在同一个方向上?这正是 SynthSAEBench 里 MCC 那个指标在测的事(它用的是匈牙利算法做一对一匹配,定义来自 arXiv:2505.20254)。
回到我一直在看的那条线:可解释性缺的从来不是可视化。SAE 把「神经元」换成了「方向」,这是一次真实的表示层升级;但它没有自动换来「可信」——可信要靠 error term、fold、真值基准这些不起眼的东西一点点攒出来。SAELens 值得读的地方,恰恰是它把这些不起眼的东西都做成了默认值或者一行开关。
项目与资料
- GitHub 仓库(MIT)
- 官方文档(v6;含迁移指南、训练指南、API)
- 预训练 SAE 注册表(38 个模型,逐层逐宽度)
- SynthSAEBench 说明与结果表(本文第七节的数字来源)
- SAE-Vis(特征仪表盘,callummcdougall 维护,与 SAELens 配合使用)
- Neuronpedia(浏览已发布特征)
- 相关论文:feature absorption(NeurIPS 2025 Oral)、SynthSAEBench、SAE feature consistency、data whitening
本文数字来源:架构标签、v6 变更、默认值与三条管线陷阱来自 SAELens v6 文档(usage / training_saes / migrating);两张表里的 F1、MCC、唯一性、解释方差与 R² 来自 SynthSAEBench-16k 结果表(L0 = 25),基准配置来自同一页;38 个模型与 1731 个 SAE 来自预训练注册表页;feature absorption 的结论来自论文摘要。第九节三条「可测的下一步」以及「这个数没被系统报告过」是我的推断。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- Blender Kiln:AI 建模缺的不是生成能力,是交付前的度量
- CineCode:每一帧都是时间的纯函数,所以电影可以被检查
- OhMyGame:AI 生成游戏不难,难的是让它自己发现游戏跑不起来
- GPT-2 的一次前向:一条 768 维的向量,被改写 12 次,变成 50257 个分数
- TokenEconomizer:Coding Agent 的成本按仓库累积,不按任务计价
- Transformer Explainer:把 GPT-2 塞进浏览器,让模型边算边解释自己
- Boubou:本地语音 AI 缺的不是模型,是一层能借给全屋的运行时
- Hy-MT2:把翻译拆成语言家族分头训练,再蒸馏回一个模型
- NNsight:把干预写进前向传播,让同一段代码在 405B 模型上跑
- Safetensors:用 8 个字节和一段 JSON,重新设计大模型的权重文件