Cheetah:常驻内存不该由模型大小决定
123 MB。2,497 MB。16 MB / 32 MB。
前两个是同一份权重的稳态 RSS,第三个是让它成立的那个预算。
Cheetah 是 DA3M0 用 Rust + C 写的本地推理引擎:Safetensors 进,CLI 和 OpenAI 兼容 API 出,Apache-2.0。2026-10-30 建库,现在 16 star、2 fork,仓库 603 KB——不到一个月、没什么人知道的个人项目。
我之所以愿意写它,不是因为它比 llama.cpp 好(它没有),而是因为它把一件通常被当成「运行时行为」的事,做成了一个可以设的参数:
进程的常驻内存(RSS),不再由模型多大决定,而由你给它的预算决定。
一、它省的不是算力,是常驻
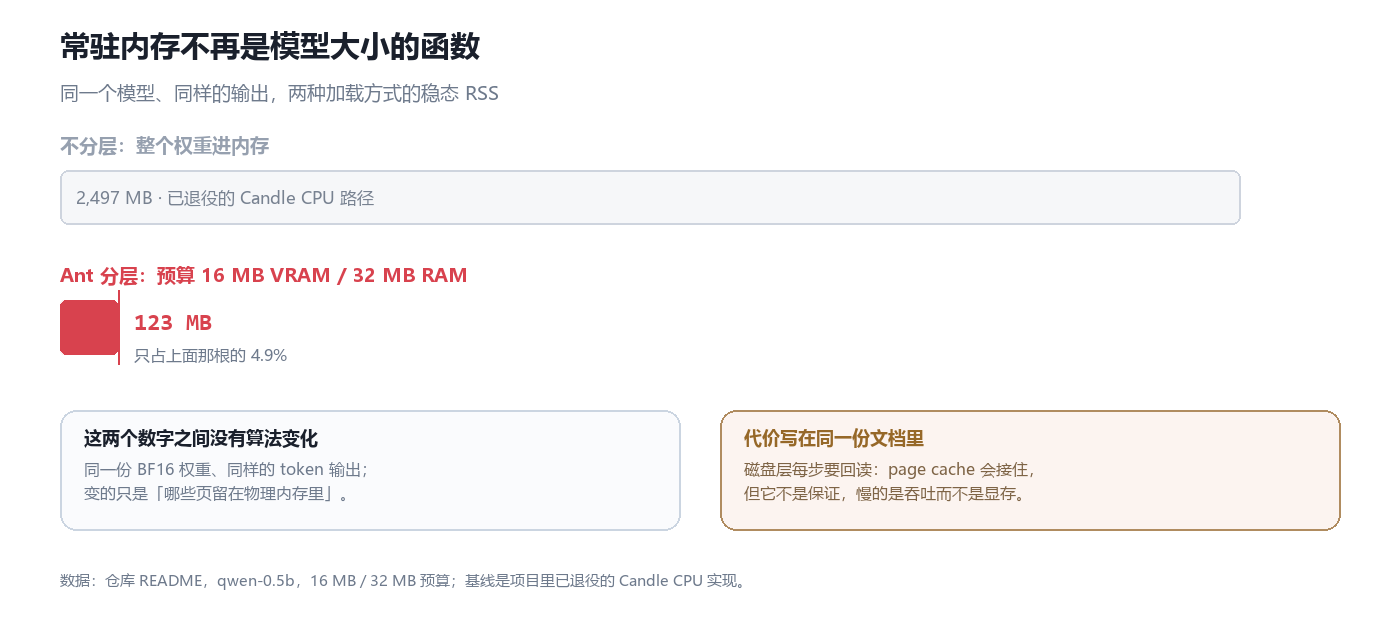
同一份 BF16 权重、同样的输出,两种加载方式的稳态 RSS;右边那根只有左边的 4.9%。
README 给的读数是:qwen-0.5b,在 16 MB VRAM / 32 MB RAM 的预算下,稳态 RSS 123 MB;作为基线的是项目里已退役的 Candle CPU 路径,2,497 MB。它同时强调了一点:输出完全相同。
这三个数字要一起读,缺一个就会误判:
- 换掉的是「哪些页留在物理内存里」,不是算法——所以输出不变;
- 123 MB 是在 16/32 MB 预算下测的,不是什么都不设就有的;Ant 自己的默认预算是 VRAM 8 GiB / RAM 16 GiB,那个配置下你不会看到 123 MB;
- 省的是常驻,不是时间:磁盘层每一步都要回读,page cache 会接住大部分,但那是操作系统的策略,不是程序的保证。
这就是它的整个卖点,也是它的整个代价。
二、三个层级,管的是同一件事:页在不在
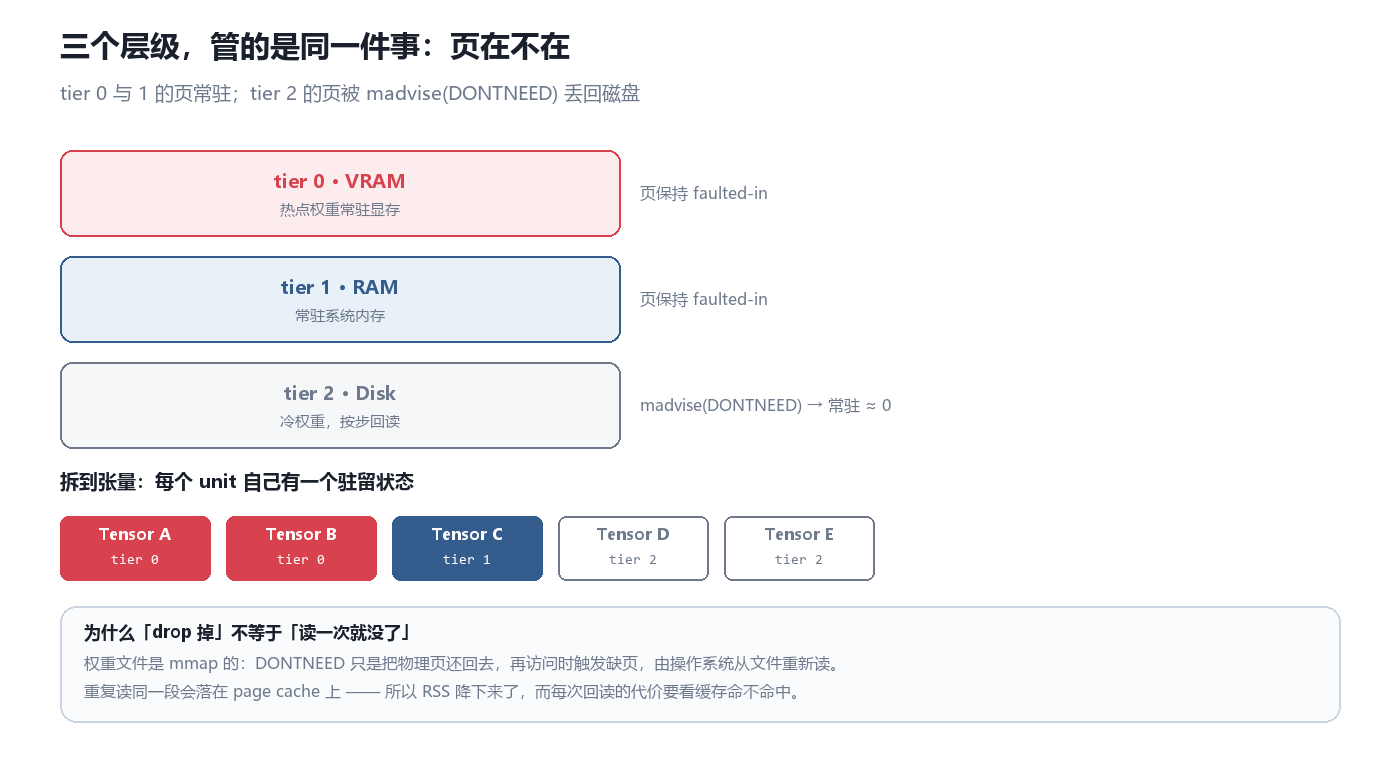
拆到张量粒度,每个 unit 有自己的驻留层级;tier 2 的页被丢回磁盘,再访问时由缺页把它们读回来。
cheetah init 之后,权重按张量拆成原子单元,每个单元分到一个层级:
- tier 0(VRAM):热权重,页保持 faulted-in;
- tier 1(RAM):常驻内存,页保持 faulted-in;
- tier 2(Disk):冷权重,页用
madvise(DONTNEED)丢掉,每一步按需流回来。
关键在最后那句的实现方式:权重文件是 mmap 的,所以 DONTNEED 并不是把数据删掉,而是把物理页还给内核;下次访问触发缺页,内核从文件重新读。于是「常驻字节数」变成了一个可以调的量,而模型本身还在原地。
这也解释了为什么 CPU 后端的 Ant 是「真的动了页」——它不是维护一份抽象的权重列表,而是让 RSS 直接反映策略。
预算和目标都可以从命令行给:--ant-vram、--ant-ram、--ant-disk-dir、--ant-eviction-policy、--ant-prefetch-stages、--ant-resident。还有一个交互式的 --setup,把模型有多少 unit、分几层打印出来,让你当场填预算,然后存进模型目录。
三、两个后端,「VRAM 层」不是同一个东西
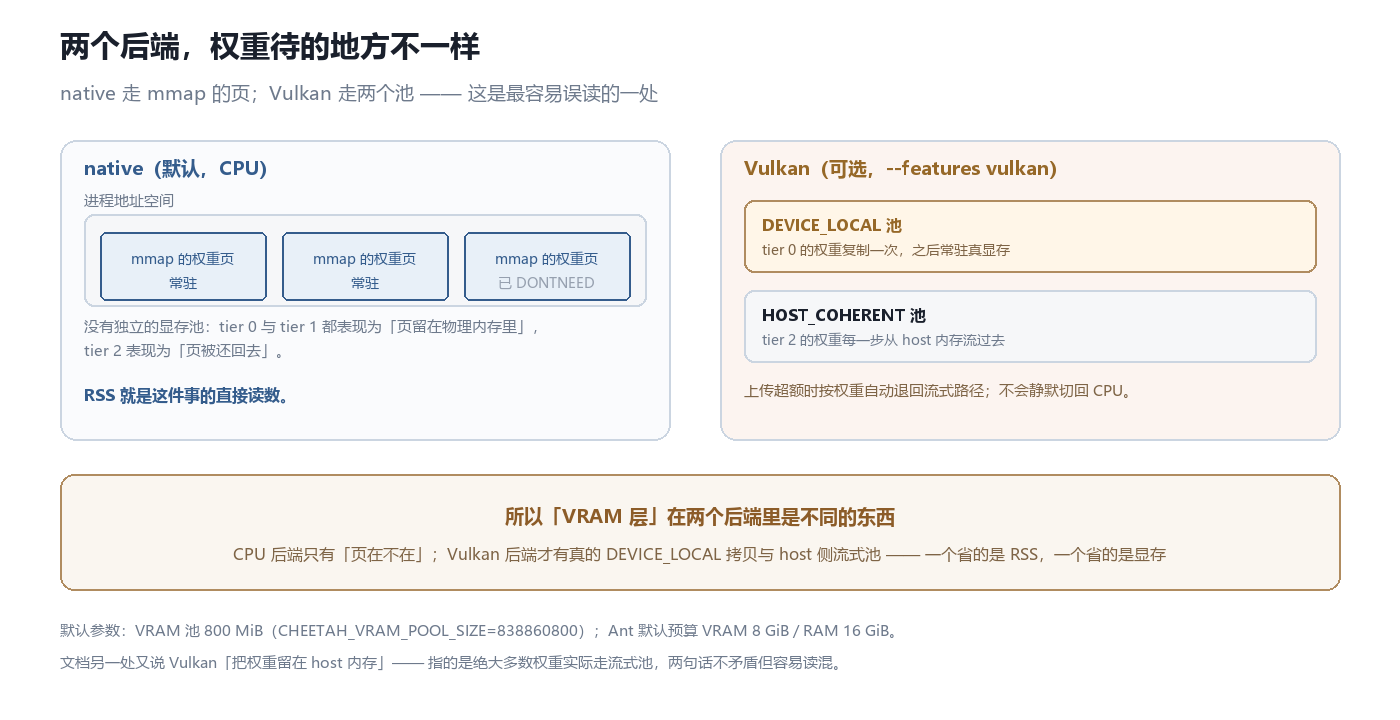
CPU 后端只有「页在不在」;Vulkan 后端才有真的 DEVICE_LOCAL 拷贝与 host 侧流式池。
这是我读 README 时最容易读混的一处,值得单独拎出来。
native(默认,CPU):没有显存池。tier 0 和 tier 1 在实现上都表现为「页留在物理内存里」,tier 2 表现为「页被还回去」。RSS 就是这件事的直接读数。
Vulkan(--features vulkan):才有两段真正的设备侧安排——VRAM 层的权重一次性上传到 DEVICE_LOCAL(真实显存),disk 层的权重每一步从 HOST_COHERENT 池流过;上传超额的权重按单个权重自动退回流式路径,而不是整批失败。
几个具体数字:默认 CHEETAH_VRAM_POOL_SIZE 是 800 MiB;计算用 GLSL 写的 shared_ops.comp 提供 10 个算子(rms_norm、add/sub、rotary、attention、silu_mul、gelu 精确版与 tanh 版、layer_norm、embedding_gather、bias_add),矩阵乘另有 f32 / bf16 / f16 / q8 四条管线,编译成 SPIR-V 后嵌进二进制,也能用环境变量指向外部 .spv。
Q8 只在 Vulkan 上:行级 int8 加每行一个 f32 scale,权重体积大约减半;norm、bias、embedding 保持原精度。CPU 后端目前只按原始 F32/F16/BF16 加载。
它做过验证的设备也很有意思:Lavapipe(软件光栅器)、Intel Haswell 核显、NVIDIA GT 730M。都是「能跑起来」级别的硬件——这既是加分(说明门槛低),也是提醒(说明不是性能证明)。
四、准备格式:把「加载」变成「映射」
原生后端要一个准备好的模型目录,不是 Hugging Face 原始目录:
cheetah init /path/to/hf-model /path/to/prepared-model
它递归扫 Safetensors,把权重写成对齐的按层分片(.cheetah/weights/),再生成一份自描述的 cheetah_manifest.json;缺 config.json 时能从权重里推断,tokenizer 文件会复制过去,源目录不动。之后加载走 mmap。
这一步的意义常被忽略:mmap 友好的布局意味着「加载模型」不再是一次读满内存的拷贝。没有对齐的分片,页级控制就只能退化成整文件读。
模型族用声明式注册表管理:每个族一个注册文件(架构别名、chat template、stop 标记、两个后端支持、家族常量),build.rs 在编译期生成注册表。族之间的差异被收进一组开关——偏移 norm、embedding scale、GeGLU、LayerNorm、并行残差、融合投影、部分 rotary。按 README 的说法,现有开源的 dense 增量都能用这些开关表达。
已支持:Qwen2、Qwen3、Llama、Gemma、Phi、Mistral、Mixtral(MoE,按 num_experts_per_tok 逐 token 路由)。
五、服务面:够用,但边界写得很清楚
cheetah serve /path/to/prepared-model --host 127.0.0.1 --port 8080
/v1/chat/completions(支持 SSE 流式)、/v1/completions(不支持流式)、/v1/models、/v1/models/:id、/health(免认证)。其余请求必须带 Authorization: Bearer <key>;没有认证时,服务拒绝监听非 loopback 地址——这条我很少在同类项目里见到,是对的默认。
三个容易踩的坑,文档自己写了:
CHEETAH_DEVICE 忘了 export。写一行 CHEETAH_DEVICE=vulkan 而不导出,子进程看不到,Cheetah 静默回退到 cpu,不报错。要用 export 或写在命令前缀里。
CHEETAH_DEVICE=vulkan ./target/release/cheetah /path/to/model   # 只对这一条命令生效
export CHEETAH_DEVICE=vulkan                                    # 整个会话
Vulkan 出错不会静默切回 CPU。设备或加载失败会给出诊断并停止。这一点和上一条正好相反:一个是静默回退,一个是绝不回退。
服务是单模型的。一次加载一个,没有热切换;并发靠 --max-concurrent-generations(默认 1)排队;n 只支持 1;没有 embedding、音频、图像接口。
六、它没证明的东西
按重要性排:
- 只有一个模型、一个预算点。123 MB 是 qwen-0.5b 在 16/32 MB 预算下的读数。7B、13B 下这条曲线长什么样,预算和 tok/s 怎么互相挤压,README 没给。而这恰恰是想用的人最需要的。
- 基线是自己退役的路径。2,497 MB 对照的是项目里已被换掉的 Candle CPU 实现,不是 llama.cpp、Ollama 或任何成熟引擎。这不影响「分层能把 RSS 压下来」这个结论,但影响「它比谁好」。
- 省的是 RSS,不是吞吐。文档只说磁盘层按步回读,没给「预算 → tok/s」的曲线。低内存不等于高效,这条在草稿里就有,确认成立。
- 没有第三方复现。16 star、2 fork、建库 20 天。代码量小、文档齐全(
docs/ANT_MEMORY.md、docs/CODEBASE.md、docs/REGISTRY.md),但所有数字都是作者自己的机器。 - Vulkan 的验证设备都很弱。Lavapipe 是软件实现,GT 730M 是 2013 年的卡。能跑通不等于有收益;README 自己说小模型上 CPU 路径往往更快。
- 不支持 GGUF。现有 GGUF 模型要转成 Safetensors 再用。
- Windows 只能走 WSL2。C 初始化代码用了 POSIX API,原生 Windows 构建「未文档化、未验证」。
- 文档内部两处措辞不一致。算子那节说 VRAM 层权重在 DEVICE_LOCAL,FAQ 又说 Vulkan「把权重留在 host 内存」。按上下文理解,后者指绝大多数权重实际走 HOST_COHERENT 流式池——两句话不矛盾,但第一次读会绕。
七、我的判断
我认为这个项目真正提出的问题,比它现在的答案更有价值。
「常驻内存」是可以设计的产品参数。大多数推理引擎把 RSS 当成结果:模型多大、上下文多长,内存就多少。Cheetah 把它当成输入:你给 16 MB,它就想办法只用 16 MB,代价是慢。这个视角对边缘设备和「一台机器上同时跑好几个小模型」的场景很实用——虽然它现在只支持单模型。
页级控制比「换更小的模型」更通用。量化、蒸馏、换小模型都是在改模型;madvise(DONTNEED) 是在改加载方式。两者可以叠加:Q8 减半体积,分层再把常驻压下去。
MoE 是这条路最自然的下一步,也是原草稿提的那个问题。Mixtral 已经按 token 路由专家,专家天然就是「unit」;如果 tier 表能跟着路由热点动态变,专家就可以按需在 VRAM / RAM / SSD 之间搬。但要注意:MoE 的热点随 token 变,静态分层 + 固定预取会失手,真正难的是预取策略而不是分层本身。这是我从它的设计推断的,不是它已经做到的。
最后说一句冷水:它是一个把想法写清楚、把边界也写清楚的个人项目,不是被验证过的引擎。如果你要找能上生产的东西,答案不在这里;如果你想看「页级预算」这件事能怎么落地,它是一个很干净的样本。
项目与资料
- 仓库:DA3M0/Cheetah(Apache-2.0)
- Ant 内存设计:docs/ANT_MEMORY.md
- 代码库地图:docs/CODEBASE.md
- 模型注册层:docs/REGISTRY.md
数据来源:star / fork / 建库时间与许可取自 GitHub REST API(2026-11-19);123 MB 与 2,497 MB、8 tok/s、16 MB / 32 MB 预算、算子与池的默认值均取自仓库 README;Ant 的层级定义与 madvise(DONTNEED) 机制取自 README 的 Ant memory 一节。文中对 MoE 动态分层的讨论是我基于其设计的推断,不是项目已实现的能力。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- AI Filmmaking Camera Control:让模型只抄镜头,不抄人
- 认知博弈:形式化、求解与可辨识性综述
- 麦田(Maitian):平台改版那天,不该让每个用户升级一次
- The Software Engineering Handbook:把工程判断写成一份自由度账本
- Hypit:你编辑的是词,秒是编译出来的
- Omni LoRA:一个 671 MB 的修正,要背两个任务
- Omni-Quantized:12 个构建,两套布局,省的是显存不是时间
- video-shotcraft:150 个镜头名,就是 Agent 的接口
- Jina-OCR-v1:赢在少写,不在写快
- MNN-Pocket-0.3B:不是把大模型缩小,是从两个预算反推形状