The Software Engineering Handbook:把工程判断写成一份自由度账本
11。0。1。
11 章,0 个算法,1 条五步链。
James C. Davis 在导言里把话说得很死:这本书不给做这些决定的算法。有后果的决定总是牵涉互相冲突的考虑、不完整的知识、不完美的测量和不确定性——正因如此才需要判断,也正因如此没法写成算法。
它给的是每个章节都要重走一遍的一条链:
Model → Property → Observation → Evidence → Judgment
The Software Engineering Handbook 副标题是 A Judgment and Decision-Making Approach。作者是 Purdue ECE 的助理教授,Edition 1 于 2026-09-12 首发,仓库最近一次提交是 2026-11-17。全书 11 章,另有一篇导言和一个结论;仓库 MIT 许可,目前 54 star、3 fork——这个数字说明它还没被当成“必读”,但它值得。
我的判断是:
这本书最有用的地方,不是它讲了受控变化,而是它把“工程判断”拆成了两样可以写下来、也可以被别人审查的东西:你钉死了哪些自由度,以及你凭什么证据敢交付。
下面按这两条线读。
一、目录本身就是论点
第 10 章是研究与开发(R&D)。按常规教材的顺序,它该排在前面——先做研究,再做需求、架构、实现。
作者把它挪到了最后,并在导言里解释了原因:R&D 要求工程师判断有限的精力该往哪投、眼前的障碍是不是真的需要新想法、什么样的证据才算一次推进——这些决定,没有工程经验的人很难体会。所以他让读者先走完前十章。
这个安排本身就是书的论点:判断力不是读出来的,是把前面的决定一个个做过之后长出来的。这一点会在第七节重新出现,因为 AI 恰好把“做那些决定”的机会接走了。
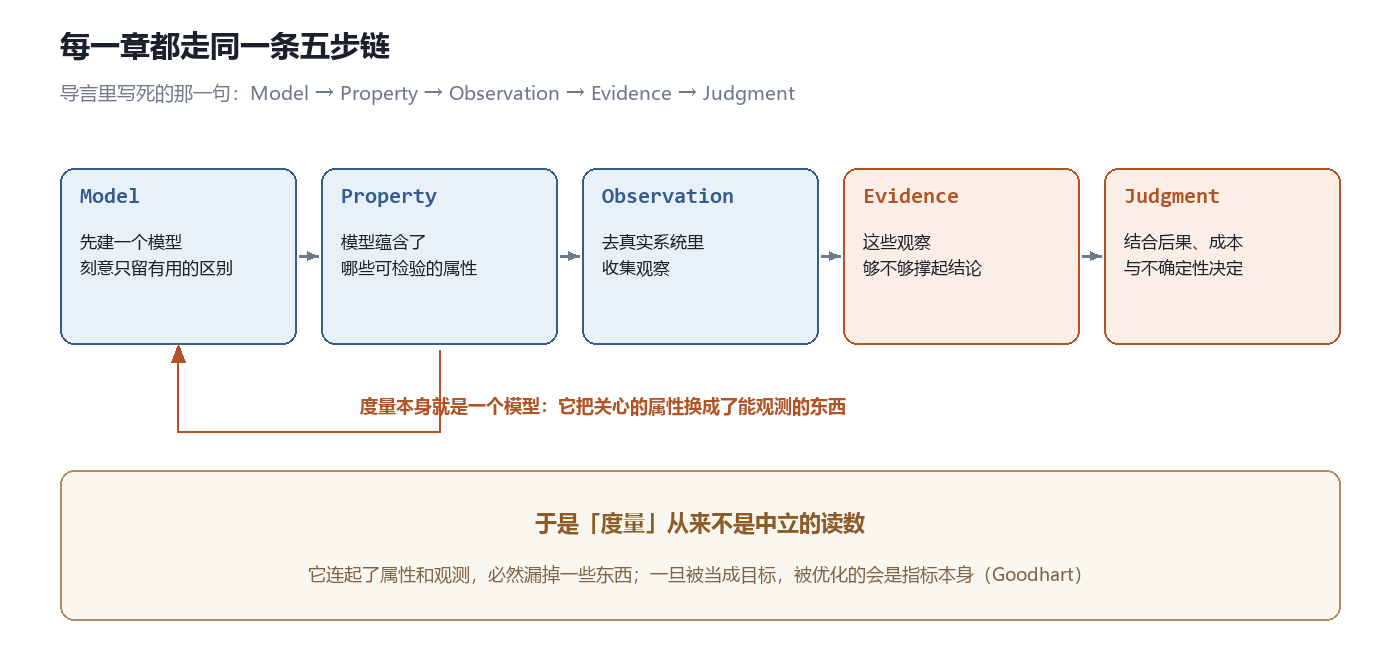
每一章的结构都是同一件事:先建模型,再问这个模型蕴含哪些属性,然后去真实系统里观察,判断这些观察够不够,最后结合后果做决定。
第 9 章把这条链写得更细一点:Property → Metric → Measurement → Evidence → Judgment。多出来的两个词是这本书的一个暗线——度量本身也是一个模型。它把“你关心的属性”换成了“你能观测的东西”,这个替换必然漏掉一些东西;一旦被当成目标,被优化的就会是指标本身。作者点名了 Goodhart。
所以这本书对“用什么指标”这件事的态度是:几乎没有一个有后果的工程决定,可以被负责任地压成单个指标。
二、第一章:软件是媒介,不是代码
第一章的标题就是全书的地基:Software Engineering: The Engineering Discipline of Controlled Change。
书里先把工程定义了一遍(引自配套的 MAGE):
工程是对重大系统行使有根据的控制、并为结果负责的学科。工程师不必亲自完成实现一个系统所需的每一个动作;但他必须保有足够的主导权,去理解并指挥这项工作、评估关于其关键属性的证据、识别假设何时失效、并在必要时介入。
然后把软件当作一种媒介来描述,和混凝土、钢材并列:可改变、可复制、可迁移、可更新。四条属性各自都很普通,合起来产生的东西不普通——一次决定可以被复制到百万台设备上。同一套机制既能把修复送到每个已部署实例,也能把缺陷、漏洞和错误假设一起送过去。
这就是“受控变化”:不是阻止变化,而是在允许变化的同时,保住那些必须为真的属性。
这里有个细节值得单独拎出来。书对“软件”的定义是:行为被表示为可由机器执行的媒介,既包括传统的指令式计算,也包括机器推理。紧接着它举的例子是 coding agent——agent 的软件提供工具、上下文、约束和一个目标,由 agent 自己推理该采取哪些动作。
也就是说,在这本书的框架里,Agent 不是软件工程的例外,而是软件的一种新写法。它的行为同样被表示为可执行的媒介,因此同样落在“受控变化”的问题域里。
三、两本账:怎么排工作,和要多少证据
第二章是我认为最容易被误读的一章。
书里给了三个维度来判断该用什么样的流程:
- Certainty:动手之前,能知道多少?
- Changeability:改主意有多贵?
- Decomposability:能不能只做一部分就有用?
多数解读会在这里补一句“模块边界清晰就可以并行开发”。这是把 decomposability 读成了“能不能拆给多个 agent 并行”。书里的定义更窄也更工程化:它问的是部分系统能不能被验证、以及部分系统能不能独立产生价值——两个不同的门槛。能验证但还不能用,增量依然有价值,因为验证本身产出信息。
然后是这一章真正的设计:失败的后果,被刻意排除在这三个维度之外。
作者的论证是干净的:后果大不大,不告诉你需求能不能提前知道,不告诉你决定好不好改,也不告诉你部分系统能不能被验证。一个高后果的系统可以落在这三个维度的任何位置。后果回答的是另一个问题:交付之前要多少证据。
于是有了两本账:三维决定“工作怎么排”,后果决定“要多少证据”。混在一起,就会得出“高风险必须瀑布、迭代等于不严谨”这种结论,而书里明确说这两件事不是一回事。
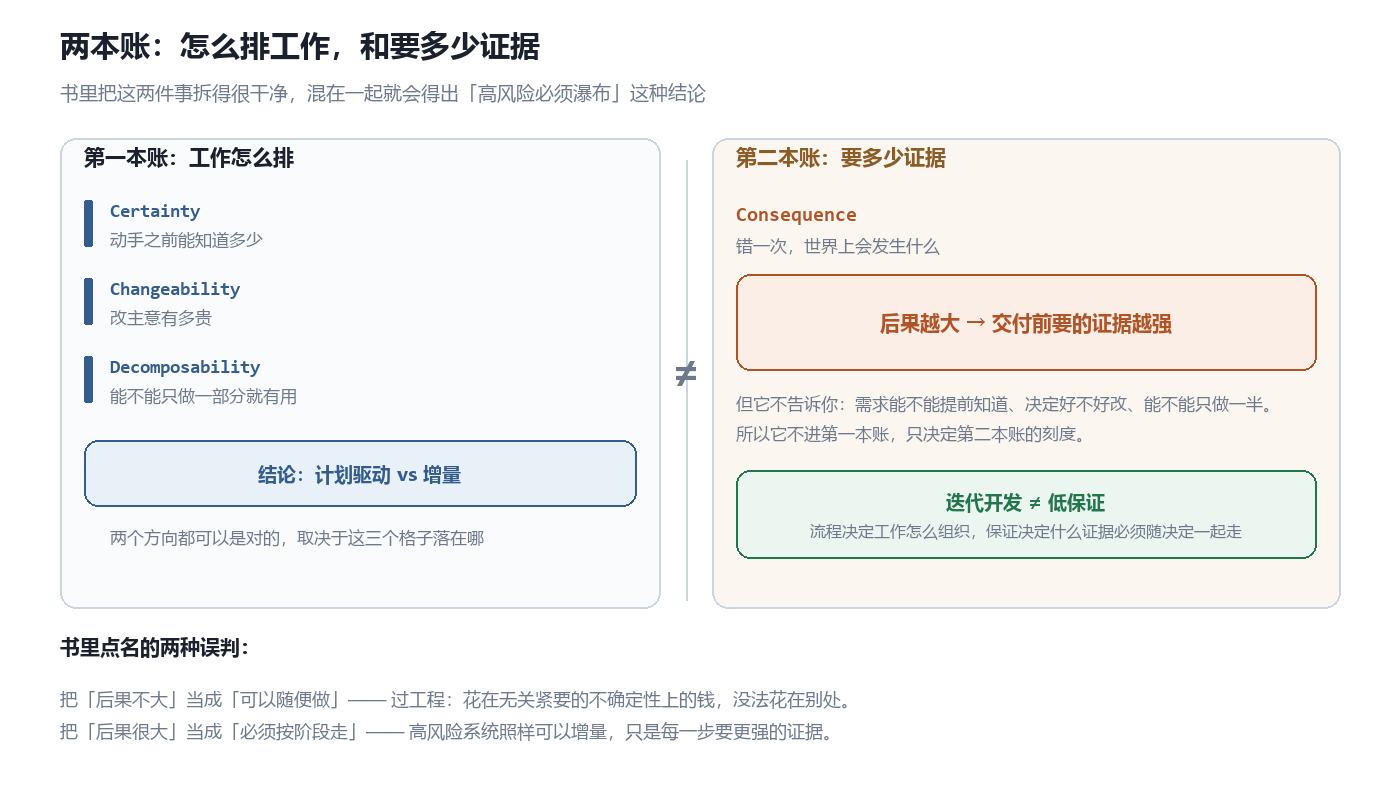
书里点名的两种误判:为无关紧要的不确定性做过量工程;以及把高后果误读成必须按阶段走。
这一章还有一个我很喜欢的转向:三个维度不是地形,是可以改造的地形。不确定太多,就投资确定性(原型、访谈、实验);决定太难改,就投资可改性(模块化、接口、自动化测试);分不出可验证的部分,就投资可分解性(垂直切片、接口先行)。当然,改造本身也是决定,也有成本——模块化更易改但更难懂,独立部署需要基础设施,原型要花时间。
四、没写下来,不等于自由
第六章是我认为全书最可操作的一章。
规格说明要回答三个判断:力气该花在哪(有后果又没搞清的地方)、责任归谁(机器可以假设环境什么、必须自己保证什么)、以及卡多紧。
第三个判断的关键,是区分三种“没写下来”:
- unknown:后果还没搞清楚,现在决定等于瞎猜;
- tacit:边界其实存在,只是没人写下来;
- free:几种做法都行,差异不构成后果。
只有第三种才是真正的自由度。前两种看起来都“没约束”,但一个是欠学习,一个是欠显式化。
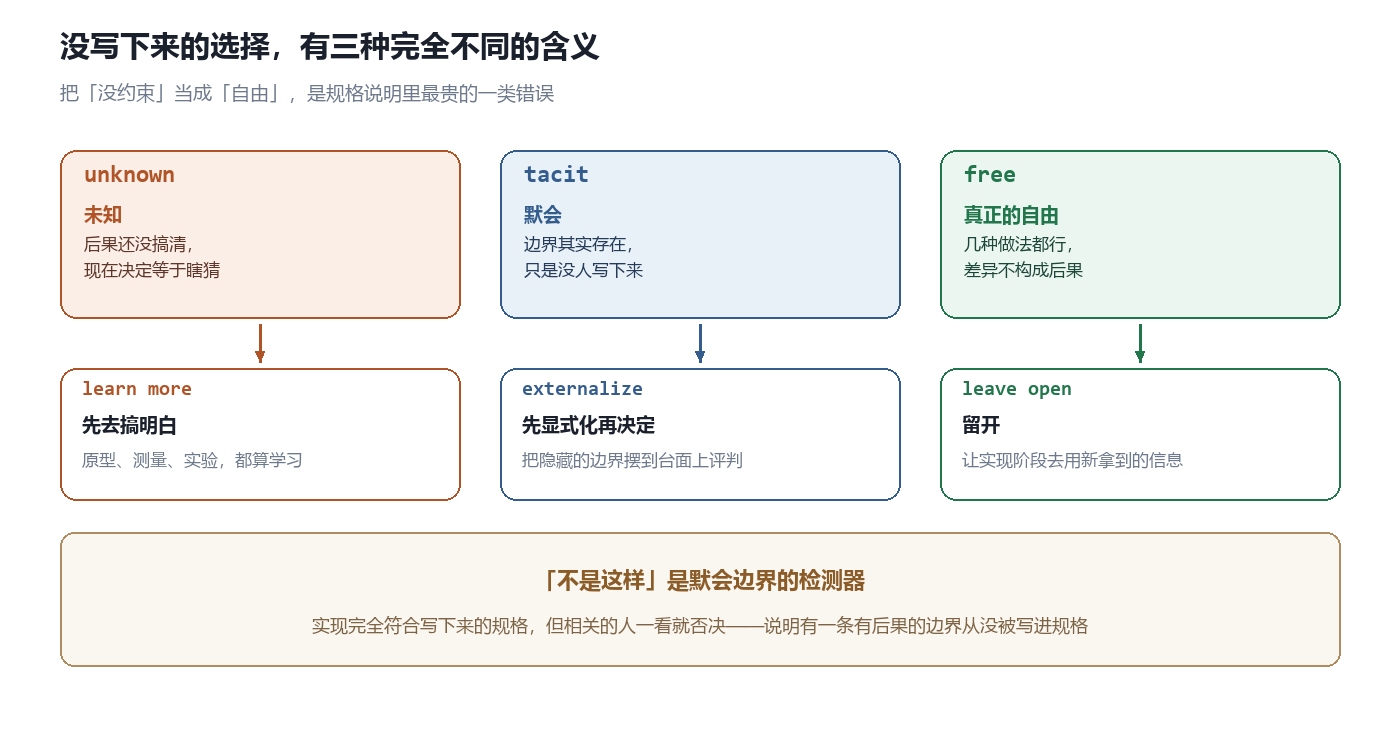
把「没约束」当成「自由」,是规格说明里最贵的一类错误。
书里还给了一个几乎可以当工具用的检测器:「不是这样」。
如果一份实现完全符合写下来的规格,但相关的人一看就否决——「不是那么晚」「不是给他看」「不是那么多」——那说明有一条有后果的边界从来没被写进规格。这个否决不是需求变更,是证据:它证明一个看起来自由的选择其实不自由。
对应的三个动作就是 Constrain / Leave open / Learn more。这套三分法对写 Agent 约束的人尤其直接:你的 prompt 里那些没写的东西,是未知、是默会,还是真的自由?如果是默会,Agent 会替你做出决定,而且是在你最不希望它做决定的地方。
五、每往下走一步,空间就收窄一次
第六章还有一句话,把整条需求到实现的链路串起来了。借用 Zave 和 Jackson(1997)的写法:给定环境假设 E 和机器规格 S,需求 R 必须能推出来。规格说明的工作,就是决定 E 和 S 各承担多少。
这句话不是形式化的装饰,它有一个很实际的推论:自动化绝大多数时候不是在加功能,而是在把责任从环境搬到机器里。「操作员会保证输入合法」变成「系统应该检测并修复非法输入」;「只在公司内网运行」变成「还要支持公网访问」。功能列表上看是多了一条,工程上看是机器多背了一份责任,而那份责任的证据要求也跟着搬过来了。
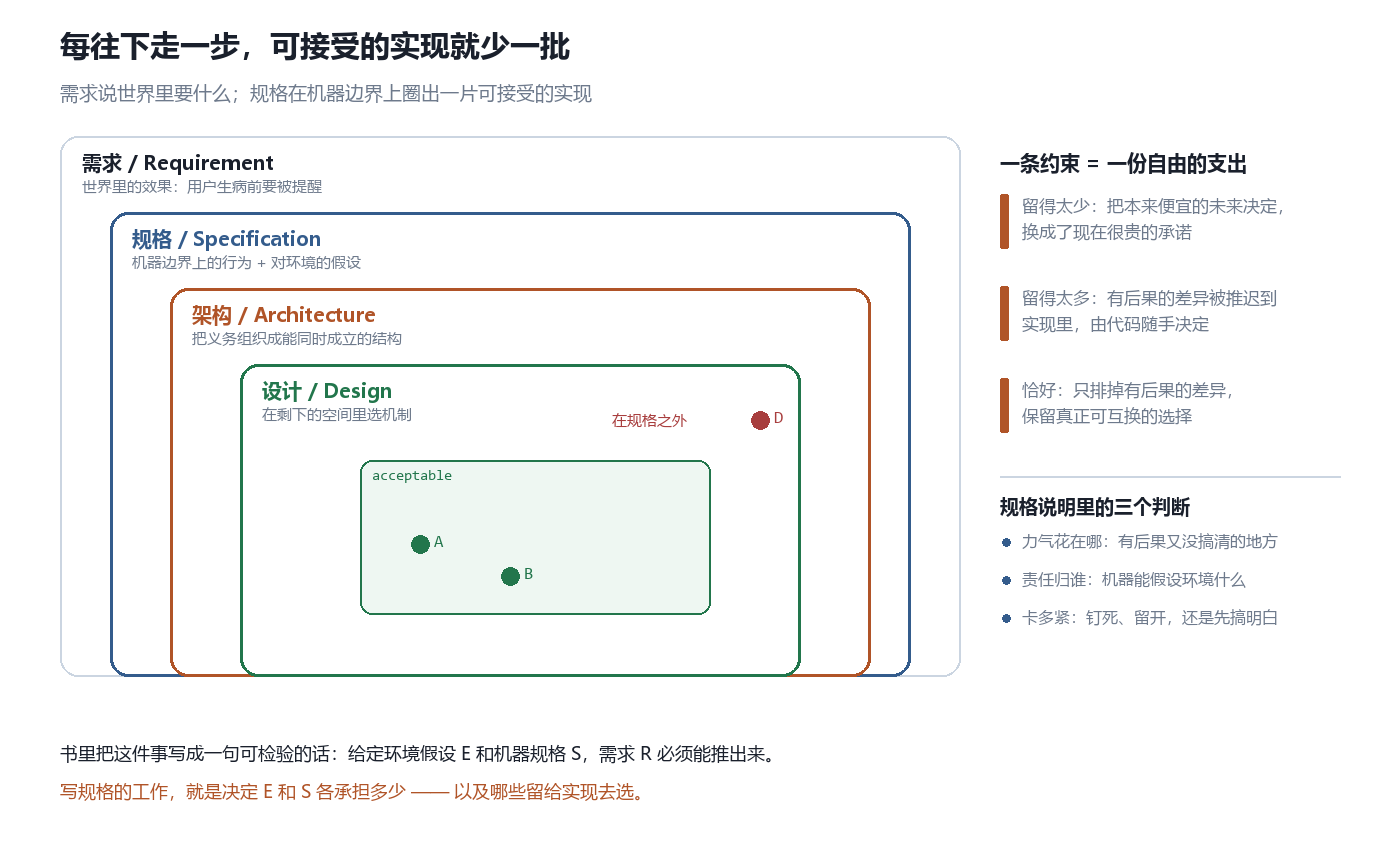
规格圈出一片可接受的实现;每加一条约束,就花掉一份自由。
书里的原图只画了「可接受区域」和几个点,我把它按章节顺序叠成了四层。要提醒的是:每加一条约束都在消耗自由——留得太少,把本来便宜的未来决定换成现在很贵的承诺;留得太多,有后果的差异就被推迟到实现里,由代码随手决定。
六、证据:交付是一次判断,不是一次检查
第九章是全书的高潮,也是最该给 Agent 平台开发者读的一章。
它的前提是:验证不是测试。测试只是获取证据的一种方式,工程问题在前面——在愿意交付之前,我们必须知道什么?
顺着这个问题,书里做了一件很利落的事:把「证据强度」拆成几个可以分别判定的维度。
| 维度 | 问的是什么 |
|---|---|
| 覆盖 | 证据走到了哪里 |
| 检出能力 | 走到那里时,它能认出错误吗 |
| 代表性 | 观察的条件和真实运行条件像不像 |
| 作用域 | 证据是在属性真正存在的层级上取的吗 |
| 独立性 | 多个证据会不会被同一个错误一起打败 |
| 假设 | 这堆证据共同依赖哪些前提 |
书里用一个极简的模型说明了为什么“测试数量”本身不是证据:若某缺陷被单次测试检出的概率是 p,那么 n 次独立测试全部漏掉它的概率是 (1−p)^n。5 次是 0.951,5,000 次是 1.5×10⁻²²。但 p 又被拆成两项——碰到相关行为的概率 × 认出它是错误的概率。任意一项是零,再多的测试也是零。这正是“生成 5,000 个通过测试”最危险的地方:如果实现和测试来自同一个对需求的解释,它们共享同一个错误的判据。
对残余不确定性,书里给了三个不同性质的应对:
margin(余量):量化属性的观察值离不可接受边界还有多远。420 ms 和 499 ms 都满足 500 ms 的规格,但处境完全不同——而且真正该关心的是扣掉工作负载、环境和测量波动之后还剩多少余量。
containment(围堵):软件的离散性让“接近正确”没有意义——一个执行要么越权了要么没有,不存在“几乎越权”。所以对没被证据覆盖到的行为,靠架构去限制它能影响的范围:接口、隔离、权限、事务、超时、灰度、回滚。书里把 Meyer 的 modular continuity / protection 延伸了一步:连续性约束变化的传播,保护性约束失败的传播,围堵约束“证据没发现的东西”的后果。
reversibility(可逆性):发现错了之后还能做什么。
最后,交付决定不是二元的,书里列了五种结局:交付、继续取证、改系统、回头改上游决定、拒绝。最后一种需要专门的说明——客户的接受不构成工程师的证据;工程师可以拒绝在一份自己站不住的判断上签字。
这一章还有一个我认为最适合被 agent 平台抄走的句子:证据变了,决定就必须更新。一次在不确定下交付,是把不确定性称过重量之后做的决定;但在“部署中的行为正在造成实质伤害”的证据积累起来之后继续同样的行为,是用一份已经不存在的知识状态里的理由,为现在的决定辩护。
七、AI:变便宜的是实现,换位置的是稀缺项
书的第三章(团队协作)里有一段对 AI 的讨论,比大多数“AI 会取代工程师”的论述都克制。
它先把人不可替换这件事说清楚:两个同级别的工程师能力可以差很远,分配工作会改变他们各自长成什么样,把活一直给最快的那个人,短期最优、长期会让组织更依赖这一个人。然后它指出生成式 AI 的特别之处:AI 是可替换的。能力可以按需购买、并行复制、换一个模型顶上;组织不需要招聘、培养、挽留每一个模型实例。
于是分配问题变了形状:当一种智能变成商品,它的互补品才是稀缺的——决定做什么、提供组织与领域上下文、识别有后果的权衡、评估证据、行使权威、承担责任。
配套的 MAGE 把这件事写成第 6 条主张:工程工作会围绕仍然稀缺的东西重组——表征、证据、治理、协调、判断。
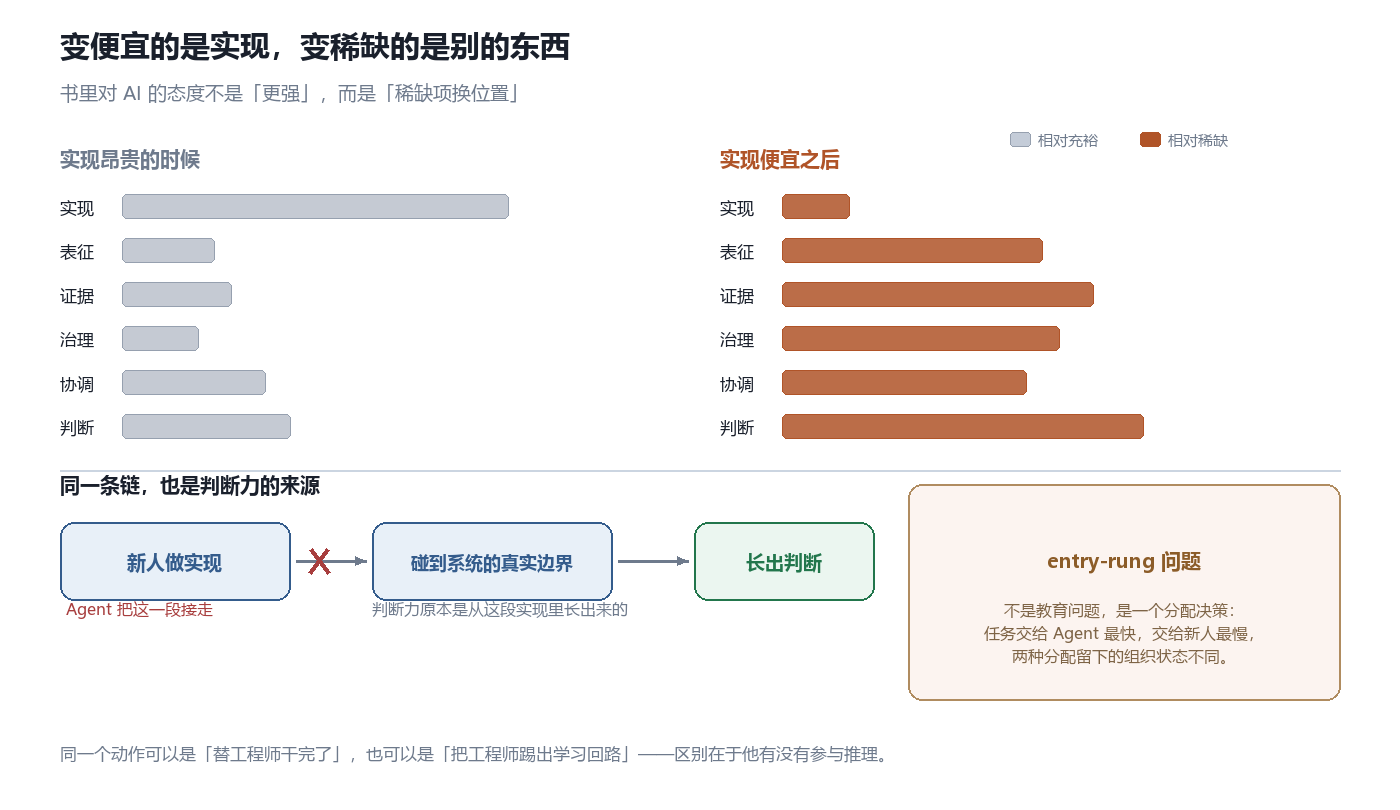
上图是按 MAGE 的说法画的示意,不是书里的实测数据;下图是这一章真正的问题。
然后是 entry-rung problem。传统上,初级工程师是通过实现工作变成资深工程师的:实现、撞上不熟悉的系统、犯错、被 review、debug、慢慢积累上下文和判断。如果 AI 把这些工作接走,组织以后从哪儿长出资深工程师?
书里最锋利的处理,是把它写成一个具体的分配决策,而不是一个教育议题:Agent 独自做,当期效率最高;新人独自做,产出慢但长经验;新人和 Agent 一起做,可能同时加速产出和学习,也可能只是把推理藏了起来。这三种分配不能只比当期成本,因为它们留给组织的状态不同。
它还给了同一件事的两种结局:一个把任务交出去、接受产物、留在推理之外的工程师,几乎不会从这次工作里长出能力;一个先形成假设、用 agent 去实现或检验、再看证据、诊断失败、修正路径的工程师,学习循环可能比过去快得多——委派可以把工程师踢出学习回路,也可以加速这个回路。
八、这本书不给你什么
按重要性排:
- 不是教程。 没有代码,没有可运行的例子,没有 checklist。作者自己在导言里说得很清楚:不给算法。想要“照着做”的人会失望。
- 例子偏温和。 睡眠顾问、支付服务、TODO 应用、医疗设备、A-7E 的飞机规格——例子是对的,但都是二手叙述,没有一手数据。工业案例被放在了配套的 MAGE 那本里(Cloudflare、Spotify、Shopify、Uber、Amazon、GitLab)。
- 对 Agent 工程只到原则层。 约束、传感器、闸门(MAGE 的 constraints / sensors / gates)在手册里只是判断的框架,不涉及具体怎么实现。想拿它直接设计一个 agent 平台,还得自己补一层。
- 规范性文本,不是实证研究。 它说的是“应该怎样判断”,不是“这样判断的公司表现更好”。这个定位本身没问题,但别把它当成效果证据。
- 英文,且没有中文版。 术语密度不低,尤其是 coordination / specification / validation 三章的词汇表是自建的。
- 第 10 章放最后是有代价的。 作者自己承认:没有工程经验很难体会 R&D 里的判断。反过来说,完全没做过生产系统的人读到第十章会很空。
页数这件事我没能核实:站点没有标注,PDF 我也读不了(这次只读了网页版各章)。所以本文不引用任何“xx 页”的说法。
九、我的判断
如果只从这本书里拿三样东西,我会拿这三样。
第一样:三种“没写下来”。 未知、默会、真自由——这个三分法可以直接搬进任何一份 agent 的约束设计里。它把“要不要写得更细”这个模糊问题,换成了“这是哪一种没写”。而「不是这样」这个检测器,可以变成一个真实的采样来源:凡是实现通过了规格却被否决的 case,都是规格漏掉的那条边界。
第二样:两本账。 把“工作怎么排”和“要多少证据”分开,是这本书最结构性的一步。它顺手解决了两个常见的滑坡:高风险不等于重流程,迭代也不等于低保证。
第三样:证据的三个旋钮。 余量、围堵、可逆性。这三个词比“测试覆盖率”有用得多,因为它们分别对应三种不同的不确定性,而且都能落到具体设计上——余量是阈值和容量规划,围堵是隔离与权限,可逆性是灰度与回滚。
这和我一直关心的那类工作其实是同一件事:把“最终产物对不对”这个没法直接回答的问题,拆成一组可寻址的中间量,然后在中间量上做观测和干预。这本书的版本是把它拆成 model / property / observation / evidence / judgment 五步;而它最有价值的一句提醒,是那个容易被忽略的括号——度量和模型一样,也是你选的,不是世界给的。
项目与资料
- 全书在线版:The Software Engineering Handbook(含 PDF / ePub)
- 配套理论:Model-Based Agentic Engineering(MAGE)
- 仓库:davisjam/model-based-agentic-software-engineering(MIT)
数据来源:章节结构与定义取自书籍网页版的导言、第 1、2、3、6、9 章原文;Edition 1 首发日期与更新日期取自站点页脚与仓库 pushed_at;star / fork 取自 GitHub REST API(2026-11-18)。图 5 上半部分是依据 MAGE 第 6 条主张绘制的示意,不是实测数据。本文为技术解读,不是翻译。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- 麦田(Maitian):平台改版那天,不该让每个用户升级一次
- Hypit:你编辑的是词,秒是编译出来的
- Omni LoRA:一个 671 MB 的修正,要背两个任务
- Omni-Quantized:12 个构建,两套布局,省的是显存不是时间
- video-shotcraft:150 个镜头名,就是 Agent 的接口
- Jina-OCR-v1:赢在少写,不在写快
- MNN-Pocket-0.3B:不是把大模型缩小,是从两个预算反推形状
- rust-anything:语言迁移不是翻译,是一场可以判负的比较
- SFT 与 RLHF:教接口,选口味,然后收窄
- Mainline:工程判断该住在 Git 里,不该住在数据库里