Transformer Explainer:把 GPT-2 塞进浏览器,让模型边算边解释自己
先给三个数字,它们说明这个项目的量级。
- 490,000:这个工具上线以来吸引的用户数,覆盖 200 多个国家。
- 90:论文里对照实验的参与者人数,比较对象是博客文章和视频。
- 124M:浏览器里真正在跑的那个模型,GPT-2 Small。
Transformer Explainer 是佐治亚理工 Polo Club 的作品,2024 年先以 IEEE VIS 海报拿了个最佳海报奖,扩写后的完整论文发在 CHI 2026。项目 MIT 开源,在线版打开就能用。
- 在线体验:poloclub.github.io/transformer-explainer
- 仓库:poloclub/transformer-explainer
- 论文:arXiv 2408.04619(CHI ‘26,DOI 10.1145/3772318.3791725)
本文只讲一件事:它凭什么能在教学上站住脚——不是图画得好看,而是图里的每个数字都来自正在跑的那次前向计算。
一、它真正做的事:一次前向,两种产物
静态架构图的问题是:它永远正确,也永远和你输入的那句话无关。
你读到的“Attention 会计算相关性”,和你输入“Data visualization”之后模型实际算出的那个 5×5 矩阵,是两回事。前者是知识,后者是证据。
Transformer Explainer 把这两件事合并了。你输入的文本进入浏览器里的 GPT-2,同一次前向计算产生两种产物:
你的输入
  → GPT-2(浏览器内,一次前向)
      ├─ 产物 A:下一个 token 的概率(模型真正的输出)
      └─ 产物 B:每一层的中间张量(被画成图的那部分)
第二列不是“再画一遍”,是顺手截下来的。所以当你在界面上看到某个 token 对另一个 token 的注意力权重是 0.31,那个 0.31 就是这次计算里真实发生的数。
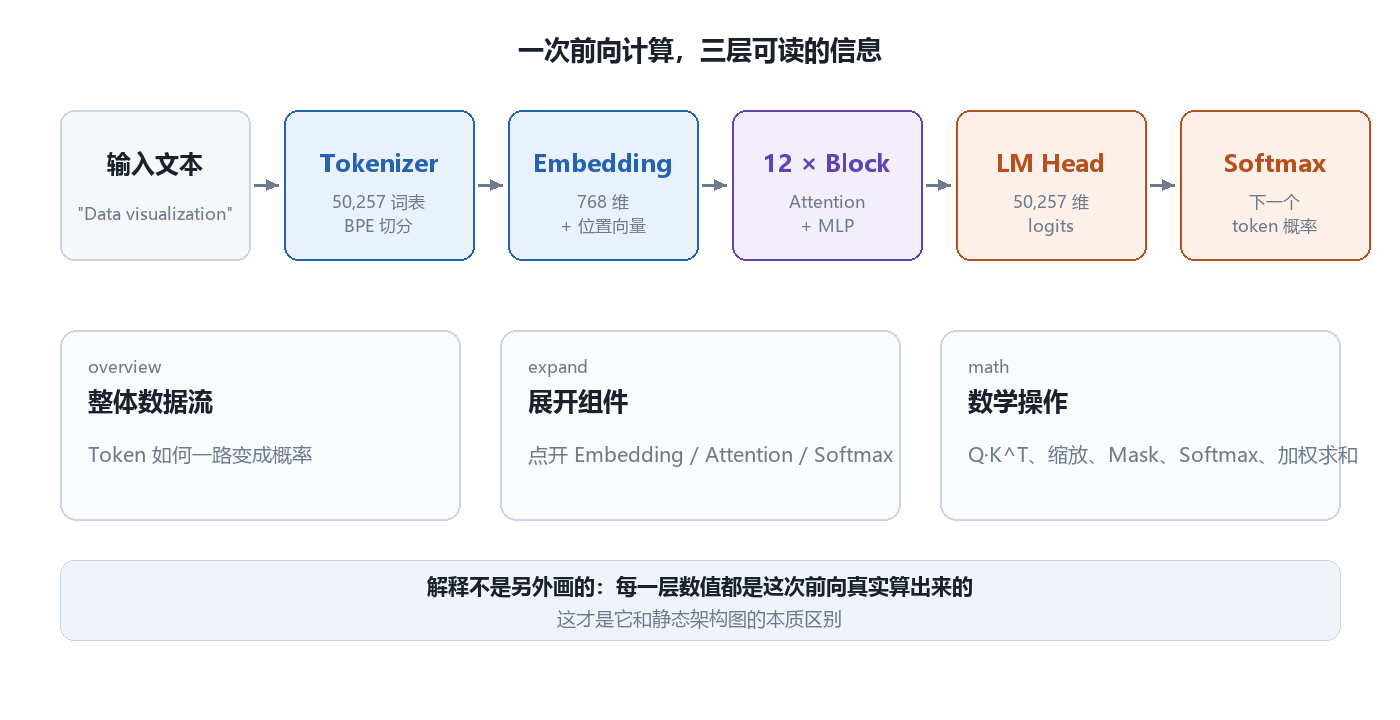
从上到下是数据流,从左到右是三档解释深度。
同一张界面还组织了三档抽象层级:
| 层级 | 你看到什么 | 解决什么问题 |
|---|---|---|
| overview | Token 怎么一路变成概率 | 建立全局地图 |
| expand | 点开 Embedding / Attention / Softmax | 看清某个组件内部 |
| math | Q·K^T、缩放、Mask、Softmax、加权求和 | 对上公式 |
后文按这条线走:先讲数据怎么流,再讲每一站发生了什么,最后讲它为什么必须在浏览器里跑。
二、分词:结果比直觉更碎
GPT-2 用的是 BPE,词表 50,257。切分结果经常不符合“一个词一个 token”的直觉。
论文自己的例子:
Data visualization empowers
→ ["Data", " visualization", " em", "powers"]
两个反直觉的地方:
-
visualization是一个 token,没有被切开; -
empowers被切成em+powers,而且第二个 token 带着前导空格。
前导空格不是排版问题,是 GPT-2 的词表里真实存在 Ġ(代表空格)这种记号。你看到的“单词”,模型看到的是带空格的片段。
这解释了一个常见困惑:为什么模型有时会把一个词续得很奇怪?因为它从来不是按词处理的。
三、Embedding 与位置:把符号变成向量
Token ID 只是个索引,没有语义。模型查一张 $50257 \times 768$ 的表,把每个 ID 换成一个 768 维向量:
\[H_0 = E_{\text{token}}(x) + E_{\text{pos}}(i)\]位置信息是可学习的位置嵌入,直接加到 token 向量上。这里有个细节值得注意:加法意味着位置信息不是另开一路,而是和词义混在同一个 768 维空间里——这也是后来 RoPE 想换掉它的原因之一。
界面上点开 Embedding,能看到两条向量相加的过程,以及结果里那些正负交替的小数。数字本身没有可读含义,但有可读的结构:同一位置、不同 token 的向量差异,和不同位置的同一 token 的向量差异,是两种不同的方向。
四、Block:一个模板重复十二次
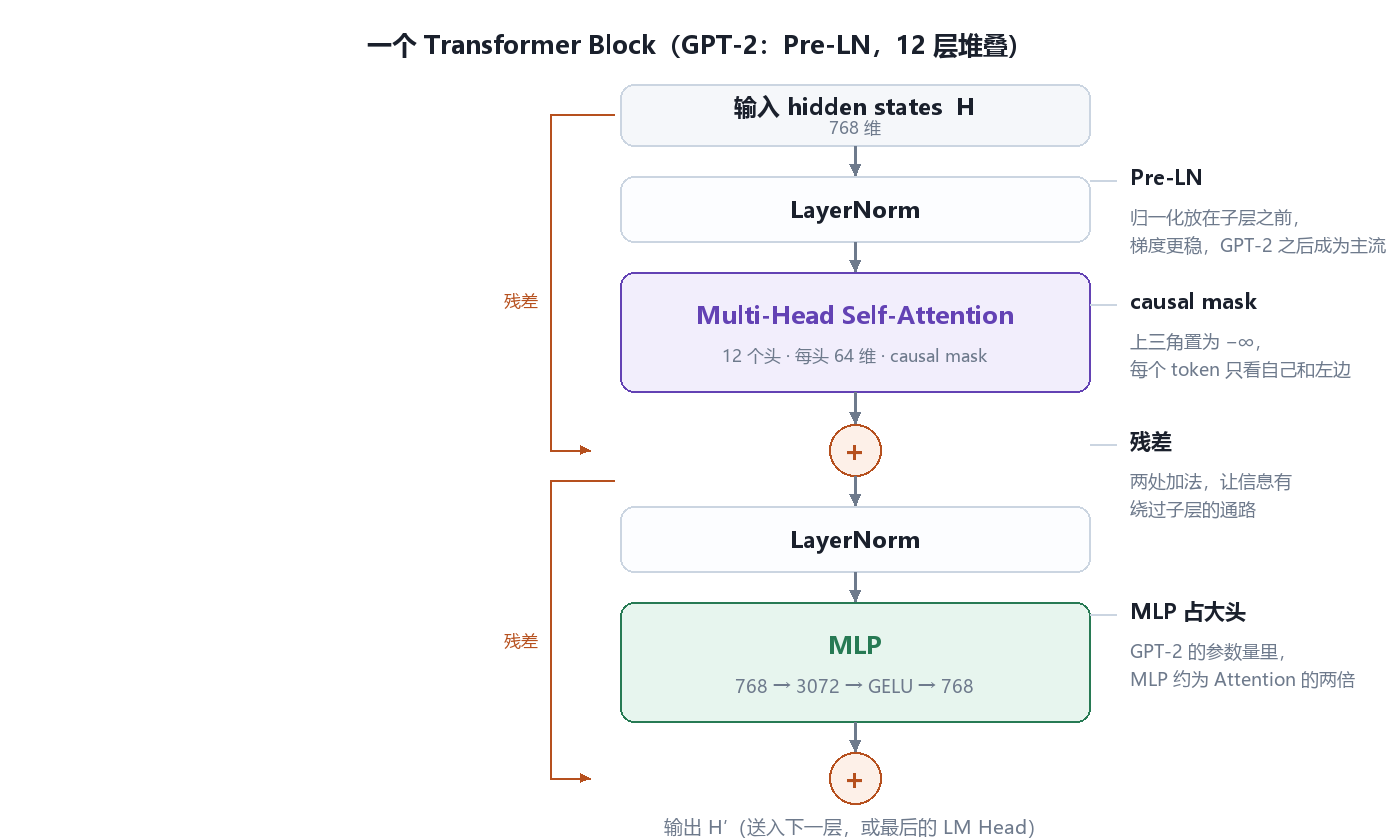
GPT-2 的 Pre-LN 结构:先归一化,再进子层,出来加残差。
GPT-2 Small 的 12 层是同一个结构复制 12 次。它不是最强的模型,但结构完整、推理够快,正好适合“当场算给你看”。每层两件事:
- 多头自注意力:让 token 之间交换信息。
- MLP:对每个 token 单独做非线性变换。
两处残差加法,两处 LayerNorm。GPT-2 用的是 Pre-LN——归一化放在子层之前。这和原始 Transformer 的 Post-LN 相反,好处是梯度能沿着残差直通到底,深层模型更好训;代价是最后要补一个 LayerNorm(GPT-2 的 ln_f),否则输出尺度不对。
MLP 的维度变化是 768 → 3072 → 768,中间用 GELU。参数量上,MLP 比 Attention 大得多:GPT-2 每层 Attention 约 2.4M 参数,MLP 约 4.7M,接近两倍。这一点常被忽视——大家盯着 Attention 看,但模型里一半以上的参数在 MLP 里。
这个图在工具里是可以点开的:点 Attention 进去看 Q、K、V,点 MLP 进去看升维和激活。层级不是靠滚动条切换的,是靠展开动画切换的,而且展开时上下文不丢——这一点后面讲设计时会再提。
五、Attention:五步,和一个三角形
这是整个工具信息密度最高的部分。
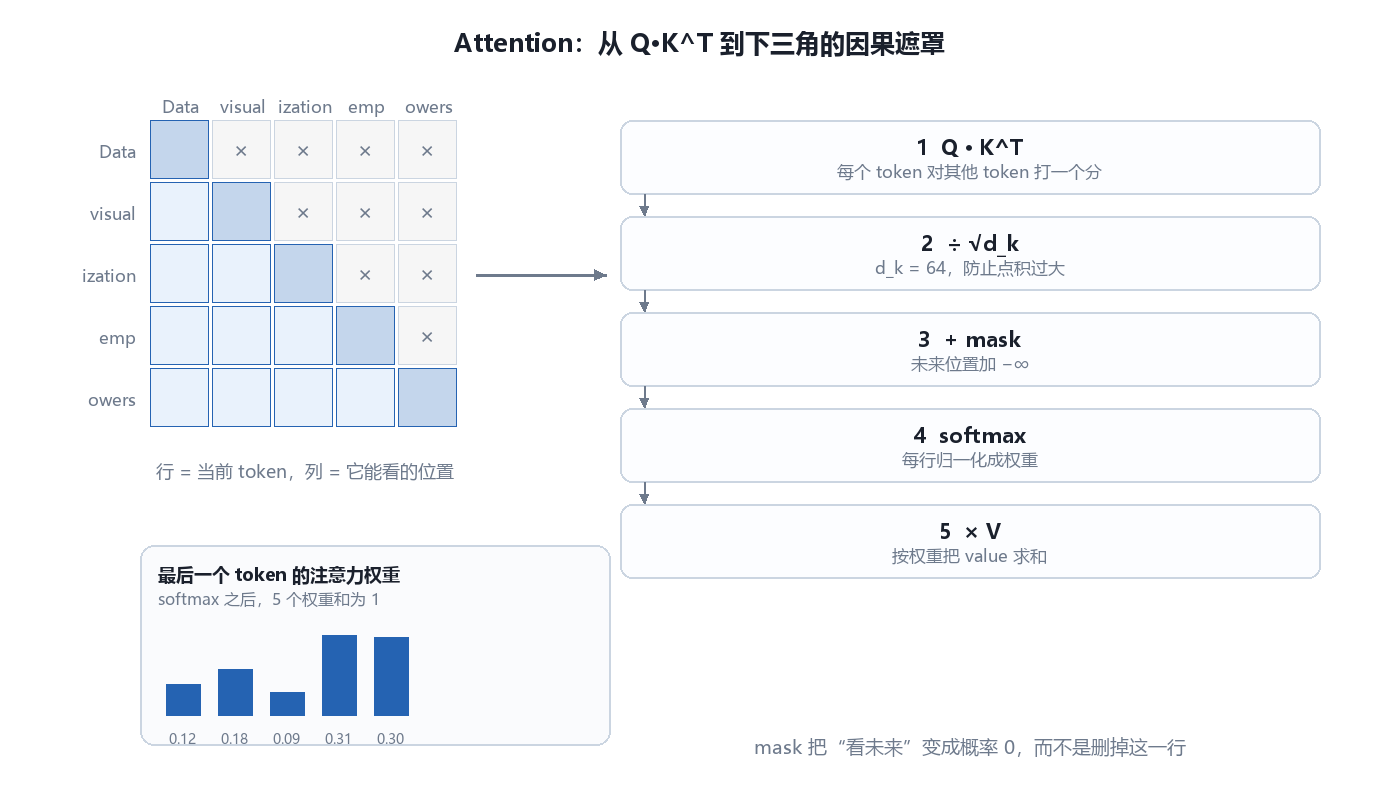
左边的矩阵是这次前向真实算出来的;上三角的 × 是遮罩,不是数据。
五个步骤,每一步对应界面里的一层展开:
① 算分。 每个 token 的 query 和其他 token 的 key 做点积,得到两两之间的相关性分数。
② 缩放。 除以 $\sqrt{d_k}$。GPT-2 的 $d_k = 64$,所以除以 8。不除的话,点积会随维度增大而变大,softmax 之后几乎变成 one-hot,梯度就死了。
③ 遮罩。 未来位置加 $-\infty$,softmax 之后权重变 0。界面上就是那个上三角的 ×。
④ softmax。 每一行归一化成权重,和为 1。
⑤ 加权求和。 用权重把各 token 的 value 加起来,得到这一层的新表示。
写成一个式子:
\[\mathrm{Attn}(Q,K,V)=\mathrm{softmax}\!\left(\frac{QK^{\top}}{\sqrt{d_k}}+M\right)V\]其中 $M$ 是因果遮罩矩阵。注意遮罩加在 softmax 之前,不是之后;加在之后会把归一化破坏掉。
那个三角形值得多看两眼。行是“当前 token”,列是“它能看的位置”,左下三角填充、右上三角是 ×。它把“自回归”这个抽象约束变成了一张可以直接读的图:第一个 token 只能看自己,最后一个 token 能看全部。
工具里还可以切换头、悬停查看单个 token 的注意力分布——这时你会看到一些很直观的现象,比如某个头几乎只关注前一个 token,另一个头在关注句首。
六、多头:12 个 64 维,不是 12 个模型
GPT-2 Small 有 12 个头,每个头 64 维,拼起来 768 维,再过一层线性投影。
768 维
  ├─ Head 1  (64 维)
  ├─ Head 2  (64 维)
  │      ...
  └─ Head 12 (64 维)
        │
     concat → 768 维
        │
     W_O → 768 维输出
这里有三个常见误解:
- 不是 12 个独立模型。它们共享同一份输入,只是用不同的投影矩阵看不同的子空间,最后拼回去。
- 不是“每个头负责一种语法”。头与功能的对应关系因模型、因层而异,得靠实验判断,不能靠命名。
- 头的维度变小了,总计算量没变。12×64 和 1×768 的参数量一样,多头换来的是“多个视角”,不是“更多算力”。
界面里可以逐个切换头,看到同一个句子在不同头下的注意力模式完全不同。这是我觉得比读论文更有说服力的一幕。
七、输出层:把“创造力”拆成三个旋钮
12 层走完,最后一层 hidden state 乘上 $W_{out}$(和 embedding 矩阵转置共享),得到 50,257 维的 logits,再 softmax 成概率。
到这里,模型的工作就结束了。接下来发生的事不是模型做的,是采样策略做的。
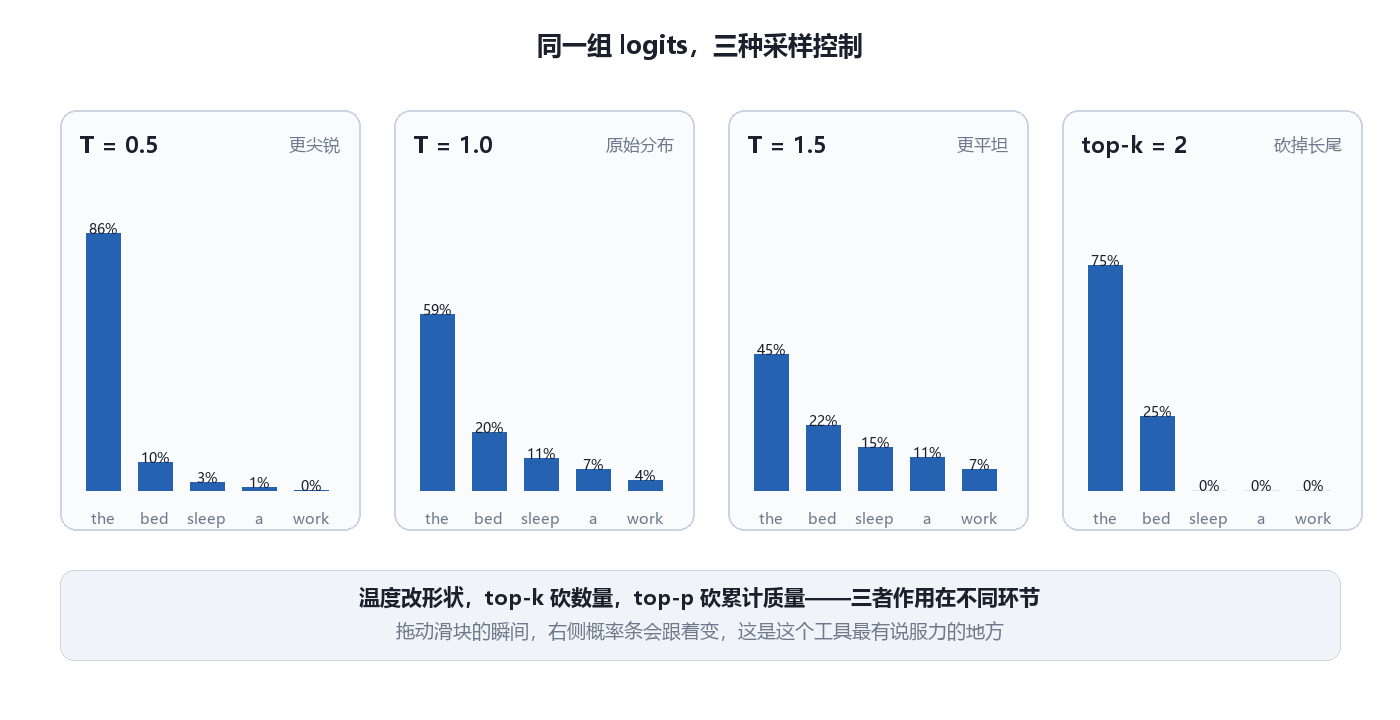
同一组 logits,四个面板:温度改形状,top-k 砍数量,top-p 砍累计质量。
温度就是把 logits 除以 $T$ 再 softmax:
\[P_i=\mathrm{softmax}\!\left(\frac{z_i}{T}\right)\]$T<1$ 让分布更尖,$T>1$ 让分布更平。它不改变模型的知识,只改变你从分布里抽样的方式。
top-k 保留概率最高的 K 个;top-p 按累计概率截断,候选集合大小是动态的。三者的作用环节不同:
| 参数 | 作用对象 | 一句话 |
|---|---|---|
| Temperature | 分布形状 | 决定“多敢选低概率词” |
| Top-k | 候选数量 | 固定砍掉长尾 |
| Top-p | 累计质量 | 按概率动态截断 |
工具里拖动滑块,右侧概率条会立刻重排。这比任何“temperature 是创造力参数”的解释都清楚——你会亲眼看到它没有创造任何新东西,只是把已有的分布压扁或拉尖。
八、浏览器里跑 GPT-2:650MB 与一条本地推理链路
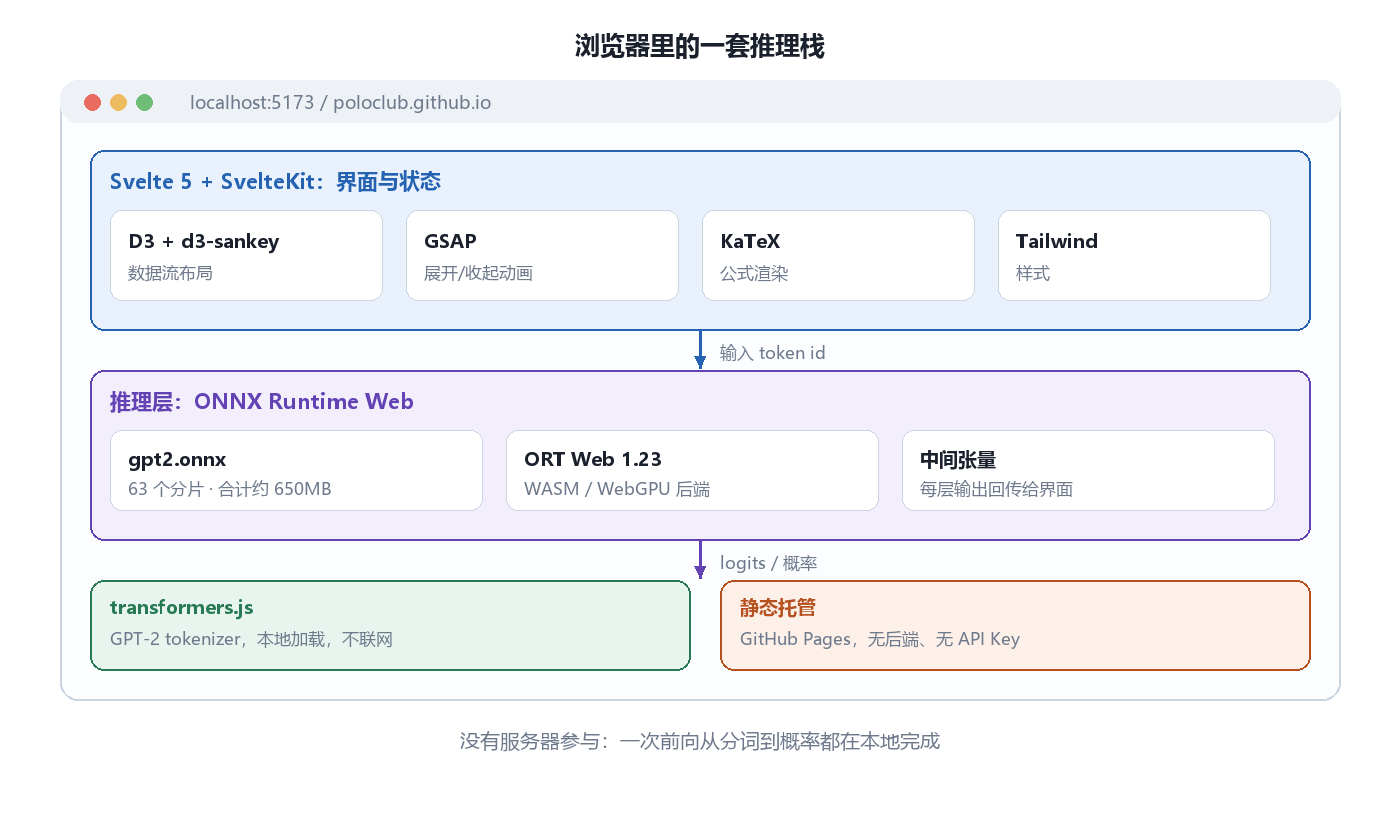
没有服务器:分词、推理、可视化都在同一个页面里。
这是整个项目工程上最有意思的部分。技术栈不是“用了几个库”,而是每个库解决一个具体障碍:
| 层 | 用的东西 | 为什么是它 |
|---|---|---|
| 框架 | Svelte 5 + SvelteKit | 细粒度响应式,数据变图就变,不用手动 diff |
| 数据流布局 | D3 + d3-sankey | token 流本来就是一张有向图 |
| 转场 | GSAP | 展开/收起要保持上下文,纯 CSS 做不到 |
| 公式 | KaTeX | 数学排版不能靠图片 |
| 分词 | @xenova/transformers | 浏览器里跑 GPT-2 的 BPE,不用回服务端 |
| 推理 | onnxruntime-web 1.23 | 把 ONNX 模型跑在 WASM/WebGPU 上 |
| 托管 | GitHub Pages(adapter-static) | 纯静态,没有后端、没有 API Key |
模型本身是 GPT-2 Small 转成的 ONNX 文件。打开仓库会看到它被切成了 63 个分片,合计约 650MB——静态托管放单文件不现实,分片还能并行下载。
这里有个必须说清楚的取舍:“浏览器运行”不等于“零成本”。第一次打开要下几百 MB,推理要吃本地 CPU/GPU 和内存。项目选 GPT-2 Small 而不是更大的模型,正是因为这个成本必须留在“打开就能用”的范围内。
另外,界面要能展开到 Q、K、V 这一层,就意味着模型除了最终的概率,还得把中间张量一起交出来。这层开销是静态图不需要付的,也是这类工具真正的工程门槛:不是能不能跑模型,而是跑完之后能不能把中间结果低成本地送到渲染层。
九、教学设计:为什么它比博客和视频有效
论文的做法不是“我们做了个工具,用户很喜欢”,而是做了对照实验:90 名参与者,分成工具组和传统材料组(博客文章 + 视频),学同样的 Transformer 概念,然后做理解测验和主观评分。
结论是工具组在理解度和参与度上有统计显著优势。论文把有效的原因归到三个设计上:
① Token-centric flow-based visualization。 以 token 为中心画数据流,而不是以组件为中心画框图。好处是学习者始终知道“现在这个数是从哪来的、要去哪”。
② Multi-level explanation。 允许在整体架构和底层数学之间来回切换。只看公式会对不上结构,只看动画会不知道发生了什么运算,两层必须能互相跳。
③ Interactive experimentation。 改输入、改参数,看结果怎么变。这是它和交互式文章(explorable explanation)的分界线——文章的故事线是作者定的,工具的实验是用户定的。
还有一个容易被低估的设计:引导式学习卡片。对非专业用户来说,最大的门槛不是数学,是“不知道该点哪”。卡片把概念讲解和具体操作绑在一起,点一步、讲一步。
十、局限
按重要性排:
- GPT-2 不是现代 LLM。 它没有 RoPE、没有 GQA/MQA、没有 RMSNorm、没有 SwiGLU、没有 MoE、没有 KV Cache 的工程复杂度。用它建立的直觉,到 Llama 或 DeepSeek 那一代会有一半要重学。
- 注意力权重不是解释。 看到某个头关注某个词,不等于“模型因为这个才输出那个 token”。注意力是信息路由的一个快照,不是因果链。
- 只有前向,没有干预。 你能看,但不能改:不能把某个头的激活置零、不能替换某个位置的 residual stream、不能做 activation patching。观察和实验之间还差一层。
- 首屏成本。 650MB 的模型文件,弱网下体验会崩。这是“零安装”的代价。
- 结论的边界。 90 人、非专家、短期测验,能说明“入门教学有效”,不能说明“深度理解有效”。
十一、我的判断:从 Explainer 到 Intervention Studio
这个项目最值得学的不是某个可视化技巧,而是它的产品结构:
模型负责产生真实数值,界面负责解释数值,交互负责让人建立因果直觉。
三者必须在同一个进程里,缺一个就退化成动画。这也是为什么它非要在浏览器里跑模型——不是为了炫技,是为了让“解释”和“计算”共享同一份数据。
顺着这个结构往下推,还差一步:从“看”到“改”。
如果给它加一层干预能力,它会立刻从教学工具变成研究工具:
- Hidden state 探针:把 Layer 6 的 residual stream 投影到词表(logit lens),看预测是怎么一层层收敛的;
- Head 消融:点一下某个头把它置零,看输出概率怎么变——这比看注意力权重更能说明因果;
- Activation patching:把 A 句某个位置的激活换到 B 句,看哪个位置决定了输出。
这三件事在 PyTorch 里用 NNsight 或 pyvene 都只要几行,难的是把它做进浏览器、并且和现有可视化拼在一起。而这恰好是 Transformer Explainer 已经解决的那一半工程问题:模型在本地、中间张量能拿到、界面能实时更新。
所以我认为它更像一个平台雏形,而不是一个成品教学页。它的下一站不是“支持更多模型”,而是“支持对模型的干预”。前者是内容扩展,后者是能力升级。
顺带说一句,Polo Club 这条产品线本身也值得看:CNN Explainer、GAN Lab、Diffusion Explainer,加上这一个,四代模型、四种可视化范式。这套东西的方法论比单个工具更有价值。
项目与资料
本文数字来自论文、README 与仓库文件清单(模型分片大小按仓库实际文件累加)。界面截图未使用,配图为按论文与实现重绘的示意图;实际交互请以在线版为准。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- Blender Kiln:AI 建模缺的不是生成能力,是交付前的度量
- CineCode:每一帧都是时间的纯函数,所以电影可以被检查
- OhMyGame:AI 生成游戏不难,难的是让它自己发现游戏跑不起来
- GPT-2 的一次前向:一条 768 维的向量,被改写 12 次,变成 50257 个分数
- SAELens:重建得越准,特征越不一定是真的
- TokenEconomizer:Coding Agent 的成本按仓库累积,不按任务计价
- Boubou:本地语音 AI 缺的不是模型,是一层能借给全屋的运行时
- Hy-MT2:把翻译拆成语言家族分头训练,再蒸馏回一个模型
- NNsight:把干预写进前向传播,让同一段代码在 405B 模型上跑
- Safetensors:用 8 个字节和一段 JSON,重新设计大模型的权重文件