AI Filmmaking Camera Control:让模型只抄镜头,不抄人
137 个镜头模板。44 个从没发出去过。9 条主张标着「未证明」。
AI Filmmaking Camera Control 是 Sirio Berati(Tein AI)做的开源仓库:用 three.js 写一段摄影机运动,渲成灰色 3D 参考视频,再交给 Seedance 2.5,让它按这段参考生成真实画面。建库 2026-11-07,136 star、30 fork、MIT、TypeScript。
大多数人会把它当成「137 个运镜提示词合集」。它其实更像一本实验记录:每个模板带代码、参考视频、提示词、发送记录,发失败的写明为什么,没发过的写明理由。
而它真正讲清楚的一件事,比 137 个镜头重要得多:
参考视频里其实有两条通道——镜头怎么走,身体怎么动。模型两条都抄。所谓「运镜控制不准」,很多时候是这两条在它眼里没有分开。
整个项目就是围绕这一句话展开的:给它一条能抄的镜头,和一个没东西可抄的人。
一、两条通道
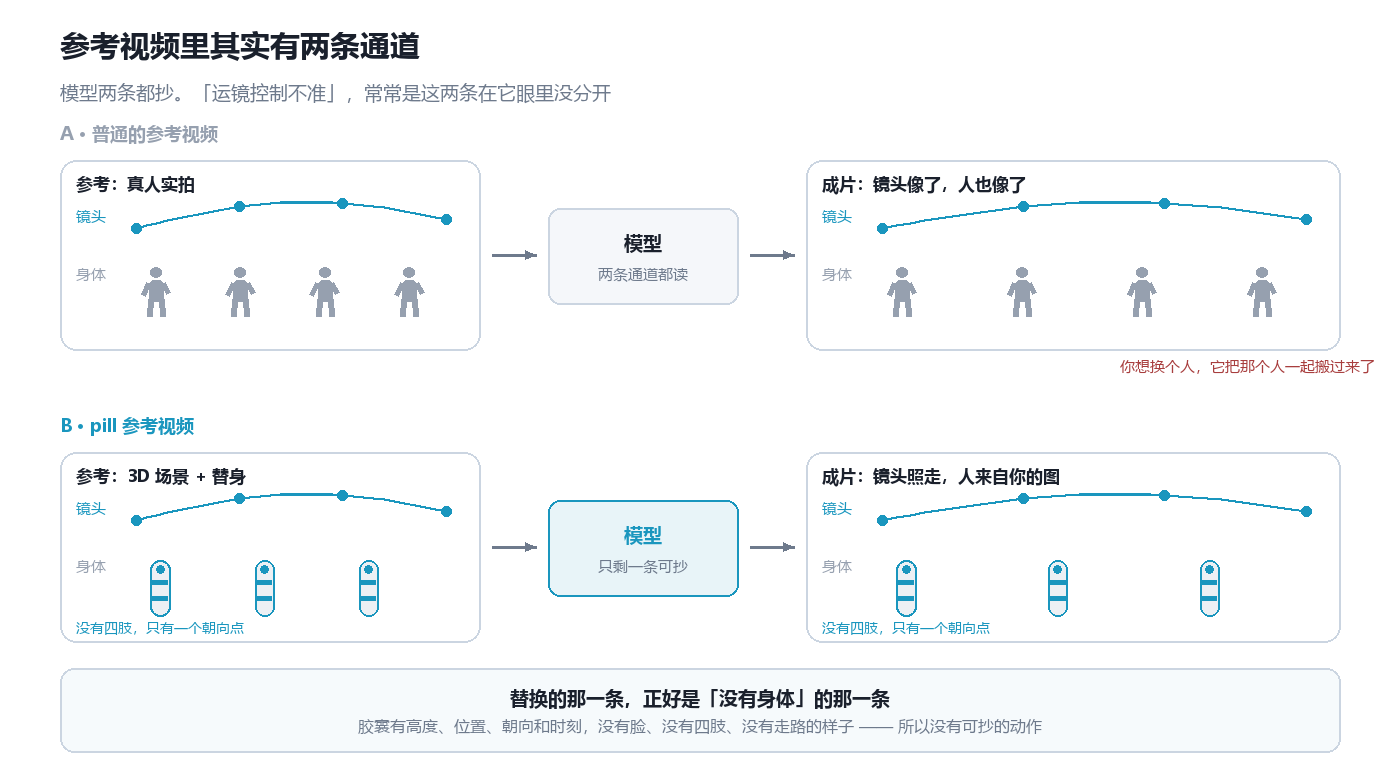
上:普通参考视频把「镜头」和「身体」一起递过去,模型两样都学。下:把身体换成胶囊,只剩镜头可抄。
这个观察可以推得很远。如果你拿一段真人实拍当参考,想要那个摇镜,模型会连那个人的走路姿势、体态、衣服一起搬过来——因为对它来说这都是「参考视频里发生了什么」,没有理由区分。
于是有了 pill(胶囊替身):
- 高度 = 那个人的高度;
- 位置 = 那个人站的位置;
- 朝向 = 一个白点,标出他面向哪边;
- 时刻 = 他在第几秒做了什么位移;
- 没有脸、没有四肢、没有走路的样子。
它保留了所有与「摄影机怎么运动」相关的信息,删掉了所有与「身体怎么动」相关的信息。
二、胶囊保住了什么,没保住什么
仓库里替身有两种:75 个片段用单个胶囊,62 个用 pin(一个头加一条细身体)。选哪种写在每个模板的 README 里。
这个设计有个直接后果,作者自己写得很清楚:胶囊没有手、腿和脚,所以这些只能由提示词给。换句话说,它不是「更好地控制动作」,而是主动放弃对动作的控制,换取对镜头的控制。
同一篇文档里还记了一条失败经验:石像类主体即使没有场景,也会被模型长成奇怪的替身形;模型还会自己发明招牌和文字。
三、确定性到哪里结束
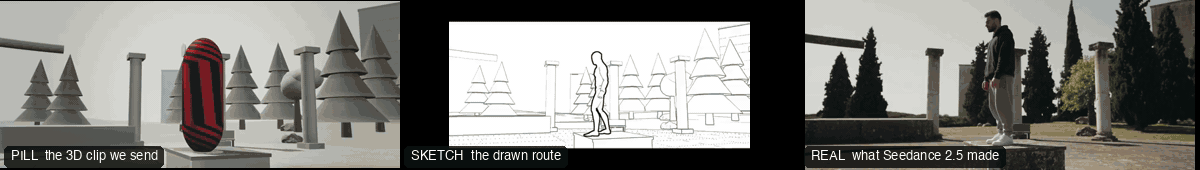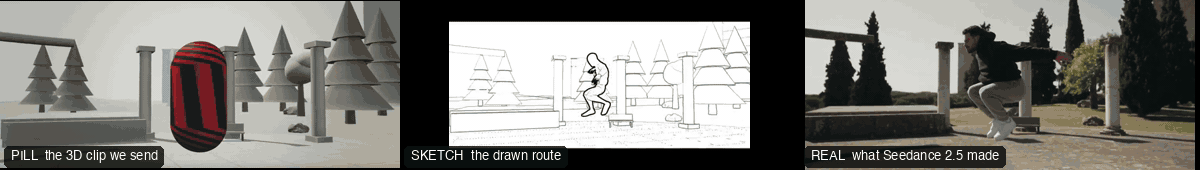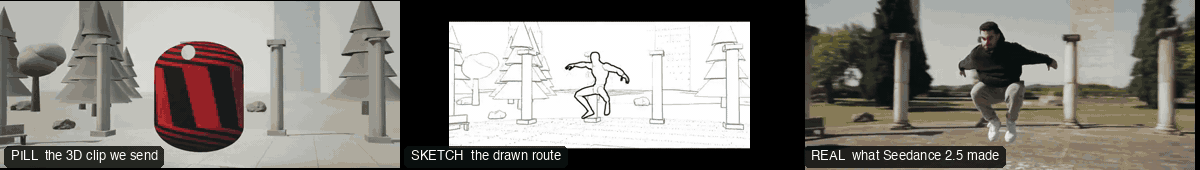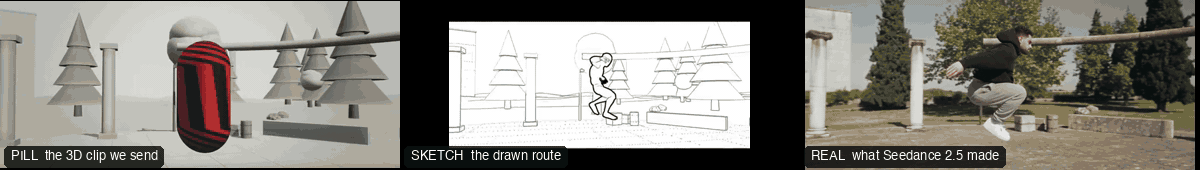
左:发出去的 pill 片段;中:同一运动画成的联系表;右:Seedance 2.5 照着它做出来的真实画面。图源:项目仓库(MIT)。
这张三联图基本把整个项目讲完了。左边那段灰色片段是代码渲的,中间是同一支镜头用几张手绘帧表达的廉价版本,右边是模型给的成片。
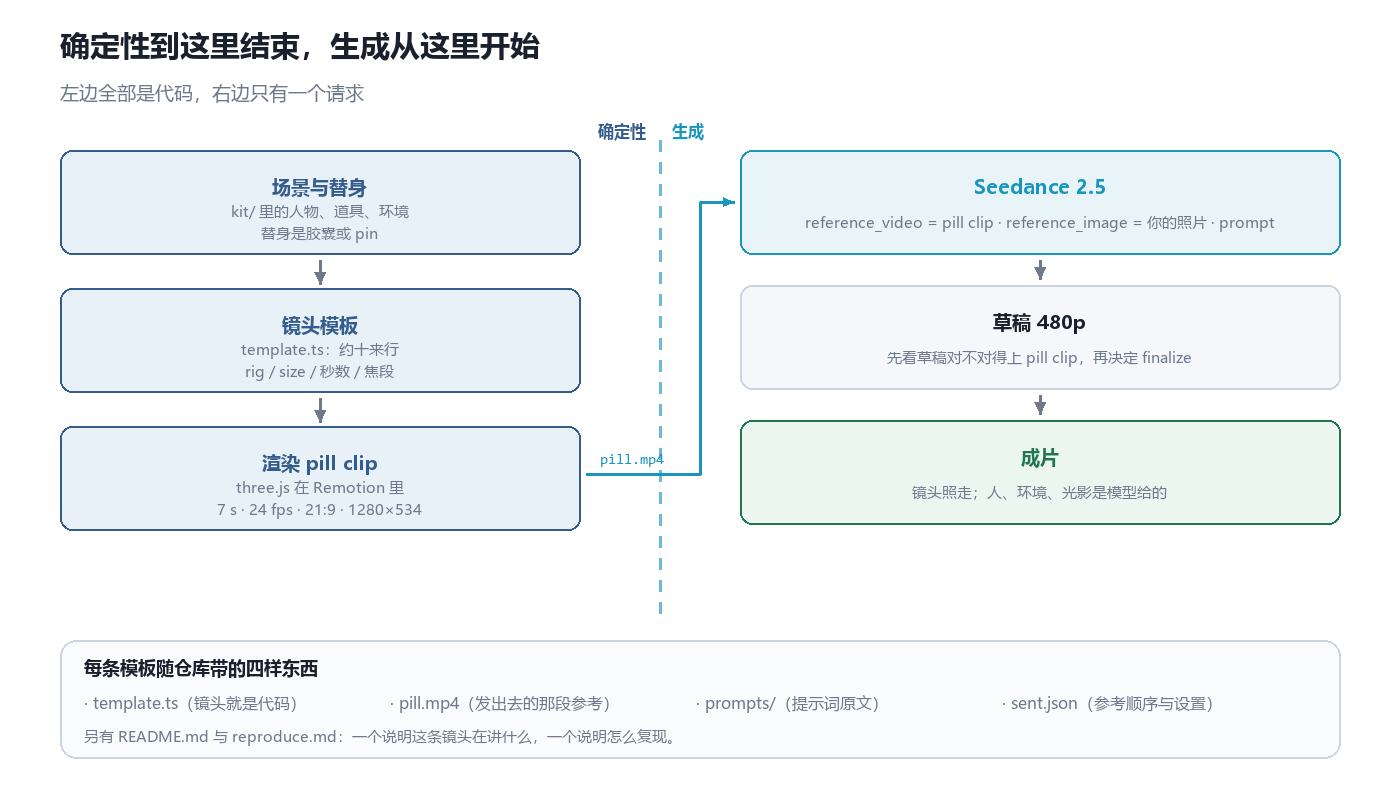
左边全部是代码,右边只有一个请求;中间那条虚线就是「确定性结束」的位置。
具体参数:pill clip 是 7 秒、24 fps、21:9,渲染出来 1280×534;仓库里的 pill.mp4 是给 gallery 用的缩小版(多数 960 宽),sent.json 记录真正发出去的是哪个尺寸。
代码这边轻得有点意外。一条模板大约十来行:
make(
  {
    id: "CAM06-Orbit",
    name: "Orbit",
    says: "Everything turns around this person: a standoff, a decision, a hero moment.",
    use: "A character at the centre of a turning point.",
    numbers: "35 mm, MS, 120° over 7 s (about 17°/s on average, peak near 58°/s), eased, no rise.",
    avoid: "Orbiting just for motion: it says this person is the axis of the scene.",
  },
  [ALEX([{ t: 0, at: [0, 0], yaw: 0 }])],
  (P) => [
    {
      start: 0,
      end: 7,
      label: "35mm  ORBIT 120",
      rig: "TECHNOCRANE ORBIT",
      subject: "ALEX",
      size: "MS",
      stop: 2.8,
      cam: rig.orbit(P("ALEX"), { size: "MS", mm: 35, rise: 0 }, 20, 140, 0, 7, 0.6),
    },
  ]
);
这是我在整个仓库里最喜欢的部分,下一节单独说。
四、两条路线:9 刀,还是 1 刀
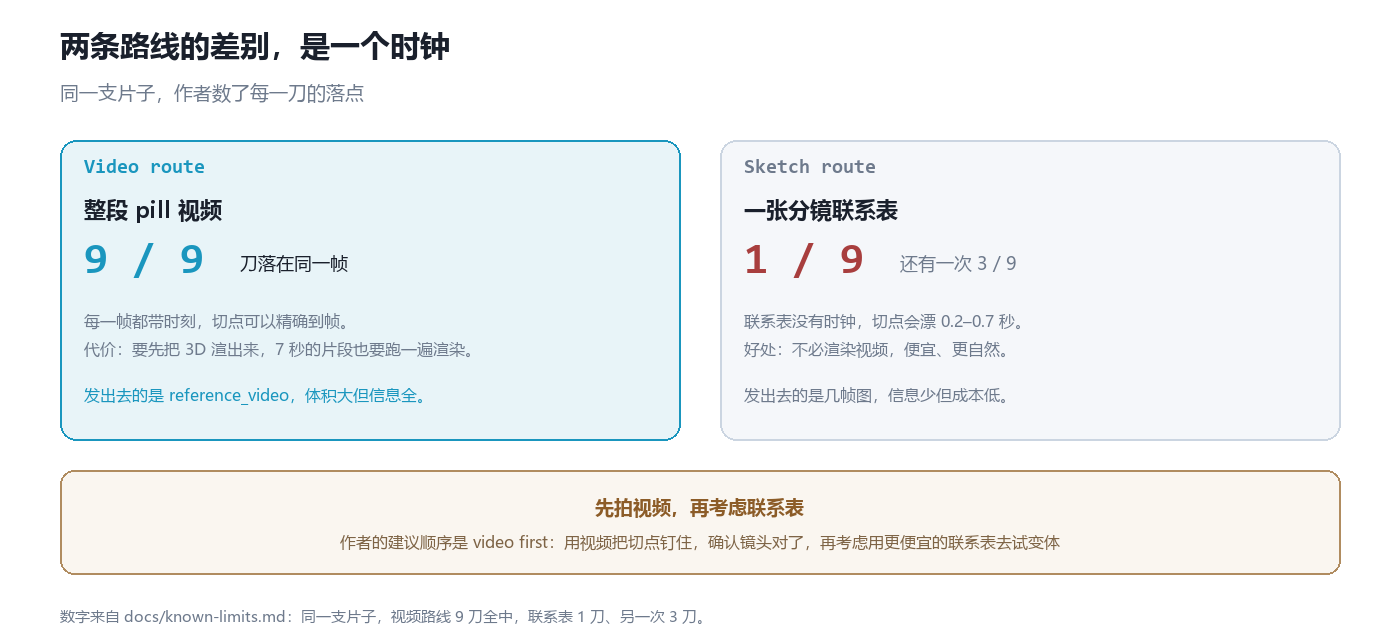
同一支片子,作者数了每一刀的落点:视频路线 9 刀全中,联系表 1 刀,另一次 3 刀。
除了发视频,还能发一张分镜联系表(把运动画成几帧图)。它更便宜、更自然,但没有时钟——所以切点会漂 0.2 到 0.7 秒。
作者在 docs/why/why-video-first-sheet-second.md 里的建议顺序是 video first:先用视频把切点钉住,确认镜头对了,再用更便宜的联系表去试变体。
便宜的价码也算清楚了:7 秒草稿,视频路线 1,021 credits,联系表 855;30 秒草稿,4,228 对 3,544。视频要按输入秒数加输出秒数计费,联系表只算输出。省下来约 16%,换的是切点精度。
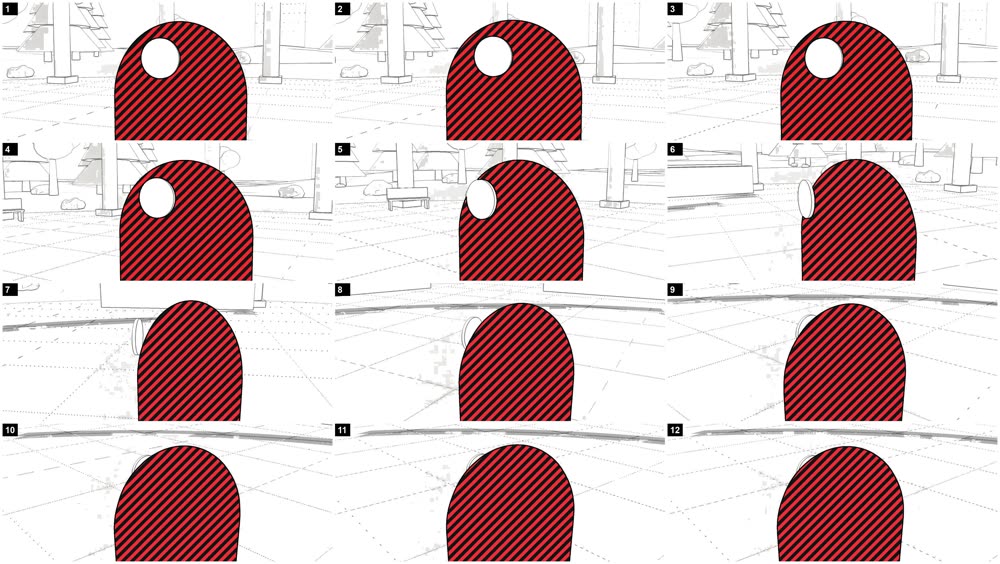
CAM06-Orbit 的 sketch route 实际发出去的联系表。图源:项目仓库(MIT)。
五、同一支镜头,十三种发法
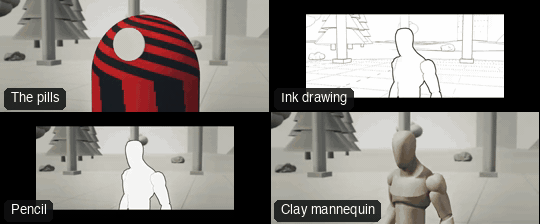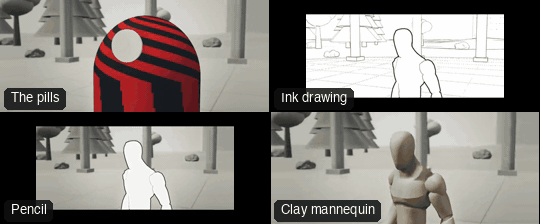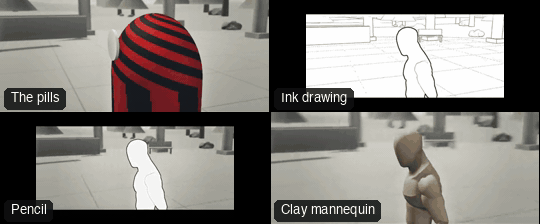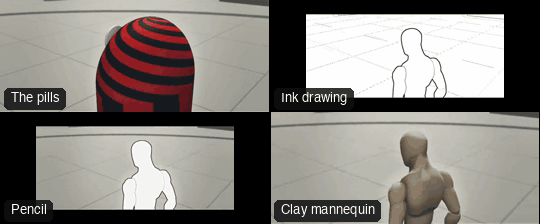
同一支环绕镜头,用六种方式递过去。图源:项目仓库(MIT)。
这一组实验比任何解释都有说服力:同一支镜头、多种输入、并排比较。docs/variants.md 里一共列了 13 种变体,其中 11 种真的发过,每一种都写明「保住了什么、漏掉了什么、什么时候能用、结论」:
- 泥人是最早的默认选项,被换掉的原因是连僵硬的肢体动作一起抄;
- 幽灵剪影一开始被认为是平衡点,pill 试验之后被否;
- 纯摄影机空板的运动最自然,但主体会落错位置——只在主体站位无所谓时能用;
- 墨线联系表分「带场景」和「不带场景」两版,带场景那版会把画出来的树当圆锥体;不带场景那版才是推荐的联系表路线。
但它也暴露了这套方法最尴尬的地方,我放到第七节说。
六、模板不是路径,是一句论述
回到那段 make()。除了摄影机参数,它还声明了四件事:
| 字段 | 回答的问题 |
|---|---|
says | 这个镜头在讲什么 |
use | 什么时候该用它 |
numbers | 焦段、景别、角度、时长、速度曲线 |
avoid | 什么情况下不该用它 |
CAM06-Orbit 的 avoid 写的是:「只为动而动地环绕:它会说这个人是场景的轴心。」——这不是技术参数,这是导演判断。
我认为这才是「可导演的单元」该有的样子:一条模板不只是「怎么动」,还包括「为什么动」和「什么时候别动」。137 条模板如果只有轨迹,那它是个素材库;带上这四个字段,它才像一本可以查的摄影语法。
七、它自己承认的边界
这是我愿意写这个项目的真正原因:docs/known-limits.md 是一张自我否定的清单。
方法做不到的:
| 限制 | 证据 |
|---|---|
| 联系表没有时钟,切点漂 0.2–0.7 秒 | 视频 9/9,联系表 1/9、3/9 |
| 打斗镜头会被版权过滤器拦 | ACT07 每次都拦,至今没有结果 |
| 参考视频总长必须小于 29 秒 | 早前的托管 API 拒过被判为 30.00 秒的片段 |
| 已有片段的真 4K 重制未证明;重跑一次就是新的一条 take | seedance-notes.md |
| 胶囊没有手腿脚,这些只能靠提示词 | why-limbs-never.md |
| 模型可能把一句台词说两遍、漏字,还会提前 1–2 秒开口 | prompt-anatomy.md |
| 声音像不像、口型对不对,需要人来听 | 检查只测嘴部运动,不测同步 |
仓库里到底有多少真东西:
- 137 个模板里,93 个有提示词(238 个文件),另外 44 个从没发过,理由写在各自的
sent.json里; - 32 个属于 ANG 系列(固定机位),作者的结论是「草稿发硬,不推荐当模板发」;
- 45 个没有结果视频(44 个加上被版权过滤器拦住的 ACT07),92 个至少有一条结果;
- 45 个模板里的 51 次发送,
pill.mp4不是当时发出去的那个文件,而是事后重渲的,sent.json的provenance字段会标注; - 运动检查在 2026-11-07 跑过全部 137 个:127 个干净,10 个带备注(穿模、陷地、滑步);其中 4 个是已经发过的;
- 作者自己的跑批里,54 个模板有 53 个通过,30 秒的片子上 9 刀全中——但这批数据没随仓库发布,属于「作者称」;
- 文档之间也不完全一致:切点漂移
known-limits.md写 0.2–0.7 秒,variants.md写 0.2–0.8 秒。
还有 9 条「未证明」,包括整套方法的中心命题:
「应用自带的预设无法精确保持运动和切点」——未证明。要证明它,得把同一支环绕镜头分别发给预设和 pill 路线,然后量两条摄影机轨迹。
写文章的人容易把这个当成既定事实。作者把它列在 UNPROVEN 表里,并写清要做什么实验才能了结它。这一点比 137 个模板更值得抄。
八、许可与利益关系
- 代码、提示词、笔记和 pill 片段:MIT;rig 是 Quaternius 的 CC0;
- Remotion 有自己的许可:个人和小公司免费,大型营利团队要买商业许可——想在公司里用,先读
NOTICE.md,它还覆盖摄影机预设、示例里的人脸和产品镜头里的品牌标识; - 作者是 Tein AI 的人,而 Tein 正是托管 Seedance 2.5、按次收费的那家;README 没有藏着这件事,
homepage直接指向 tein.ai,仓库也明确写「本仓库不存任何 key,也不会自己发起或花费任何请求」。
这不算问题,但它决定了你怎么读这个项目:它是自家服务的一份高质量使用示例,也是自家 gallery 的来源。
九、我的判断
如果只从这个仓库里拿三样东西:
第一样:把参考信号拆成「可抄」和「不可抄」两部分。这是全文最有迁移价值的一招。任何用参考图/参考视频引导生成的系统,都可以问一句:这条参考里,我到底希望模型学哪一部分?剩下的那部分能不能物理地删掉,而不是靠提示词去劝?
第二样:模板要带「什么时候别用」。avoid 字段比 numbers 更稀缺。素材库给你一百种运动,语法书告诉你哪一种会毁掉这场戏。
第三样:把未证明的写下来。UNPROVEN 表是这个仓库最不像营销材料的部分,也是它最可信的部分。
我也有一点保留。这套方法的成本结构是「先渲一遍 3D,再让模型生成」,对单条镜头是值得的,对一次要出五十条的批产未必;而且它的精度上限被参考视频的 29 秒限制和多条「未证明」卡着。它更像一间把方法论摊开给你看的实验室,而不是一个可以闭眼接入的生产线。
这和我最近拆的几个项目其实是同一个动作:先问「这条信号里哪一部分是我想传递的」,再决定用什么形式去传。Hypit 把时间轴拆成词的投影,麦田把易碎的平台适配拆进插件,这里把参考视频拆成镜头和身体。拆法不同,问题同一个。
项目与资料
- 仓库:sirioberati/ai-filmmaking-camera-control-seedance-2-5(MIT)
- 已知边界:docs/known-limits.md
- 137 条模板索引:templates/INDEX.md
- 方法总览:docs/idea.md
- 模型服务:Tein AI
数据来源:star / fork / 建库时间取自 GitHub REST API(2026-11-19);模板数、发过的数量、切点计数、时长限制与许可条款取自仓库 README 与 docs/known-limits.md;template.ts 代码片段为原文摘录,仅做了折行排版,未改字段。文中的 GIF 与联系表来自仓库 docs/assets/ 与 templates/CAM06-Orbit/,按 MIT 转载并已标注来源。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- Cheetah:常驻内存不该由模型大小决定
- 认知博弈:形式化、求解与可辨识性综述
- 麦田(Maitian):平台改版那天,不该让每个用户升级一次
- The Software Engineering Handbook:把工程判断写成一份自由度账本
- Hypit:你编辑的是词,秒是编译出来的
- Omni LoRA:一个 671 MB 的修正,要背两个任务
- Omni-Quantized:12 个构建,两套布局,省的是显存不是时间
- video-shotcraft:150 个镜头名,就是 Agent 的接口
- Jina-OCR-v1:赢在少写,不在写快
- MNN-Pocket-0.3B:不是把大模型缩小,是从两个预算反推形状