Mainline:工程判断该住在 Git 里,不该住在数据库里
0。
这是 Mainline 要求你额外部署的服务数量。没有数据库,没有向量库,没有同步服务,没有常驻进程。整个系统就是一个 Go 二进制(release 包 13 MB),因为它的存储层不是自己写的——是 Git 的 ref 命名空间。
仓库是 mainline-org/mainline,2026-04-25 建库,205 star、15 fork、3 个 open issue,Go 1.22+,最新版本 v0.5.1(2026-07-27)。官方自我定位是 Git-native memory for coding agents,状态写得很老实:public alpha。
市面上绝大多数 “Agent Memory” 都在同一个方向上竞争:谁的检索更准、谁的摘要更好、谁的图更复杂。Mainline 换了一个赌注——它不改进记忆的内容,它改记忆的宿主。
本文只讲一件事:把记忆塞进 Git,究竟换来了什么,又付出了什么代价。
一、Git 记的是 what,缺的是 why
README 里那个例子很好,因为它足够具体。
团队试过用 Redis 队列处理支付事件,后来发现主从复制延迟会导致重复扣款,于是放弃,改用数据库事务加幂等。那个 redis.go 不会被删干净——它留着半成品和几个 TODO,docker-compose 里还挂着一个 redis 服务。
六个月后另一个 Agent 接手,grep 到这里,看到的全是“这项迁移还没做完”的信号。它很可能把活干完。
代码本身没有说谎,它只是只保留了残余状态,不保留决策状态。
这件事用一张表说更清楚。同样是“记录工程知识”,五种宿主的表达能力完全不在一个量级:
| 宿主 | 能表达 | 表达不了 |
|---|---|---|
| commit message | 一句话结论 | 被否掉的方案 |
| PR 描述 | 评审期的完整论证 | 合并之后就散了 |
AGENTS.md | 长期生效的规则 | 第 3 次改主意之后的状态 |
| 会话记忆 | 逐字的推理过程 | 下一个人读不到,也检索不到 |
| issue 系统 | 任务状态与讨论 | 这段逻辑落在哪一行提交上 |
这五种东西有一个共同点:它们都是文档。文档只能追加,不能回答一个反向的问题——这个提交,有没有人解释过它为什么存在?
Mainline 的答案是把这件事变成可计算的对象。
二、它存的是决策的形状,不是对话
先把边界划清楚,因为“记忆”这个词太容易膨胀。Intent Record Spec 明确列了四条非目标:不做 AI 的行级归属、不抓会话转录、不做 token/成本统计、不做项目管理。
它存的是一份 IntentSummary:
| 字段 | 内容 |
|---|---|
goal | 用户的原始目标,尽量逐字保留 |
what / why | 改了什么,以及为什么改 |
decisions[] | 每个决策点:选了什么、理由、被否掉的备选 |
fingerprint | 动到的子系统、文件、标签、API 与数据模型变更 |
references[] | 指向 issue/PR/CI/session 的链接(只存元数据,从不抓取内容) |
code_commit / code_tree | 封存时的 HEAD 与该提交的树 hash |
decisions[].rejected 是整份 schema 里最关键的一个字段。被否掉的方案才是代码里看不见的东西,而它恰恰是未来 Agent 最需要、又最不可能自己推出来的信息。
一个细节能说明这套 schema 的成熟度:IntentSummary 里还留着 risks、followups、anti_patterns 三个字段,但注释写得很清楚——历史只读,新封存必须留空,真正的信号走专门的事件。它们把“写进摘要”和“成为规则”拆成了两件事,第七节会讲为什么这个拆分是被一次真实事故逼出来的。
三、两个命名空间,两种语义
看存储布局,Mainline 的设计意图就露出来了。
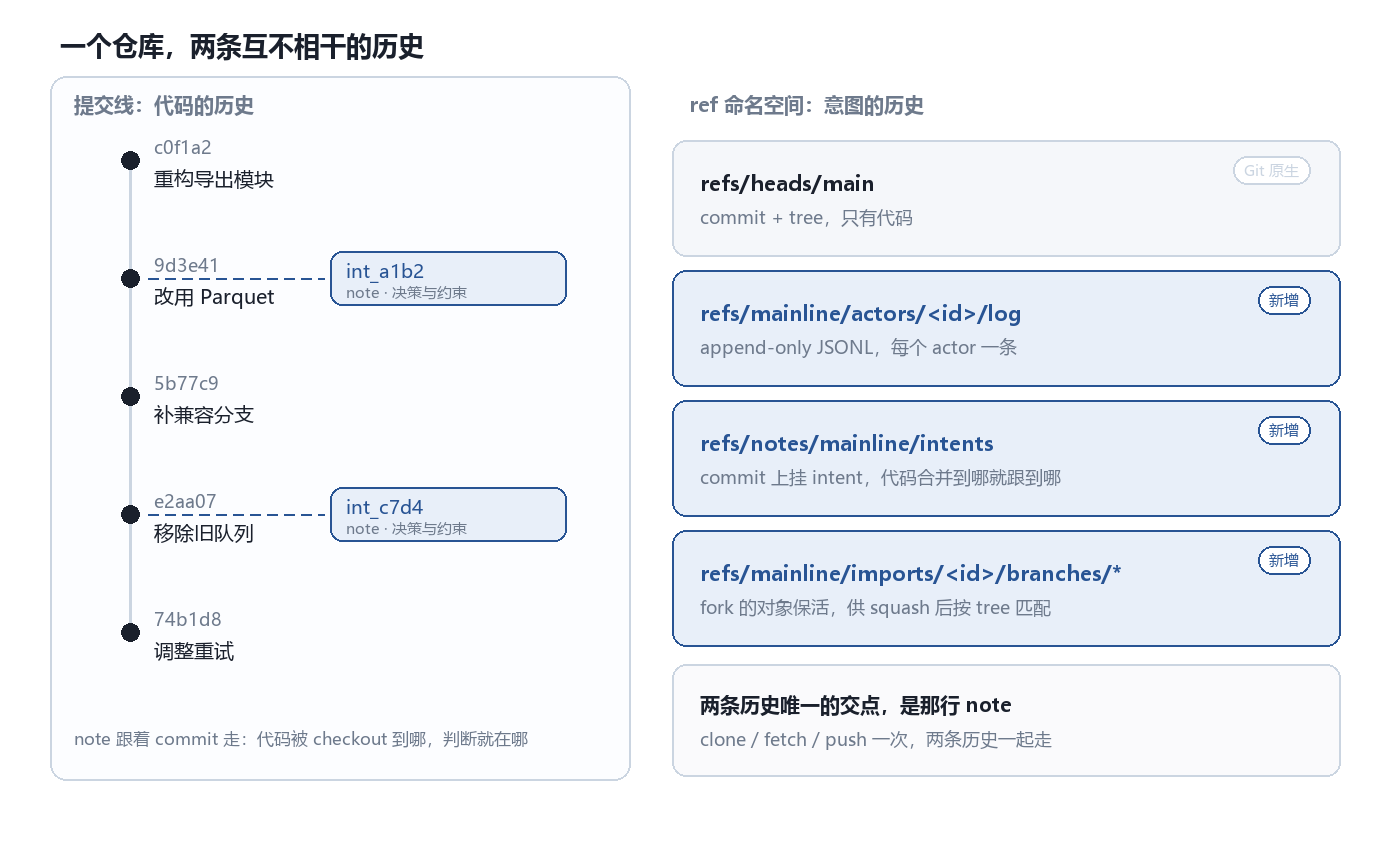
note 是唯一的交点:代码 checkout 到哪,判断就跟到哪;而事件流自己走自己的历史。
refs/heads/main                          # 代码
refs/mainline/actors/<actor_id>/log      # 意图事件流,append-only JSONL
refs/notes/mainline/intents              # commit → intent 的挂载点
refs/mainline/imports/<actor>/branches/* # fork 的对象保活
两种机制承担两种完全不同的语义,这是全文最该被记住的一处分工:
refs 走“时间”。每个 actor 一条追加式的 JSON-lines 日志,事件类型、时间戳、actor、payload。它有自己的历史线,和代码的提交图没有关系——这很重要,因为这意味着意图记录不需要为了写一行日志去制造一个提交。
notes 走“位置”。它把意图钉在具体 commit 上。代码合并到哪,判断就跟到哪,git checkout 到哪个分支,那一段历史里的意图就在手边。
从实现上推断(官方没有明说),按 actor 分片还有一个免费的好处:并行 Agent 不争同一个 ref。三个 Agent 同时工作,写的是三个不同的命名空间,追加互不干扰,不需要锁,也不需要中心化的写入序列。这是 Git 的对象模型白送的一致性。
代价也很直接:一个 actor 只写自己那条 ref,所以“团队共享一条记忆流”这件事必须靠 fetch 与 merge 来做,而不能靠一个自增 ID。
四、事件流在 Git 里,视图在本地
第二个设计选择更反直觉:Git 里存的是事件,不是状态。
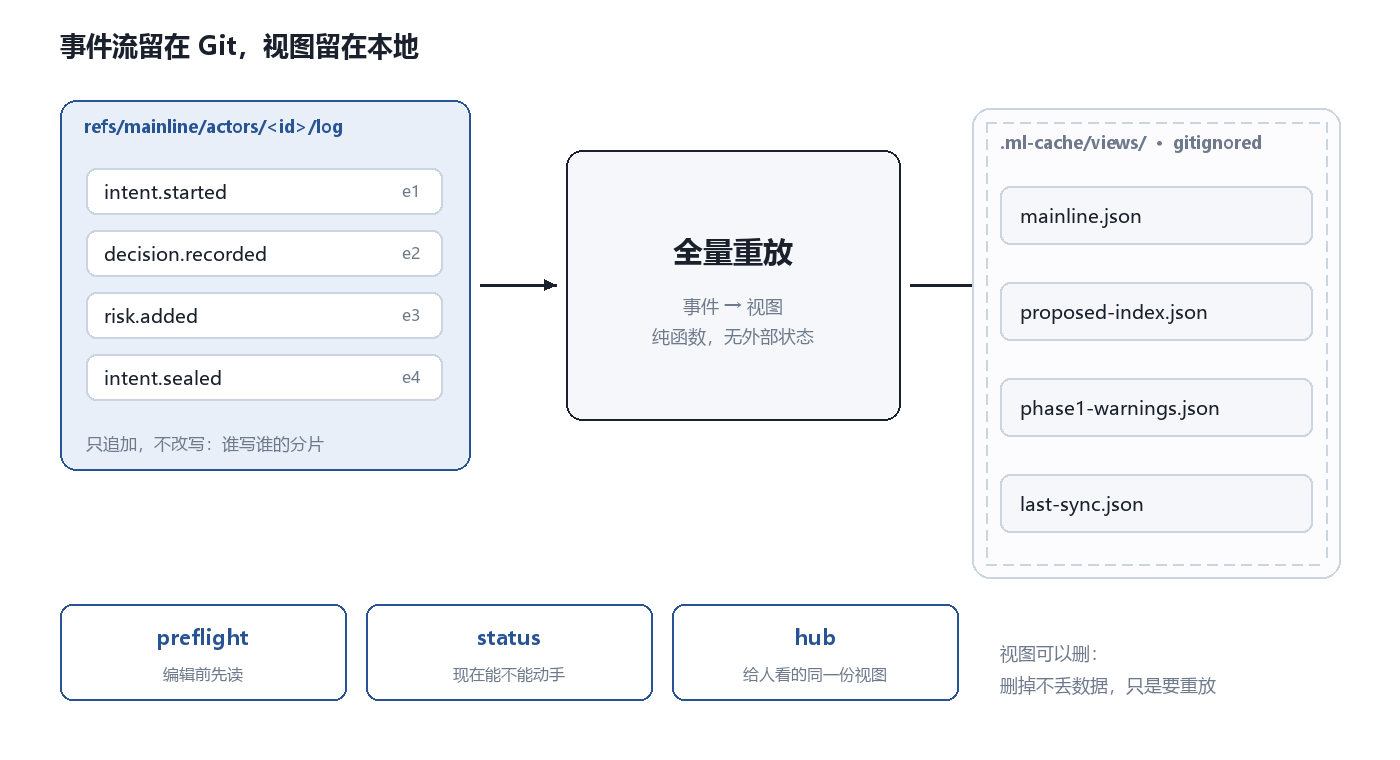
.mainline/config.toml 提交进仓库,.ml-cache/views/*.json 被忽略——可重建的东西不进 Git。
.mainline/
  config.toml      # 团队配置,提交
  local.toml       # 每个 actor 的身份,gitignore
.ml-cache/         # 本地缓存,gitignore
  views/mainline.json
  views/proposed-index.json
  views/phase1-warnings.json
  views/last-sync.json
封存一份 intent,写的是事件;要看“现在有哪些 intent、哪些冲突、哪些缺口”,则是把全部事件重放一遍,投影成一棵视图。官方把这套重放逻辑放在 engine 里,并且用 property-based test 锁住了它的确定性:同一条事件流重放两次结果必须一致,状态迁移必须幂等,pin 级联的优先级必须固定。
这套形态我一般叫 CQRS——写侧只追加,读侧重新投影,投影可丢弃。但这里有意思的地方不是命名,而是投影为什么必须放在本地:视图一旦提交进 Git,它就会成为又一个会产生合并冲突的文件,而且每次写入都要跨 actor 协调。把它放在 .ml-cache/ 里,删掉不丢数据,只是要重放一遍。
“可重建的东西不要进版本控制”——这条老规矩在这里被用来解决一个很新的问题。
五、pin:squash 之后,意图靠什么找回代码
这是全篇技术含量最高的一段,也是我建议所有做 Agent 记忆系统的人仔细看的地方。
代码合进 main 的方式,绝大多数是 squash merge。squash 会把分支上的一串提交压成一个,换掉 commit hash,也换掉父提交。于是“封存时记下的 code_commit”在合并之后就不存在了。
那意图怎么知道自己对应哪个提交?
Mainline 用的是一套三级级联,顺序固定:
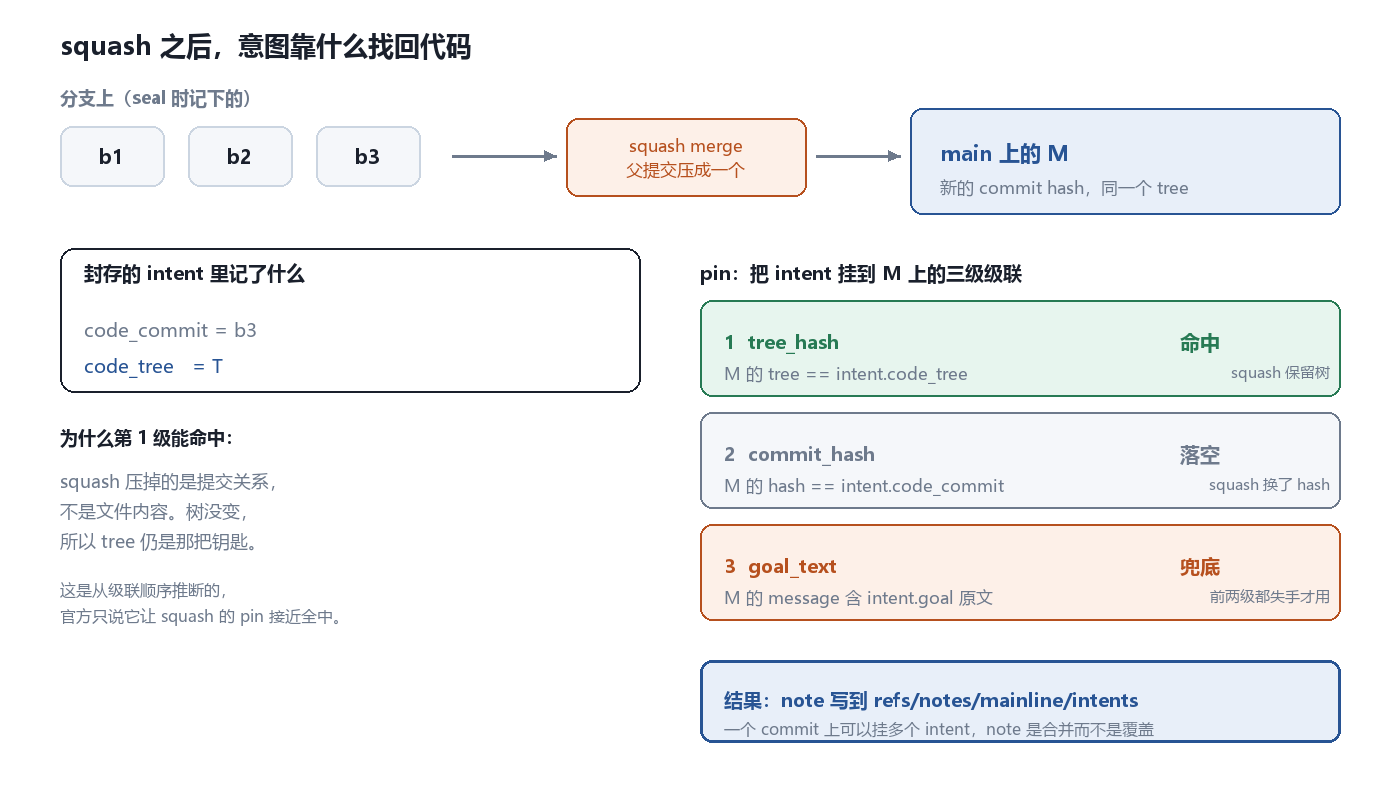
第 1 级能命中,是因为 squash 压掉的是提交关系,不是文件内容。
-
tree_hash:合并后提交的树 hash,等于 intent 里记的code_tree; -
commit_hash:提交 hash,等于code_commit(fast-forward 或 rebase 保留提交时有效); -
goal_text:提交信息里逐字包含 intent 的goal。
官方说这套级联让 squash 合并的自动 pin 接近全中。为什么第 1 级能中,是我从顺序推断的:树的 hash 只由目录内容决定,squash 保留内容、只丢弃提交关系,所以树没变,那把钥匙还在。这也解释了为什么 code_tree 是必填字段——它不是装饰,它是 join key。
fork 场景暴露了这套设计的边界。上游仓库要按 tree 匹配,就必须让 fork 的那个树对象在上游可达,否则对象根本不在库里。所以 mainline actor import 除了接受对方的 actor 日志,还会尽力把 fork 分支抓进 refs/mainline/imports/<actor>/branches/* 这种隐藏 ref 里保活。
这一段很能说明“Git 原生”的真实成本:你想复用 Git 的合并语义,就得连它的对象可达性规则一起接受。换成数据库,这是一行 join;换成 Git,这是两类 ref 加一套信任边界。
六、覆盖率:把“没有记录”变成一等公民
这是 Mainline 与普通知识库最本质的分岔。
知识库是“我知道什么”的集合。它永远不知道自己的空白在哪里——你没法查询一个不存在的东西。
Mainline 把 main 上的每个提交强制归入三种状态之一:
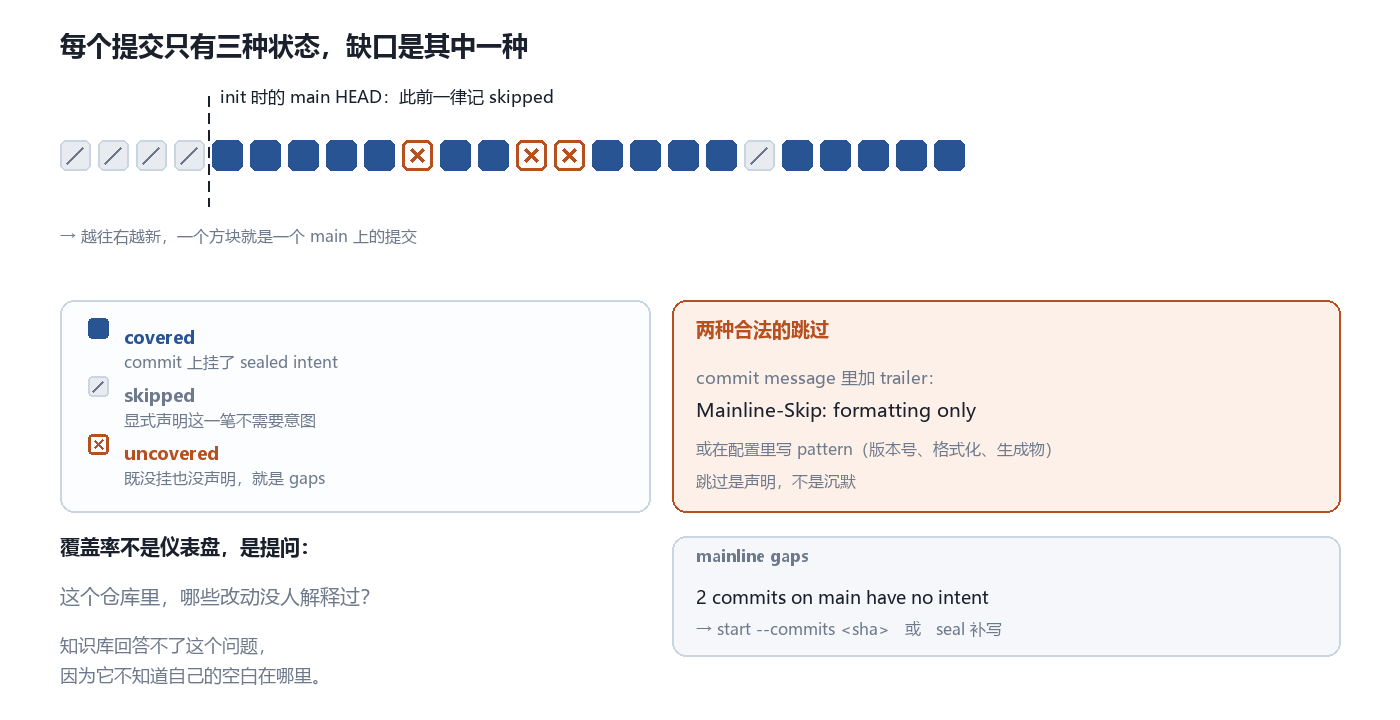
跳过是声明,不是沉默:Mainline-Skip: trailer 或配置里的路径 pattern 都算合法豁免。
| 状态 | 含义 |
|---|---|
| covered | 该提交上挂了 sealed intent |
| skipped | 显式声明这一笔不需要意图(格式化、版本号、生成物) |
| uncovered | 既没挂也没声明——这是一个缺口 |
mainline gaps 就是列出第三类。接入已有仓库时,init 会把当时的 main HEAD 记为基线,该提交及之前的提交统一算作 pre-Mainline 历史(skipped),之后的提交必须正常覆盖。
这个模型的价值不在报表,而在它把“沉默”和“声明”区分开了。一个团队说“格式化提交不用写意图”,这是策略;一个团队只是懒得写,这是缺口。两者在代码里长得一模一样,只有覆盖率模型能分开。
这也是我为这篇文章选“Git 原生”而不是“Agent 记忆”做主题的原因:覆盖率这个概念只有在提交是单位的时候才成立。换成“会话”做单位,你根本定义不出什么叫“没被记录”。
七、治理:谁有资格写规则
如果说 pin 级联是技术上的巧思,这一节是制度上的巧思,而且它是被一次真实事故逼出来的。
Mainline 把长期信号分成了不同的物种,生命周期和检索行为都不一样:
| 类型 | 性质 | 生命周期 | 会被继承吗 | 检索时会截断吗 |
|---|---|---|---|---|
| Risk | 评审时的提醒 | open → resolved / expired | 否 | 会(每个 intent 取 top-N) |
| Constraint | 人确认过的硬规则 | 长期,直到显式修改 | 是 | 永不截断 |
| 继承约束 | 因文件重叠自动适用 | 同上 | 是(本身就是传播) | 永不截断 |
| Conflict | 检出的重叠 | 按对存在 | — | — |
| Coverage gap | 缺失的意图 | 直到被覆盖或豁免 | — | — |
关键在于最后两列:约束永不截断,风险会。规范自己举的例子就属于约束——不要删 /oauth 上的旧 session 中间件,因为 OAuth 回调在重定向期间仍然依赖 session 状态。这类东西一定会出现在 Agent 编辑之前的上下文里;风险则是提醒,不是法律。
而这两种东西的写入者不同:
-
mainline guard add是交互式命令,由人确认才能产生约束; -
mainline risks add/followups add是结构化事件,可以由 Agent 提出; - 封存(
seal)不能生产规则。
最新 schema 明确写着:risks、anti_patterns、followups 是历史只读字段,新封存必须留空。
为什么?官方评测文档里留了案底。早期设计允许 Agent 在 seal 时写 anti_patterns,结果形成了一条污染链:Agent 自己的封存措辞,变成了未来 Agent 必须遵守的硬规则。一个 fixture 因此长期失败,修复方式不是改检索,而是把“写规则”的权限从 Agent 手里收回去。
我认为这是整个项目里最值得抄的一段判断。绝大多数“Agent 记忆”系统默认把 LLM 写下的东西当成事实沉淀下来,于是记忆库越用越脏,而且脏得无法追溯——因为污染源是模型自己。Mainline 的解法不是更好的摘要,是权限分层:过程记录 Agent 可以写,规则必须人确认。
八、协作:三个 Agent,和一次 preflight
意图冲突检测是 Mainline 相对独特的能力,但它的粒度比宣传语要细。
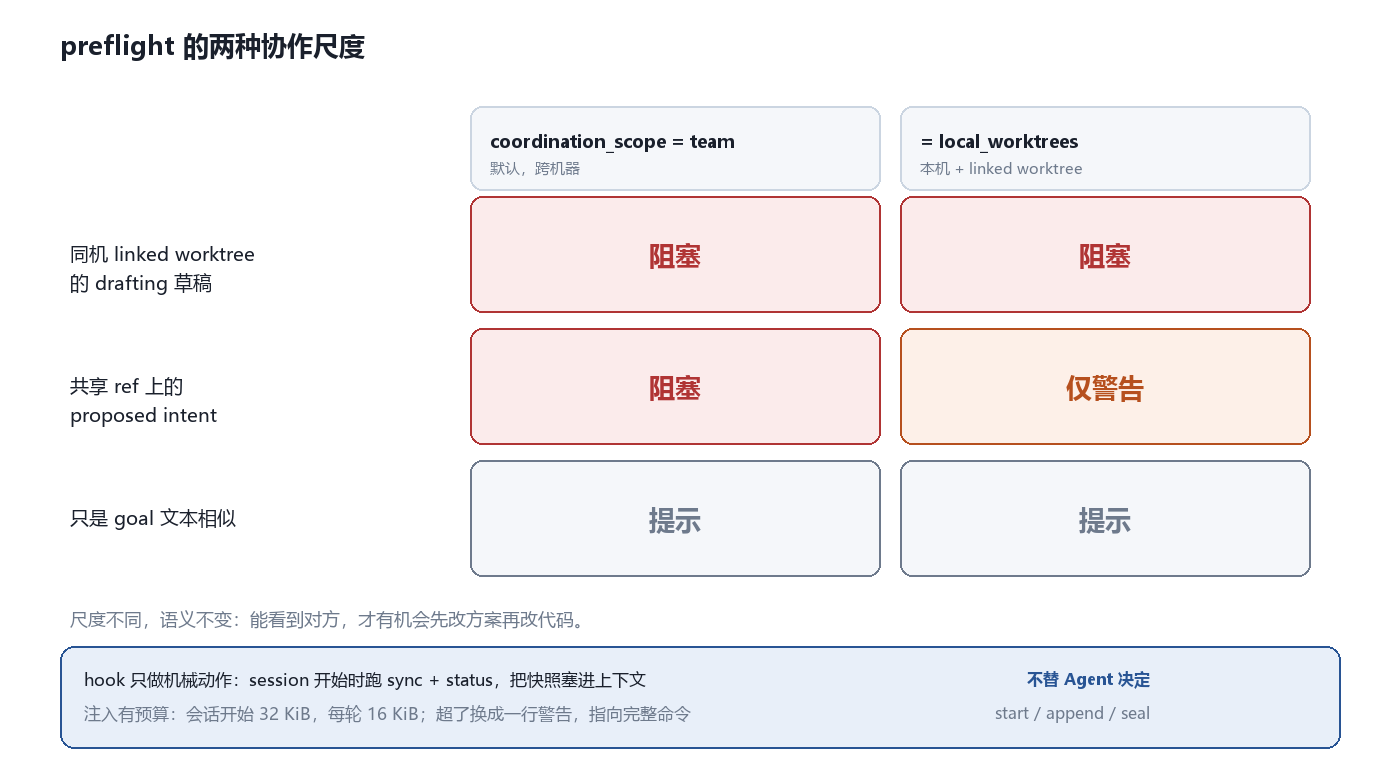
同一份预检,team 和 local_worktrees 两种尺度给出的答案不同,但“先看到对方”这件事不变。
一个 intent 有七种状态,单向流转:
drafting → sealed_local → proposed → merged
                                  ↘ abandoned
                                  ↘ superseded
                                  ↘ reverted
drafting 是未发布的,只在本地——准确地说,只在当前 clone 内。但 status 和 preflight 会扫描同一台机器上的 linked worktree,把兄弟草稿的摘要和部分指纹摸出来。这解决了一个非常具体的问题:一个开发者在两个 worktree 里并行跑两个 Agent,两边动的可能是同一个文件。
于是 preflight 的阻塞语义取决于协作尺度(写进 .mainline/config.toml 或 clone 本地的 git config):
| 情形 | team(默认) | local_worktrees |
|---|---|---|
| 同机 worktree 的 drafting 草稿,文件重叠 | 阻塞 | 阻塞 |
| 共享 ref 上的 proposed intent,文件重叠 | 阻塞 | 仅警告 |
| 只是 goal 文本相似 | 提示 | 提示 |
另一处细节是 72 小时规则:一个草稿如果 72 小时没有新的 turn 更新,它对本地编辑的占用会从阻塞降级为警告。没有人希望一个废弃的草稿永久卡住仓库。 另外 preflight 每次对每个重叠最多展开 8 个 matched_files,但计数与阻塞判断仍用全量路径——这是为了控制注入上下文的大小,不是为了少报。
至于 hook,它的职责被刻意压到最小:会话开始时跑 mainline sync 和 mainline status,把快照塞进上下文,然后就结束。它不决定什么时候 start、什么时候 append、什么时候 seal。0.5.1 还给它加了预算:会话开始 32 KiB,每轮 16 KiB,超了换成一行警告,指向完整命令。
机械的部分交给 hook,语义的部分留给人——这个分工和“全自动记忆”的流行叙事正好相反。
还有一份恢复规则,读起来像飞行检查单:工作区脏了而脏文件不明确属于当前任务,停下来问;sync 过期或分支漂移,先同步再封存;封存解析失败,修结果再提交;冲突警告,要么上报要么找人判断。默认动作是停,不是继续。
九、评测:9 比 0,以及它没证明的东西
官方公布的是一个受控实验:8 个合成 fixture,3 个种子,2 种模式。
| 模式 | Forbidden-list violations | 一致性 |
|---|---|---|
| Intent-first | 0 | 0/8 fixture 失败 |
| Code-first | 9 | 2/8 fixture 稳定失败 |
9 这个数字能对上账:superseded-decision 每个种子违反 2 条禁止项(给 CSV 加列 + 继续用旧 CSV 格式),abandoned-approach 每个种子违反 1 条,3 个种子 × 3 条 = 9。
但比这组数字更有价值的是它没证明什么,官方自己列了五条:
- 这是第一个受控实验,不是公开基准;
- 8 个场景全是人工构造的,不是从真实仓库采样;
- 用的是单一模型(live 层是 Claude Sonnet 4),只有 3 个种子;
- 一部分结果是预计算响应的重放,温度不是 0 的真实方差没测到;
- 打分依赖 LLM 当裁判,
docs-only-intent那一条只有 72% 置信度。
而且有一处细节特别值得记下来:在 live 那轮里,docs-only-intent 的 Code-first 没有犯错——Sonnet 4 去翻了 CLI help text,从代码里找到了那个术语约定。于是优势范围被收窄成一句话:
只有在代码里根本没有信号的地方,意图才起作用。
剩下的两类场景,正好是代码最会骗人的两类:
- 被放弃的路线:半成品实现 +
docker-compose里的 redis 服务 = 无法抵抗的“把活干完”信号; - 被取代的决策:CSV 和 Parquet 两个端点都活着,CSV 上写着 deprecated 但仍有流量 = 自然的“两边都加一列”。
文档里有一句判断我很认同:这两种失败是结构性必然的,不是提示词工程能修的——因为代码呈现的是残留状态,而不是决策状态。
十、局限
按重要性排,这些是我认为真正会挡住你上生产的东西:
- public alpha,schema 会变。Intent Record Spec 自己标着
v0.1-draft · Not a standard,明写“会有破坏性变更”。跨版本升级要读 CHANGELOG 的 migration notes。 - hook 只覆盖四个运行时。Cursor、Codex、Claude Code、Pi 有仓库级 hook;Copilot 能读同一份仓库事实,但没有 hook,只能靠 skill + CLI 手动走。README 里那句“支持 Copilot”说的是数据可读,不是自动注入——这两件事差别很大。
- Windows 没有一键脚本。安装脚本只支持 macOS / Linux 的 amd64/arm64,Windows 得去 Releases 下 zip。
-
sync不是自动的。它要手动跑,或者靠 hook 在会话开始时触发。纯 CLI 用户会忘记同步,然后看到过期的视图。 - 记忆质量完全取决于封存质量。
mainline lint只是 advisory 的提示,不阻断。一个写满 “implemented changes” 的what字段,会让整套系统退化成一个更复杂的 todo。 - 许可证是分层的,不是单纯的开源。CLI、skills、SDK、协议规范是 Apache-2.0;文档是 CC-BY-4.0;托管服务、GitHub App、团队面板是商业条款;名字和商标保留。GitHub 上显示
NOASSERTION,就是因为没有一个 SPDX 能描述这种组合。
十一、自己跑一遍
安装是一行脚本,但在 Windows 上得去 Releases 下 zip(脚本只覆盖 macOS / Linux 的 amd64 与 arm64):
curl -fsSL https://raw.githubusercontent.com/mainline-org/mainline/main/install.sh | bash
mainline version

cd your-repo
mainline init --actor-name "alice"
mainline doctor --setup
init 会写 .mainline/config.toml、配置 refspec、装 skill、为支持的 Agent 装仓库级 hook,并把当前 main HEAD 记成覆盖基线。doctor --setup 是仓库级的接线检查——它必须在 Git 仓库里跑,这个区别官方在 0.5.0 里专门修过文案。
之后真正高频的四条命令都是 Agent 跑的:
mainline preflight --json
mainline start "clean up old export logic" --json
mainline append "confirmed the legacy CSV route is still used for overnight reconciliation" --json
mainline seal --prepare --json > .ml-cache/seal.json
mainline seal --submit --json < .ml-cache/seal.json
人只需要读:status --actionable 看现在能不能动手,log 看历史,show <id> 看一份意图的完整结论,trace <id> 看它的内部时间线,gaps 看缺口,hub open 打开那个静态站点。
seal --prepare 与 --submit 拆开,是我很喜欢的一处产品判断:先把要提交的证据冻结成文件,看一遍,再决定交不交。这把“不可逆操作”变成了“可审查的两步”。
十二、我的判断
Mainline 提出的问题比它给的答案更重要:Git 该不该从“代码版本管理”长成“AI 工程的记忆与协作基础设施”?
我认为会,但理由和它的宣传语不太一样。不是“Agent 需要记忆”——那个需求有十种实现方式。真正的理由是:只有 Git 能在不新增一个真相来源的前提下,让记忆获得分支、合并、fork、权限和审计的语义。你要自建一套同等强度的协作机制,工作量比想象的大一个数量级。
顺着这个判断,我认为最值得抄的不是它的 CLI,而是两处接缝:
第一处是 tree_hash 做 join key。 它把一个不可靠的关联(commit hash 在 squash 后失效)换成了一个稳定的关联(树内容)。任何“给提交附加元数据”的系统都会遇到 squash/rebase,这个技巧可以整体搬走。
第二处是 Mainline-Skip 这种显式豁免语法。 覆盖率模型要能落地,必须允许人说“这一笔不用记”,而且这个声明要留在代码里、跟着提交走。没有豁免语言的覆盖率工具,最后都会因为噪音被关掉。
三个我会去验证的下一步:
- 把 worktree 变成一等协作单元。
coordination_scope = local_worktrees已经露头了,它承认“同一台机器上的并行 Agent”和“分布式团队”是两种不同的冲突尺度。如果这条路走通,Git worktree 就从一个开发技巧变成了多 Agent 的隔离原语。 - 把 evaluation 挂到
decisions[]上。现在验证结果只是 intent 里的 notes,没有结构。但decisions[].chose和rejected天然就是可检验的断言——“我们选了事务加幂等,因为主从延迟”,这句话是可以被测试证伪的。 - 让 coverage 变成 CI 门。
gaps现在是给人看的,Mainline-Skip已经是现成的豁免语法。把 uncovered 变成 PR 上的一个 required check,记忆才会真的被维护——机制永远比倡议有效。
最后说一句和 J-Tech Japan 那套 Intent-System 的区别,因为两者常被放在一起看。Intent-System 的重心是流程:用确定性 CLI 和 GitHub label 状态机,把开发流程搬出模型的上下文,保证意图能一路推到 Issue 和交付。Mainline 的重心是存储:它不太管任务怎么流转,它管判断存在哪里、怎么随代码走、谁的提交没人解释过。
| Intent-System | Mainline | |
|---|---|---|
| 解决的问题 | 流程会不会被上下文冲掉 | 判断会不会随代码丢失 |
| 核心机制 | 状态机 + 任务派发 | refs 事件流 + notes 挂载 |
| 记忆的边界 | 一次工作流 | 一个仓库的历史 |
| 失效方式 | 流程空转 | 覆盖率虚高 |
两者不冲突,甚至互补:一个管“这件事该怎么做完”,一个管“为什么当初这么做”。
如果要往平台层落,我倾向于把 Mainline 当成 Intent Memory 子系统,而不是主流程:
| 子系统 | 职责 |
|---|---|
| Mainline | 工程判断与决策记忆,随代码流转 |
| Git worktree | 多 Agent 的隔离开发单元 |
| Context Engine | 检索相关意图与代码上下文 |
| Policy Engine | 谁能写规则(对应 guard 的人确认) |
| Evaluation Engine | 校验实现是否兑现了 decisions[] |
| Recovery Engine | 检查点、回滚、按 stop lines 停机 |
这个组合里最容易被忽略的是 Policy Engine 那一格。Mainline 已经用 guard add 演示了正确的做法:记忆可以自动积累,规则必须人工确认。任何打算做多 Agent 平台的团队,如果跳过这一层,最后一定会得到一个越用越自信、也越来越脏的记忆库。
项目与资料
- GitHub:mainline-org/mainline
- 官网:mainline.sh,托管 Hub:mainline.sh/hub
- 中文 README:README.zh.md
- 三份规范:Intent Record Spec v0.1、Agent Context Protocol v0.1、Agent Autonomy Stop Lines v0.1
- 评测方法与保留意见:docs/eval-results.md
许可证是分层模型:CLI、agent skills、hooks、SDK 与协议规范为 Apache-2.0;文档与示例为 CC-BY-4.0;托管服务与品牌资产另计,商标保留。
本文所有数字、命令名与 ref 路径均取自仓库 README、docs/reference.md、docs/specs/intent-record-v0.md、docs/eval-results.md、CHANGELOG.md 与 GitHub API(核对时间 2026-11-18)。文中标注“推断”的部分是我的推理,不是官方表述;架构示意图为我根据公开文档重绘,非官方原图。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- MNN-Pocket-0.3B:不是把大模型缩小,是从两个预算反推形状
- rust-anything:语言迁移不是翻译,是一场可以判负的比较
- SFT 与 RLHF:教接口,选口味,然后收窄
- Intent-System:它不信任 AI,所以把流程搬出 AI 的上下文
- vLLM:每次重写,改的都是同一本显存账
- Diagram Design:50 种图表是目录,能拒绝你的检查才是产品
- gpu-unlock:GeForce 的半速矩阵算力,写死在八个 4 位字段里
- Octop:单进程是它的地基,也是它的天花板
- VoiceStudio:把 ElevenLabs 搬回本地之后,账单换成了许可证
- DroidDeck:手机跑 PC 游戏不难,难的是让 Android 相信自己正在当主机