Jina-OCR-v1:赢在少写,不在写快
4,096。1,085。2.57。
第一个数字是一个视觉 token 要覆盖多少像素,第二个是一页文档要吐多少 token,第三个是每秒能处理多少页。
前两个是成本,第三个是结果。而这篇论文真正有意思的地方在于:它在速度指标上并不是第一,却赢了吞吐——因为在文档解析这件事上,“一页要写多少”比“每秒能写多少”更决定成本。
项目是 Jina AI 的 jina-ocr-v1,技术报告 arXiv:2609.03181(2026-09-02,四位作者),端到端文档解析模型,基于 DeepSeek-OCR 的骨干改造。许可证是 CC BY-NC 4.0,商用要单独谈——这一点先放在开头,因为它决定了你要不要继续往下读。
一、它是什么:一次“服务点”改造
它没有从零训练一个文档解析模型。论文的定位很明确:DeepSeek-OCR 已经证明了“压缩视觉编码器 + 紧凑 MoE 解码器”能把服务成本压下来,Jina 要做的是补掉剩下的那个瓶颈——自回归解码本身。
| 从 DeepSeek-OCR 继承 | 这一版新增 | |
|---|---|---|
| 视觉 | DeepEncoder(约 380M):SAM 80M → 16× 卷积 → CLIP-L 300M | — |
| 解码 | DeepSeek-3B-MoE:12 层、d=1280、64 路由 + 2 共享、top-6 | — |
| 词表 / 位置 | 129,280 / 32,768(RoPE θ=10⁶) | — |
| 投机解码 | — | FastMTP:一个共享 draft block,递归 K=3 |
| 后训练 | — | 指令对齐 + 鲁棒性微调 + GRPO(密集可验证奖励) |
| 数据 | — | 公开语料清洗 + 定向合成(JinaOCRSynth) |
参数量要拆开看,否则很容易记错:
- 解码器 3B 总参数,每 token 激活约 570M(MoE,top-6 路由);
- 整个模型 约 3.4B 总参数,激活不到 1B(含视觉塔)。
- 视觉塔本身约 380M(SAM 80M + CLIP-L 300M)。
所以“570M 激活”说的是解码器每步激活多少,不是“模型只有 570M”。这两个数字差 6 倍,选型和显存规划时用错会很难受。
二、输入侧:把 4,096 个 patch 压成 256 个 token
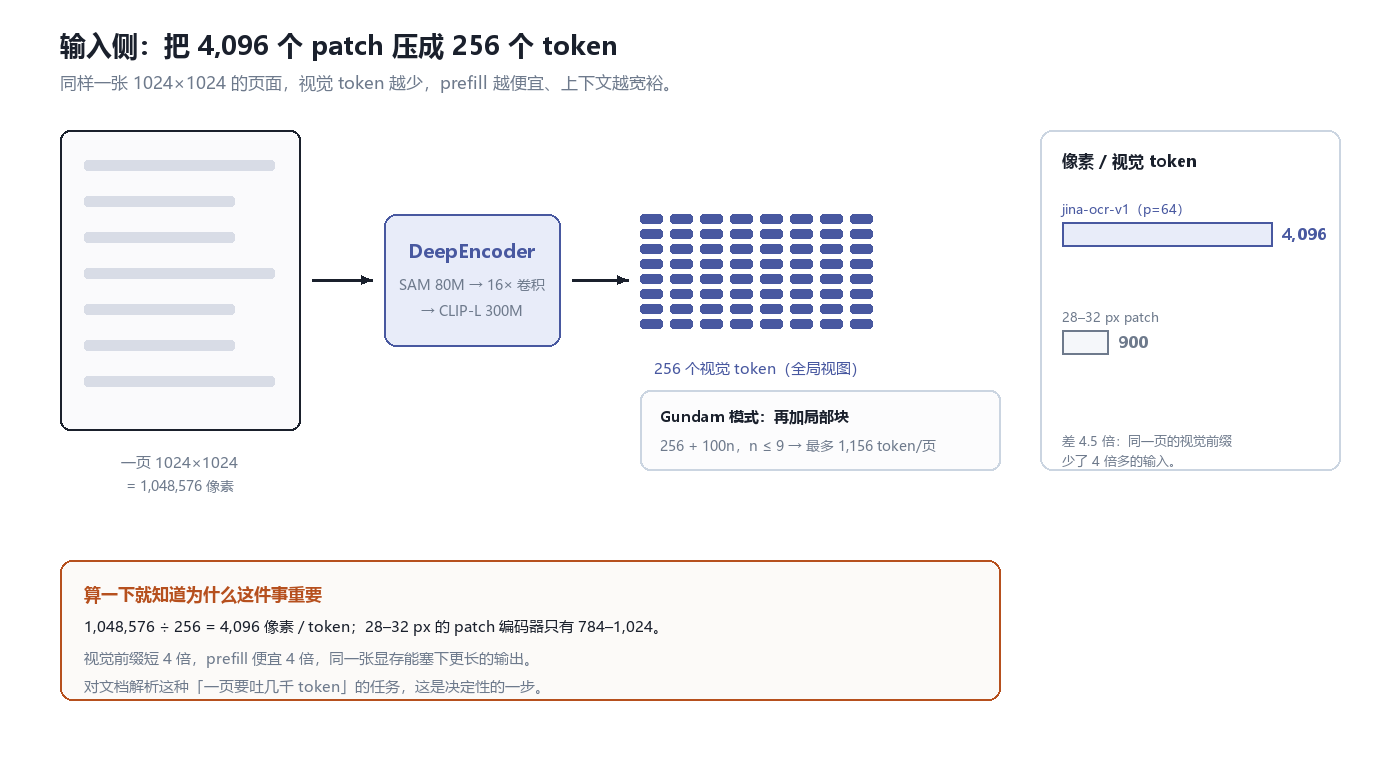
1,048,576 像素除以 256,每个视觉 token 覆盖约 4,096 像素;28–32px patch 的编码器只有 784–1,024。
DeepEncoder 的路线是“先看局部,再看全局”:window-attention 的 SAM 编码器抓局部纹理,16 倍卷积压缩把空间分辨率打下来,再用 global-attention 的 CLIP 编码器补语义。
结果是:一张 1024×1024 的页面,4,096 个 patch 被压成 256 个视觉 token。
这个数字值得单独记一下,因为它是个可以直接比较的横轴。常见 VLM 用 28–32px 的 patch 切图,每 token 只覆盖 784–1,024 像素;DeepEncoder 的等效 patch 边长是 64,单位 token 覆盖的像素多 4 倍多。同一页文档,视觉前缀短 4 倍,prefill 就便宜 4 倍。
细节优先的场景还有 Gundam 模式:全局视图之外再切局部块,256 + 100n,n 最多 9,一页最多 1,156 个视觉 token。这是一种“按需加钱”的设计——普通页只付 256,密排小字的表格才付到 1,156。
三、解码器:3B 里只走 570M
MoE 在这类任务上的性价比很高,原因很朴素:文档解析的每个 token 需要的知识类型很集中。输出 <td> 的时候不需要调动写诗的能力,输出 LaTeX 的时候也不需要。
12 层、hidden 1280、64 个路由专家 + 2 个共享专家、top-6,每个 token 走 6 个专家。3B 的总参数保证了容量,570M 的激活量保证了单步成本。
论文给出的定位很直接:在 olmOCR-Bench 和 OmniDocBench 上,570M 激活参数的模型都在“精度 vs 激活参数”的帕累托前沿上,而且领先那些大一个数量级的系统;在 OmniDocBench 上它还是这条前沿上最紧凑的那个点。
这话听起来像常规宣传,但配上后面那张吞吐表就比较有说服力了。
四、FastMTP:一个 draft block,递归猜三步
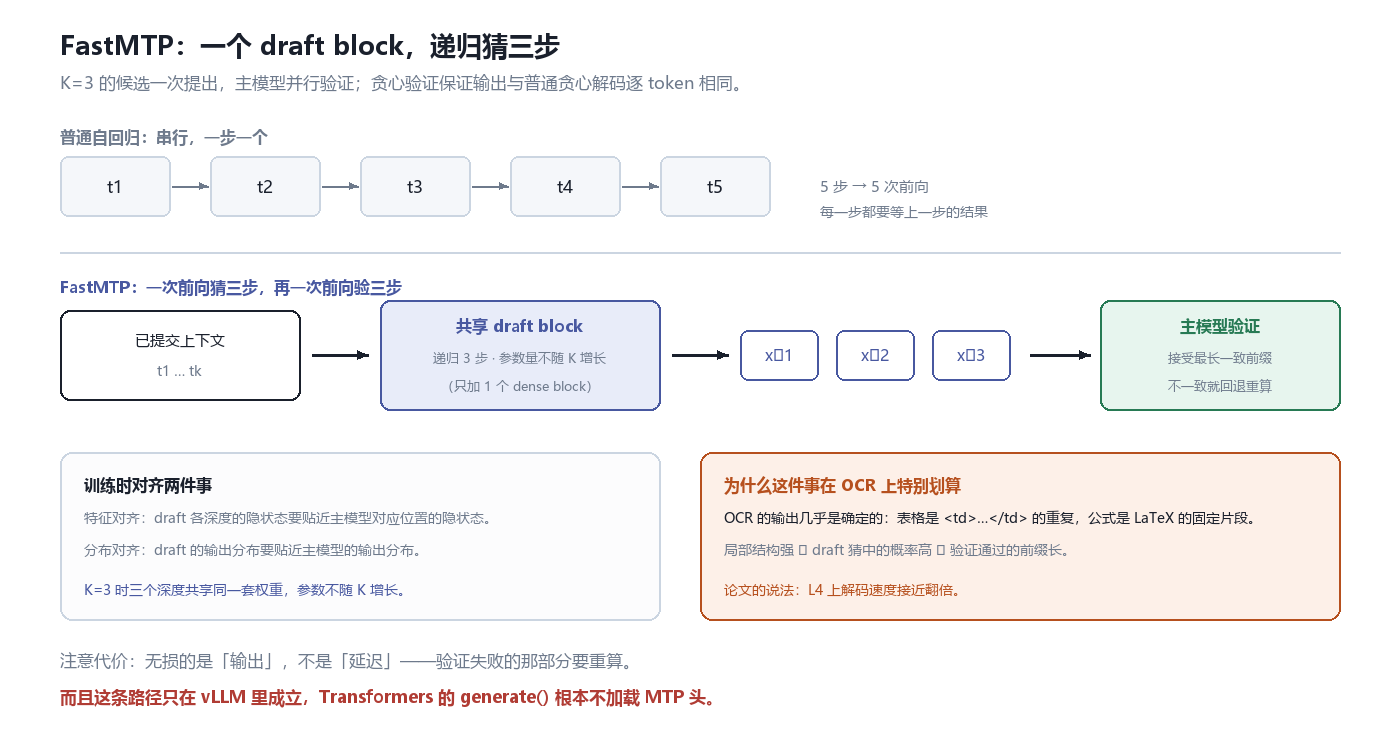
共享一个 dense draft block,递归预测 K=3;主模型并行验证,接受最长的一致前缀。
投机解码的思路不新:先用一个便宜的“草稿模型”猜出后面几个 token,再让主模型一次性验证。难点在两点——草稿要够便宜,猜得还要够准。
FastMTP 的做法是只加一个共享的 dense draft block,递归执行 K=3 步。共享的好处很直接:草稿部分的参数量不随 K 增长,K=3 和 K=5 的参数开销一样。
训练时对齐两件事:特征的(draft 各深度的隐状态贴近主模型对应位置)和分布的(draft 的输出分布贴近主模型)。论文里把这件事写成了一张“序列位置 × 递归深度”的二维网格,README 里有一句更实用的总结:draft 每一步都必须建立在“上一步的预测”上,而不是重新锚定到真实 prefix——这也解释了后面那个部署坑。
验证是贪心的:只接受与主模型贪心解码逐 token 相同的最长前缀。所以它是无损的——输出跟普通贪心解码完全一致,不是拿质量换速度。
为什么 OCR 特别适合投机解码?论文的理由我很认同:OCR 的输出几乎是确定的。表格是 <td>…</td> 的重复,公式是 LaTeX 的固定片段,标题层级是有限的标记集合。局部结构这么强,draft 猜中的概率自然高。
官方数字:在 NVIDIA L4 上,FastMTP 相比普通贪心自回归解码,解码速度接近翻倍。
代价也要说清楚:无损的是输出,不是延迟。验证失败的那部分要回退重算,所以加速比取决于页面的“可预测程度”——表格页赚得多,自由排版的扫描件赚得少。
五、输出侧:赢在“少写”,不是“写快”
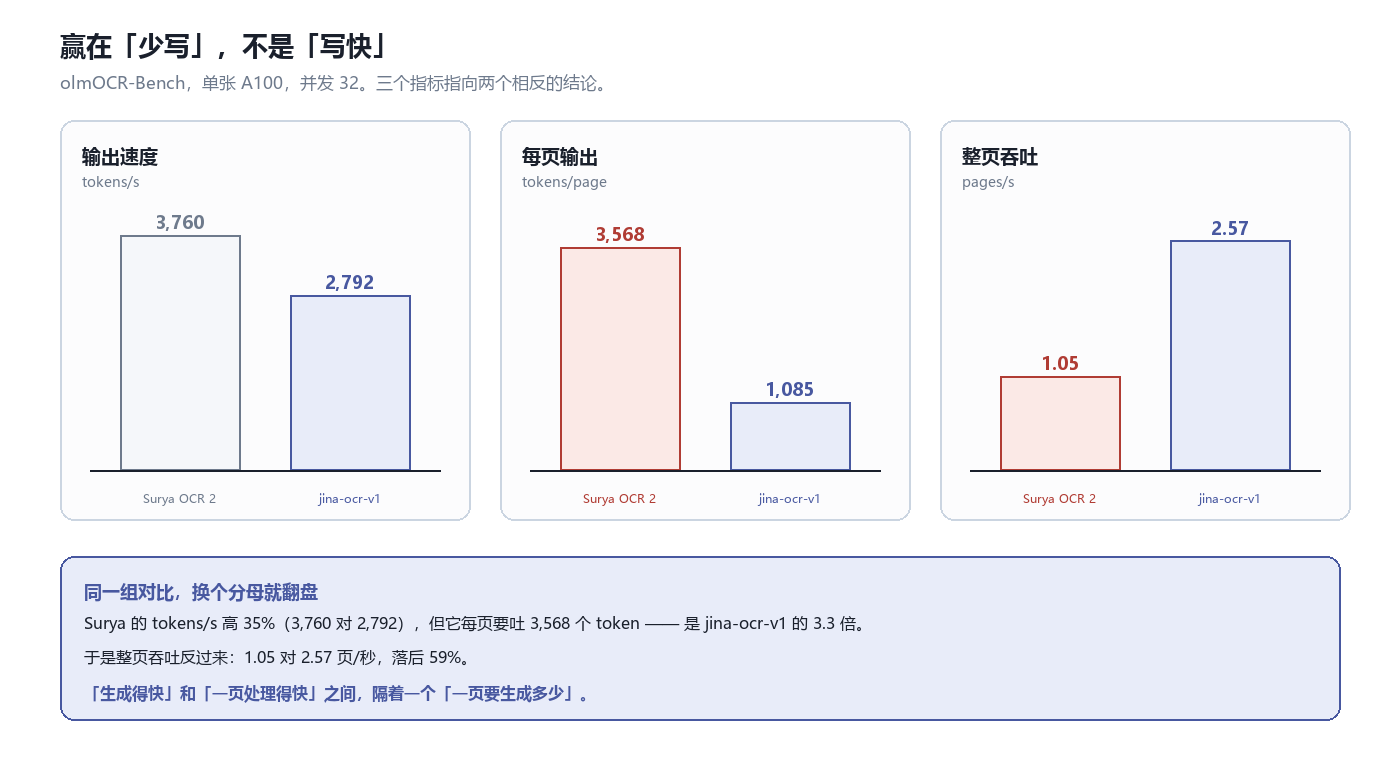
同一组对比,换个分母就翻盘。数据取自模型卡。
这是全文我最想让人记住的一节。
官方在 olmOCR-Bench 上对比了 14 个系统(单张 A100,并发 32),其中有两个数字很刺眼:
| 系统 | 输出速度 | 每页输出 | 整页吞吐 |
|---|---|---|---|
| Surya OCR 2 | 3,760 tok/s | 3,568 tok/page | 1.05 页/秒 |
| jina-ocr-v1 | 2,792 tok/s | 1,085 tok/page | 2.57 页/秒 |
Surya 的 token 生成速度快 35%,但它的整页吞吐只有 jina-ocr-v1 的 41%。
原因全在中间那列:它每页要吐 3,568 个 token,是对方的 3.3 倍。 而 jina-ocr-v1 是所有“得分超过 83”的系统里输出最短的那个。
所以:
- 模型 A 每秒能写 3,760 个 token;
- 模型 B 每秒能写 2,792 个 token;
- 但模型 B 一页只写 1,085 个 token,于是它每秒能处理 2.57 页。
吞吐 = 速度 ÷ 每页输出量。这两个因子都能优化,但只有分母能靠“少写”来降。 而“少写”在文档解析里是有真实价值的:表格用 HTML 而不是 Markdown 管道的重复描述、去页眉页脚、忽略插图、公式只留 LaTeX——这些不是偷懒,是把“给下游用”和“给人看”分开。
这条视角对做 RAG 的人尤其重要:你为 OCR 付的钱,最终是按页算的,不是按 token 算的。
六、后训练:五个可执行的检查相乘
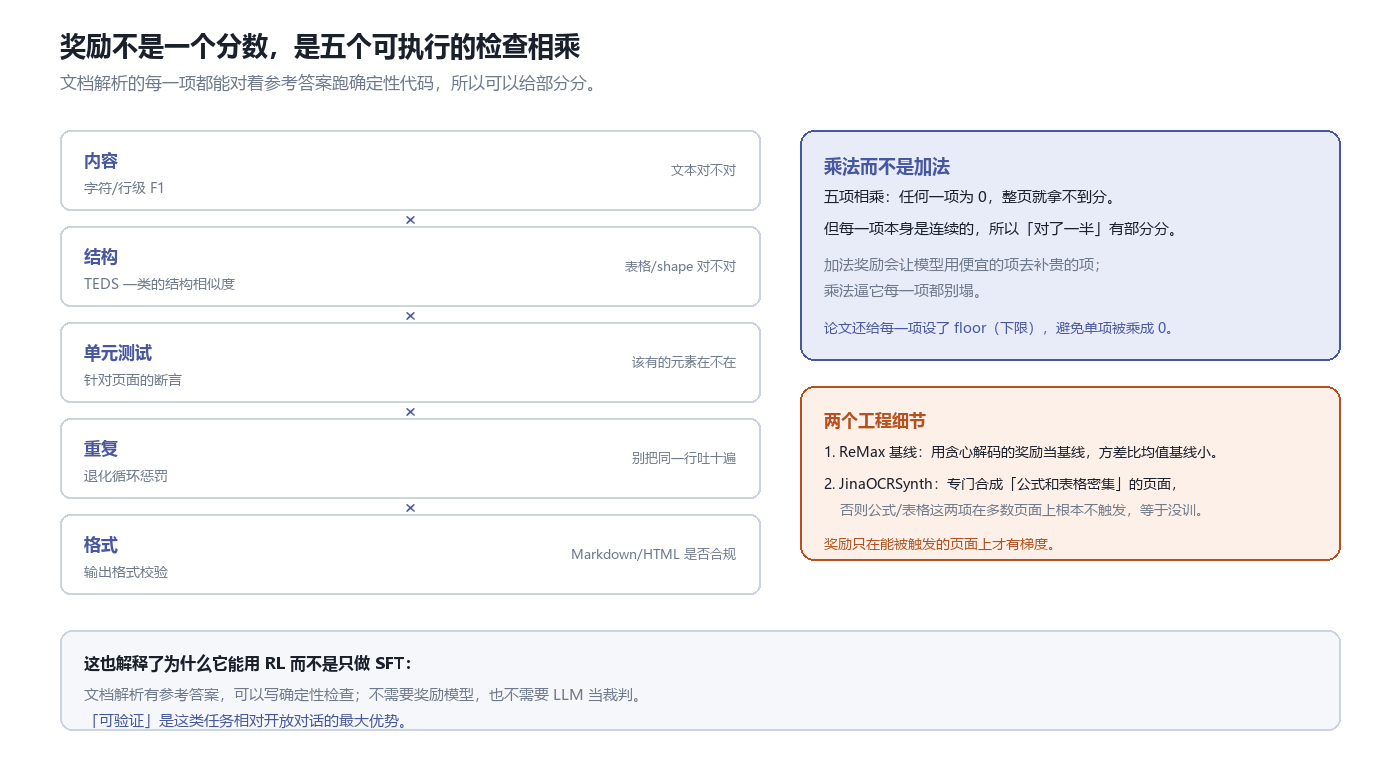
文档解析有参考答案,所以每一项都能写成确定性代码,不需要奖励模型,也不需要 LLM 当裁判。
后训练分三步:指令对齐(含长度外推)、困难文档的鲁棒性微调、然后 GRPO + 密集可验证奖励。
关键在“密集”两个字。很多文档解析的 RL 会用编辑距离或 TEDS 给一个总分,而这里是把奖励拆成五项,每项都由确定性代码对着参考答案算:
| 项 | 检查什么 |
|---|---|
| 内容 | 字符/行级 F1 |
| 结构 | TEDS 一类的结构相似度 |
| 单元测试 | 针对页面的断言(该有的元素在不在) |
| 重复 | 退化循环惩罚(别把同一行吐十遍) |
| 格式 | 输出格式是否合规 |
而且这些项是相乘的,不是加权求和。这个选择的含义很清楚:任何一项为 0,整页就拿不到分;但每一项本身是连续的,所以“对了一半”能拿到部分分。加法奖励会让模型用便宜的项去补贵的项,乘法逼它每一项都别塌。论文还给每一项设了下限,防止某一项被乘成 0 之后梯度全断。
两个工程细节值得抄:
第一,ReMax 基线。 用贪心解码的奖励当基线,而不是用组内均值。对确定性强的任务,这个基线方差更小。
第二,JinaOCRSynth。 专门合成“公式和表格密集”的页面。理由很实际:公式项和表格项只有在页面上真的有公式和表格时才触发,而自然语料里这类页面占比不高——不补齐,这两项的梯度就是稀疏的。奖励只在能被触发的页面上才存在。
七、评测怎么读:两个分数,一个前提
官方成绩:
| Benchmark | 分数 |
|---|---|
| OmniDocBench v1.6 | 91.14 |
| olmOCR-Bench | 83.4(比 DeepSeek-OCR 基线 +7.4) |
但这里有一个几乎所有人都会忽略的前提,它写在模型卡的 Prompt 一节里:这两个分数是用一套比“推荐用法”严格得多的指令测出来的。
推荐给用户的默认 prompt 只有一句:“把这张文档图转成干净的 Markdown,保持自然阅读顺序。”
而评分时用的 prompt 长得多,明确要求:
- 公式转 LaTeX,行内用
$ $、块级用$$ $$,不许用 unicode 数学符号; - 表格转 HTML(用
<th>、rowspan、colspan),不许用 Markdown 表格; - 忽略所有图形内容,不描述不转换;
- 去掉页眉页脚,但保留参考文献和脚注;
- 保留跨页断句的原样;
- 如果没有可读文字,输出
null。
这解释了两件事。第一,为什么它的“每页输出”能压到 1,085 token:去掉页眉页脚、忽略插图、表格用紧凑 HTML,本来就少写很多。第二,你复现不出 91.14,很可能不是模型不行,而是你没用那套 prompt。
这是文档解析评测的通病,不算这个项目的错,但作为使用者必须知道:benchmark 分数和“默认用法”之间,隔着一整段没被强调的指令。
八、跑起来:三条路,三个坑
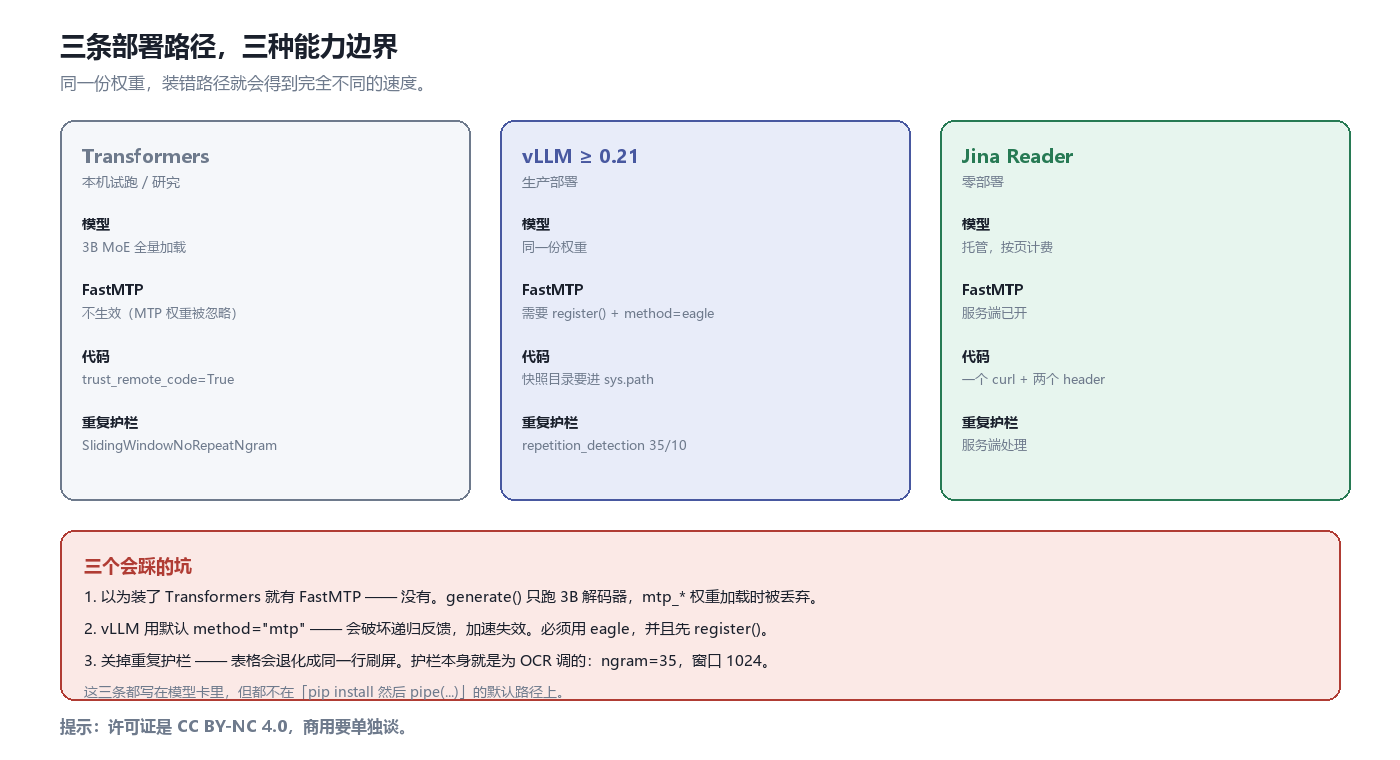
同一份权重,装错路径就会得到完全不同的速度。
三条路,能力边界差别很大:
Transformers(本机试跑):AutoProcessor + AutoModelForCausalLM,trust_remote_code=True。但要注意——generate() 只跑 3B 解码器,FastMTP 完全不生效,mtp_* 权重在加载时被忽略。想在本地验证“投机解码有多快”是验证不出来的。
vLLM ≥ 0.21(生产):需要先 register()(每个进程一次,LLM(...) 之前),并且用 method=“eagle”。这一步不能省,也不能改:vLLM 默认的 method=“mtp” 会在每个 draft 步骤重新锚定到目标模型,破坏 FastMTP 的递归反馈——加速会失效,而且不报错。另外模型快照目录必须进 sys.path,否则 worker 进程 import 不到 deepseek_ocr_mtp。
Jina Reader(零部署):r.jina.ai 加两个 header(X-Respond-With: jina-ocr-v1、X-Page),或者走 OpenAI 兼容的 api.jina.ai/v1/chat/completions。冷启动会返回 503,等 30–60 秒重试。
还有一个不太显眼但很致命的坑:重复退化护栏。
Transformers 侧默认挂了 SlidingWindowNoRepeatNgramProcessor(no_repeat_ngram_size=35、窗口 1024,并白名单放行 <td>/</td> 这两个 token);vLLM 侧对应 repetition_detection(max_pattern_size=35、min_pattern_size=35、min_count=10),采样参数是 temperature=0.0、repetition_penalty=1.05。
这些默认值不是随手写的——它们就是为“表格页会退化成同一行刷屏”这个具体故障调的。如果你把它们关掉换成通用的重复惩罚,表格很可能直接崩。
九、局限
按重要性排:
- 许可证是 CC BY-NC 4.0,不是 Apache 2.0。 权重能下载不等于能商用;商业授权要联系销售。这条比任何技术指标都优先。
- 它只做“一页图 → 一份结构化文本”。 PDF 拆页、批量调度、结果存储、索引、权限,全都要自己接;Reader 那层帮你做了取页和渲染,但那是另一个产品。
- FastMTP 只在 vLLM 里成立。 Transformers 路径拿不到这部分加速,两者性能不可直接比较。
- 91.14 依赖那套严格 prompt。 换成默认 prompt 或你自己的指令,分数会变,而且大概率往下走。
- 幻觉与漏字的风险由页面质量决定。 倾斜、模糊、低分辨率扫描件仍是主要失败源;论文为此专门做了鲁棒性微调,但“是否足够”要靠你自己的样本验证。
- 吞吐是单机单卡单并发测的(A100、并发 32)。换 GPU、换并发、换分辨率,2.57 这个数字都会动。
- 它对“图表”是主动丢弃的。 按评分 prompt 的要求,图形内容不描述不转换——如果你的场景需要理解图(不只是文字),这不是它的范围。
十、我的判断
这个项目值得学的不是 91.14,而是它把“部署成本”拆成了三个可独立优化的因子,而不是笼统地说“我们很高效”。
三个因子,三层账:
| 层 | 优化对象 | 手段 | 代价 |
|---|---|---|---|
| 输入 | 视觉 token 数 | 16× 卷积压缩,256 token/页 | 细节要靠 Gundam 局部块补 |
| 计算 | 每 token 激活参数 | MoE top-6,570M/3B | 路由开销、显存要装下全部专家 |
| 输出 | 每页 token 数 | 结构化输出 + 严格指令 | 表达力受限,图表被丢弃 |
三层里最被低估的是第三层,因为前两层在论文里好写、好画图,第三层只是一个“每页 1,085 token”的数字——但它才是页/秒这个分母。
顺着这个思路,有三件事可以搬走:
第一,把吞吐写成“页/秒”,而不是“token/秒”。 前者是业务指标,后者是引擎指标。当你的灰度指标用错了分母,优化方向会整个跑偏——Surya 那个例子就是最好的反证。
第二,投机解码的收益取决于输出的“可预测度”,不是模型大小。 表格、公式、固定标记这类强局部结构,是投机解码的理想负载;自由文本不是。选型时先看输出形态,再看硬件。
第三,RL 的奖励要乘法,且每一项都要能被触发。 乘法防塌项,合成数据防稀疏——这两条对任何“多维度可验证”的任务都成立,不只 OCR。
如果只记一句话:这个模型最聪明的地方不是压视觉 token,是把“少写”变成了产品指标。
项目与资料
- 模型:jinaai/jina-ocr-v1(CC BY-NC 4.0)
- 论文:arXiv:2609.03181,15 页、5 图、8 表
- 官方博客:Faster Document Parsing on Low-Budget GPUs
- Playground:Document OCR
- 仓库内附
example.py,同时支持 Transformers 与 vLLM 两个后端
事实核对:架构参数(12 层、1280、64+2 专家、top-6、129,280 词表、32,768 位置、RoPE θ=10⁶)取自 config.json 与论文表 1;91.14 / 83.4 / 2.57 页每秒 / 2,792 tok/s / 1,085 tok/page / 1.05 页每秒与 3,760 tok/s 取自模型卡的吞吐对比;三个训练阶段、乘法奖励、ReMax 基线、JinaOCRSynth 与 L4 加速取自论文摘要与第 5 节;部署细节(register()、method=“eagle”、no_repeat_ngram_size=35、repetition_detection、Transformers 不支持 MTP)取自模型卡。示意图均为重绘,柱状图为真实数值,其余形状为示意。核对时间 2026-11-18。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- video-shotcraft:150 个镜头名,就是 Agent 的接口
- MNN-Pocket-0.3B:不是把大模型缩小,是从两个预算反推形状
- rust-anything:语言迁移不是翻译,是一场可以判负的比较
- SFT 与 RLHF:教接口,选口味,然后收窄
- Mainline:工程判断该住在 Git 里,不该住在数据库里
- Intent-System:它不信任 AI,所以把流程搬出 AI 的上下文
- vLLM:每次重写,改的都是同一本显存账
- Diagram Design:50 种图表是目录,能拒绝你的检查才是产品
- gpu-unlock:GeForce 的半速矩阵算力,写死在八个 4 位字段里
- Octop:单进程是它的地基,也是它的天花板