Hypit:你编辑的是词,秒是编译出来的
0。30,485。$1.15。
一条 20 秒的成片,时间轴上作者手写的秒数是 0 个;仓库不到四个月拿到 30,485 star;官方示例给出的总成本是 $1.15。
Hypit 2026-07-29 建库,现在到 v0.3.3,TypeScript,3,583 个 fork,副标题只有一句:Clone any viral video with AI agents。
我看完源码之后的判断是:它最值得抄的不是“让 Agent 生成视频”,而是一个更小、更硬的设计——
它把时间轴从“作者写的事实”,降级成了“编译产物”。你编辑的是词,秒是算出来的。
本文只讲这一件事。
一、时间轴的归属问题
剪辑软件里,时间轴是所有权的中心。你在第 3.2 秒切一刀,这个 3.2 就是事实:渲染器照着它执行,字幕照着它出现,没人会去质疑它。
代价是改一句话,五处要改,还有一处要重新量。
| 改一句台词,要同步的地方 | 传统时间轴 | Hypit 里 |
|---|---|---|
| 脚本 | 改文本 | 改 Script 里那一句 |
| 配音 | 重录或重生成 | 重录或重生成(不变) |
| 每段时长 | 手工量、手工填 | 实测 extent,自动得出 |
| 字幕时间 | 逐句对轴 | 由词区间投影得出 |
| B-roll 落点 | 拖动片段重新卡点 | 跟着它锚定的短语走 |
| 音效与转场 | 逐个挪 | 由总时间轴重算 |
五处要改、一处要重新量,而且没有任何一处会告诉你“已经对不上了”。这就是为什么改一版比做一版还累。
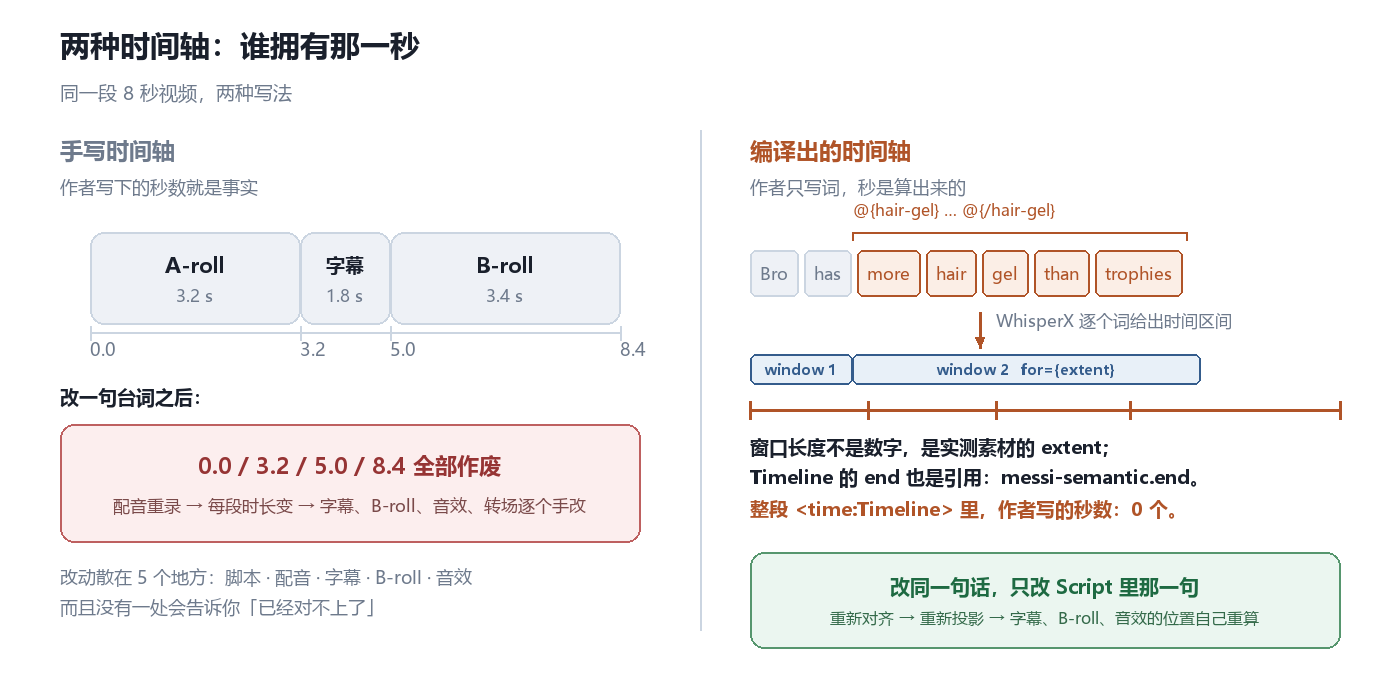
左边改一句要重写五个文件,右边改一句只动 Script 里那一行;这不是体验差异,是数据归属的差异。
二、它长什么样:四个文件
安装只有一条命令:
npx skills add hypit-ai/hypit -g
装的是 Skill(制作知识),可执行的 hypit 由 Agent 另外准备。视频项目可以放在任何目录,不必克隆仓库。
一个项目里其实只有四类文件:
| 文件 | 是什么 | 谁写 |
|---|---|---|
.svml | Author Source | Agent 或人:剧本、素材、组件、合成 |
.svs | Recipe | 可复用的外观与动作片段 |
.svrun | Run Source | 这次 Build 要什么、复用哪些旧产物 |
hypit.runtime.json | Runtime Profile | 用哪些服务、凭据在哪 |
我第一次看到这个切分时觉得过度设计,直到看懂了它挡掉的是什么:这四类文件的作者不是同一个人,改动频率也差两个数量级。剧本一天改八遍,Profile 一个项目配一次。
三、五个所有者,三条边界
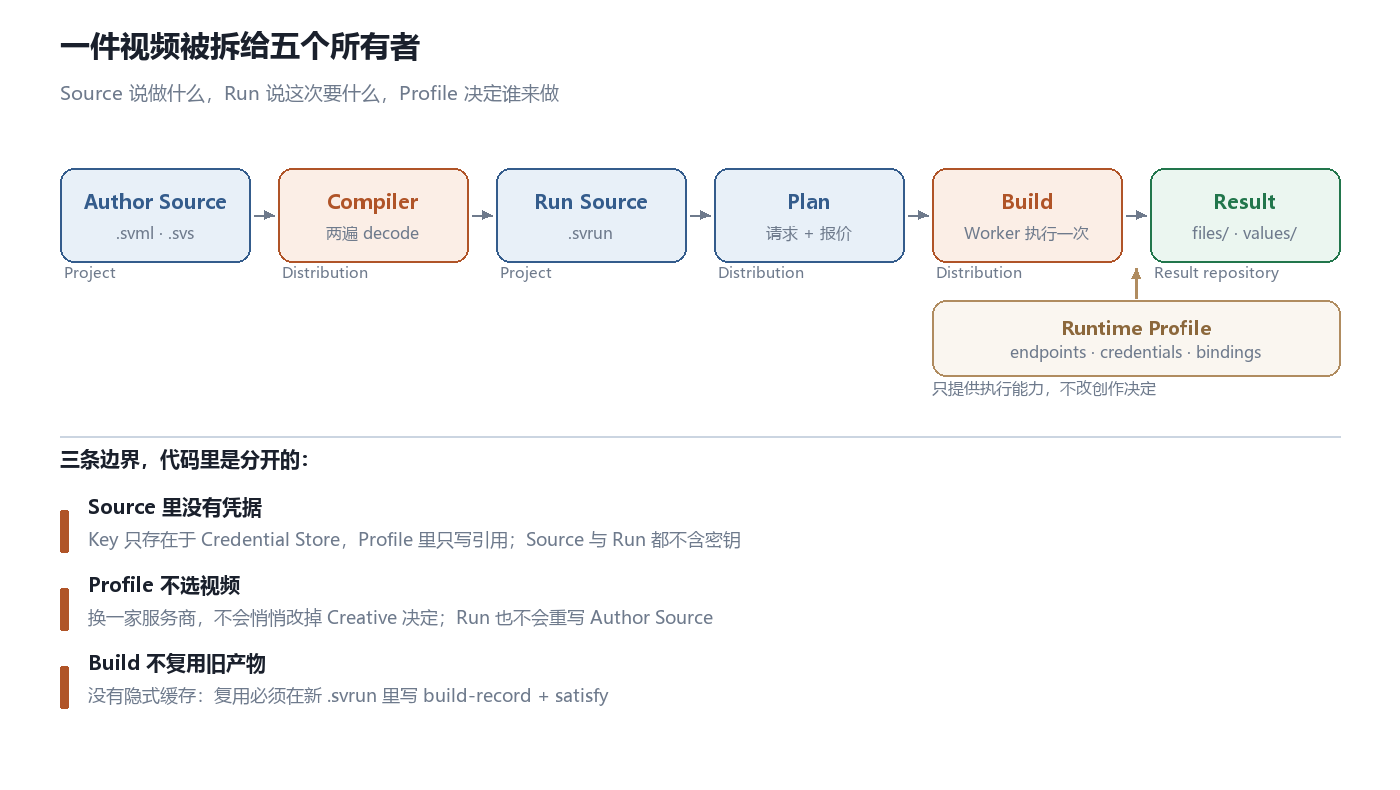
官方文档里的所有者划分:Project 拥有 Source,Distribution 拥有编译器与执行器,Profile 拥有端点与凭据,Build 是一次尝试,Result 仓库保存产物。
这套划分在代码里是三条硬边界:
Source 里没有凭据。 Key 只存在 Credential Store 里,Profile 里写的是引用,.svml 和 .svrun 都不含密钥。
Profile 不选视频。 换一家模型服务商,不会悄悄改掉创作决定;反过来,Run 也不会重写 Author Source。
Build 不复用旧产物。 这一点最反直觉:Hypit 没有隐式缓存,build 每次都创建新的 Build id,哪怕源码一个字没改。复用必须在新 .svrun 里显式写 build-record 和 satisfy。
对 Agent 来说,这三条边界比任何提示词都管用:它能改的东西被限制在 Source 和 Run 两层,越不过去动执行环境。
四、SVML 不是“视频语言”
SVML 常被描述成一种视频的声明式描述语言。翻开源码之后,这个说法要修正一下。
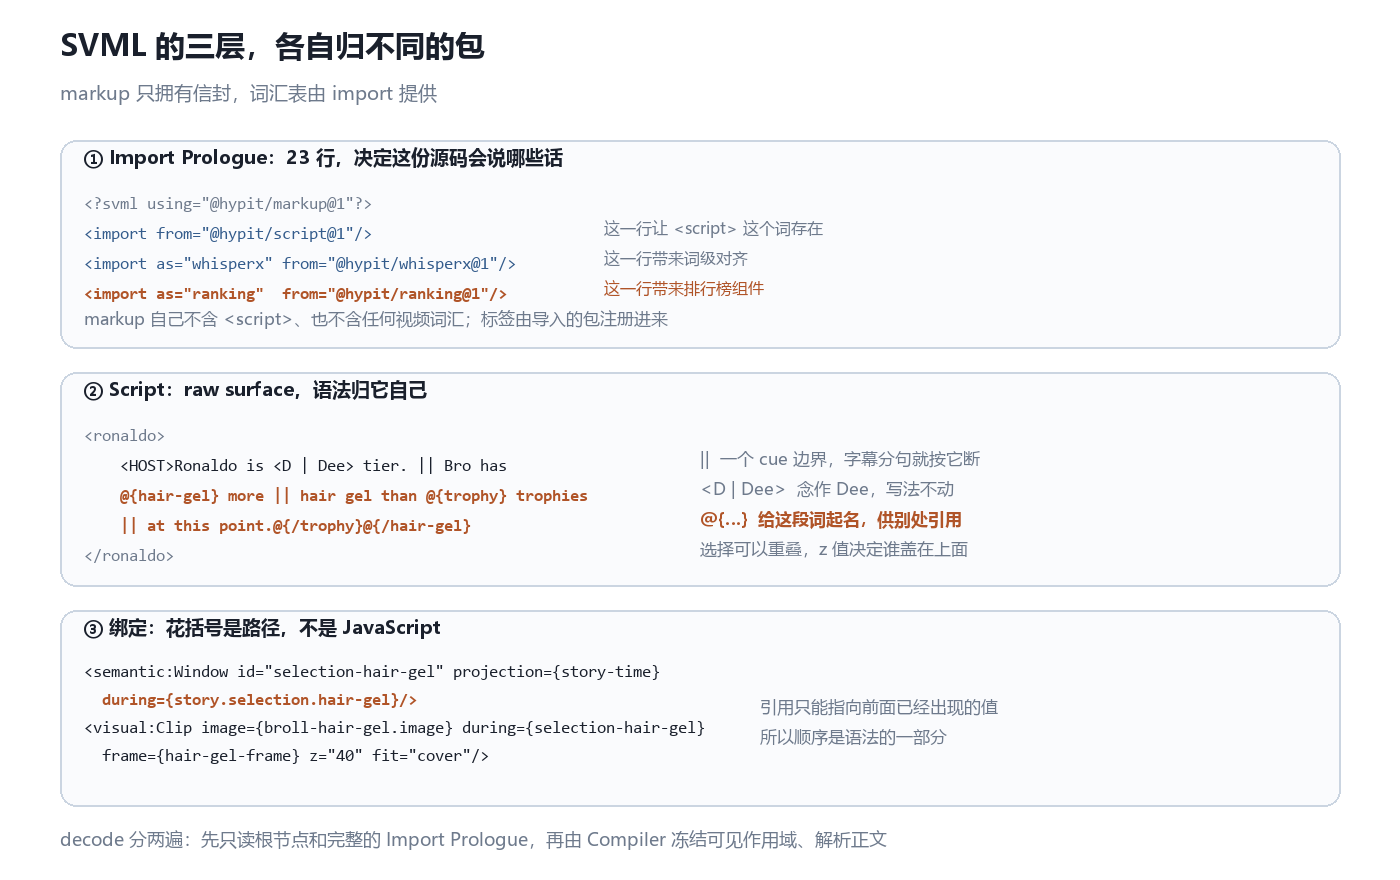
@hypit/markup 只拥有 <svml> 信封、导入序言、命名空间和通用元素,其余词汇表全部由 import 进来的包提供。
这个包的 README 写得很清楚:markup 自己不含 <script>,不含任何媒体或视频词汇。 <script> 能被识别,是因为某一行 import 引入了 @hypit/script。足球排行榜那条片子,开头是 23 行 import——23 个包各自往这份源码里注册一个能力。
所以 SVML 更准确的定义是:一个带命名空间前缀的组件装配格式,加上每个组件自己的原始表面(raw surface)。
第二层是 Script。它不遵守 XML 那套规矩,语法归它自己:
<HOST>Ronaldo is <D | Dee> tier. || Bro has
@{hair-gel} more || hair gel than @{trophy} trophies
|| at this point.@{/trophy}@{/hair-gel}
三件事同时发生:|| 是 cue 边界,字幕分句按它断;<D | Dee> 让这个词念作 Dee 而不改写法;@{…} 给一段词起名字,别处就能引用这段词。
第三层才是普通元素,花括号里是绑定路径,不是 JavaScript:
<semantic:Window id="selection-hair-gel" projection={story-time}
  during={story.selection.hair-gel}/>
解析分两遍:先只读根节点和完整的导入序言,由 Compiler 冻结可见作用域,再解析正文。因此引用只能指向前面已经出现的值——前向引用不是通用保证。这一条看起来像实现细节,其实是这套语言可以静态检查的前提。
五、秒是从哪来的
这是全文的核心,也是我认为它值得单独写一篇的原因。
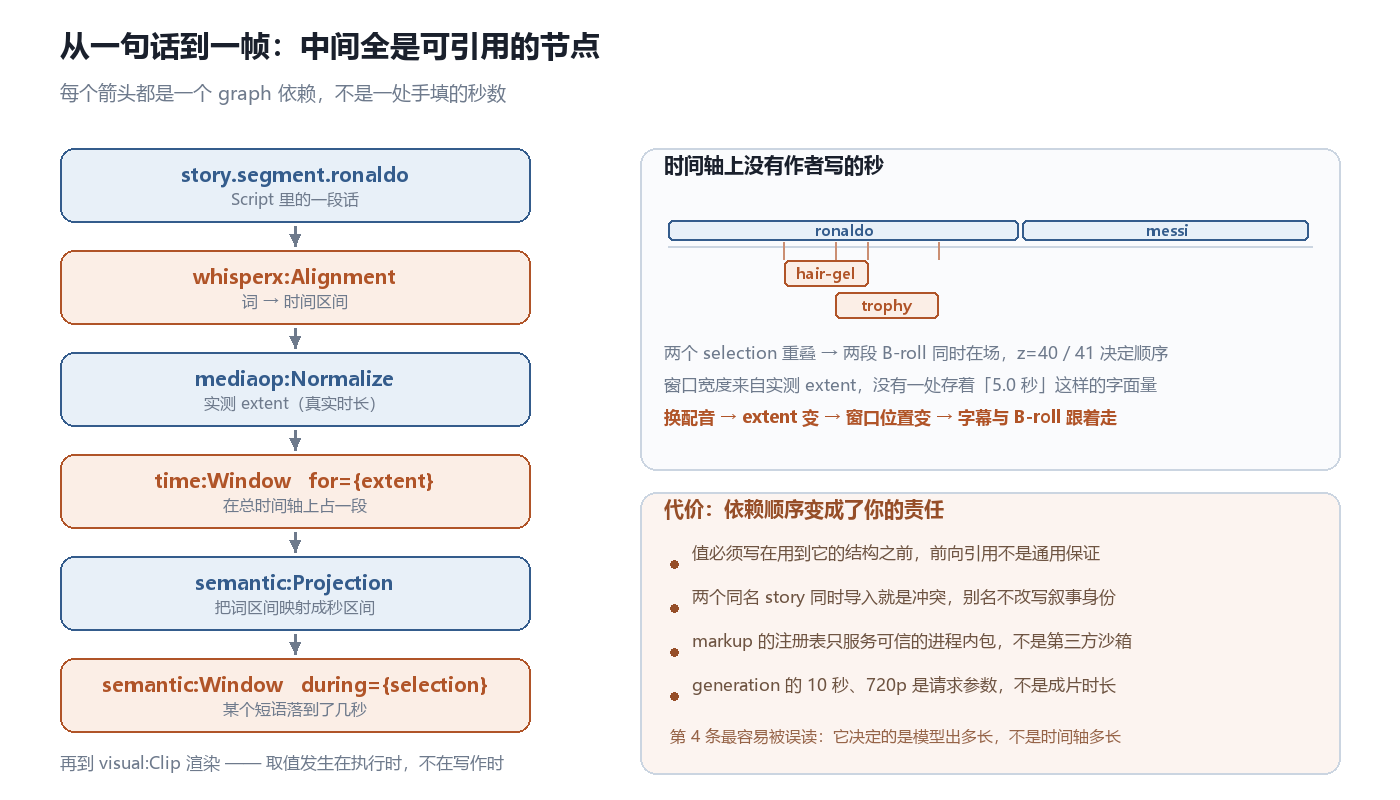
每个箭头都是一个 graph 依赖。时间轴上没有一个节点存着“5.0 秒”这样的字面量。
足球那条片的整个时间轴只有两行:
<time:Timeline id="speech" clock={clock} end="messi-semantic.end">
  <time:Window id="ronaldo-semantic" from="start" for={ronaldo-media.extent}/>
  <time:Window id="messi-semantic" from="ronaldo-semantic.end" for={messi-media.extent}/>
</time:Timeline>
窗口的宽度是 for={…extent}——归一化之后实测出来的真实时长,不是作者填的数字。整条时间轴的 end 是 messi-semantic.end,一个点的名字,不是秒。
于是有了三个直接后果,而且都是从依赖图里自动得到的,不是三个功能:
- 改文案重新对齐,字幕时间跟着重算;
- 换配音重新对齐,窗口位置跟着变;
- 换 B-roll 素材,只需要换那个
Clip的image,不用重新设计版面。
再往上,semantic:Projection 把“词的时间区间”映射成“秒的时间区间”,semantic:Window 再用一个短语的 selection 取出它落到的那一段。B-roll 锚定的从来不是秒,是一个短语。
这里有个容易被误读的地方:源码里写着 duration="10"、resolution="720p",看着像成片参数。它不是。它是发给生成模型的请求参数。示例 README 里写得很直白:两段都估算出 9 秒,源码里请求 10 秒是为了给表演留出空间。
六、词是编辑单元,那重叠怎么办
词一旦成为编辑单元,就会碰到一个真问题:两个 B-roll 想锚在同一句话上,谁在上面?
Hypit 的答案是:允许重叠,用 z 显式解决。源码注释用的是英文:later overlapping jokes use a higher explicit z on their own Clip occurrence。
<visual:Clip id="hair-gel" image={broll-hair-gel.image}
  during={selection-hair-gel} z="40" .../>
<visual:Clip id="trophy" image={broll-trophy.image}
  during={selection-trophy} z="41" .../>
我原本以为这种重叠会被禁止,因为它是时间轴模型里最脏的部分。它没有被禁止,而是变成了两个数字——因为在语义模型里,重叠是表达,不是冲突:同一句话里先提头发胶、再提奖杯,两段画面本来就应该轮流出现。
这也解释了为什么 selection 需要一个名字。名字一旦存在,它就变成了 graph 上的一个节点,可以被静态检查、被别处引用。
七、钱在提交前就能看见
对做批量生产的人来说,这一节可能比前面都实用。
Hypit 把“花多少钱”拆成了五个命令,其中四个不花钱:
| 命令 | 做什么 | 会不会产生费用 |
|---|---|---|
hypit check | 只做源码检查 | 不会 |
hypit estimate | 按语速/语言估算时长 | 不会 |
hypit plan | 列出这次要发哪些请求、需要哪些凭据 | 不会 |
hypit pricing | 读所选服务商的费率并归并请求 | 不会 |
hypit build | 唯一会提交工作的动作 | 会 |
官方三个示例的实测总成本:20 秒的足球排行榜 $1.15,18 秒的播客片段 $1.07,26 秒的街头采访 $1.09。这个价位能成立,靠的不是模型便宜,而是大部分素材不调用生成模型:字幕、动效、排行榜、代码渲染的画面全部本地编译。
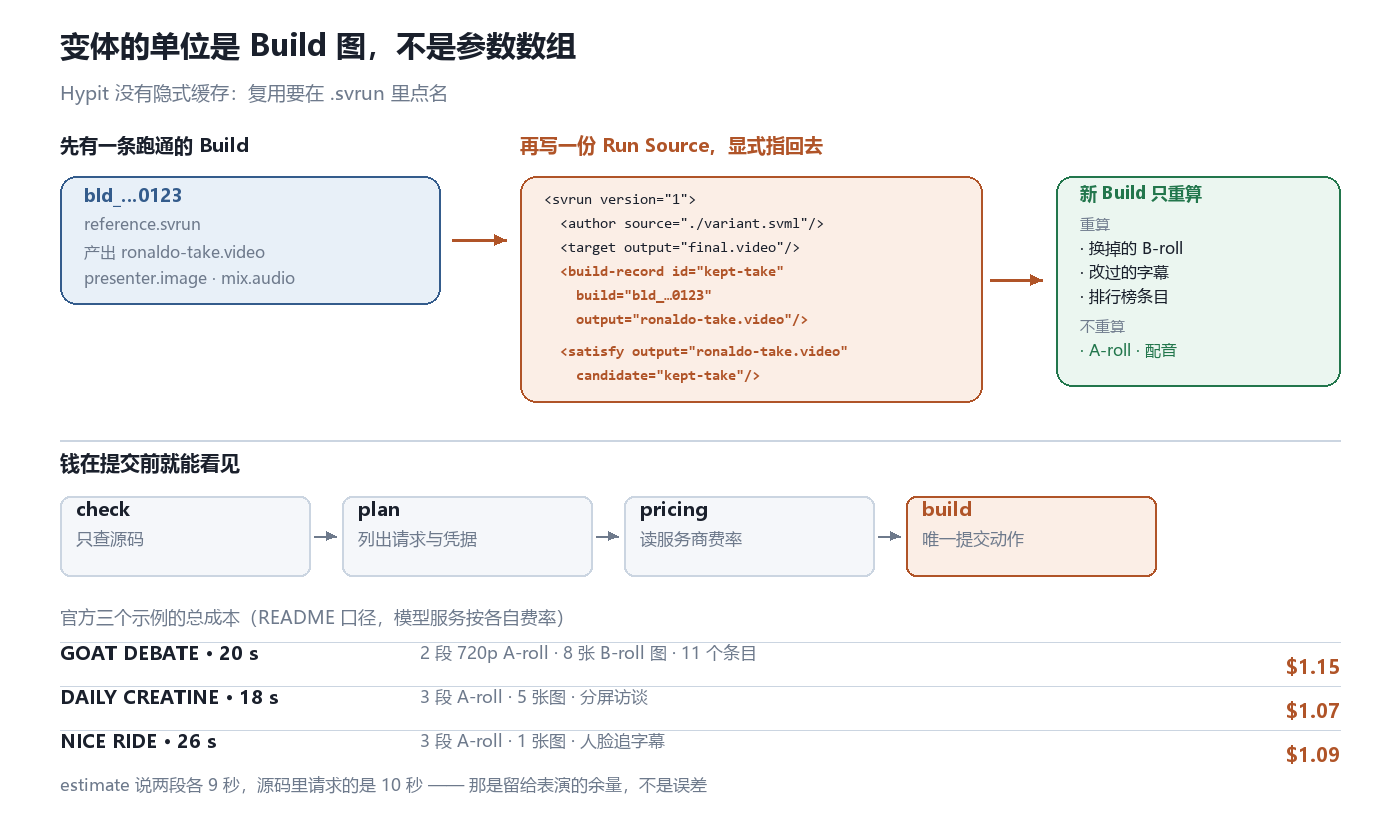
复用不是缓存命中,是在 .svrun 里点名一条旧 Build 的某个 Output。
八、“100 个变体”成立到什么程度
这是宣传语和代码差得最远的一处,值得单独说。
README 的副标题是“1 command, 100 variants, 100M views”。听起来像模板参数化:一份模板,填 100 行配置,出 100 条片子。
但代码里没有隐式缓存。变体的真实形态是:另写一份 .svrun,用 build-record 指向上一条 Build 的某个 Output,再用 satisfy 把它接到当前逻辑输出上。 规划器会剪掉被替换掉的操作,但保留仍然被消费的上游节点。
| 说法 | 代码里的事实 |
|---|---|
| 一条命令出 100 个变体 | 一条命令出一次 Build;100 个变体=100 份 Run 或生成它们的脚本 |
| 复用的是“模板” | 复用的是具名 Output(bld_… + output),要手写两行 |
| 参数化的变量 | 变量是 Source 本身;换主播要改 Prompt 和参考图 |
| 示例里的三个克隆 | 示例 README 明说 swap-host 等是 separate studies,不是同一条流水线的产物 |
我不认为这是虚假宣传,但它的杠杆点和宣传语说的不是同一个:真正的杠杆是“复用已完成的 Output,只重跑下游”,而不是“模板参数化”。这也是为什么它要在示例里强调 64 个无头 Chromium 并发渲染——当 100 个变体共享同一条 A-roll,剩下的工作量几乎全是渲染。
顺带一提,中文 README 写这条片子有“十张 1K 脑腐图”,而当前仓库源码里是 8 个 B-roll 图片请求加 1 张主播图。两者不矛盾,只是不是同一版素材;本文所有计数以 examples/ranking-football/reference.svml 为准。
九、局限
按重要性排:
- 概念密度高。 Source、Recipe、Run、Candidate、Satisfaction、Surface、Facet、Endpoint、Binding、Profile、Result——这套词汇表是为“能力边界清晰”付的代价。第一次读文档的人很容易在第四层就放弃。
- 许可证不是纯 Apache-2.0。 正文叫 Hypit Open Source License,是在 Apache 2.0 上加了三条:不得做多租户托管、不得商业转售、不得移除 CLI 与产物里的名称与 LOGO。自用、给自己的客户做片子都没问题;做成 SaaS 要单独授权。GitHub API 上这个仓库的 license 字段是
NOASSERTION,不是Apache-2.0。 - 生成费用并没有消失。 $1.15 是官方示例口径,取决于你用哪家模型、哪档画质。换更强的视频模型、换更高的分辨率,账单都会变。
- 首次准备不便宜。 Node 22.15+、pnpm 10.33、Python 3.10–3.13、uv、ffmpeg,加一个由
hypit runtime up下载的 Chromium。文档自己提醒:本地推理的初始下载量可能很大,先想清楚要不要走托管。 - “批量”没有内置命令。 100 个变体要自己生成 100 份 Run Source 或写循环脚本,官方文档只讲单次 Build。
- 版权仍然是你的事。 复刻一条爆款的结构不等于拥有它的创意、肖像和音乐授权;示例 README 甚至专门说明球员照片“是真实标识,不是生成的仿冒图”,并建议记录来源。
十、我的判断
我认为 Hypit 真正的贡献,是把视频制作里三个长期靠人的环节各自换成了一个可以检查的东西:
时间从“写下的数字”换成“引用”。 这是“改一句台词不用重做全片”唯一可能的实现方式。任何还想用参数化模板解决这件事的方案,最后都会退回到手写时间轴。
复用从“缓存”换成“显式图”。 拒绝隐式缓存看起来是倒退——多写两行,还要自己记住 build id。但它换来了可解释性:每一次 Build 用到哪些旧产物,全在 .svrun 里写着,不在某个哈希目录的角落里。
成本从“事后账单”换成“提交前的一次查询”。 对一个会被 Agent 反复重跑的系统,这一条比省下来的钱重要。
如果要接着往下做,我会想看两个方向。一是把 selection 从“作者手写”扩展到“检索出来的”——给一段配音,自动找到最该出现 B-roll 的短语,那才是把“锚定在词上”推到极限。二是给 Projection 加评估器:既然每个窗口都是可寻址的,就能算出字幕与语音的对齐误差、B-roll 与台词的语义距离,让“这条片子合不合格”也变成一个可以查询的量。
这和我一直关心的那类工作其实是同一个动作:把最终产物拆成可寻址的中间量,然后在中间量上做观测和干预。只不过在视频里,那个中间量叫“词”。
项目与资料
- 仓库:hypit-ai/hypit
- 官网与文档:hypit.ai · 开发指南 · Run 与 Build
- 本文引用的示例:examples/ranking-football/reference.svml
- 许可证:LICENSE
数据来源:star / fork / 建库时间取自 GitHub REST API(2026-11-18);版本号取自 package.json(0.3.3);成本与服务商取自仓库 README;代码片段取自当前 main 分支的示例源码,未做改写。本文为技术解读,具体能力以项目实际版本为准。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- 麦田(Maitian):平台改版那天,不该让每个用户升级一次
- The Software Engineering Handbook:把工程判断写成一份自由度账本
- Omni LoRA:一个 671 MB 的修正,要背两个任务
- Omni-Quantized:12 个构建,两套布局,省的是显存不是时间
- video-shotcraft:150 个镜头名,就是 Agent 的接口
- Jina-OCR-v1:赢在少写,不在写快
- MNN-Pocket-0.3B:不是把大模型缩小,是从两个预算反推形状
- rust-anything:语言迁移不是翻译,是一场可以判负的比较
- SFT 与 RLHF:教接口,选口味,然后收窄
- Mainline:工程判断该住在 Git 里,不该住在数据库里