MNN-Pocket-0.3B:不是把大模型缩小,是从两个预算反推形状
300。200。173。466。
四个数字,四个量纲:300 MB 峰值内存上限、200 tok/s 的实时交互下限、173 MB 的 INT4 部署体积、466 tok/s 在 iPad Pro M5 上的解码速度。
前面两个是约束,后面两个是结果。而 0.3B 这个参数量,是前两个数字筛出来的,不是拍出来的。
模型是阿里 MNN 团队(淘宝天猫)的 MNN-Pocket-0.3B,Apache 2.0,技术报告 arXiv:2611.12311(2026-11-09 提交)。截至本文核对时,Hugging Face 上主模型 365 个 like,模型卡列了六个变体。
端侧模型的文章很容易写成参数罗列。这篇只讲一件事:当预算先于结构被定死,架构、词表、量化和内核会分别被逼成什么样子。 顺带算一笔论文没写、但每个想在手机上跑 32K 的人都会撞上的账。
一、它是什么:一个家族,六个变体
先把“模型”这个词拆开,因为这个项目发布的是一组东西,不是一个文件。
| 变体 | 形态 | 用途 |
|---|---|---|
-Base | BF16 | 预训练基座,给继续预训练用 |
-SFT | BF16 | 只做完监督微调的中间检查点,官方说留给研究和消融 |
0.3B(主模型) | BF16,723 MB | 通用指令微调版,Transformers 可直接加载 |
-GGUF | F16 / Q8_0 / Q4_1 | 给 llama.cpp:前两个来自 BF16,Q4_1 来自 QAT |
-MNN | INT4 W4A16,173 MB | 真正进 App 的那一个 |
-Dec | LoRA + Pointer Head | 非自回归决策模型,一次前向出结果 |
架构参数如下:
| 项目 | 值 |
|---|---|
| 参数量 | 约 300M(稠密) |
| 层数 | 28 |
| Hidden size | 896 |
| 注意力 | 14 个 head,GQA 2 个 KV head,head_dim 64 |
| FFN | 2560,SiLU |
| 位置数 | 40,960(部署支持 32K) |
| 词表 | 65,536,输入输出 embedding 共享 |
| 精度 | 原生 BF16;部署 INT4 W4A16(group 64) |
| 语言 | 中文、英文 |
顺手把“300M”这个数字验一下,因为它决定后面所有的账。每层参数 ≈ 注意力 $896\times896 + 2\times(896\times128) + 896\times896$ ≈ 1.835M,加 MLP $3\times896\times2560$ ≈ 6.881M,合计 8.72M;28 层是 244M;再加大约 58.7M 的词表(65536 × 896,输入输出共享只算一次),总共 303M。
记住 58.7M 这个数,第四节会用到它。
官方对能力的表述很克制:同规模里平均分最好,指令遵循超过若干 0.5B 模型;不推荐做高级数学和长链条代码生成这类推理密集任务。这句话值得照抄进任何一个选型文档。
二、规模不是选出来的,是筛出来的
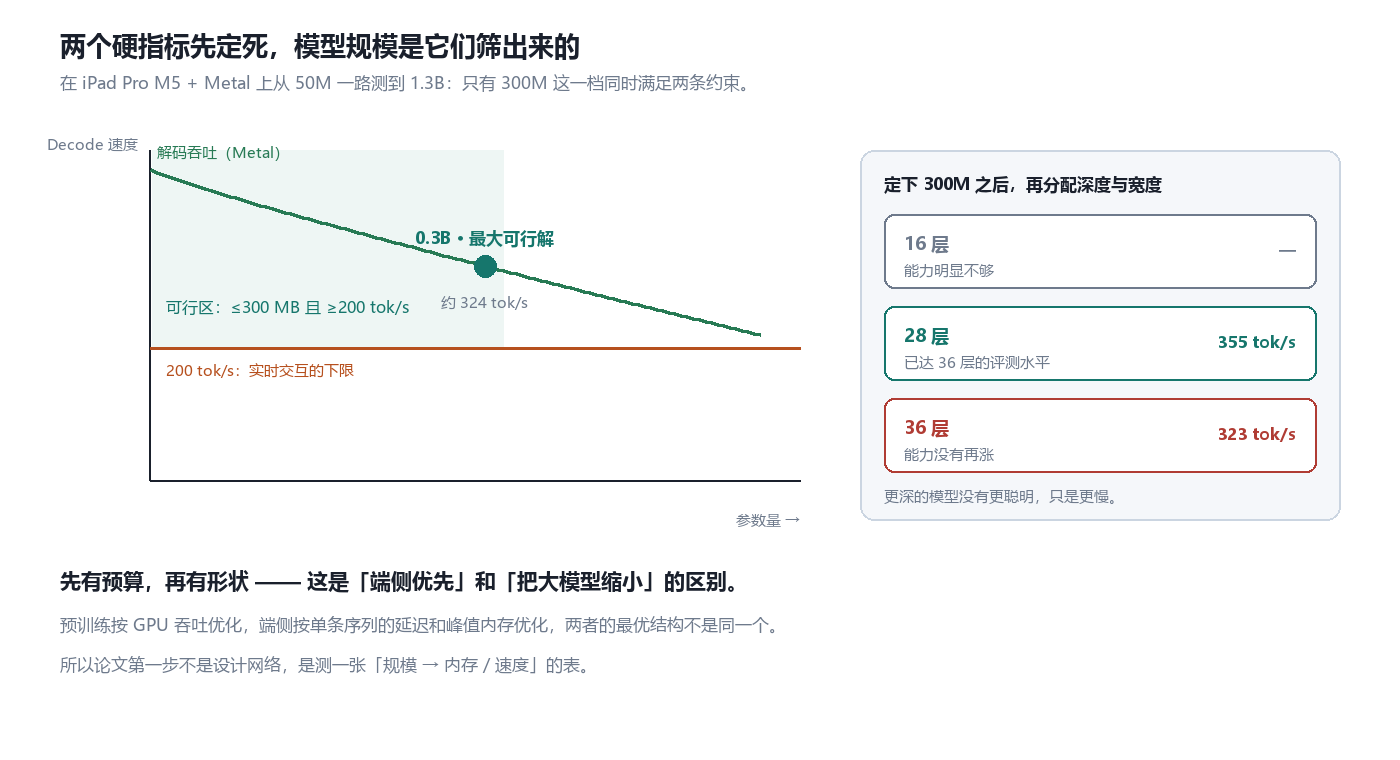
横轴参数量、纵轴解码速度;可行区在两条约束围出的左上角,0.3B 正好压在边界上。形状是示意。
论文第一步不是设计网络,是测一张表:把架构从约 50M 缩放到约 1.3B,每一个候选都放到 iPad Pro M5 上用 MNN 的 Metal 后端跑,同样的输入输出长度(256 token),记录峰值内存和解码速度。
结果很单调:模型越大,峰值内存越高,解码越慢。于是两条约束画出一条线——
- 峰值内存不能超过 300 MB(消费级 App 的常驻预算);
- 解码不能低于 200 tok/s(实时交互的下限,人眼对逐字输出的容忍度大约在这个量级)。
0.3B 是同时满足这两条的最大候选。 这不是“我们觉得 0.3B 合适”,而是“再大一点就出界”。
定下规模之后,才轮到第二层:同样 300M 参数,深度和宽度怎么分?论文比了 16、28、36 层三种配置:
| 配置 | 能力 | 解码速度 |
|---|---|---|
| 16 层 | 明显不足 | — |
| 28 层 | 已达 36 层的评测水平 | 355 tok/s |
| 36 层 | 没有继续提升 | 323 tok/s |
16 → 28 层,训练损失明显下降、评测明显变好,内存和速度只付了一点;28 → 36 层,能力不涨,解码从 355 掉到 323。
多出来的 8 层没有让模型更聪明,只让它更慢。 这句话是整篇报告里我最喜欢的一处工程判断。
三、词表:砍掉的 87K 个 token 去哪了
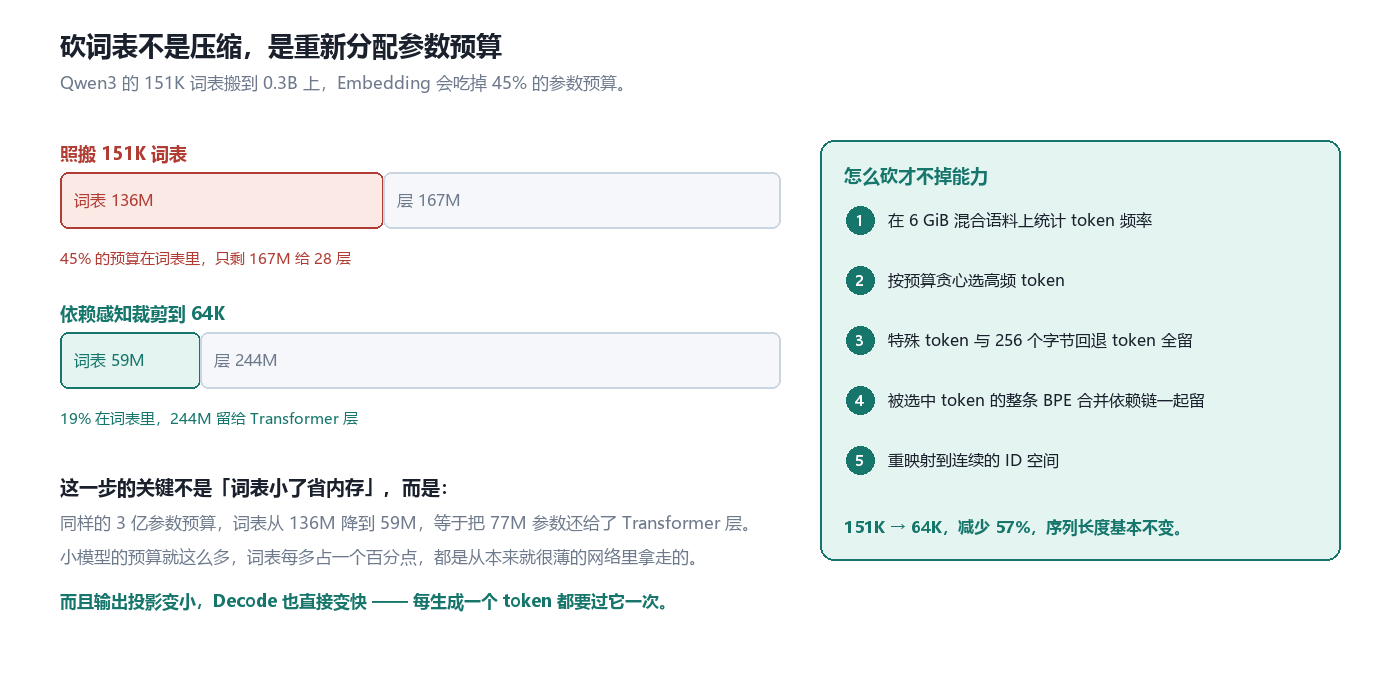
两根条都是 303M 的预算;左边那根里,词表占 136M,只剩 167M 给 28 层。
这是我认为最值得抄的一个设计,因为它解决的是一个小模型独有的问题。
词表在百亿参数模型里是零头,在 0.3B 上是主项。Qwen3 的词表约 151K,对应的 embedding 是 $151{,}000\times896\approx136M$——占 303M 预算的 45%。而 MNN-Pocket 的 backbone 是从 Qwen3 稠密版缩下来的,直接继承词表,就等于让一个 300M 的模型拿一半预算去存“字表”。
所以他们把词表砍到 64K。但砍法很讲究,因为重新训一个 tokenizer 会引入初始化不匹配和分词不稳定:
- 用 6 GiB 覆盖预训练、SFT、指令数据的混合语料,统计 token 频率;
- 按预算贪心选高频 token;
- 所有特殊 token 和 256 个字节回退 token 必须保留(否则任何未知字符都会变成
<unk>); - 被选中 token 的整条 BPE 合并依赖链一起保留——这一条是“依赖感知”的关键,因为一个 token 的切法依赖它的父级合并规则,只留叶子会切出非法序列;
- 重映射到连续的 ID 空间。
结果:151K → 64K,减少约 57%,中文英文代码数学的分词效率基本不变。
账算得很清楚:embedding 从 136M 降到 58.7M,等于把 77M 参数还给了 Transformer 层。而且输出投影同步变小——每生成一个 token 都要过它一次,所以这一步也直接换来解码速度。
在端侧,词表大小不是分词质量问题,是参数预算问题。 这个视角在云端模型上几乎不会出现。
四、4.1 万亿 token 分四段,然后三刀
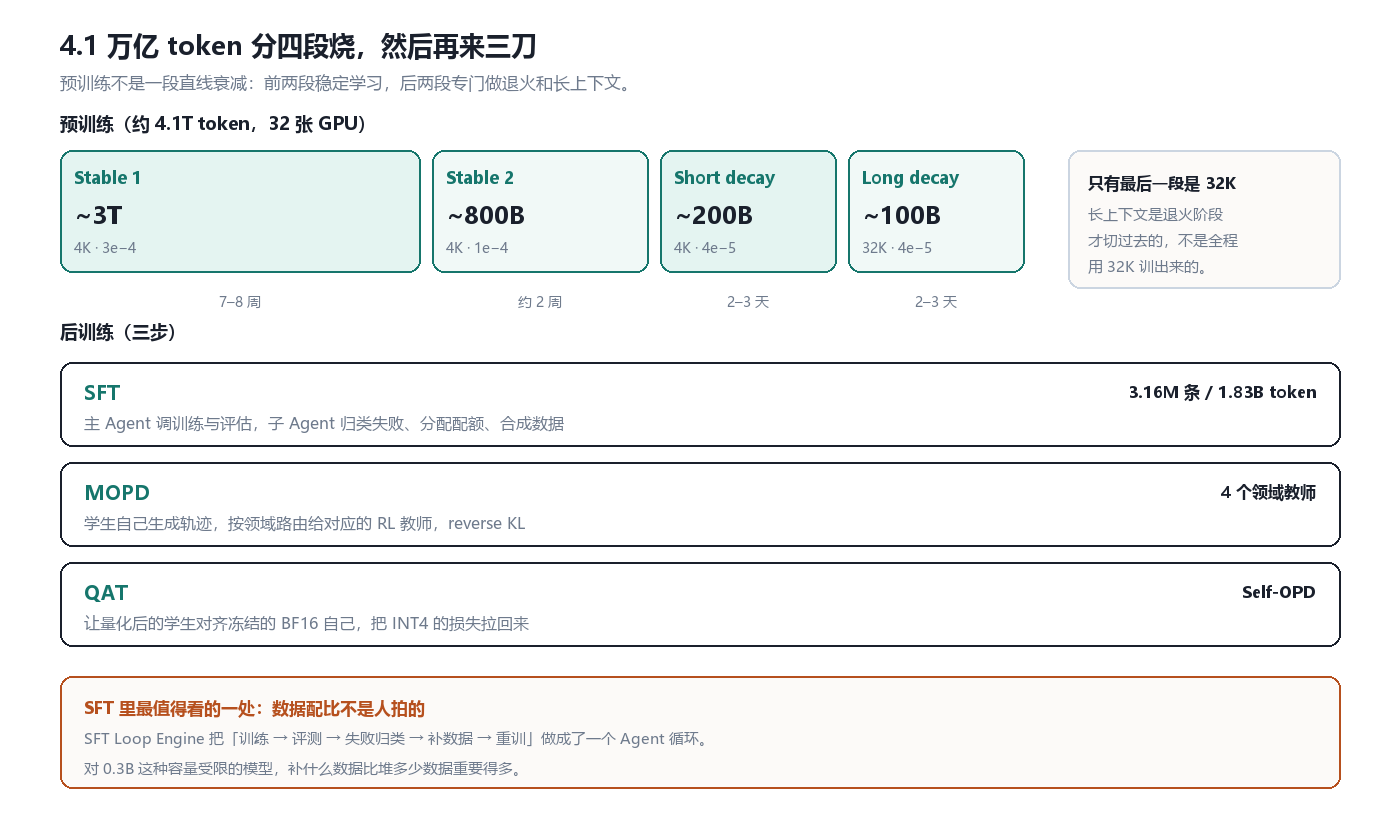
前两段稳定学习,后两段专做退火;只有最后一段才切到 32K 上下文。
预训练不是一条直线衰减到结束,而是四段,每段有自己的 token 预算、学习率和上下文长度:
| 阶段 | token | 上下文 | 峰值学习率 | 时长(32 卡) |
|---|---|---|---|---|
| Stable 1 | ~3T | 4,096 | 3e−4 | 7–8 周 |
| Stable 2 | ~800B | 4,096 | 1e−4 | 约 2 周 |
| Short decay | ~200B | 4,096 | 4e−5 | 2–3 天 |
| Long decay | ~100B | 32,768 | 4e−5 | 2–3 天 |
合计约 4.1T token。注意最后一行:32K 不是从头训的,是最后 100B token 才把上下文切过去的。这也解释了为什么“支持 32K”和“32K 训过”是两件事——它的 32K 只见过总预算的 2.4%。
更值得说的是数据工程。他们没有把质量、难度、信息密度这些维度压成一个分数,而是做成五维联合分桶:domain(领域)、quality(质量)、knowledge density(知识密度)、difficulty(难度)、style(风格)。分桶之后,语料的最小调度单位就是“某个领域的某个质量档 × 某个难度档”,而不是“某个数据源”。
配比怎么定?两步:
- 代理跑 + 更新插值:在同一检查点上跑多个候选配方的短程训练,得到各自的参数增量 $\Delta\theta_i$,然后线性插值 $\tilde\theta=\theta_0+\sum_i\alpha_i\Delta\theta_i$ 粗筛大片空间;
- 真训细搜:插值只是近似,最终候选必须在真实混合数据上训练、再调采样权重和优化设置。
用便宜的近似去筛空间,用贵的真训去定结论——这个两层结构比“我们精心设计了数据配比”要诚实得多。
后训练三步:
SFT:3.16M 条、1.83B token。代码 30.6%、知识问答 26.4%、数学 24.3%、创意写作 13.7%、指令遵循只有 1.29%。最有意思的是 SFT Loop Engine:主 Agent 调训练和评估技能,子 Agent 分别做失败归类、配额分配、以及合成/去重/查泄漏,然后把补出来的数据喂回下一轮。数据配比不是人拍的,是按模型自己的失败分布迭代出来的。
MOPD(多教师 on-policy 蒸馏):四个领域专家教师(知识、指令遵循、数学、代码)。学生在自己生成的轨迹上被评估,按领域路由给对应教师,用 reverse KL 蒸馏。on-policy 的意义在于:学生会在自己会犯的错上被纠正,而不是在自己根本不会走的路上被喂标准答案。
QAT:这一步最关键,下一节单独说。
五、INT4 的账:-0.41 分是怎么换来的
先算体积。3 亿参数:BF16 是 2 字节/参数 ≈ 600 MB 理论值,官方给的完整 BF16 模型是 723 MB(含词表和额外结构);INT4 是 0.5 字节/参数 ≈ 150 MB 理论值,实际权重文件 171 MB,加上计算图 0.95 MB、分词器 1.7 MB、配置若干 KB,合计 173 MB。
多出来的部分是量化尺度、零点和 group 元数据——group size 是 64,也就是每 64 个权重共享一组 scale。
压缩率约 4.2 倍。但真正的问题不是能压多少,是压完还剩多少能力:
| 版本 | 11 项基准平均 |
|---|---|
| BF16 | 50.00 |
| INT4(QAT) | 49.59 |
只掉 0.41 分。 单项看有涨有跌:C-Eval 反而从 38.86 涨到 40.27,IFEval 从 73.20 涨到 74.12,但 GSM8K 从 54.36 掉到 52.84。0.41 是平均,不是每一项都小。
这个结果靠的是 QAT,而且是自蒸馏式的 QAT(论文叫 Self-OPD):训练时让量化后的学生去对齐冻结的 BF16 自己,而不是用一堆通用数据做校准。
这个设计我觉得挺妙。量化带来的误差是“同一个模型在低精度下的行为漂移”,那么最合适的老师就是它自己的高精度版本——分布完全对得上,不需要外部数据覆盖,也不会引入新的偏置。
顺带一个和上一篇的对照:那篇讲 RLHF 的核心动作是“选择”让分布收窄;这里 Self-OPD 用的是同一套蒸馏机制,方向却相反——把量化后跑偏的分布拉回教师身边。同一个工具,可以收窄,也可以拉回。
六、466 tok/s 该怎么读
官方给的 INT4 实测(512 token 上下文):
| 设备 | 后端 | Prefill | Decode |
|---|---|---|---|
| iPad Pro M5 | Metal | 8,721 tok/s | 466 tok/s |
| iPad Pro M5 | CPU | 2,228 tok/s | 231 tok/s |
| Snapdragon 8 Gen 5 | OpenCL | 3,403 tok/s | 138 tok/s |
| Snapdragon 8 Gen 5 | CPU | 930 tok/s | 251 tok/s |
三件事必须一起读,否则这张表会被误用:
第一,Prefill 和 Decode 是两回事。 前者是处理输入(矩阵乘,算力密集,能吃满 GPU),后者是逐 token 生成(访存密集,受带宽限制)。8,721 和 466 差 19 倍,不是笔误。
第二,测试条件是 512 token 上下文。 上下文一长,KV cache 变大、注意力开销上升,466 会掉。论文只说“512-token context”,没说 8K、32K 时是多少。
第三,后端差异很大,而且不是单调的。 有意思的是 Snapdragon 8 Gen 5 上 CPU 的 Decode(251)反而比 OpenCL(138)高,而 Prefill 是 OpenCL 领先(3,403 vs 930)。原因不难猜:小模型逐 token 生成时,数据搬运和内核启动的开销可能超过并行收益。“开 GPU 一定更快”在端侧不成立。
另外报告里提了可选的推测解码,收益取决于设备、后端和工作负载——这句话翻译过来就是:别指望它,先测。
七、173 MB 之外:32K 上下文的另一笔账
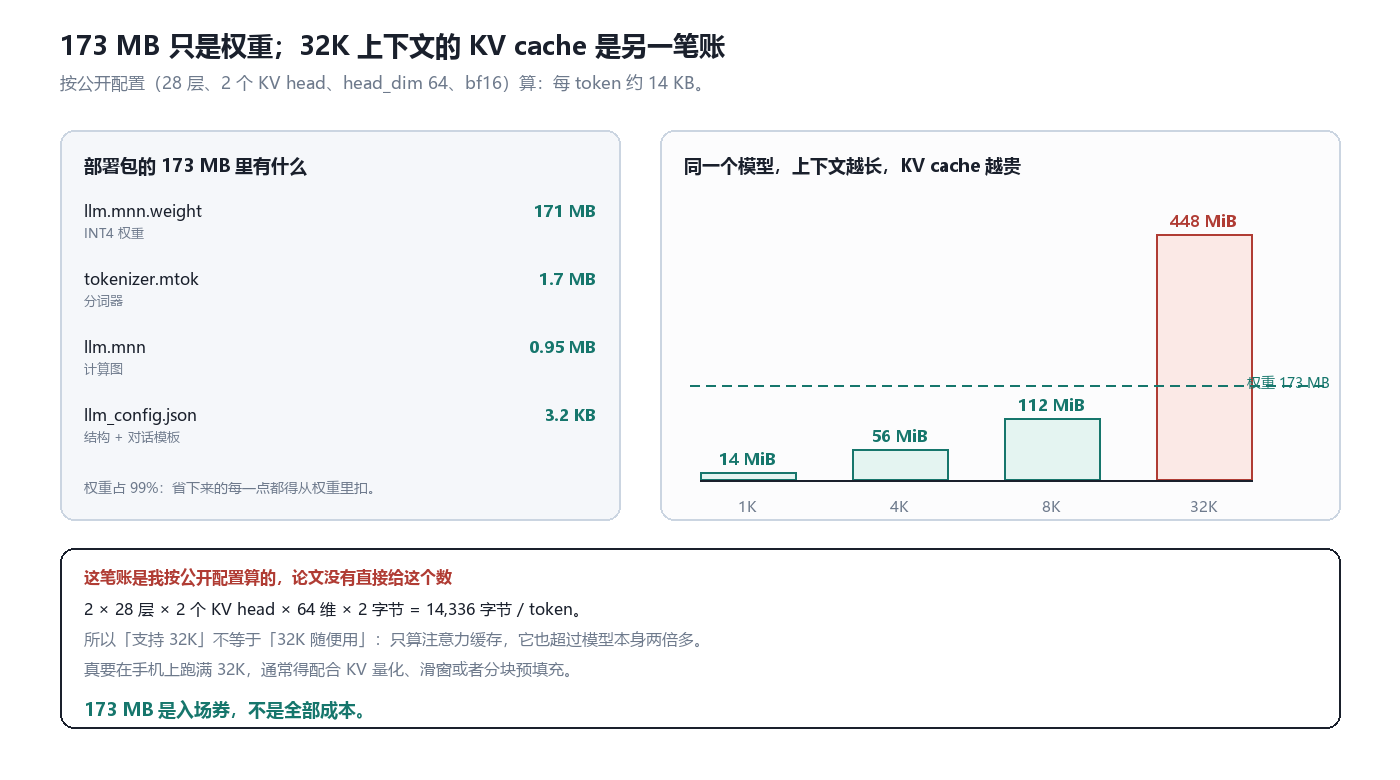
这笔账是我按公开配置算的,论文只标了“支持 32K”,没有给这个数字。
这是本文唯一一处我自己算的数,因为它决定了“32K 上下文在手机上到底能不能用”。
KV cache 每 token 的字节数是:
\[2 \times L \times H_{kv} \times d_{head} \times \text{bytes} = 2 \times 28 \times 2 \times 64 \times 2 = 14{,}336\ \text{bytes}\]也就是每 token 约 14 KB。乘上上下文长度:
| 上下文 | KV cache(bf16) |
|---|---|
| 1K | 14 MiB |
| 4K | 56 MiB |
| 8K | 112 MiB |
| 32K | 448 MiB |
对比一下:模型权重才 173 MB。跑满 32K,光注意力缓存就是权重的 2.6 倍。
所以“173 MB 的模型能跑在手机上”和“173 MB 的模型能在手机上处理 32K 文档”是两个不同的命题。后者通常需要额外手段:KV 量化到 INT8 能减半(约 224 MiB),滑窗或分块预填充能压峰值,但都会改变行为。
GQA 在这里帮了大忙——2 个 KV head 而不是 14 个,省了 7 倍。如果没有 GQA,同样配置每 token 是 100 KB,32K 就是 3.1 GB,直接出局。架构选择在端侧的第一受益人不是你看到的参数量,是你没看到的缓存。
八、评测:平均第一,但有一项必须读进去
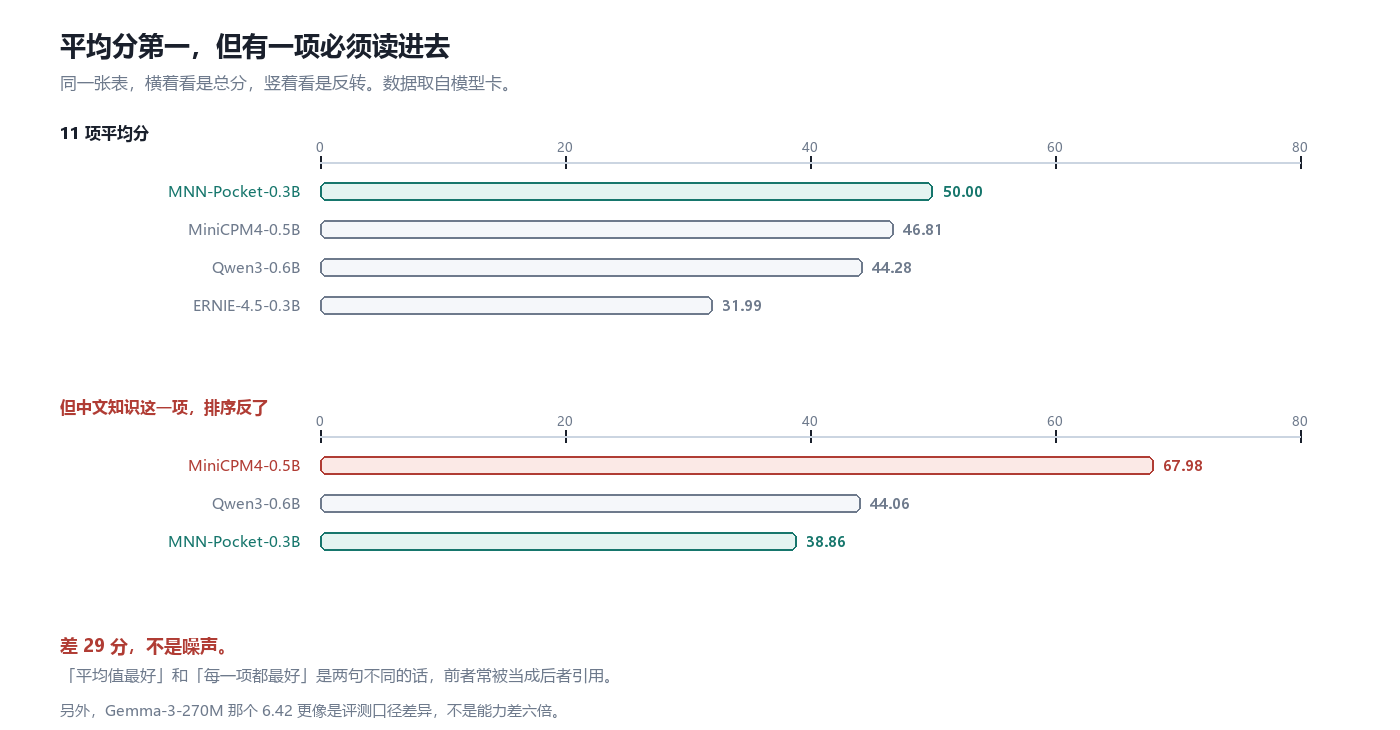
同一张表横着看是总分,竖着看是反转。
11 项基准的平均分:
| 模型 | 参数量 | 平均 |
|---|---|---|
| MNN-Pocket-0.3B | 0.3B | 50.00 |
| MiniCPM4-0.5B | 0.5B | 46.81 |
| Qwen3-0.6B | 0.6B | 44.28 |
| ERNIE-4.5-0.3B | 0.3B | 31.99 |
| LFM2.5-350M | 0.35B | 31.28 |
| Hunyuan-0.5B | 0.5B | 31.22 |
| SmolLM2-360M | 0.36B | 18.43 |
但看单项,中文知识这两项是反的:C-Eval 上 MiniCPM4 是 67.98,MNN-Pocket 是 38.86;CMMLU 是 66.04 对 40.11。差了将近 29 分。
MNN-Pocket 赢在哪里?IFEval 73.20(MiniCPM4 52.13)、IFEval-zh 74.59(30.30)、GSM8K 54.36(42.46)、MATH500 35.40(23.00)。也就是说它把预算押在了指令遵循和数学推理上,而不是中文百科知识。
这不算缺点,是取舍。但如果你的场景是中文知识问答,只看“平均分第一”会选错。
还有一个数字要单独说:Gemma-3-270M 的平均分是 6.42,C-Eval 6.84、GSM8K 0.00、HumanEval 0.00。这个量级不像能力差距,更像评测口径不兼容(模板、答案抽取或语言设置没对齐)。我没有证据,只能说:遇到这种量级的异常值,先怀疑表格,再怀疑模型。
九、Dec:一次前向做完决策
除了自回归语言模型,还有一个 -Dec 变体:LoRA adapter + pointer head,一次前向直接输出决策,不逐 token 生成。
为什么这件事值得单独提?因为 Agent 系统里大量调用根本不需要生成自然语言:
输入:用户要把文件移走
候选:DELETE / ARCHIVE / RESTORE / IGNORE
输出:ARCHIVE
这类“从有限动作空间里选一个”的任务,用自回归模型做要付出完整的解码成本:几十个 token 的延迟,换来一个词。而指针式(pointer)输出可以把这件事变成一次分类。
对端侧 Agent 来说,这是性价比很高的一条路:不是所有智能都需要以文字的形式输出。
代价也很清楚:它只能做受限选择,没法解释、没法组合、没法处理开放输出。它是同一份权重上的另一个头,不是通用能力的替代。
十、局限
按重要性排:
- 0.3B 是天花板,不是起点。 官方自己写了不推荐高级数学和长链条代码。MATH500 35.40、MBPP 38.20 这两个数就是边界线。
- 所有性能数字都是官方自测,单机单后端(iPad Pro M5 / Snapdragon 8 Gen 5)。没有第三方复现,也没有 Android 真机长时间跑的温度与功耗曲线——而后者才是产品体验的关键。
- INT4 版本与运行时版本耦合。 模型卡明确写了:tied-embedding 的 INT4 布局要求运行时与导出版本同族,版本不匹配会直接
Load module failed。这是部署时最容易踩的坑。 - 32K 的实际可用性受 KV cache 限制(第七节),且没有官方在长上下文下的速度数据。
- QAT 是训练期决策,事后补不了。 想换词表大小、换 group size,都要重新过一遍 QAT。
- 评测口径不统一。 Gemma 那个 6.42 提醒你:跨模型对比表的可信度,取决于每一列是不是用同一套 harness 跑出来的。
- 家族里只有主模型有完整文档,GGUF 和 Dec 的细节要靠模型卡拼。
十一、我的判断
这个项目最值得学的不是 173 MB,而是它把“部署预算”写成了可执行的验收指标。
大多数端侧模型论文的开头是“我们设计了一个轻量模型”;这篇的开头是“300 MB、200 tok/s,然后我们测了从 50M 到 1.3B 的每一个候选”。差别在于:前者无法被反驳,后者可以被一张表推翻。
顺着这个思路,我认为有三件事可以整体搬走:
第一,把约束写成数字,再让架构去满足它。 “轻量”“高效”“适合端侧”都不是指标。300 MB 和 200 tok/s 是。有了它,规模选择、深度选择、词表大小、量化方案全都变成了同一个优化问题里的变量,而不是四个独立的经验决定。
第二,词表是端侧最被低估的杠杆。 151K → 64K 换来 77M 参数和更小的输出投影,这个操作在云端模型上收益微乎其微,在 0.3B 上是 25% 的参数预算。判断标准很简单:词表参数占模型的比例超过 20%,就该考虑剪。
第三,QAT 要用自己的 BF16 当老师。 量化的本质是分布漂移,那么最贴合的教师就是漂移前的自己。这比用通用校准集更稳,也不需要额外数据。
如果要给一个具体的下一步建议,我会选这个:让官方补一张“上下文长度 → 解码速度 / 峰值内存”的曲线。 现在只有 512 token 一个点,而 32K 是主打卖点之一。这条曲线决定了它能不能做“本地文档问答”这类真正需要长上下文的产品,而不是只能做短指令。
最后回到开头那四个数字。300、200 是约束,173、466 是结果——但中间那个 0.3B,才是整篇报告真正的结论:在端侧,模型大小不是一个设计自由度,是一个被解出来的值。
项目与资料
- 主模型(BF16,723 MB):taobao-mnn/MNN-Pocket-0.3B
- 部署版(INT4,173 MB):MNN-Pocket-0.3B-MNN
- 基座:MNN-Pocket-0.3B-Base
- 技术报告:arXiv:2611.12311(MNN Team,2026-11-09)
- 推理框架:alibaba/MNN
- 许可证:Apache 2.0
数据来源与核对:模型参数、体积、速度表、11 项基准与 INT4 / BF16 对比取自 Hugging Face 模型卡(主模型与 -MNN 变体)与论文 HTML 版;四阶段预训练的超参、词表裁剪流程、MOPD 与 QAT 的描述取自论文第 2–4 节。第七节的 KV cache 数字是我按公开配置推导的,论文未给,已在图内标注。文中示意图均为重绘,曲线形状为示意而非实测。核对时间 2026-11-18。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- rust-anything:语言迁移不是翻译,是一场可以判负的比较
- SFT 与 RLHF:教接口,选口味,然后收窄
- Mainline:工程判断该住在 Git 里,不该住在数据库里
- Intent-System:它不信任 AI,所以把流程搬出 AI 的上下文
- vLLM:每次重写,改的都是同一本显存账
- Diagram Design:50 种图表是目录,能拒绝你的检查才是产品
- gpu-unlock:GeForce 的半速矩阵算力,写死在八个 4 位字段里
- Octop:单进程是它的地基,也是它的天花板
- VoiceStudio:把 ElevenLabs 搬回本地之后,账单换成了许可证
- DroidDeck:手机跑 PC 游戏不难,难的是让 Android 相信自己正在当主机