SFT 与 RLHF:教接口,选口味,然后收窄
SFT 和 RLHF 常被讲成两件事:前者教模型「怎么回答」,后者教模型「哪种回答更好」。
这个说法没错,但它掩盖了一个更关键的事实:这两步在数学上做的是同一件事——把概率质量收拢。
SFT 抬高示范答案的似然,RLHF 抬高奖励模型高分答案的似然。两者都没有任何一项在说「请保留其他说得通的回答」。理解了这一点,再看「为什么不同公司的模型越来越像」,就不再像巧合。
这篇文章按这个线索走一遍:先看基础模型缺什么,再看 SFT 到底在算哪些 token 的账,然后拆 RLHF 的三步与 DPO 的等价改写,最后回到趋同这个问题,用三条实证把它说清楚,也给出一组可以做的实验。
一、四个阶段,改的都是同一个形状
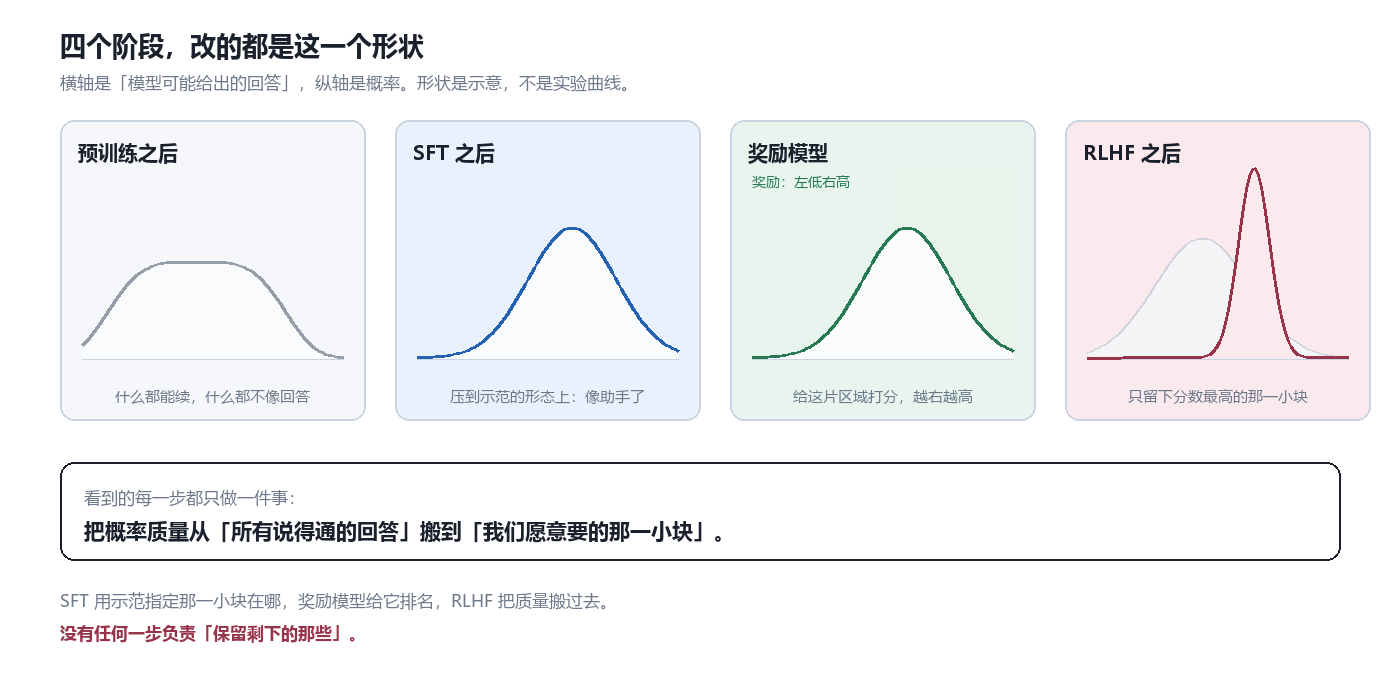
横轴是「模型可能给出的回答」,纵轴是概率;形状是示意,不是实验曲线。
先把这条流水线摆清楚,因为后面每一节都只是它的细节:
| 阶段 | 输入 | 改了分布的什么 |
|---|---|---|
| 预训练 | 海量文本 | 学出一个很宽、很平的分布 |
| SFT | 问题 + 示范答案 | 收窄,并挪到示范的形态上 |
| 奖励模型 | 成对比较 | 不改分布,只给分布打分 |
| RLHF / DPO | 奖励 + 参考模型 | 只留下分数最高的那一小块 |
关键在最后一行。没有任何一步负责「保留剩下的那些」。 多样性不是被压制的,是从一开始就不在目标函数里。
二、基础模型缺的不是知识,是接口
一个刚预训练完的模型,你输入「如何设计一个数据库」,它可能续写成一篇维基条目,可能吐出一段建表语句,也可能接着写「如何设计一个编译器」。它什么都会一点,但不知道你现在要的是哪一种。
这一点有一个很干净的证据。LIMA(arXiv:2305.11206)只用了 1,000 条精挑的「问题 + 回答」做监督微调,模型是 65B 的 LLaMA,不碰强化学习,也不训奖励模型。结果在受控人类评测里:对比 GPT-4,43% 的回答被认为相当或更好;对比 Bard 是 58%,对比 DaVinci003 是 65%。
作者从这组数字得出的结论,比「小数据也能对齐」更重要:
大模型的知识几乎全部来自预训练,微调只需要教会它怎么把已有的东西拿出来。
所以 SFT 学的不是知识,是接口:格式、结构、语气、什么时候该给代码、什么时候该收尾。这也解释了为什么它便宜——它改的是「表达方式」这一层很薄的参数,不是把知识重新灌一遍。
三、SFT:一次带掩码的继续预训练
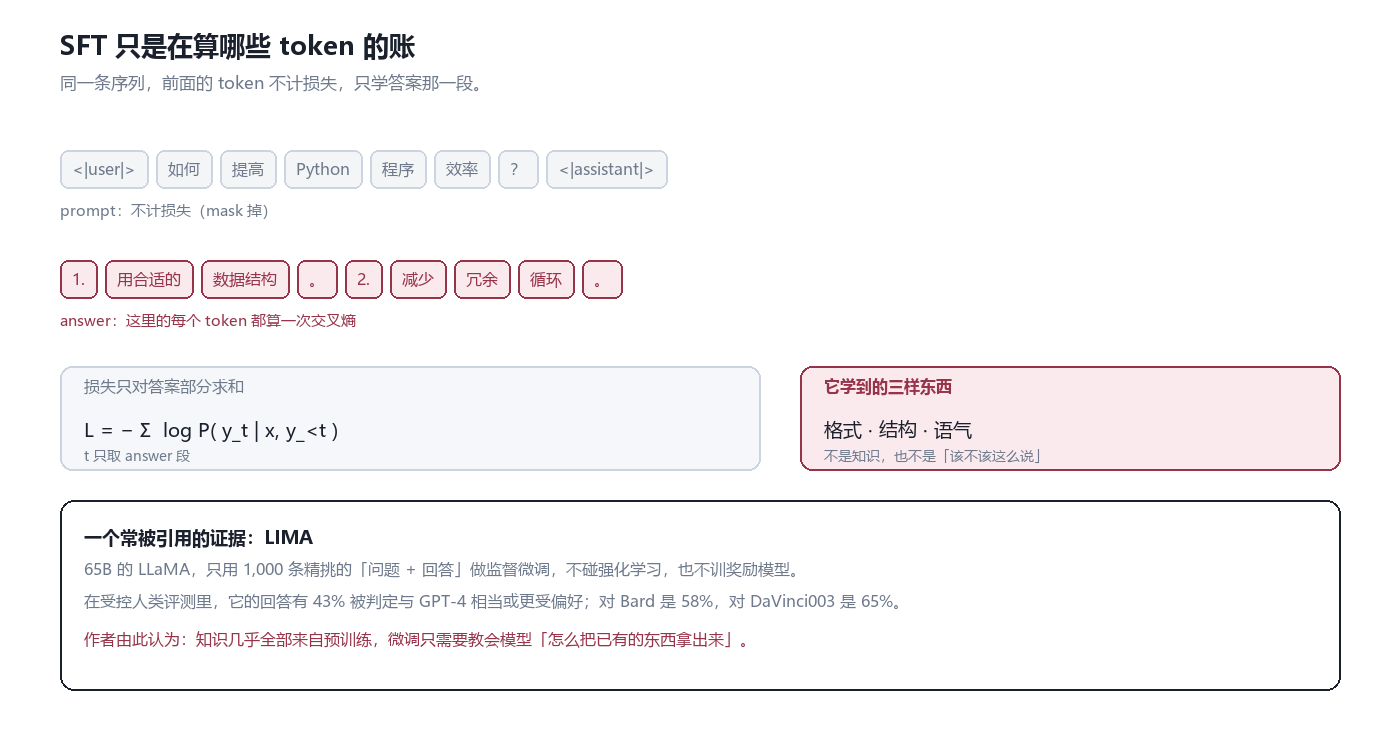
同一条序列,前面的 token 被 mask 掉,只对答案那一段算交叉熵。
SFT 的实现细节里,唯一容易被忽略但很关键的一点是:它不是把整条序列都拿来算损失。
输入拼起来大概是 <|user|> 如何提高 Python 程序效率?<|assistant|> 1. 用合适的数据结构。…,训练时只对 <|assistant|> 之后的 token 计损失。否则模型会同时学习「怎么提问」,那是浪费,也可能引入奇怪的倾向。
目标函数还是交叉熵,只是求和范围变了:
\[L_{\mathrm{SFT}} = -\sum_{t \in \text{answer}} \log \pi_\theta(y_t \mid x, y_{<t})\]对每个答案 token,模型输出一个在整个词表上的概率分布,我们只看它给「标准答案里的那个 token」打了多少概率,取负对数,求和,反向传播。
这就是全部的机制。 没有偏好,没有比较,没有奖励。它只是在说:请让这段文字在你的分布里更可能一些。
四、SFT 的三个隐性成本
第一,数据分布就是性格。如果你的一万条示范里 8,000 条强调稳妥、1,500 条强调创新、500 条鼓励激进,模型学到的不是「三种风格都会」,而是「稳妥最安全」。这不是模型在推理,这是最大似然估计的算术。
第二,风格可以学,能力学不来。这一条有个更尖锐的证据:Gudibande 等人的 The False Promise of Imitating Proprietary LLMs(arXiv:2305.15717)系统比较了「模仿强模型的输出」与「自己预训练」,结论是模仿能追上风格,追不上能力。LIMA 从另一侧说明了同一件事:微调只负责把已有能力调出来。
第三,熵会下降。SFT 训久了,模型对同一个问题的输出会越来越固定。这是好是坏取决于场景:客服 FAQ 里是好事,头脑风暴里是灾难。但这个下降是训练目标的直接后果,不需要任何额外解释。
到这里,SFT 的问题已经很清楚了:它只能朝「示范」收敛,没法表达「A 比 B 好一点,但 C 也不错」。 现实里大部分有价值的问题,恰恰是后者。
五、RLHF 第一步:把「好不好」变成「哪个更好」
于是有了偏好数据。
同一个问题采样两个回答,让标注员说哪个更好。注意这里的关键设计:人不给绝对分数,只给相对顺序。 给绝对分数需要一套跨标注员一致的量表,实际上做不到;给相对顺序只需要「这两个里我选这个」,一致性高得多。
有了成对数据,就能套 Bradley-Terry 模型,把「排序」变成一个可训练的似然:
\[P(y_w \succ y_l \mid x) = \sigma\big(r_\phi(x, y_w) - r_\phi(x, y_l)\big)\]其中 $y_w$ 是被偏好的回答(win),$y_l$ 是被拒绝的(lose),$r_\phi$ 就是奖励模型,$\sigma$ 是 sigmoid。
这个式子的意思是:两个回答的分数之差,经过 sigmoid,就是「A 比 B 好」的概率。 训练奖励模型的损失,就是让这个概率尽量贴近标注结果:
\[L_{\mathrm{RM}} = -\mathbb{E}_{(x, y_w, y_l)}\Big[\log \sigma\big(r_\phi(x,y_w) - r_\phi(x,y_l)\big)\Big]\]到这一步,人类偏好被压缩成了一个标量函数。
六、第二步:奖励模型学的是偏好,不是正确
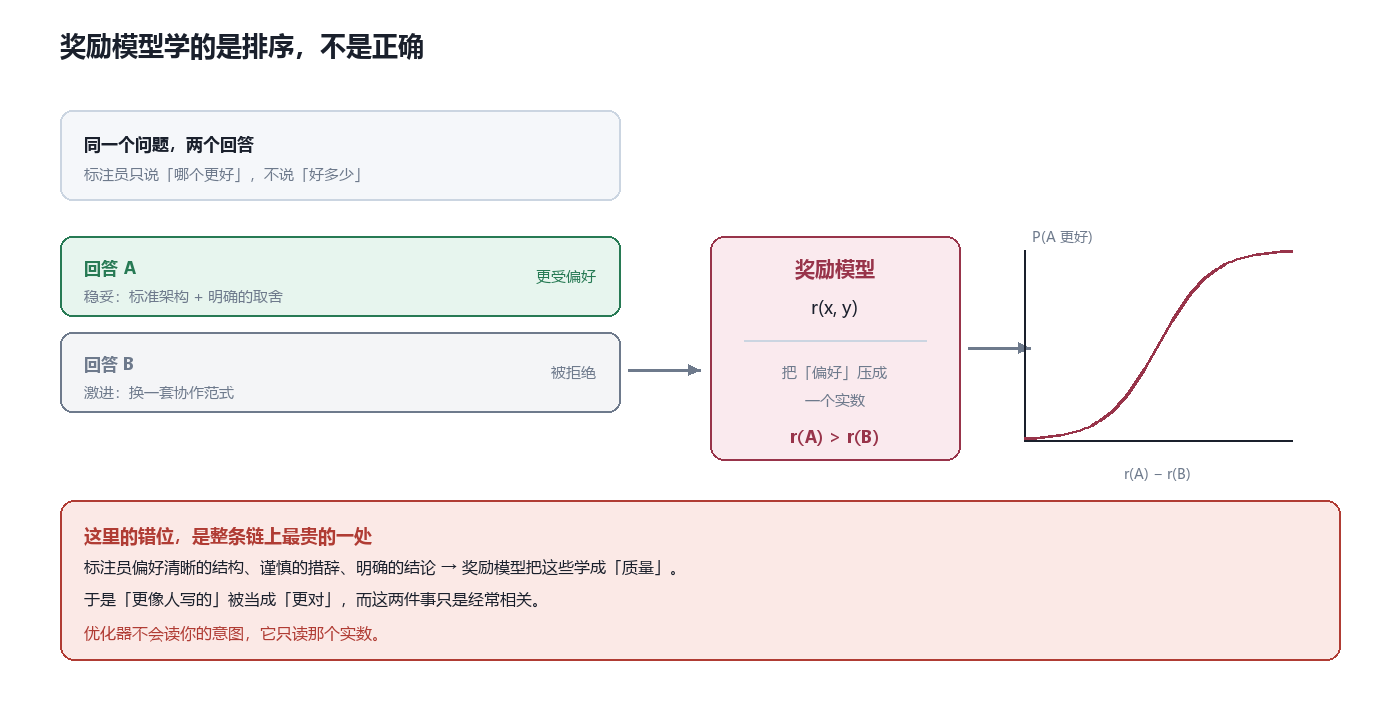
它只负责排序:给定两个回答,说哪个分更高。它不知道绝对真理长什么样。
这是整条链上最贵的一处错位。
标注员偏好清晰的结构、谨慎的措辞、明确的结论、不极端的判断。这些确实是好回答的常见特征,所以奖励模型把它们学成「质量」。于是「更像人写的」慢慢被当成「更对」——而这两件事只是经常相关,不是同一件事。
一个具体的后果是长度偏置:人类标注员倾向于给更详细、更长的回答更高分,奖励模型学到「长 = 好」,RL 阶段模型就学会啰嗦。这不是模型在骗人,它只是忠实优化了你给它的那个实数。
更麻烦的是,这个错位会随优化强度放大。Gao、Schulman、Hilton 的 Scaling Laws for Reward Model Overoptimization(arXiv:2210.10760)把这件事量成了曲线:随着策略离初始模型越来越远,代理奖励单调上升,真实质量先升后降。这就是 Goodhart 定律在 RLHF 里的具体形状。
七、第三步:PPO 与 KL 惩罚
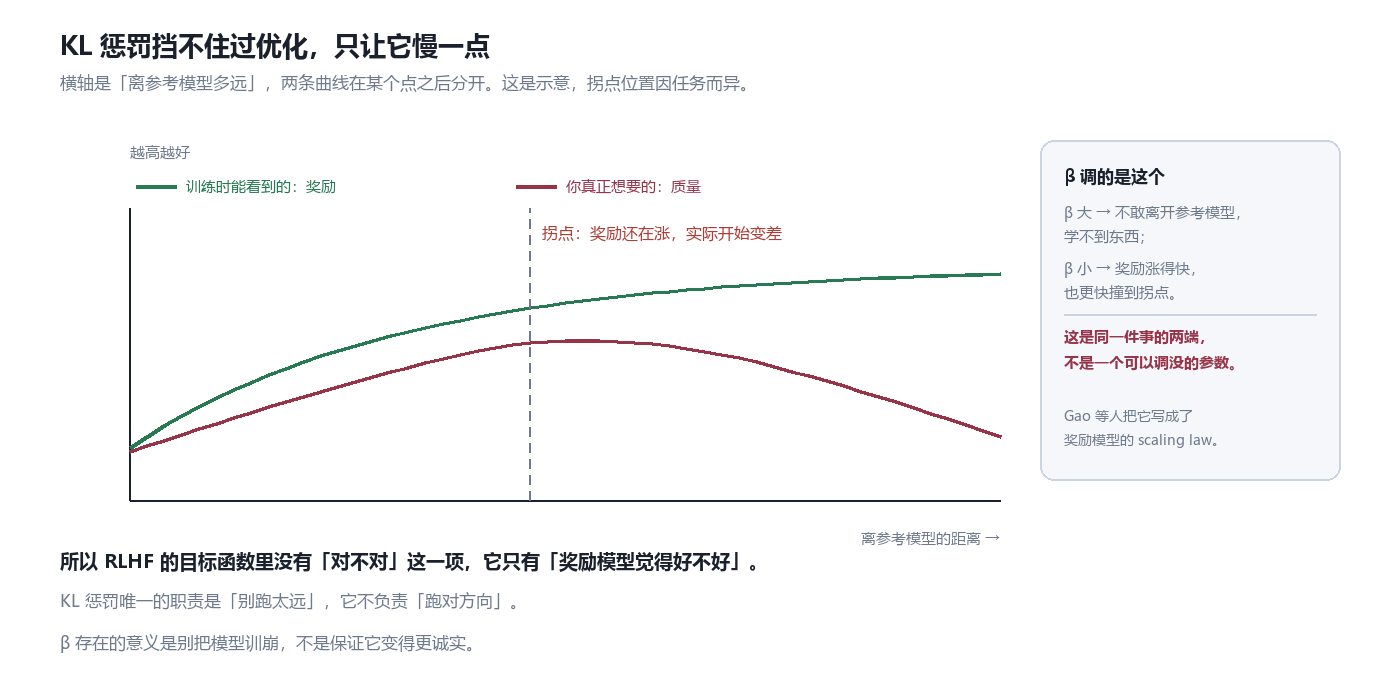
两条曲线在拐点之后分开:训练时你能看到的只有绿色那条。这是示意,拐点位置因任务而异。
有了奖励模型,就可以做强化学习。经典做法(InstructGPT,arXiv:2203.02155)是用 PPO 优化:
\[\max_{\theta}\ \mathbb{E}_{x,\, y \sim \pi_\theta(\cdot \mid x)}\big[r_\phi(x,y)\big] - \beta\, D_{\mathrm{KL}}\big(\pi_\theta \,\|\, \pi_{\mathrm{ref}}\big)\]逐项解释:
- $r_\phi(x,y)$:奖励模型给的分数,要最大化;
- $D_{\mathrm{KL}}(\pi_\theta | \pi_{\mathrm{ref}})$:当前策略与参考模型(通常是 SFT 后的模型)的分布距离,要最小化;
- $\beta$:两者的兑换率。
KL 项存在的理由很实际:没有它,模型会迅速退化。 只要找到奖励模型的一个漏洞,它就会一直往那个方向跑,输出变成一堆高分但无意义的字符串。KL 项相当于一根橡皮筋,把模型拴在「还像人话」的范围内。
但这根橡皮筋两个方向都拉:
| $\beta$ | 会发生什么 |
|---|---|
| 太大 | 不敢离开参考模型,几乎学不到新东西,等于白训 |
| 太小 | 奖励涨得飞快,也更快撞上过优化的拐点 |
所以 $\beta$ 不是一个可以调没的超参,它是同一个权衡的两端。 很多工程讨论把它当成「稳定性旋钮」,其实它更像「你敢走多远」的预算。
八、DPO:把奖励模型消掉,但没消掉「选择」
RLHF 的工程复杂度主要来自两处:要单独训一个奖励模型,还要在训练中反复采样、跑 PPO。这两步都不太稳定。
DPO(arXiv:2305.18290)的出发点是:上面那个带 KL 约束的最优策略,其实有闭式解。 把这个解代回 Bradley-Terry 似然,奖励模型就被解析地消掉了,只剩下一个分类损失:
\[L_{\mathrm{DPO}} = -\mathbb{E}\Big[\log \sigma\Big(\beta \log \tfrac{\pi_\theta(y_w \mid x)}{\pi_{\mathrm{ref}}(y_w \mid x)} - \beta \log \tfrac{\pi_\theta(y_l \mid x)}{\pi_{\mathrm{ref}}(y_l \mid x)}\Big)\Big]\]不用奖励模型,不用采样,不用 PPO 的裁剪。直接在最喜欢的回答和 rejected 回答之间做一次「相对概率提升多少」的比较。
论文的实验结论是:DPO 在情感控制上超过 PPO 版 RLHF,在摘要和单轮对话上持平或更好,而且实现和训练都简单得多。
但这里有一个容易被误读的地方:DPO 消掉的是奖励模型这个中间件,不是「选择」这个动作。它的目标函数里同样只有 $y_w$ 和 $y_l$,同样没有一项在奖励「其他合理答案」。所以第十节要讲的趋同,DPO 一样逃不掉——它只是把同一种收窄做得更便宜。
补一句:到了推理模型时代,第三阶段又长出了新变体,比如用可验证奖励(答案对不对可以自动判)做 RL 的 RLVR,以及 GRPO 这类去掉价值网络的简化算法。奖励从「人类偏好」换成了「程序判定」,但目标结构没变:最大化一个标量。
九、两种失败模式
把两步放在一起看,区别其实不在「监督 vs 强化」,而在它们各自会怎么坏。
| SFT | RLHF / DPO | |
|---|---|---|
| 数据 | 问题 + 一个标准答案 | 问题 + 两个回答 + 谁更好 |
| 目标 | 最大化示范答案的似然 | 最大化偏好分数的期望,同时别离参考模型太远 |
| 学到的 | 格式、结构、语气 | 一种「更好」的方向 |
| 典型失败 | 数据有偏 → 性格有偏;训久了熵下降 | 奖励模型有偏 → 学会讨好它;训久了过优化 |
| 失败的表现 | 千篇一律,但至少正常 | 分数很高,但实际变差 |
| 成本 | 低,一次监督训练 | 高,要奖励模型 + RL 循环(DPO 降低了这一项) |
一句话总结这张表:SFT 的错在「学错了样本」,RLHF 的错在「学错了目标」。
十、为什么会趋同
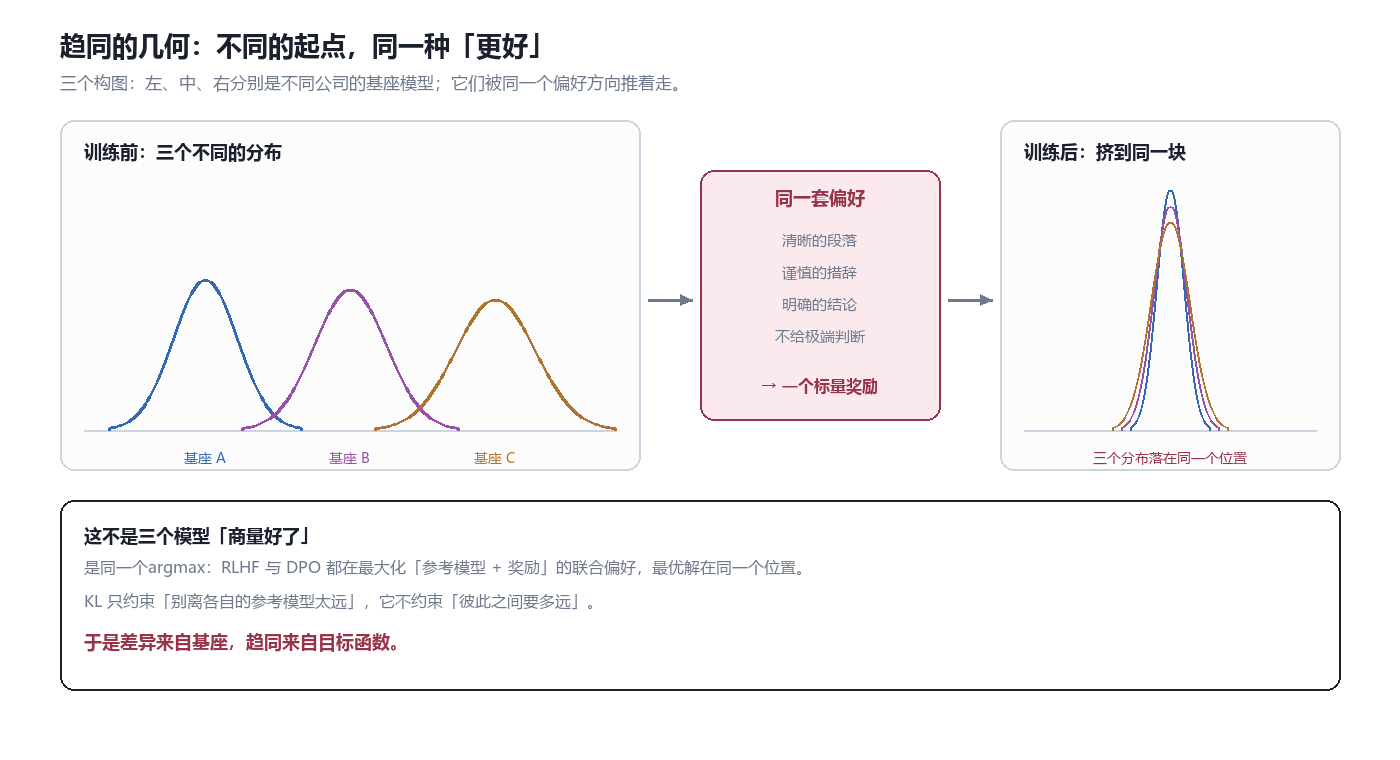
左:三个基座的分布不同;中:同一套偏好被压成一个标量;右:三条曲线落在同一个位置。这是示意。
现在回到那个问题:为什么不同公司的模型,回答越来越像?
我给的机制解释是:趋同不是训练的副作用,是「选择」这个动作的几何后果。
拆开看有三层。
第一层,目标函数是标量。 无论是 max E[r] 还是 DPO 的隐式奖励,最终都是把一个高维的「回答空间」投影到一根轴上,然后往高处走。轴只有一根,高处只有一片。
第二层,KL 拴的是「距离」,不是「差异」。 它约束 $\pi_\theta$ 别离自己的参考模型太远,完全不约束 $\pi_\theta^{(A)}$ 离 $\pi_\theta^{(B)}$ 有多远。所以两个模型可以各自老老实实地待在自己的橡皮筋范围内,同时一起挤到同一块地方。
第三层,偏好数据同源。 各家标注员的群体、培训手册、偏好准则高度相似(有用、无害、清晰、不极端)。奖励模型学到的方向因此高度相关。这不是抄袭,是同一个「人类」被采样了很多次。
机制说完了,证据呢? 有三条,强度不同:
证据一(最直接):RLHF 降低多样性。 Kirk 等人(arXiv:2310.06452)在两个基座模型、摘要与指令遵循两类任务上,分别比较了 SFT、奖励模型、RLHF 三个阶段。结论有两条,而且是一对:RLHF 比 SFT 更能在分布外泛化,但显著降低输出多样性。 作者把这句话写成了一句 tradeoff——当前方法在泛化与多样性之间交换。
这条特别重要,因为它说明多样性下降不是「训坏了」,而是换来了别的东西。
证据二(更尖锐):RL 会缩小推理的覆盖范围。 Yue 等人(arXiv:2504.13837)用 pass@k 在很大的 k 上测 RLVR 训练出的模型,发现:k 小时 RL 模型更强,k 大时基座模型反而更高。 作者的结论是,当前 RL 并没有诱导出基座之外的新推理模式,能力「源于并受限于」基座;反而是蒸馏能带来新的模式。
换句话说,RL 让模型更容易踩中它已经会的那条路,但没让它会更多条路。
证据三(跨模型层面):开放式生成的同质性。 Artificial Hivemind(NeurIPS 2025)系统测量了多个模型在开放式问题上的回答分布,发现模型之间、以及同一模型多次采样之间都存在显著的趋同。这类研究还在早期,度量口径也有争议,但方向和前两条一致。
三条放在一起,可以下一个我认为站得住的结论:当所有模型都在同一根「人类偏好」的轴上被优化时,它们会在轴上相遇;模型之间的差异更多来自基座,而不是来自后训练。
十一、这个结论有多硬
必须把边界说清楚,否则它会变成一句廉价的「AI 都一个样」。
第一,多样性和趋同不是一个指标。 Kirk 测的是同一模型多次输出的多样性;Hivemind 测的是跨模型的分布距离。前者下降,不自动等于后者成立。
第二,它和任务强相关。 摘要、指令遵循这类「有一个好答案」的任务,收窄是好事。开放式写作、头脑风暴、假设生成,收窄就是损失。同一份训练在两个场景里的评价完全相反。
第三,采样参数能部分抵消,但只是部分。 调高温度能让表面文字更多样,但如果分布的质量已经集中,高温只会把少数几个模式说得更花哨——这是「表面多样性」,不是「思路多样性」。要区分这两件事,得看语义层面的分布,不是看 token 层面的熵。
第四,基座差异仍然很大。 不同架构、不同数据、不同规模,在同样的偏好下依然会保留可辨的风格差异。趋同是统计意义上的「更接近」,不是「变成同一个模型」。
第五,这个方向的因果证据还不完整。 目前多是相关性:RLHF 之后多样性下降,且不同模型风格接近。但「因为共享偏好,所以必然趋同」这个因果链,还没有被严格的对照实验验证过。这正好是下一节要设计的东西。
十二、如果要做实验,我会怎么设计
你原来的问题很好:如果我们人为修改 SFT 数据和 RLHF 奖励函数,能否让同一个基础模型产生截然不同的认知风格?
这个问题可以被拆成三个可证伪的实验。都不需要训大模型,7B 级别就够看出方向。
实验一:固定基座,只改偏好方向。 同一个基座、同样的 SFT 数据、同样的算力,训两个奖励模型:一个偏好「先给结论再展开」,一个偏好「先列出三个竞争假设再收敛」。分别做 DPO。然后测两件事:两个模型的输出分布是否在语义空间里分离;以及各自在「对方偏好」的评测集上掉多少分。 预测:会分离,但分离幅度明显小于「两个不同基座」的差异。如果是这样,就说明趋同的主要来源是基座,而不是偏好——这会推翻我上面那句「趋同来自目标函数」的强版本。
实验二:固定偏好,只改「收窄的力度」。 同一套偏好数据,改 KL 系数 $\beta$ 和采样温度,扫一条曲线。每个点上同时测 pass@1 和 pass@k(k 取大值)。 预测:存在一个区间,pass@1 上升而 pass@k 下降。找到这个区间的宽度,就找到了「选择性」和「覆盖度」的兑换率。这比笼统说「RLHF 降低多样性」有用得多。
实验三:多基座同偏好,测两两距离。 三个不同基座 + 同一套偏好,测训练前后两两之间的分布距离(JS 散度或嵌入空间距离)。 预测:训练后距离变小。这就是第十节那张图的直接检验。
否证条件必须提前写下来,否则实验没有意义:如果同偏好训练后,三个基座的输出分布没有比各自的 SFT 基线更接近,那么「选择导致趋同」这个机制解释就是错的——趋同应该另找原因(比如预训练语料同源)。
至于「认知多样性训练」,我认为它比想象中难,因为难点不在奖励函数写不出来,而在你怎么验证多样性不是表演。让模型「先提三个假设」很容易,让它真的走三条不同的推理路径很难。一个可操作的口径是:不看它说了几个假设,看这三个假设导向的结论是否真的不同、以及换一个随机种子后是否还不同。
这也回到了我在其他几篇里反复提到的那条判断:能被指标骗过去的东西,最后一定会被指标骗过去。 多样性也一样——如果奖励函数里只有「看起来多样」,模型会学会表演多样。
项目与资料
- InstructGPT:Training language models to follow instructions with human feedback,arXiv:2203.02155
- LIMA:Less Is More for Alignment,arXiv:2305.11206
- DPO:Direct Preference Optimization: Your Language Model is Secretly a Reward Model,arXiv:2305.18290
- 模仿的边界:The False Promise of Imitating Proprietary LLMs,arXiv:2305.15717
- 过优化:Scaling Laws for Reward Model Overoptimization,arXiv:2210.10760
- 多样性与泛化的权衡:Understanding the Effects of RLHF on LLM Generalisation and Diversity,arXiv:2310.06452
- 推理覆盖范围:Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?,arXiv:2504.13837
- 开放式同质性:Artificial Hivemind: The Open-Ended Homogeneity of Language Models (and Beyond),NeurIPS 2025
文中公式为标准形式;第一、四、五、十节的示意图为我根据公开文献重绘,形状是示意而非某一实验的测量曲线。第十节的机制解释(「选择」导致收窄)是我的推理,三条证据分别支持它的不同部分,强度并不相同;第十一节列了它目前站不住的边界。核对时间 2026-11-18。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- MNN-Pocket-0.3B:不是把大模型缩小,是从两个预算反推形状
- rust-anything:语言迁移不是翻译,是一场可以判负的比较
- Mainline:工程判断该住在 Git 里,不该住在数据库里
- Intent-System:它不信任 AI,所以把流程搬出 AI 的上下文
- vLLM:每次重写,改的都是同一本显存账
- Diagram Design:50 种图表是目录,能拒绝你的检查才是产品
- gpu-unlock:GeForce 的半速矩阵算力,写死在八个 4 位字段里
- Octop:单进程是它的地基,也是它的天花板
- VoiceStudio:把 ElevenLabs 搬回本地之后,账单换成了许可证
- DroidDeck:手机跑 PC 游戏不难,难的是让 Android 相信自己正在当主机