rust-anything:语言迁移不是翻译,是一场可以判负的比较
7,925。0。0.23x。
第一个数字是 x18n core 的录制案例数,第二个是其中的不一致数,第三个是其中一个函数在 Rust 里的加速比——它是 0.23 倍,也就是说慢了四倍多。
三个数字来自同一份报告,报告的最后一行是这句建议:
Do not ship these ports into x18n: they are correct but slower.
一个迁移工具,把自己刚做完、且全部通过校验的 29 个函数,主动判成了「不要发」。这就是我决定写它的原因。
项目是 erkamyaman/rust-anything,作者 Erkam Yaman,Rust 写的,MIT。2026-11-16 建库,到本文写作时约 37 小时,已经有 1,314 star、85 fork、2 个 open issue。README 顶上那行字是它的全部主张:up to 20x faster · 38,251 recorded cases replayed · 0 mismatches · one command。
这篇不写「Rust 迁移指南」,只写一件事:它把「该不该换」做成了一个可以被数据否决的判断,而这个判断的可靠性,取决于一个比测试套件更窄、也更诚实的东西——录制。
一、迁移真正缺的不是翻译
先承认一件事:把一段 TypeScript 翻译成 Rust,今天的模型已经做得不错了。翻译不是瓶颈。
瓶颈在这个问题后面:
你怎么知道翻译对了?
旧项目跑了五年,没有完整的测试,没有接口文档,有些行为只存在于用户的实际用法里。一次性重写的风险不在写不出来,在于没人能证明新的和旧的一样。
草稿里列的五条风险,其实都可以归到同一件事上:
| 风险 | 表面说法 | 真正的问题 |
|---|---|---|
| 行为不一致 | 边界条件、异常、数据格式对不上 | 没有可执行的「一样」的定义 |
| 迁移风险高 | 一次改太多 | 没有可以中途停下的粒度 |
| 性能不确定 | Rust 不一定更快 | 没有一个统一的比较口径 |
| API 兼容难 | 调用方要改 | 没有「接口不动」的约束机制 |
| 测试覆盖不足 | 单测覆盖不到真实输入 | 覆盖率的靶子本身是错的 |
rust-anything 对这些问题的回答是同一条:把「原实现在某个输入下做了什么」录下来,变成可重放的案例,然后让每一次替换都去对这个录制负责。
它自己把这条边界写得很清楚(DECISIONS.md 的 D1):它是一个由 Agent 驱动的工具箱,而不是一个会自己调模型的翻译器。理由是——「校验恰恰是 Agent 做不可靠的那部分」。
这句话是整篇文章的题眼。它解释了为什么这个工具长得不像同类产品:它不生成代码,它生成判决。
二、一条流水线,两条泳道
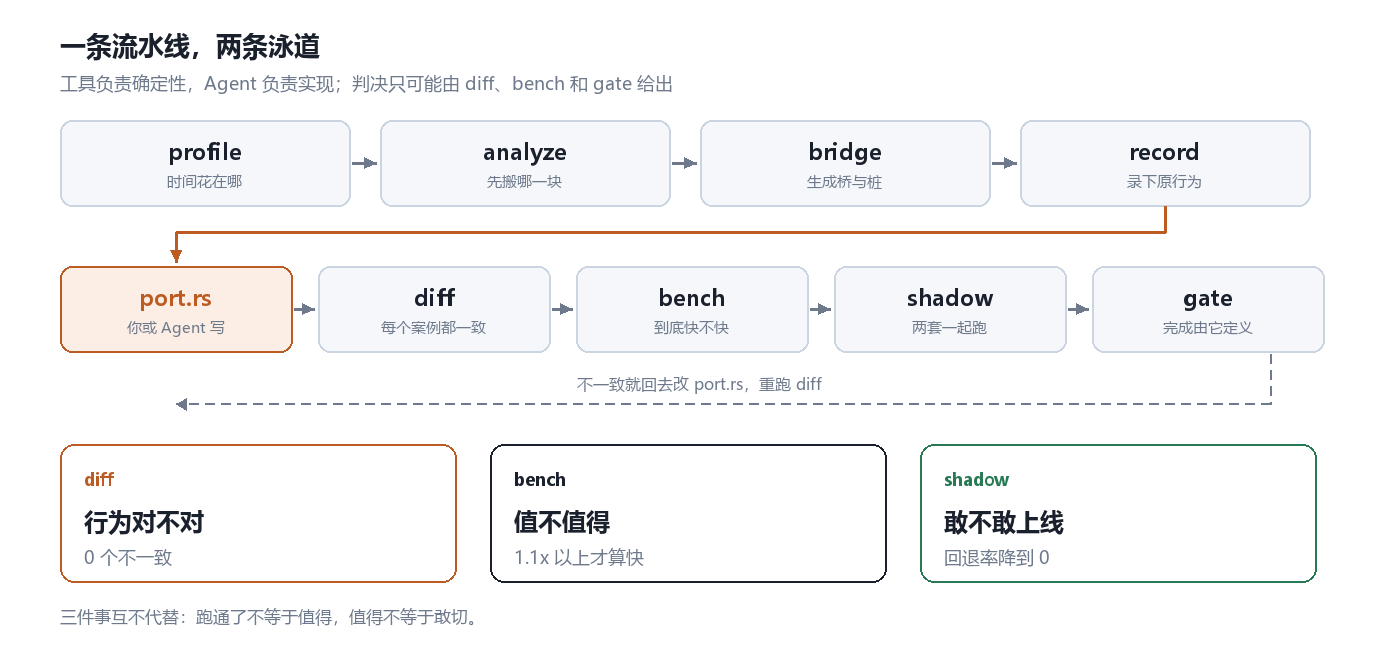
橘色那一步是全流程里唯一由人或 Agent 写的代码;其余七步都是确定性的机械动作。
profile ──> analyze ──> bridge ──> record ──> port.rs ──> diff ──> bench ──> shadow ──> gate
- profile:在语言自己的 profiler 下跑真实负载(node
--cpu-prof、cProfile、go test的 pprof、JFR、Ruby 的 TracePoint),按 inclusive time 排函数,标出调用者和那个「每次调用都在变的参数」。它还会标出已经被 numba / Cython / JAX 编译过的代码——那些地方换 Rust 基本没收益。 - analyze:切出迁移单元(unit)、算出波浪顺序(wave)、给每个单元定桥接方案、列出风险(带
file:line)和就绪度/优先级。 - bridge:生成桥接 crate 和
port.rs的桩。 - record:录原实现的行为。
- diff / bench / shadow / gate:四道判定。
值得注意的是 analyze 的单元定义(D1 之外的 A1):一个 unit 是一个目录,或者包源码根目录下的一个文件。不是函数,不是类。因为在真实的 TS 项目里,「模块」就是目录。而波浪顺序来自单元依赖图的强连通分量(A5)——叶子先搬,环必须一起搬,这样 Rust 永远不会回调 JS。
还有一个数字能说明它为什么用 Rust 写、用 oxc 解析(D4):x18n 27,000 行代码,分析耗时约 0.1 秒。
三、Record:案例是生成出来的,不是写出来的
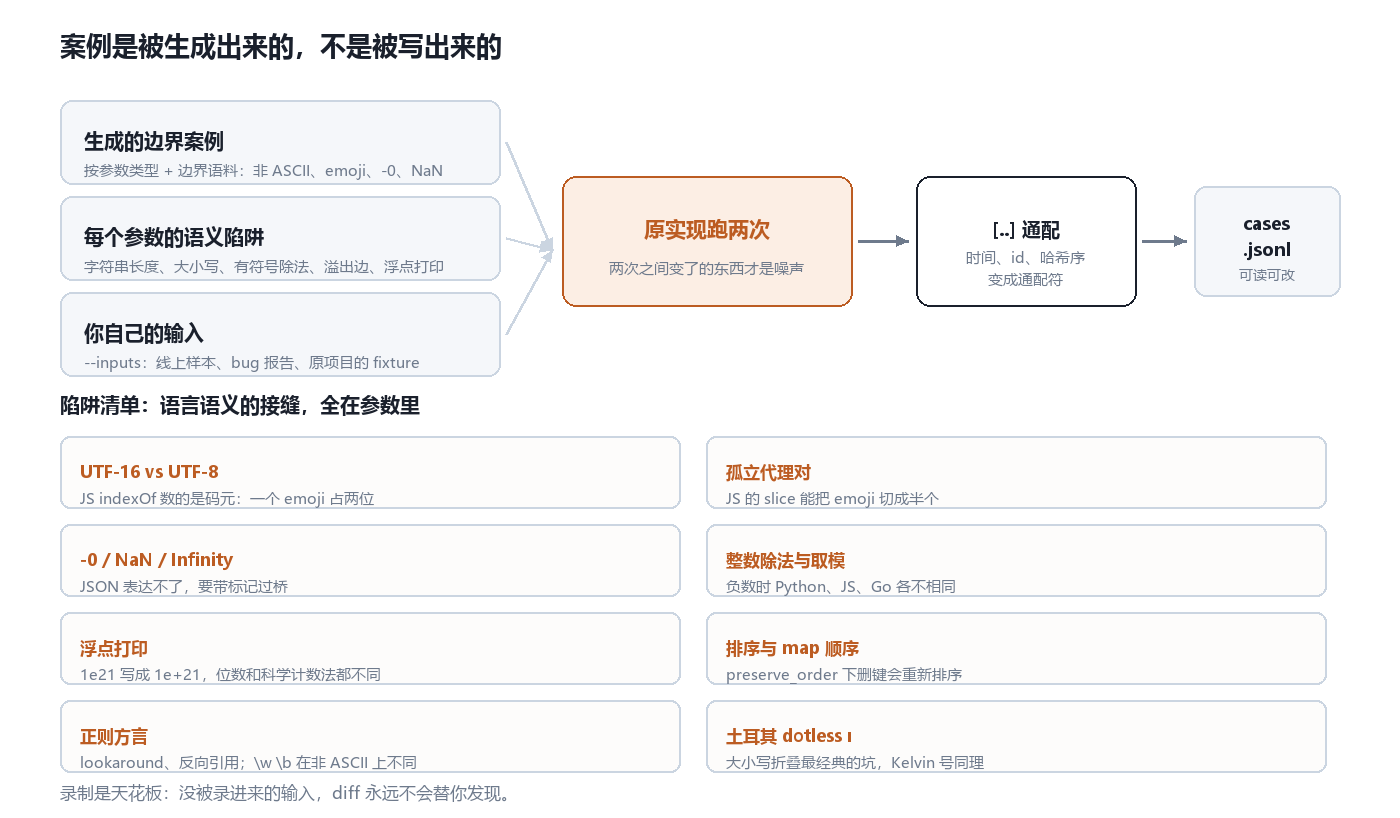
边界案例由参数类型推出来,语义陷阱按参数逐个加,真正决定成败的往往是第三类:你自己的输入。
这是我认为最值得抄的一段设计。
传统做法是「先补测试,再迁移」。问题是补测试本身就需要知道旧代码在边界上做什么——而这正是你缺的知识。
rust-anything 换了个顺序:不知道就先跑,跑出来的就是规格。
录制有三个来源(README 的 record 一节):
- 按参数类型生成的边界案例:非 ASCII、emoji、
-0、NaN、该是浮点却传了整数…… - 每个参数的语义陷阱:字符串长度与大小写、有符号除法、溢出边界、浮点打印、map 与排序顺序。
record会给文件里每个用了正则的函数额外加一组陷阱(土耳其无点 ı、开尔文符号、长 s、阿拉伯-印度数字、行分隔符、希腊末尾 sigma)。 - 你自己的输入:
--inputs cases.jsonl,喂线上样本、bug 报告、原项目的 fixture。
录制时会把原实现跑两次,两次之间变了的东西才被标成噪声:变化的值变成通配符,顺序变化按无序比较,行数变化变成 ...。结果存成 cases.jsonl——纯文本、可读、可手改。README 甚至直说:删掉你认为不该存在的案例是允许的。
这个设计有两个很硬的后果。
第一,录制即天花板。 没被录进来的输入,diff 永远不会替你发现。作者把这句话放在 README 的 What it can’t catch 第一行,没有含糊。
第二,录制会自动暴露语言之间的接缝。 比如 README 里那个最漂亮的例子:x18n 的 fuzzyScore 第一版按 Rust 的 char 索引,简单测试全过,diff 挂了:
198/200 cases match
- fuzzyScore("b😀", "a😀b😀c"): expected {"ok":1997}, got {"ok":1998}
差一。因为 JS 的 indexOf 数的是 UTF-16 码元,一个 emoji 占两位,而 Rust 的 char 是码点。这种 bug 你读代码读不出来,写测试也想不起来——只有两个实现并排跑才会掉出来。
四、Diff 与 Shadow:比较的单位是调用者看到的东西
diff 做的事看起来简单:把 cases.jsonl 里的案例逐条喂给 Rust,比对结果。
但有两个决定让它比看上去严谨:
它走的是调用者会走的那个 wrapper。 DECISIONS.md 的 M3 写得很直白:diff 必须经过 cgo 包、Fiddle 文件、JNI 类、PyO3 包这些真实入口。「测试必须看到调用者看到的东西:wrapper 的 bug、类型转换、异常映射,全都算在内。」
它不比对错误信息,只比对「有没有抛」。 L7:两边都抛就算一致,消息不比较。理由是错误文案几乎从来不是契约,而被强迫对齐措辞会让每一个 port 都无谓地挂掉。这条看起来很松,其实收得很准——它把「行为」定义在调用者能依赖的范围内。
shadow 则是把比较搬到运行期:
RUST_ANYTHING_MODE=old      # 只跑原实现
RUST_ANYTHING_MODE=shadow   # 两套都跑,返回原实现的结果
RUST_ANYTHING_MODE=new      # 用 Rust
三个细节值得注意。shadow 永远返回原实现的结果,Rust 的错误永远不上升到调用者(L9);它先跑原实现、后跑 Rust;并且它是按语言用最小侵入的方式实现的——Go 是一个包,Ruby 是一个 prepend 的文件,Java 是 <Class>Shadow 类,C 是用 -D 重命名的文件加一个 shadow feature。
这个思路作者说得很清楚(D5):Cloudflare 当年就是把新旧实现放在同一个进程里并排跑,再逐步切流量。测试证明一个 port,生产流量确认一个 port。
五、Gate:一份不许糊弄的清单
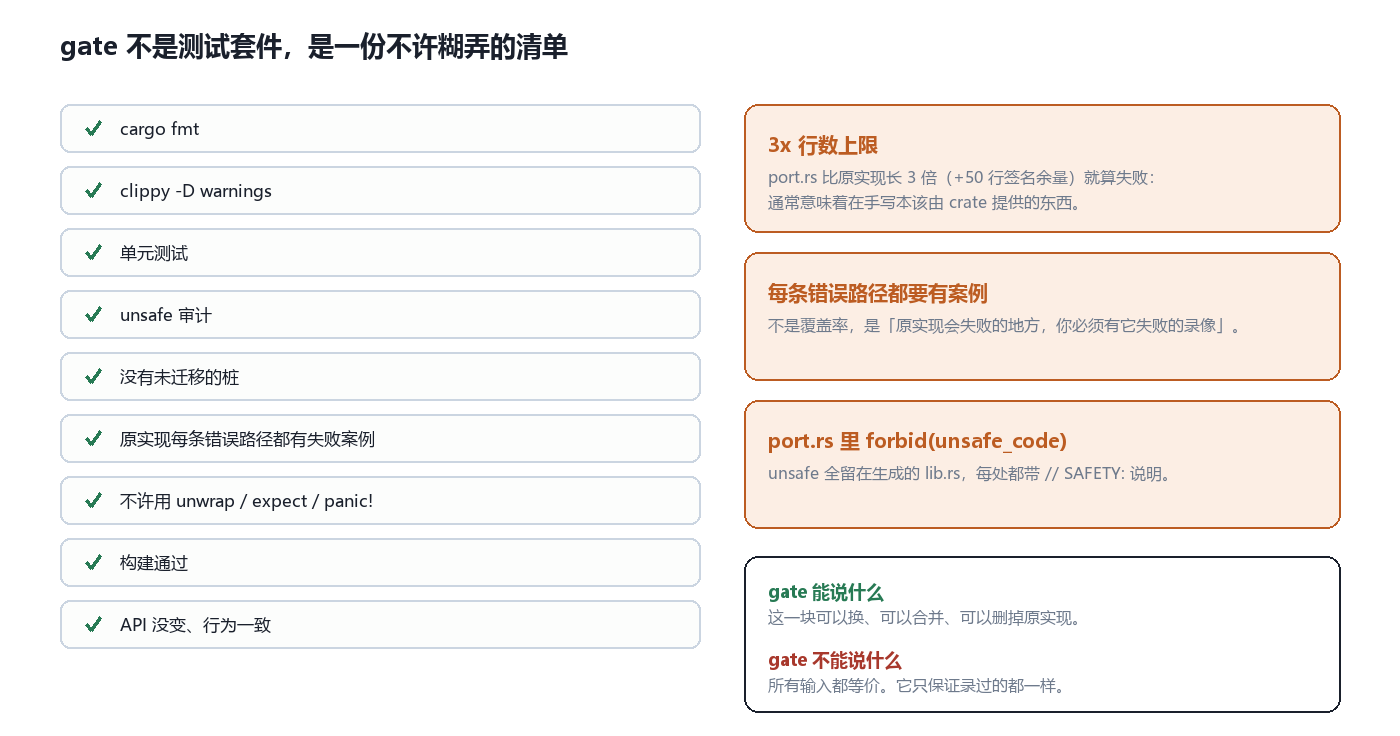
最有信息量的是中间那条:不是覆盖率,是「原实现会失败的地方,你必须有它失败的录像」。
gate 的清单不长,但每一项都在堵一个洞:fmt、clippy -D warnings、测试、unsafe 审计、没有未迁移的桩、不许用 unwrap / expect / panic!、构建通过、API 没变且行为一致。外加一条很少见的:原实现的每一条错误路径,都必须有一条录制下来的失败案例。
这三条规矩是我认为它比大多数「质量门禁」更狠的地方:
1. port.rs 里的代码比原实现长 3 倍(+50 行签名余量)就算失败。 这条规则的目的不是审美,是诊断:一个 port 突然膨胀三倍,通常意味着你在手写某个 crate 已经提供的东西,或者在逐个 case 地处理本该用类型解决的问题。把「膨胀」当成信号,比事后 review 有效得多。
2. 错误路径必须有录像。 大多数迁移会漏掉 error path,因为正常路径跑通了就以为完事了。强制要求「原实现在这个输入下会失败」也有一份案例,等于把异常语义也纳入契约。
3. port.rs 里 #![forbid(unsafe_code)]。 所有 unsafe 都被赶进生成的 lib.rs,每一处都带 // SAFETY: 注释(M6)。结果是:你要维护的那部分代码,在整个迁移过程中始终是安全 Rust。
还有一处设计我特别喜欢:gate 明确区分了「能说什么」和「不能说什么」。它能说这一块可以换;它不能说所有输入都等价。
六、Bench:为什么按函数搬过去会更慢
这是全文最重要的一节,也是这个项目和绝大多数「用 Rust 重写」宣传最不一样的地方。
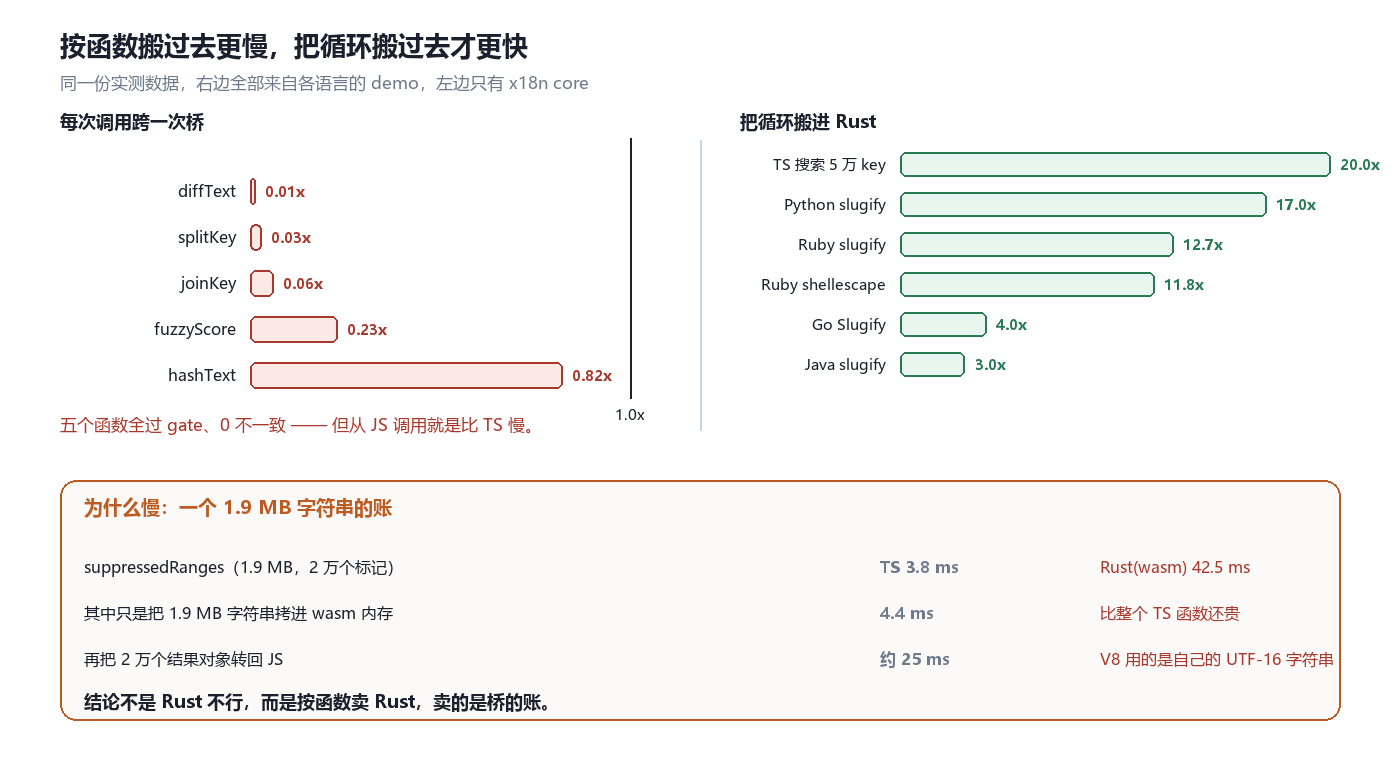
同一份数据,两组方向相反的结论;左边每一个都通过了 gate,右边每一个都还没有经过同样的证明。
先看事实。x18n core 里 55 个导出,29 个能不改变公开 API 地搬到 Rust,26 个必须留下(类型里含函数、generator、RegExp、instanceof、泛型——桥接带不过去,DECISIONS.md 的 X1 记录了这个 26/55 的比例)。29 个全部 9/9 过 gate,7,925 条案例 0 不一致,外加 4,600 次 shadow 调用的 0 不一致。
然后 bench 把它们几乎全部判成更慢:
| 函数 | 单次调用加速比 |
|---|---|
diffText | 0.01x |
splitKey | 0.03x |
joinKey | 0.06x |
fuzzyScore | 0.23x(napi 版 0.22x) |
hashText | 0.82x |
少数几个在 1x 以上的(applyTextEdits 1.12x、buildTree 1.19x),作者的解释也很老实:那些函数的录制案例大多是非法的输入,JS 的时间花在建异常对象上。
大输入同样没有翻盘:
| 输入 | TS | Rust(wasm) |
|---|---|---|
hashText,1.4 MB | 2.0 ms | 2.8 ms |
diffText,1.4 MB | 5.2 ms | 11.1 ms |
suppressedRanges,1.9 MB,2 万个标记 | 3.8 ms | 42.5 ms |
joinKey,10 万次调用 | 6.3 ms | 65.7 ms |
最刺眼的是第三行,差了 11 倍。而这个数字是可以被拆开归因的,这也是我认为这份报告最有价值的地方:
- 把 1.9 MB 的字符串拷进 wasm 内存,光这一步就是 4.4 ms——比整个 TS 函数还贵;
- 再把 2 万个结果对象转回 JS,大约 25 ms;
- 而 V8 跑这些字符串操作时,用的是它自己的 UTF-16 字符串,根本不需要拷贝。
所以结论不是「Rust 不行」,而是:按函数卖 Rust,卖的是桥的账。 一次跨语言调用的固定成本,被一个几微秒的函数调用放大成了灾难。
bench 最后会直接给判决(S4):1.1x 以上算快,0.9x 以下算慢,并建议「发布、留下慢函数、改搬更大的单元、或者(对 C)继续优化 port」。它没有把数字丢给你自己看——它把结论也一起给了,包括对自己不利的结论。
七、Batch:赢的不是语言,是边界
那什么情况下 Rust 该赢?答案是把循环搬过去,而不是把函数搬过去。
const search = new FuzzyScoreBatch(keys); // 建一次
const order = search.rank(query, 0); // 每次按键:只回索引
bridge --batch fn:param 会生成一个类:item 只过一次桥,之后每次调用在 Rust 里对所有 item 跑一遍,用满所有核,结果是 typed array。索引回传而不是字符串回传,因为调用方本来就握着 key。
在 x18n 那份搜索上(5 万个 key,逐键输入):TS 每次 10 ms;FuzzyScoreBatch 默认索引 5.1 ms;加上 port.rs 里手写的 FuzzyScoreIndex(先建小写键和字符掩码表,单字母查询走一列,二次输入只重算上次命中的集合)后是 0.45–0.56 ms,18–22 倍;wasm 单线程版 0.95 ms,11.5 倍。
其他语言是同一张图景(4 核,结果与错误都一致):
| 语言 | 负载 | 原实现 | batch |
|---|---|---|---|
| Python | slugify,2 万串 | 98 ms | 17x |
| Ruby | slugify,2 万串 | 110 ms | 12.7x |
| Ruby | shellescape(标准库),5 万个混合值 | 88 ms | 11.8x |
| Go | Slugify,5 万串 | 49 ms | 4x |
| Java | slugify,5 万串 | 43 ms | 3x |
而同一批函数如果按次调用:Go 0.93x、Java 0.68x——编译型语言的叶子函数在自己语言里本来就已经很快了。
这里还藏了一个很工程的细节(S12):带 batch 的 crate 全局用 mimalloc。原因不是玄学——系统分配器把线程串行化了,纯 Rust 里 4 核只有 1.6x,放进 Go 进程里甚至比单线程还慢;换 mimalloc 后是 3.2x。
另外 S14 那条也值得记:结果字符串要成批回去。Go 分配一块总长度的缓冲,Rust 多核拷进去;Java 直接拿一个 UTF-16 的 char[] 加长度数组再切。把结果一条条 join 是省不下来的——Java 的 batch 从 25 ms 降到 14 ms,靠的就是这个。
八、整应用:回退率的下降
单个模块证明完,整个应用怎么办?答案是一个会自己算「还有多少没搬」的框架。
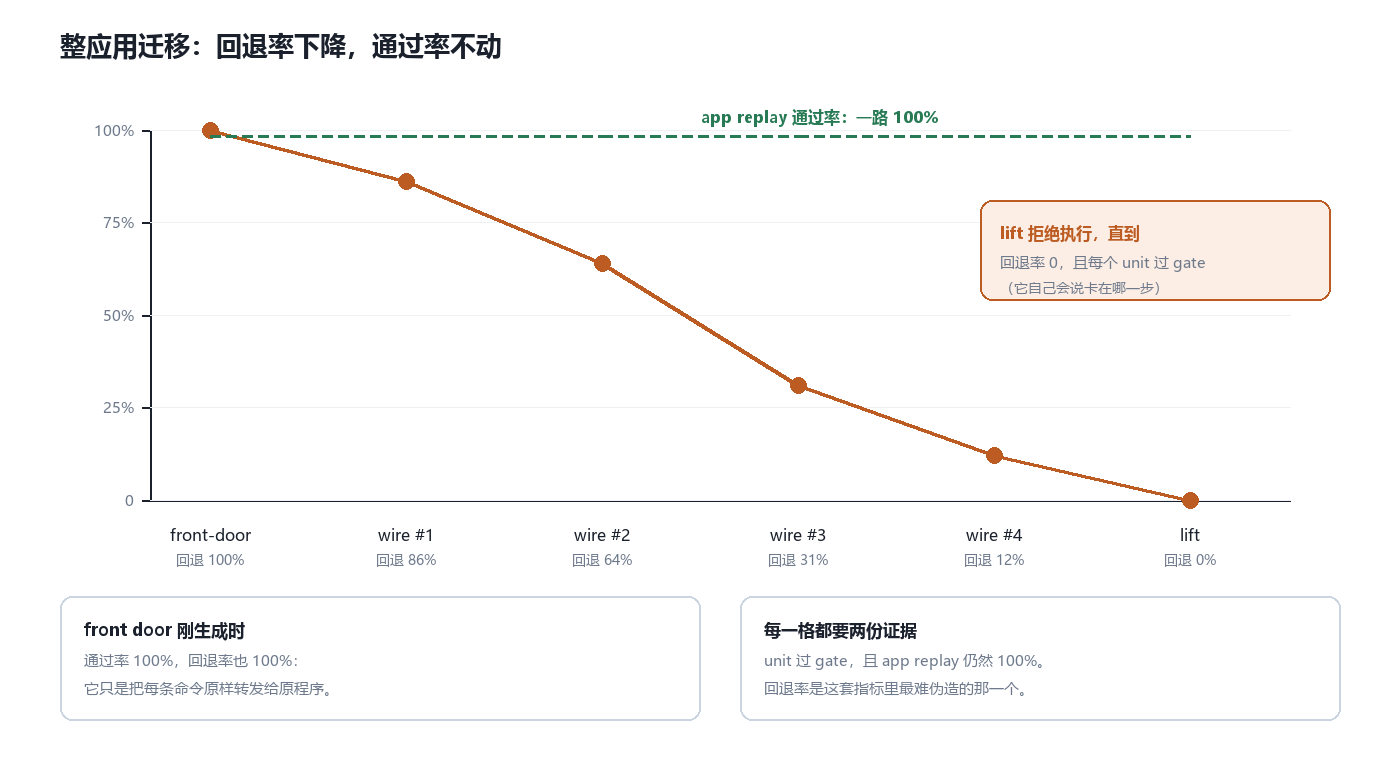
刚生成的 front door 通过率 100%、回退率也 100%:它只是把每条命令原样转发给原程序。
rust-anything analyze . --whole-app      # 形态、入口、每个依赖对应的 crate、要你拍板的决策
rust-anything app record . -- python3 cli.py
rust-anything app replay .               # 原实现必须 100% 通过
rust-anything app front-door .           # rust/app:每条命令都转发给原程序
rust-anything app wire . textkit --command upper
rust-anything app lift .
几个细节让这条链子站得住:
案例是 trycmd 文件。 app record 从应用自己的文档里抽 $ mytool ... 例子、从 --inputs 拿输入、再按 CLI 参数生成语义陷阱;每个案例跑两次,差异变成 [..]。存成 <case>.toml + .stdin + .stdout + .stderr + .in/ + .out/,人可以直接改。HTTP 服务同理:从文档里的 curl 行生成,案例里存状态码、关键响应头和 body。
回退率是一个算出来的数,不是一个说法。 front door 把每次回退写进 RUST_ANYTHING_FALLBACK_LOG,app replay 顺便报告回退率。库模式更狠:没有进程可回放,公开 API 就是 front door,回退率 = 还没被 Rust 接管的导出占比。
lift 会拒绝执行。 它的条件是回退率 0 且每个 unit 都过 gate,不满足就直接告诉你卡在哪一步。它做的还是「在副本上先做」:移除回退路径和 kill switch、把每个 unit crate 变成普通库、加上 rust/app/tests/app_cases.rs 让 CI 只需要 cargo,跑完整套 checklist 才写回。原程序从头到尾没被碰过。
还有一个我没想到的部分:整应用迁移真正的难点不是技术,是决策。所以 skill 里有一套 grilling 流程——Agent 分轮提问,每个问题都附上推荐答案,直到每个决策被定下来,然后写成 rust/DECISIONS.md 里的 ADR,配一份 rust/GLOSSARY.md 把原项目的术语映射到 Rust 命名。跨会话靠 rust/MAP.md 记录每个 unit 的状态,每个检查点留一份 rust/HANDOFF.md。该人做的步骤(部署、DNS、密钥)由一个生成的 rust/cutover.sh 交互式地带着做,每一步都留退路。
(这套 grilling / research 的做法注明改编自 Matt Pocock 的 skills。)
九、它明确说自己抓不到什么
这一节是整个 README 里我最尊重的部分。作者用整整一节列出了「通过」到底意味着什么,而且每一条都给了具体的失败场景:
- 没人录过的输入。 生成的案例、陷阱、你的
--inputs就是上限。作者的原话:把生产样本、bug 报告、原项目的 fixture 加进去,因为「弄坏生产环境的那个输入,很少是生成器想得出来的」。 - 正则。
regexcrate 没有 lookaround 和反向引用;就算能编译,\w、\b、\d和非 ASCII 的大小写匹配也可能和 JS / Python / Java 不同。换fancy-regex或者重写 pattern,可能通过全部案例,却在土耳其无点 ı 或零宽连接符上分叉。 - 两次运行之间会变的东西。 哈希序、并发——
record会把它们识别成「任意顺序」或...,但作者提醒:这一类恰恰是 port 里最容易真的变质的。 - 浮点。 数字转文本的格式在各语言之间不同(
1e21、-0、位数),这些必须精确匹配;--float-tolerance只原谅舍入,不原谅格式。 - 输出之外的一切。 时间、内存、负载下的并发、stdout/stderr/退出码/写文件/HTTP 响应之外的副作用(网络、数据库、信号)都不比较。
- 别的平台。 录制只证明「跑它的这台机器上的行为」。所以依赖类型宽度、字节序、编译器的 C,
analyze会建议继续用 C 写。
最后这条在 DECISIONS.md 里还有个更狠的实现细节(M5):C 的每条案例在独立的子进程里跑,崩了就记成 crash: <signal>,并接受任何 port 行为。理由很硬——超出 C 函数契约的输入是未定义行为,真实的 glibc 在 isalpha(INT_MAX) 上会段错误。一个会崩的录制,不能要求 Rust 也崩得一模一样。
十、局限
按重要性排:
- 它只有 37 小时大。 1,314 star 是发布效应,不是工程成熟度。作者自己把
DECISIONS.md写成了「每条都可以被推翻」的形态,这既是诚实,也说明设计还在动。 - 语言覆盖是子集,不是全集。 Java 只处理 public 类的
public static方法,重载、泛型、char、对象类型都留在 Java;Ruby 只处理模块函数,带 block 的类方法留在 Ruby;Go 的 method、泛型、变参、指针、接口、channel 都留在 Go;C 只过标量和const char *。每一门语言都有一条明确的「到此为止」的线。 - 桥接不是免费的,而且它自己承认。 「bridge 每次调用都拷贝字符串和结构化值;对细粒度函数,这个开销是主导的。」这条被写在 Known limits 里,没被藏起来。
- shadow 只比较同步返回值。 会修改参数对象的函数,第二次实现拿到的是已经被改过的输入。别名(Ruby 的
alias)也会绕过 shadow。 - bench 是单机 4 核的结果。 所有数字都在同一台机器上、4 核;跨核扩展、NUMA、容器 CPU 配额都没测。当作方向性结论看,不要当 SLA。
- C 的门槛偏高。 只用标量与
const char *能过桥,输出缓冲(char *out, size_t *len)和状态结构体都留在 C;宏定义的函数也看不见。 - 它依赖你的运行时。 Node 22.6+、Python 3.9+、Go 1.21+、Ruby 3+、JDK 17+,还要各自的编译器;wasm 桥要额外装
wasm-bindgen-cli并锁版本。
十一、我的判断
回到开头那三个数字。7,925 / 0 / 0.23x 之所以有价值,不是因为它们证明了 Rust 好或不好,而是因为它们同时来自一个流程:能录、能比、能判、而且判完敢公开。
我认为这个项目里有三样东西是可以整体搬走的,跟 Rust 无关:
第一,把「判决」做成一等产物。 大多数工具输出的是报告,人读完自己下结论。rust-anything 的 analyze 给就绪度和优先级,bench 给 ship / keep / port-bigger,gate 给 done,lift 给「卡在哪一步」。判决可以被推翻,但它必须先被给出。
第二,把 benchmark 从 gate 里拆出去。 这是 DECISIONS.md 的 X5,理由只有一句:「速度不是正确性,但它决定一个 port 该不该发。」把「对不对」和「值不值」分成两道门,是这份设计里我最想抄的一处。合成一道门的工具,最后都会把「慢但正确」判成失败,或者把「快但可疑」放过去。
第三,录制是一种可以被生成的规格。 传统顺序是「先写测试再改」,这个顺序预设了你知道旧代码该做什么。录制把顺序反过来了:先让它跑,跑出来的就是规格。这跟上一篇写 Mainline 时的观察正好互补——Mainline 存的是 why(当初为什么这么做),rust-anything 证的是 what(现在到底做了什么)。一个给未来的 Agent 读,一个给当下的 Agent 判。
如果要给三个可验证的下一步,我会选:
- 把
app replay接到 CI 的 required check 上。 回退率这个指标现在只在本地算,它天生适合当门禁——因为它是一个不会被 Agent 的措辞骗过去的数。 - 把「录制覆盖率」做成可查询的。 现在
cases.jsonl是一堆文本,读者只能靠眼睛判断够不够。如果能把「哪些参数类型还没有陷阱」「哪些分支从没被触发」算出来,录制才能像覆盖率一样被追责。 - 把 bench 的结论接回
analyze的排序。 现在 profile 找热点、bench 判值不值,但analyze的优先级仍然靠静态启发式(loops 和字符串工作量)。把实测结果回灌进排序,才算闭环。
最后一句给这个项目:它最难得的不是支持六种语言,也不是 20 倍那个数字,而是它在一个所有人都在喊「用 Rust 重写」的年份里,写了一份 29 个函数、7,925 个案例、0 个不一致,然后建议你别用的报告。
一个工具的可信度,约等于它愿意否定自己的次数。
项目与资料
- GitHub:erkamyaman/rust-anything
- 设计取舍与理由:DECISIONS.md
- x18n core 的完整迁移报告:demo/x18n-core
- 六种语言的真实代码迁移:docs/real-world-languages.md
- 工作流 skill:skills/rust-anything
- 安装:
cargo install rust-anything,或npm install -g rust-anything,或从 GitHub Releases 取预编译包;之后rust-anything setup注册 MCP server 与 skill(Claude Code / Codex / Cursor / Gemini CLI)
许可证 MIT;生成的 port 和桥接代码归你所有。README 声明这是一个独立项目,与 Rust 项目、Rust 基金会无关,“Rust” 是 Rust 基金会的商标。
本文所有命令、数字与引文均取自仓库 README、DECISIONS.md、demo/x18n-core/README.md、docs/real-world-languages.md 与 GitHub API(核对时间 2026-11-18)。架构示意图为根据公开文档重绘,非官方原图;图中「回退率」的下降曲线是示意,实线数值不代表某个真实项目的逐步记录。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- MNN-Pocket-0.3B:不是把大模型缩小,是从两个预算反推形状
- SFT 与 RLHF:教接口,选口味,然后收窄
- Mainline:工程判断该住在 Git 里,不该住在数据库里
- Intent-System:它不信任 AI,所以把流程搬出 AI 的上下文
- vLLM:每次重写,改的都是同一本显存账
- Diagram Design:50 种图表是目录,能拒绝你的检查才是产品
- gpu-unlock:GeForce 的半速矩阵算力,写死在八个 4 位字段里
- Octop:单进程是它的地基,也是它的天花板
- VoiceStudio:把 ElevenLabs 搬回本地之后,账单换成了许可证
- DroidDeck:手机跑 PC 游戏不难,难的是让 Android 相信自己正在当主机