Omni-Quantized:12 个构建,两套布局,省的是显存不是时间
14.23。3.67。28。
第一个是 BF16 的 Transformer 权重,第二个是 NF4 的同一份权重,第三个是文生图一张图的耗时——而前三档量化的耗时分别是 28 秒、28 秒、30 秒。
也就是说:把 14 GB 压到 3.67 GB,省下的是显存,几乎不省时间。
这个仓库叫 Qwen-Image-2.1-Uncensored-Omni-Quantized,ChatR Labs 出品,2026-11-03 上线,160,748 次下载、510 个 like,基于阿里 Qwen-Image-2.1 做的社区微调 + 量化。
但真正让我想写它的不是“能压到 4 GB”,而是另一件事:同一个模型,12 个构建,两套互不通用的张量布局。
一、它是什么:一次训练,12 个文件
结构很简单,一句话说完:把训练好的 rank-128 LoRA 以 strength 1.0 合并进基础 Transformer,然后按不同精度和运行时切成 12 份。
| 项 | 值 |
|---|---|
| 基础模型 | Qwen-Image-2.1(Single-stream DiT,约 7B) |
| 适配器 | ChatR Labs rank-128 Omni LoRA,合并强度 1.0 |
| 训练检查点 | step 90,000 |
| 适配模块 | 224 个 |
| 张量数 | Diffusers 布局 297,ComfyUI 布局 265 |
| 许可 | Qwen Research License(非商用,除非另行授权) |
这里有两个数字必须先分清,否则后面全错:
- 7B 是图像生成 Transformer 的参数规模;
- 3.67 GB 是 NF4 那个权重目录的大小,不是运行时的显存占用。
而且仓库只发 Transformer。文本编码器、processor、VAE 都要从 Qwen/Qwen-Image-2.1 单独取——这决定了“4 GB 能不能跑”这个问题本身就不完整。
二、12 个构建,先看运行时再看大小
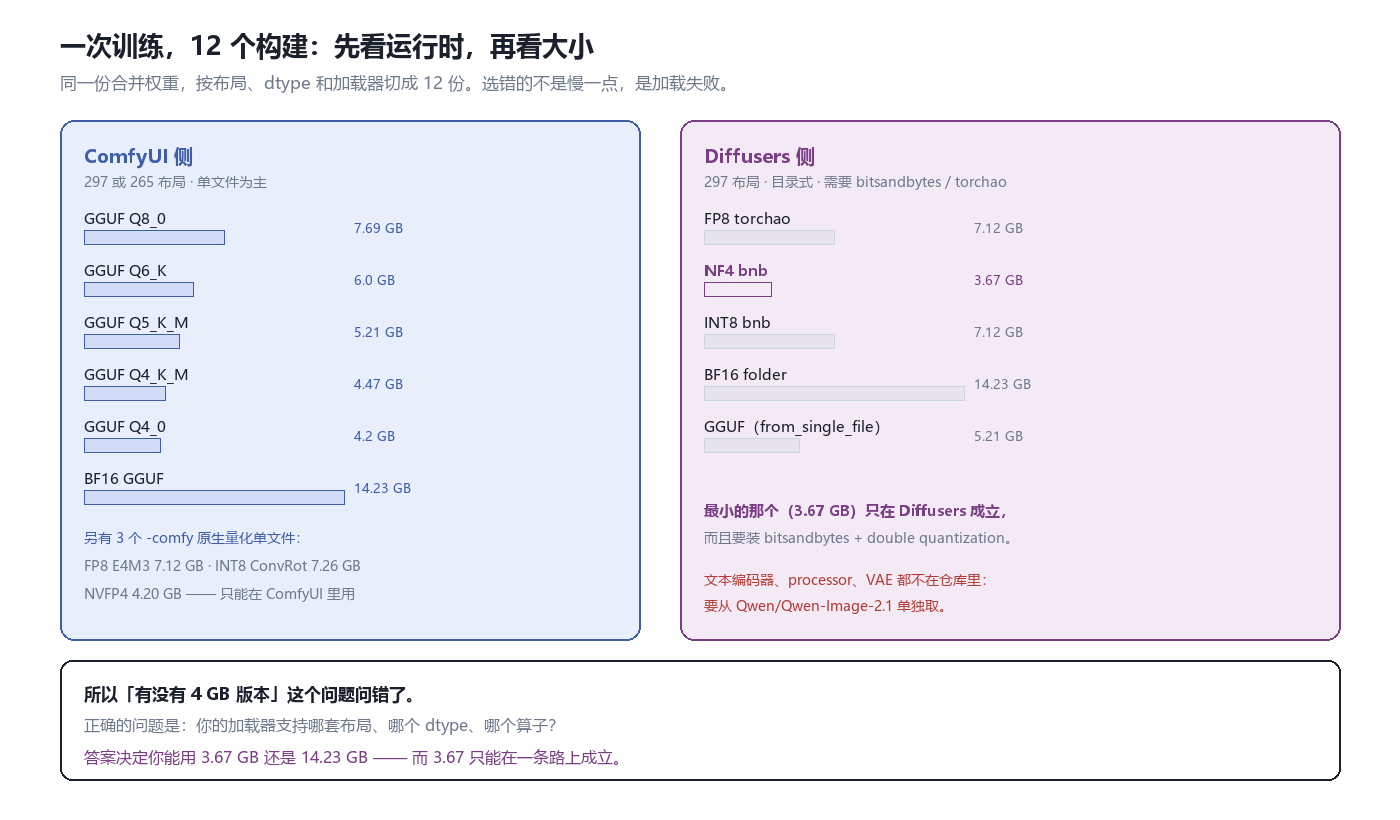
左边 ComfyUI,右边 Diffusers;同一个模型,文件不通用。
| 构建 | 大小 | 运行时 | 布局 |
|---|---|---|---|
| BF16 GGUF | 14.23 GB | 两端都能用 | 297 |
| BF16 safetensors | 14.23 GB | Diffusers / ComfyUI | 297 |
| Q8_0 / Q6_K / Q5_K_M | 7.69 / 6.00 / 5.21 GB | 两端都能用 | 297 |
| Q4_K_M / Q4_0 | 4.47 / 4.20 GB | 两端都能用 | 297 |
| FP8 E4M3(comfy) | 7.12 GB | 仅 ComfyUI | 265 |
| INT8 ConvRot(comfy) | 7.26 GB | 仅 ComfyUI | 265 |
| NVFP4(comfy) | 4.20 GB | 仅 ComfyUI | 265 |
| FP8 torchao | 7.12 GB | 仅 Diffusers | 297 |
| NF4 bnb | 3.67 GB | 仅 Diffusers | 297 |
| INT8 bnb | 7.12 GB | 仅 Diffusers | 297 |
注意两处容易记错的地方:
- 最小的 3.67 GB 只在 Diffusers + bitsandbytes 这条路上成立,ComfyUI 侧拿不到;
- INT8 有两个不同大小的版本:Comfy 的 ConvRot 是 7.26 GB,不是 7.12 GB。7.12 是 Diffusers 那个。
所以“有没有 4 GB 版本”这个问法本身就是错的。正确的问题是:你的加载器支持哪套布局、哪个 dtype、哪个算子?
三、297 与 265:差的不是权重,是存法
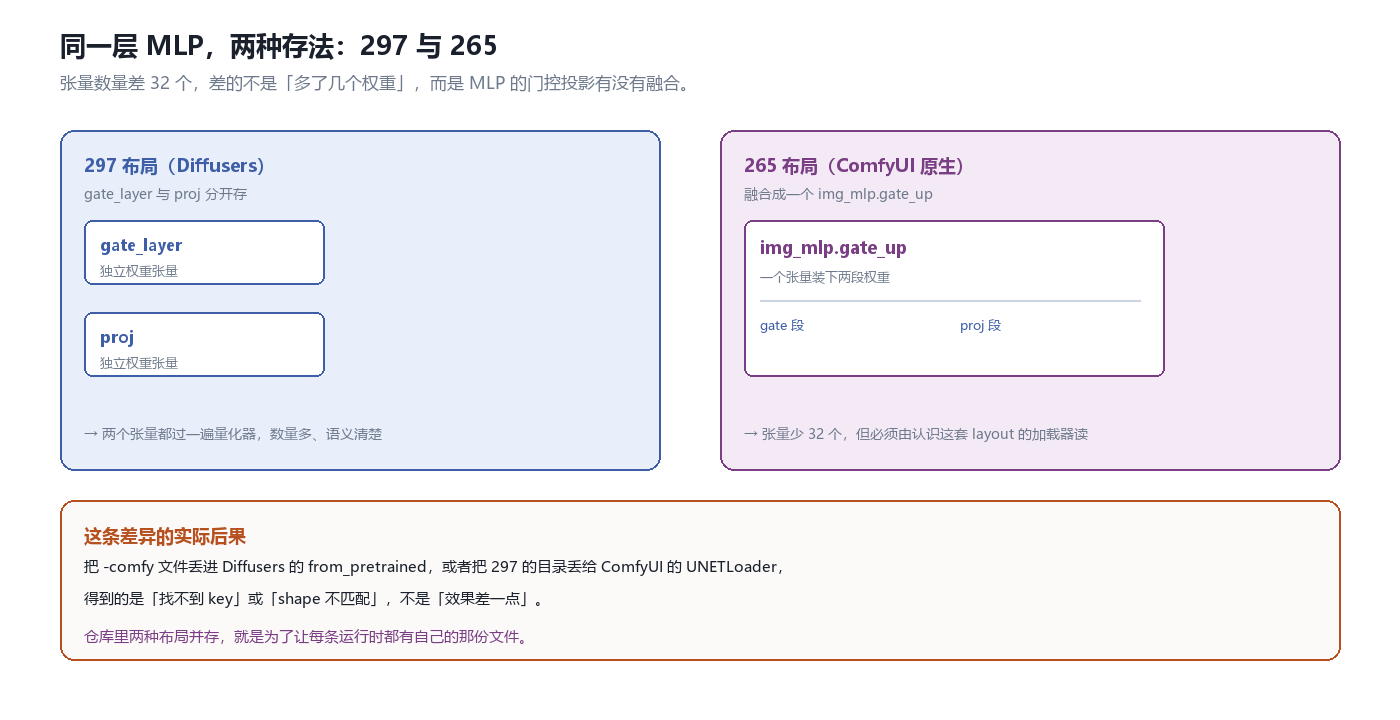
张量数差 32 个,差在 MLP 的门控投影有没有融合。
这是整个仓库最硬的一处工程细节,也是最容易被忽略的。
Diffusers 的 297 布局里,MLP 的门控投影拆成两个独立张量:gate_layer 和 proj。ComfyUI 原生量化用的 265 布局把它们融合成一个 img_mlp.gate_up——一个张量装下两段权重。
后果不是“效果差一点”,而是直接加载失败:
- 把
-comfy.safetensors丢进 Diffusers 的from_pretrained→ 找不到 key; - 把 297 的目录丢给 ComfyUI 的
UNETLoader→ shape 不匹配。
所以仓库同时提供两套文件,不是冗余,是让每条运行时都有自己的那份契约。
顺带说,GGUF 是唯一能跨两端的格式:ComfyUI 用 Unet Loader (GGUF),Diffusers 用 from_single_file。这也是文档把“ComfyUI,一个文件,两个工作流”标成首选的 GGUF 的原因。
四、dtype 和参数里的三个暗坑
坑一:INT8-bnb 要用 float16 加载。 这个构建把非量化张量存成 FP16,所以 pipeline 和 transformer 都必须用 torch_dtype=torch.float16——统一用 bfloat16 会在运行时报 dtype 不匹配。
坑二:关掉 VAE tiling。 文档原话是:分块解码(tiled decoding)会产生可见的竖向色带。对图像模型来说,这类“默认开启但会毁掉画质”的选项比任何参数都危险。
坑三:负向提示词必须给一个空格。 留空或省略,会让 true CFG 即使在 true_cfg_scale=5.0 时也不生效。想“不用负向词”的正确写法是 negative_prompt=“ ”,不是删掉这一行。
推荐参数(官方的网格搜索结果):35 步、true CFG 5.0、er_sde + simple、768×1152 或 1024²、KV cache 开。另外文档特意澄清:这是普通 LoRA 合并,没有做少步蒸馏,所以不要指望 4 步、8 步出图。
五、LoRA 合并:把适配器折进权重
数学部分很短:
\[W' = W + \alpha \cdot BA\]其中 $B$、$A$ 是 LoRA 的低秩分解(rank 128),$\alpha$ 是合并强度(这里是 1.0),$W’$ 是合并后的权重。
合并的意义在推理侧:不需要在运行时单独加载 adapter,也不需要在 prompt 里加触发词。代价是失去了“调强度”的能力——strength 已经被烧进权重里了。
仓库覆盖了 224 个模块。有意思的是不同量化构建的模块数不一样:Comfy FP8 报 229 个,NVFP4 报 192 个“融合模块”。这不是笔误,而是融合会改变算子边界:两段权重合成一个张量之后,量化器看到的是 192 个更大的单元,不是 229 个小的。
这也解释了为什么不同构建之间的质量差异不能只按“位宽”排序——同样的 4 bit,分组方式(ConvRot group size 256、NVFP4 的 fused layout、NF4 的 double quantization)完全不同。
六、架构:为什么是 Single-stream
底座 Qwen-Image-2.1 的三个设计决定了这个量化版能做什么:
Single-stream DiT。 32 层 Transformer,文本 token 和图像 token 放进同一条序列里做 block-causal attention,而不是两套网络各处理一半。这让“编辑”变成了一种 prompt 而不是一个额外的模块——同一个模型既能生成也能改图。
Qwen3-VL 8B 当文本/视觉编码器。 这部分在所有构建里都没有被量化,原样从基础仓库取。所以 12 个构建之间的差异,全部来自 Transformer。
RGBA VAE。 64 通道,包含 alpha。这意味着原生支持透明背景生成和透明图层编辑。对图标、素材、设计工具来说是实打实的能力差异,而不只是“多一个通道”。
再加上 Flow Matching 做调度:从噪声出发,逐步预测向目标分布移动的方向,最后交给 VAE 解码。
七、量化省了什么,没省什么
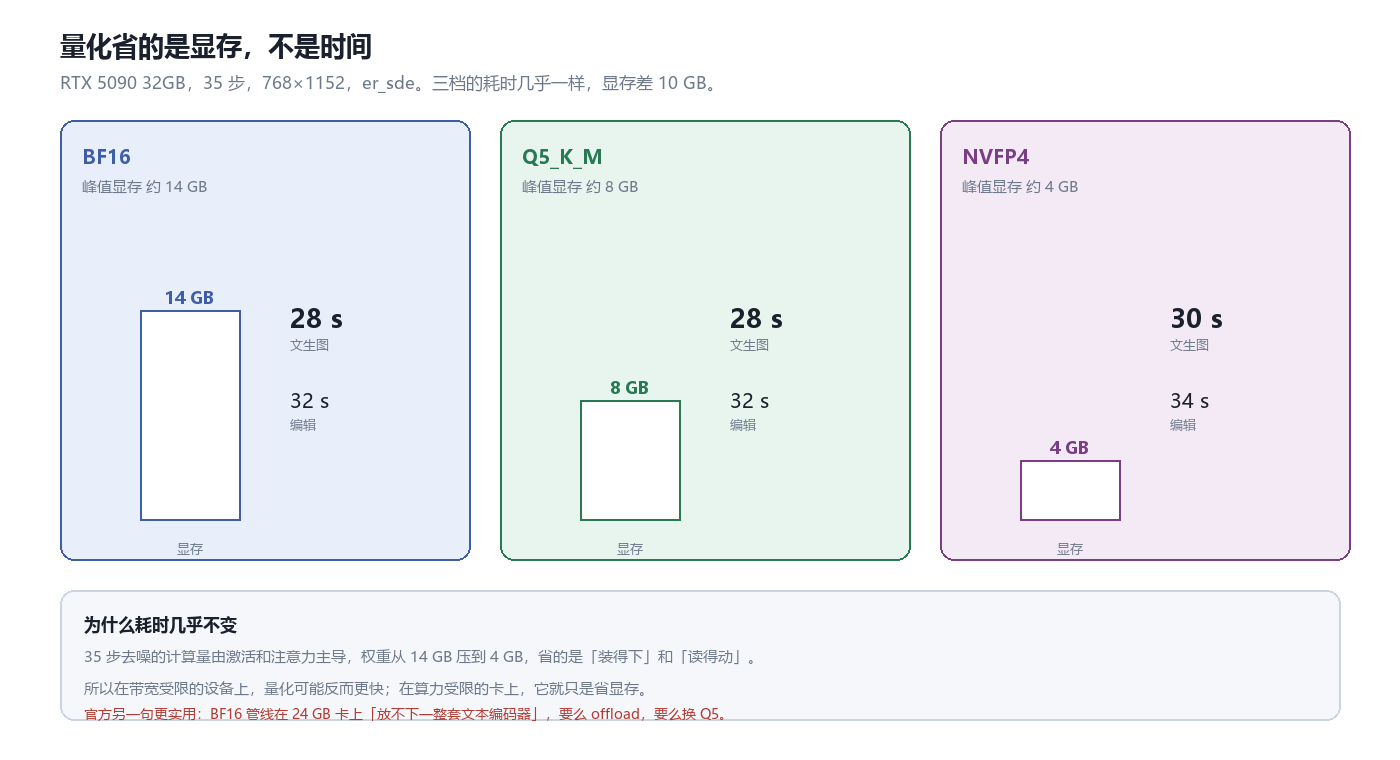
RTX 5090 32GB,35 步,768×1152,er_sde;左列显存,右列耗时。
官方实测(单卡 RTX 5090,35 步,768×1152):
| 构建 | 峰值显存 | 文生图 | 编辑 |
|---|---|---|---|
| BF16 | 约 14 GB | 约 28 s | 约 32 s |
| Q5_K_M | 约 8 GB | 约 28 s | 约 32 s |
| NVFP4 | 约 4 GB | 约 30 s | 约 34 s |
显存从 14 GB 降到 4 GB,耗时反而多了 2 秒。
原因不难理解:35 步去噪的计算量由激活和注意力主导,权重从 14 GB 压到 4 GB,省的是“装得下”和“读得动”,不是“算得快”。在带宽受限的设备上量化可能更快,在算力受限的卡上它就只是省显存。
这条结论对选型很关键:如果你的卡装得下 BF16,就不要为了“更快”去下 4 bit——你只是换来了更小的文件,可能还丢了精度。量化真正的用途是:让本来装不下的卡装得下。
文档里还有一句更实用的:BF16 管线和完整文本编码器在 24 GB 卡上放不下,要么用 CPU offload,要么换 Q5。而编辑和 ControlNet 还要额外几 GB 的参考/控制 latent。
八、评测:三行数字,三种含义
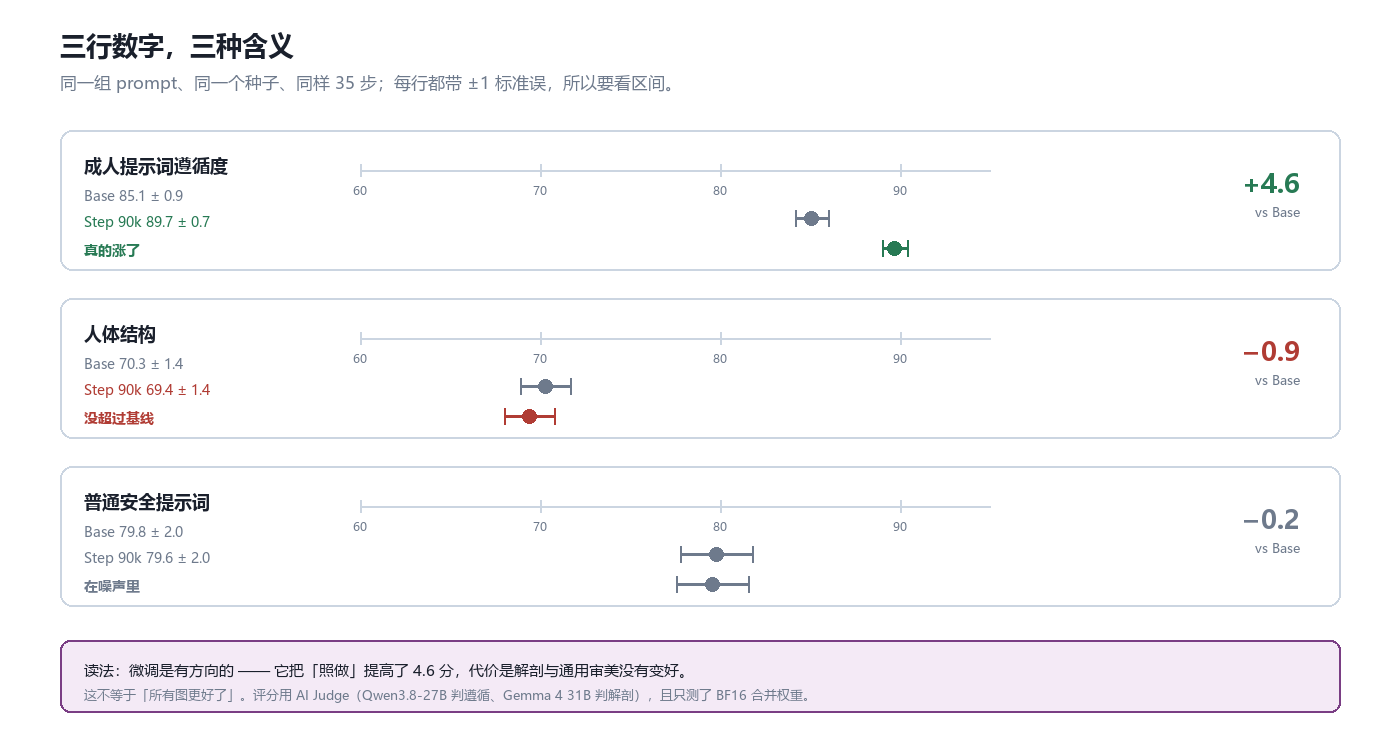
同一组 prompt、同一个种子、同样 35 步;每行带 ±1 标准误,所以要看区间。
| Benchmark | Base | Step 32k | Step 90k |
|---|---|---|---|
| 成人提示词遵循度(960 张) | 85.1 ± 0.9 | 87.4 ± 0.8 | 89.7 ± 0.7 |
| 人体结构(960 张) | 70.3 ± 1.4 | 67.7 ± 1.4 | 69.4 ± 1.4 |
| 通用安全提示词(300 PartiPrompts) | 79.8 ± 2.0 | 75.8 ± 2.2 | 79.6 ± 2.0 |
三行要分开读:
- 第一行真的涨了:+4.6,且误差区间不重叠。
- 第二行没超过基线:69.4 对 70.3,落在噪声里但方向不对。作者自己写了“两个检查点都没有在人体结构上超过基线”。
- 第三行回到了基线:中间那个 32k 检查点掉了 4 分,到 90k 才追平。
所以正确的结论是:这次微调是有方向的——它把“照做”提高了,代价是解剖与通用审美没有变好。 它不等于“所有图都更好了”。
还有三条限定必须一起说:
- 分数来自 AI Judge(Qwen3.8-27B 判遵循、Gemma 4 31B 判解剖),不是人工评测;
- 只测了 BF16 合并权重,12 个量化文件没有单独评分;
- 关于名字里的 “uncensored”,模型卡的原话是:它描述的是发布意图,不保证每个概念都能被渲染出来;结果取决于 prompt、你加载的构建,以及跑它的应用。
九、跑起来:ComfyUI 的最小闭环
ComfyUI(官方在 0.39.0 / commit b0b7435、前端 1.53.6 上验证过):
ComfyUI/models/
├── diffusion_models/   qwen-image-2.1-step90000-Q5_K_M.gguf
├── text_encoders/      qwen3vl_8b_int8_convrot.safetensors   ← Comfy-Org 提供
└── vae/                qwen_image_2.1_vae_bf16.safetensors   ← Comfy-Org 提供
GGUF 用 Unet Loader (GGUF);原生量化用 Load Diffusion Model;编辑时参考图走 Text Encoder (Qwen-Image) 的 edit 模式。官方还附了一个 9 个节点全部内置的 workflow_example.json,拖进 ComfyUI 就能跑。
Diffusers(GGUF 单文件):
import torch
from diffusers import QwenImage21Pipeline, QwenImage21Transformer2DModel, GGUFQuantizationConfig

transformer = QwenImage21Transformer2DModel.from_single_file(
    "qwen-image-2.1-step90000-Q5_K_M.gguf",
    quantization_config=GGUFQuantizationConfig(compute_dtype=torch.bfloat16),
    config="Qwen/Qwen-Image-2.1", subfolder="transformer",
    torch_dtype=torch.bfloat16,
)
pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", transformer=transformer, torch_dtype=torch.bfloat16,
)
pipe.enable_model_cpu_offload()
这个写法本身就在说明分工:Transformer 从 ChatR Labs 取,其余组件从 Qwen 取。 NF4/FP8 则换成 from_pretrained(..., subfolder=“qwen-image-2.1-step90000-NF4-bnb”)。
十、许可与内容责任:两件最容易被跳过的事
第一,许可不是 Apache-2.0。 这个仓库继承 Qwen Research License,限非商业研究与评估,商用要向权利方单独申请。权重能下载,不等于能进商业 SaaS;再分发也要看上游的署名与条款。
第二,没有内置过滤器。 模型卡明确说这个版本不额外加 prompt 过滤和输出安全检查——这意味着审核责任整个落在应用层。如果要做面向公众的生成服务,你需要在架构里补上:内容审核、权限与配额、滥用检测、日志与申诉通道。这不是“可选的合规装饰”,是这类模型能不能上线的分界线。
顺带说一句边界:本文讨论的是量化与部署工程,不涉及对具体内容的评价或生成。
十一、局限与我的判断
局限按重要性排:
- 许可限制最硬。 非商用,这是所有技术优点之前的门槛。
- 4 GB 不是“到处能跑”。 最小的 NF4 只在 Diffusers 成立,还要 bitsandbytes;ComfyUI 侧最小是 4.20 GB 的 Q4_0 或 NVFP4,且 NVFP4 依赖特定算子。
- 量化不提速。 上面那张表已经说明;指望它加快生成会失望。
- 评测是自测 + AI Judge。 没有第三方复现,也没有跨卡、跨分辨率的质量对比。
- 布局耦合。 297 / 265 两套文件意味着升级 ComfyUI 或 Diffusers 时,可能两边都要重新取文件。
- 微调方向单一。 提升集中在提示词遵循,通用审美与解剖没有改善,甚至略降。
- 仓库 92.5 GB。 全下载不现实,按需取一个构建才是正常用法。
我的判断是:这个项目最值得学的不是“能压到 4 GB”,而是它把“量化”这件事从“一个更小的文件”重新定义成了“一条运行时契约”。
12 个构建听着像堆料,其实每一份都对应一个明确的三元组:(布局, dtype, 加载器)。选错的后果不是效果差一点,而是起不来。这份矩阵本身就是文档——它告诉你这个生态里到底有几种互不兼容的加载方式。
三个可以搬走的点:
第一,把“最小”和“最快”分开问。 量化回答的是“装不装得下”,不是“跑不跑得快”。混着问,最后一定用错。
第二,为每条运行时发布各自的文件,而不是发布一个“通用”文件。 通用格式(GGUF)确实存在,但它不是万能的;把布局差异显式化,比让用户在报错里猜要好。
第三,给评测加误差棒,并且承认没涨的那一行。 这个模型卡写了 ±1 标准误、写了“两个检查点都没超过基线”、还写了“量化文件没参与评分”——这三句话的信息量比整张分数表都大。
如果要给一个下一步:把 12 个构建压缩成一张“能力矩阵”表格——每个构建标出(最小显存、可用加载器、是否支持编辑、是否需要额外包),而不是让人从 12 行文件名里自己拼。这是文档问题,但决定了一个人第一次能不能跑通。
项目与资料
- 量化仓库:chatrlabs/Qwen-Image-2.1-Uncensored-Omni-Quantized(Qwen Research License)
- 基础模型:Qwen/Qwen-Image-2.1
- 配套组件(Comfy-Org 版文本编码器与 VAE):Comfy-Org/Qwen-Image-2.1
- 推理框架:ComfyUI · Diffusers
数据核对:12 个构建的文件名、大小与布局,224/229/192 模块数,量化实现(GGUF 逐块、FP8 E4M3 per-tensor、INT8 ConvRot group 256、NF4 double quantization),显存与耗时表,三行评测与 AI Judge 型号,推荐参数与三个暗坑,以及许可条款,均取自模型卡(核对时间 2026-11-18)。第六节的架构描述(Single-stream DiT、32 层、Qwen3-VL 8B 编码器、64 通道 RGBA VAE)来自基础模型资料,本次未逐项核验,请以 Qwen 官方文档为准。下载量与 like 数取自 Hugging Face API。示意图为根据模型卡重绘;图 4 的区间图按 ±1 标准误绘制,是原始数据的可视化,不是新实验。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- 麦田(Maitian):平台改版那天,不该让每个用户升级一次
- The Software Engineering Handbook:把工程判断写成一份自由度账本
- Hypit:你编辑的是词,秒是编译出来的
- Omni LoRA:一个 671 MB 的修正,要背两个任务
- video-shotcraft:150 个镜头名,就是 Agent 的接口
- Jina-OCR-v1:赢在少写,不在写快
- MNN-Pocket-0.3B:不是把大模型缩小,是从两个预算反推形状
- rust-anything:语言迁移不是翻译,是一场可以判负的比较
- SFT 与 RLHF:教接口,选口味,然后收窄
- Mainline:工程判断该住在 Git 里,不该住在数据库里