video-shotcraft:150 个镜头名,就是 Agent 的接口
124。150。0。
124 张配方卡,150 个镜头,0 个视频生成模型。
这是 video-shotcraft 最反直觉的地方:在一个所有人都想用扩散模型生成视频的年份,它选择了让 Agent 写 React。每一帧都由代码从你自己的截图和文案里画出来。
项目 2026-07-19 建库,到现在 21,014 star、1,933 fork、4 个 open issue,Apache-2.0,TypeScript,仓库 204 MB(大部分是 150 个镜头的预览素材和 demo)。
而我认为它最值得抄的不是“用代码做视频”,而是一个更小、更具体的设计:
它给每一个镜头起了名字。
一、它解决的问题不是“生成”,是“编排”
产品宣传片的成本结构很特殊:难的不是画面,是把画面、文案、节奏、音效对齐到一条时间线上。
| 环节 | 传统做法 | 这里的做法 |
|---|---|---|
| 素材 | 设计师重画 UI | Puppeteer 采真实页面 |
| 动效 | AE 手工打关键帧 | 从 150 个镜头里点一个 |
| 节奏 | 剪辑师对着音乐手动切 | BGM 节拍分析 + 镜头落点 |
| 音效 | 素材库试听 | Freesound 按场景搜索下载 |
| 修改 | 回 AE 改,再导一遍 | 改 React 组件,或进 Workbench |
| 交付 | MP4 | MP4 + 源码 + 可编辑工程 + 剪映草稿 |
它把“创意”留给了选片和文案,把“执行”变成了确定性的渲染。
二、一个镜头,三种表示
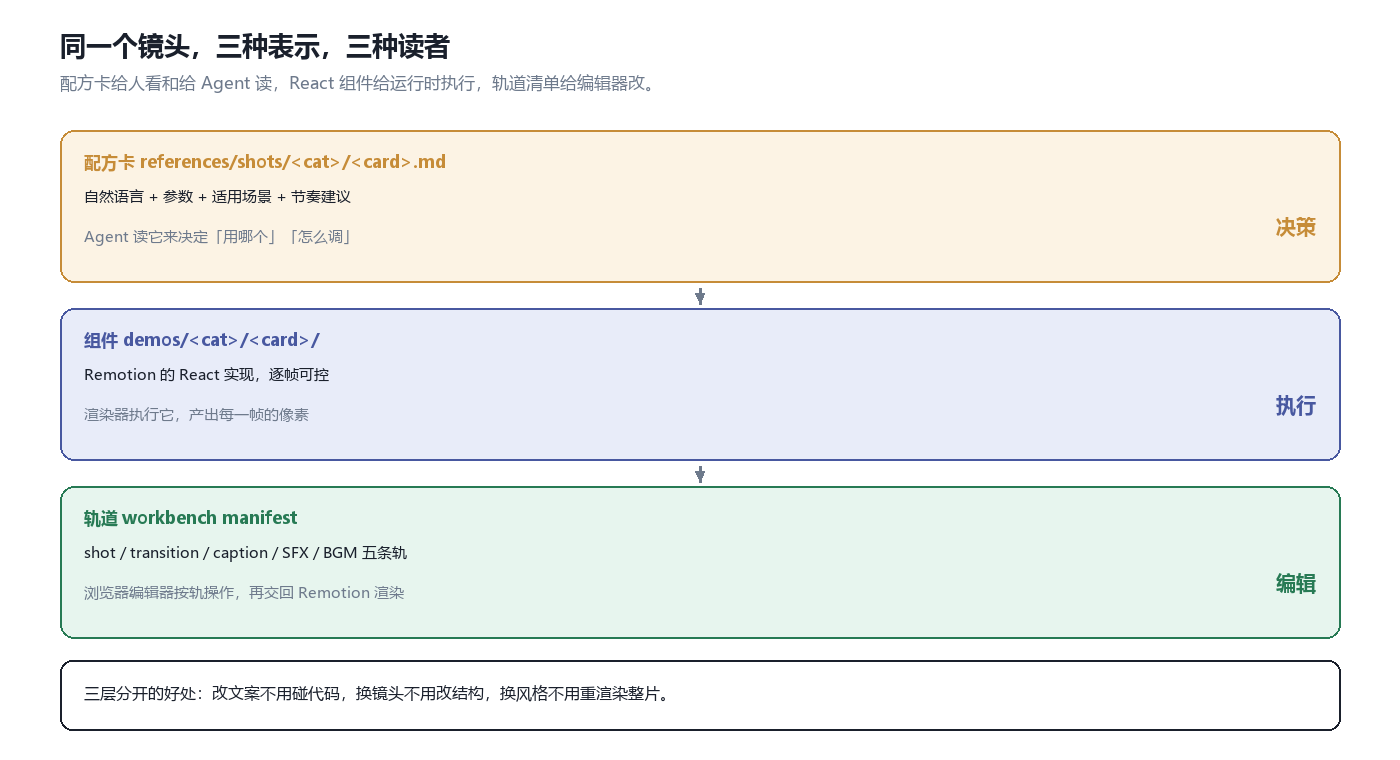
文本给 Agent 读,代码给渲染器执行,轨道给编辑器改。
这是整个项目的结构骨架,理解了它,其他都是细节。
第一层:配方卡(文本)。 每个镜头一份 Markdown,放在 references/shots/<category>/<card>.md。里面写的是自然语言:这个镜头长什么样、什么时候用、节奏怎么走、参数有哪些。这一层的读者是 Agent。
第二层:React 组件(代码)。 对应的 Remotion 实现放在 demos/<category>/<card>/。这一层的读者是渲染器。
第三层:轨道清单(数据)。 Workbench 打开时,影片被拆成 shot / transition / caption / SFX / BGM 五条轨,每条的进出点、时长、参数都是数据。这一层的读者是人和编辑器。
三层分开的直接好处:改文案不用碰代码,换镜头不用动结构,换风格不用重渲染整片。
一个同类项目常见的失败是只有第二层——一堆 Remotion 组件,Agent 靠读代码猜怎么用。配方卡的存在让“选镜头”变成了检索而不是猜测。
三、名字是人和 Agent 之间的接口
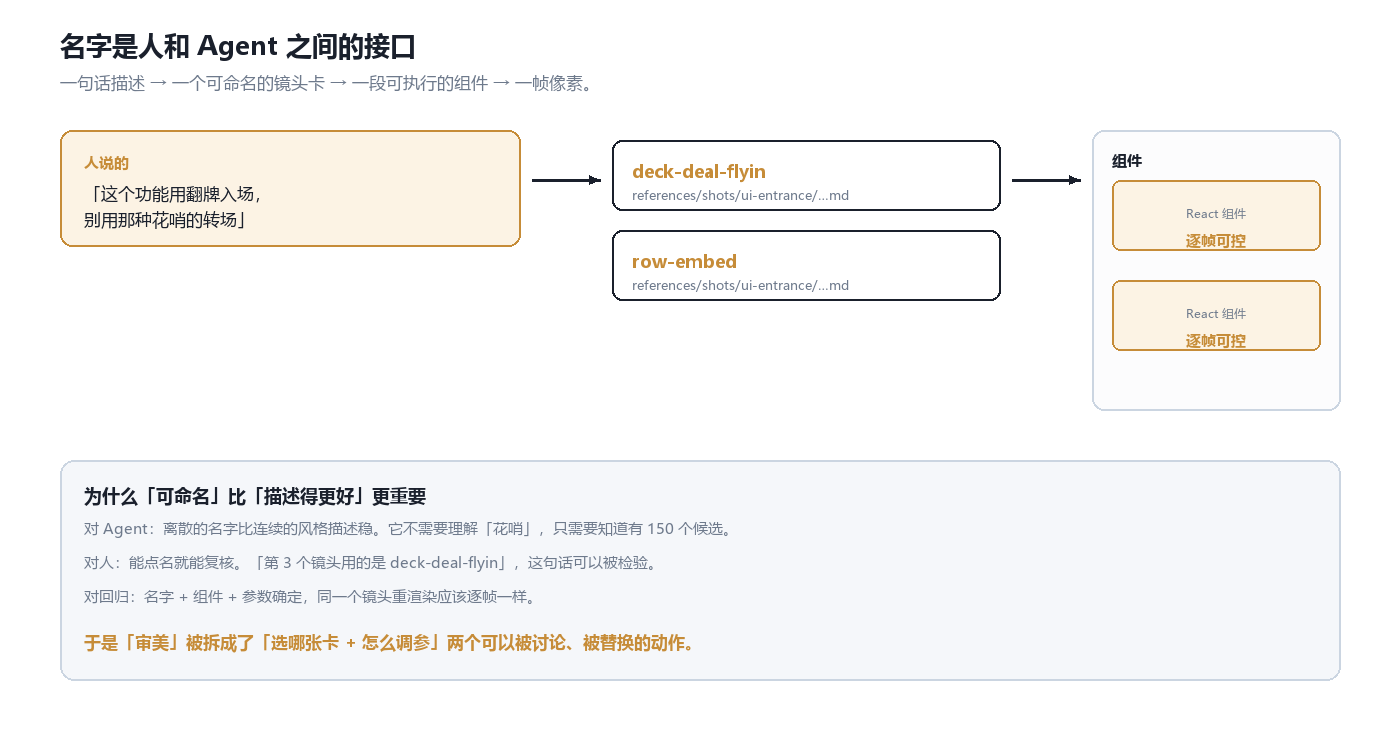
能点名,就能复核;能复核,才敢交给 Agent 自动跑。
这是我写这篇文章的真正理由。
你说“这个功能用翻牌入场,别用花哨的转场”,Agent 拿到的是一个连续的、模糊的风格要求。它得在这个空间里猜。
但如果镜头库里有名字,这句话就变成了两个离散的引用:
Use the deck-deal-flyin and row-embed
shot cards to present this feature.
deck-deal-flyin(发牌式飞入)和 row-embed(行嵌入)是 150 个候选里的两个确定项。Agent 不需要理解“花哨”,它只需要选卡片、读参数、填内容。
可命名带来三件事:
- 对 Agent:离散候选比连续描述稳。选错也容易发现,因为名字会出现在产物里。
- 对人:能点名就能复核。“第 3 个镜头用的是 deck-deal-flyin”这句话是可以被检验的,而“第 3 个镜头挺有质感”不是。
- 对回归:名字 + 组件 + 参数确定,同一个镜头重渲染应该逐帧一样。
于是“审美”被拆成了两个可以被讨论、被替换的动作:选哪张卡,怎么调参。
这也是我认为这套设计可以整体搬走的原因——它对任何“让 Agent 做创意工作”的场景都成立:先把专业判断切成有名字的候选,再让 Agent 在候选集里选。设计规范、PPT 版式、3D 打光、游戏关卡,都是同一个形状。
四、为什么是 Remotion:帧是函数
Remotion 的核心心智模型只有一句:视频的第 n 帧,是 (组件, n) 的纯函数返回值。
const frame = useCurrentFrame();
const opacity = interpolate(frame, [0, 30], [0, 1], {
  extrapolateRight: "clamp",
});
没有时间线,没有关键帧缓存,没有“渲染器状态”。给同一个组件和同一个帧号,永远得到同一张图。
这件事的价值不在“前端工程师好学”,而在于它让视频进入了软件工程的所有基础设施:可以 diff、可以 review、可以测试、可以复用组件、可以参数化、可以进 CI。
对比一下另一条路:扩散模型生成的视频也是“可编辑的”——在它自己的工具里。但它的编辑单位是潜空间或局部重绘,不是“把第 3 个镜头的标题字号从 64 改成 56”。
五、素材从哪来:真实页面
video-shotcraft 用 Puppeteer 打开你的产品页面,采集真实截图,再放进镜头里做 2.5D 相机运动、分解、聚光灯之类的处理。
对软件产品来说这一步很关键:真实的 UI 比设计师重画的 UI 更可信,而且不会出现“宣传片里的界面和产品不一样”这种事故。
三个必须自己检查的点,项目文档也强调了:
- 登录态:需要登录的页面要先准备好会话,否则采到的是登录页。
- 动态内容:骨架屏、加载动画、随机推荐位,换个时间采就是另一张图。
- 敏感数据:客户名、邮箱、头像、真实金额。模板自带的截图只是演示素材,发布前必须换成自己的并做脱敏。
六、节奏:先有音乐,再有落点
音乐这件事,人工剪辑师是“跟着感觉切”,自动化必须把它变成数据。
流程是:用 uv 跑一次性的 Python 脚本做 BGM 节拍分析,拿到小节和重音位置,再把这些时间点映射成镜头切换点和动画关键帧。这样动画不会和音乐完全脱节。
音效走 Freesound:按场景搜索(Logo 出现要 Impact、卡片飞入要 Whoosh、页面切换要 Transition、数据增长要 Digital),下载、试听、按 CC0 / CC BY 过滤,并记录来源与许可证清单。
几个工程细节值得注意:
- 不需要 API key,下载脚本用标准库,分析依赖 ffmpeg;
- 项目移除了共享音效库——每个视频项目自己采、自己记 manifest;
- BGM 只有 5 首,放在
assets/audio/bgm/,附ATTRIBUTION.md。
这个取舍很清楚:音频的授权是按文件走的,所以素材不能做成全局缓存。
七、交付之后:帧级一致的编辑器
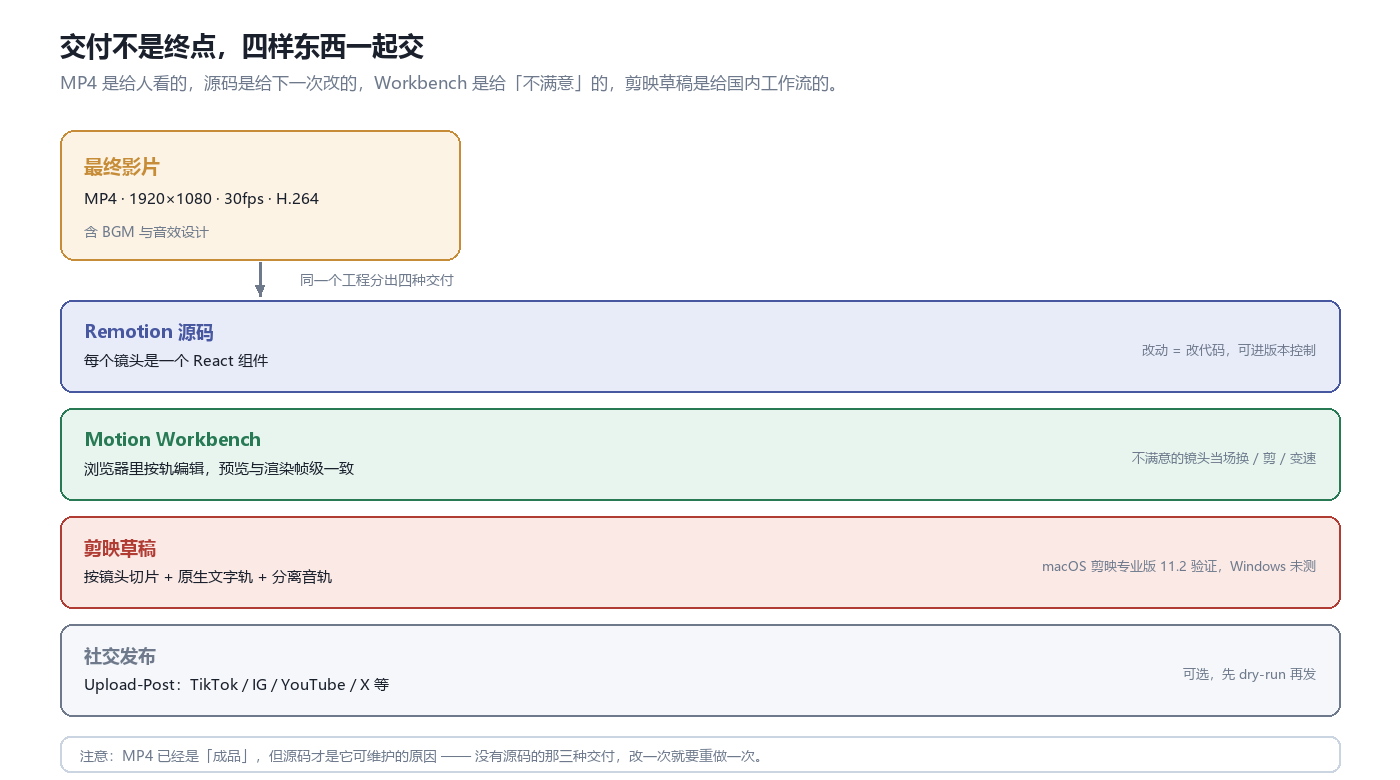
MP4 是给人看的,源码是给下一次改的,Workbench 是给“不满意”的,剪映草稿是给国内工作流的。
交付物不是一个 MP4,是四样东西:
| 交付物 | 内容 |
|---|---|
| 最终影片 | MP4,1920×1080,30fps,H.264,含 BGM 与音效 |
| Remotion 工程 | 完整源码,每个镜头是一个 React 组件 |
| Motion Workbench | 浏览器编辑器,按轨编辑后重新导出 |
| 剪映草稿 | 可选:按镜头切片 + 原生文字轨 + 分离音轨 |
Workbench 的打开方式是一行命令:node workbench/scripts/open.mjs <project>。它把影片拆成 shot / transition / caption / SFX 四条可见轨(BGM 在底下),选中任意镜头就能改文案、字号、颜色,可以移动、裁剪、变速,也可以直接从 150 个镜头库里拖一个新的进来。
它的关键承诺是:预览与渲染帧级一致。
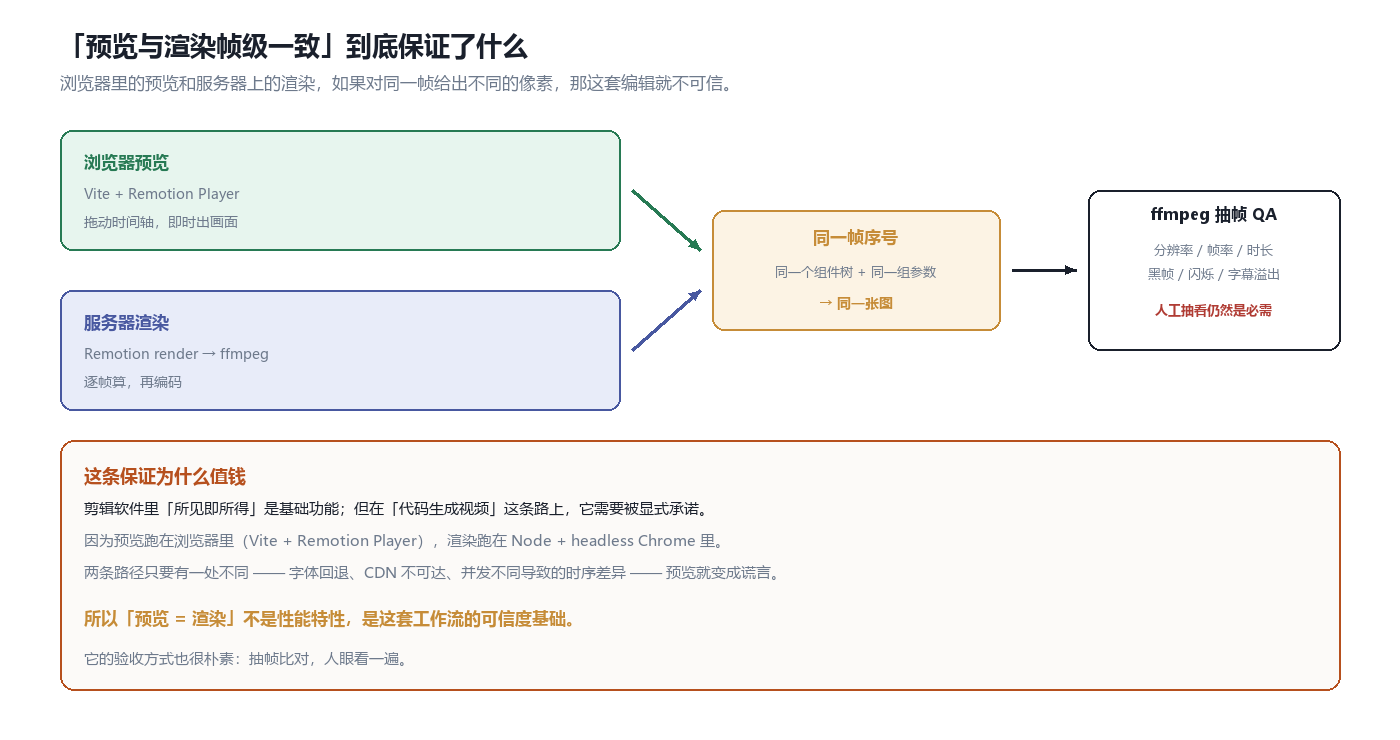
预览跑在浏览器的 Remotion Player 里,渲染跑在 Node + headless Chrome 里,两条路径必须收敛到同一张图。
这句话值得单独拆开,因为它是这套工作流的可信度基础,而不只是一个性能特性。
剪辑软件里“所见即所得”是默认的。但在“代码生成视频”这条路上,预览和渲染是两条不同的执行路径——一条在 Vite + Player 里,一条在 Node + headless Chrome 里。只要有一处不同(字体回退、CDN 不可达、并发导致的时序差异),预览就变成了谎言。
而一旦预览不可信,“人可以在浏览器里精修”这件事就整个塌掉,你只能回到“改代码 → 重渲染 → 看结果”的循环。
剪映草稿导出是国内用户更关心的一项:它输出的不是 MP4 导入,而是按镜头切片的工程——每个镜头一个片段,字幕是原生文字轨,音效和 BGM 分开。README 的目录说明里写得很直白:jianying-export/ 是 mac 已测、win 未测,验证环境是 macOS 上的剪映专业版 11.2。
八、跑起来的三个坑
依赖不复杂:Node.js / npm(Remotion 与 Workbench)、ffmpeg / ffprobe(抽帧与质检)、uv(只用于 BGM 节拍分析)、puppeteer(只用于页面采集,脚本会按需安装)。Remotion 首次渲染会自己下载 headless Chrome。
真正的坑在 headless Linux / CI 上。README 写得很老实,一共三堵墙:
- 并发上限。 低核机器上
remotion still/render会报 “Maximum for –concurrency is 2”,要显式传--concurrency=1。 - 旧 headless 模式被移除。 新版 Chrome/Chromium 删掉了老的 headless,把 Remotion 指向系统 Chromium 会起不来。要用
chrome-headless-shell这种二进制,而不是完整 Chrome。 - CDN 可能不可达。
remotion.media在部分网络环境下拿不到,自动下载 headless-shell 会失败,需要--browser-executable=<本地路径>。
三条都在文档的折叠块里,三条也都能让第一次渲染直接失败。这类“第一次跑就卡住”的信息,比任何特性列表都值钱。
另外,国内克隆慢可以用 AtomGit 镜像,这是 README 里专门给的一句。
九、三层授权,别混着算
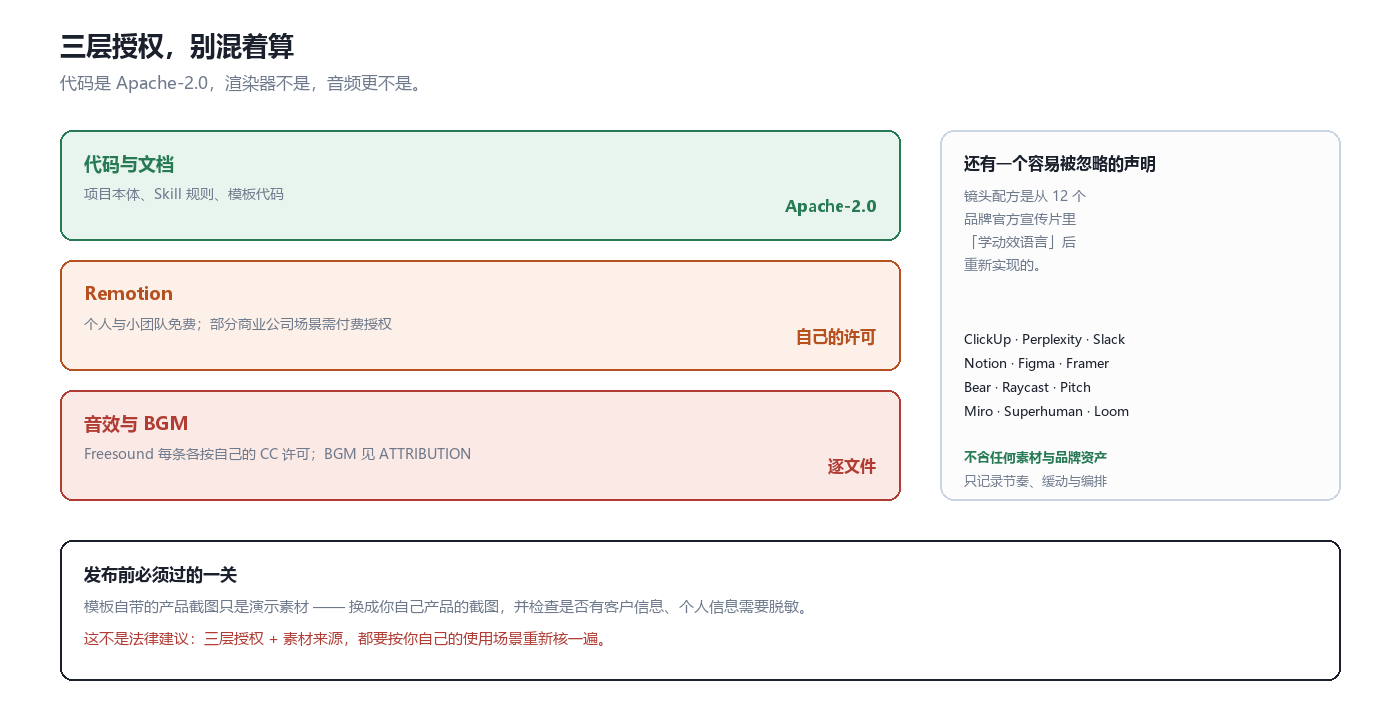
项目是 Apache-2.0,但 Remotion 不是,音频更不是。
这类项目最容易踩的坑不是技术,是授权。
| 层 | 许可 | 要注意什么 |
|---|---|---|
| 代码与文档 | Apache-2.0 | 项目本体、Skill 规则、模板代码 |
| Remotion | 自己的许可 | 个人与小团队免费;部分商业公司场景需付费 |
| 音效与 BGM | 逐文件 | Freesound 每条按自己的 CC;BGM 见 ATTRIBUTION |
还有一段声明我认为很值得单独提:镜头配方是从 12 个品牌的官方宣传片里“学动效语言”后重新实现的——ClickUp、Perplexity、Slack、Notion、Figma、Framer、Bear、Raycast、Pitch、Miro、Superhuman、Loom。文档明确写了:只记录节奏、缓动与编排,不含任何素材与品牌资产,也不存在隶属或背书关系。
这是一个很干净的边界处理方式:学方法,不搬素材,并说清楚学了谁。做 Agent 创作类项目的人可以直接抄这个模板。
最后一句提醒属于产品侧:模板自带的产品截图只是演示素材,换成你自己的,并检查是否有客户信息、个人信息需要脱敏。这不是法律意见,是发布前必须过的一关。
十、局限
按重要性排:
- 它是给软件产品用的。 优势来自“真实截图 + 精确文字”,换成真人实拍、自然风景、复杂 3D,这条路就不划算——那是生成模型的战场。
- 镜头卡是别人的审美。 150 个镜头覆盖了很多常见动作,但风格上限由卡片决定;想做出品牌独有的镜头语言,仍然要自己写组件。
- 剪映导出只测了 macOS。 Windows 端未验证;剪映版本升级也可能破坏草稿格式,这是所有“导出工程文件”类功能的通病。
- 渲染仍然吃机器。 headless Chrome 逐帧渲染,长片 + 高分辨率 + 复杂 3D 变换会很慢;CI 上还要处理上面那三堵墙。
- 自动化替代不了审片。 文案、镜头选择、音量平衡、脱敏,都要人过一遍。项目自己也把 “frame QA” 明确列为流程的一步,而不是可选项。
- 21k star 不代表 21k 用户。 这个数字里有大量“收藏了以后再看”;真正的检验是 showcase 里有多少人真的交付了片子。
- 依赖链较长。 Node + ffmpeg + uv + puppeteer + headless Chrome,任何一环版本漂移都可能出问题。
十一、我的判断
把这几篇连起来看,会发现一个共同的形状:好的 Agent 工具都在做同一件事——把专业判断变成可枚举、可复核的离散选项。
- Mainline 把“为什么这样写”变成可检索的 intent;
- rust-anything 把“改对了吗”变成可重放的案例;
- MNN-Pocket 把“能不能上手机”变成 300 MB 和 200 tok/s;
- Jina-OCR 把“处理一页要多少钱”变成每页 token 数;
- 而这个项目,把“视频好不好看”变成了 150 个可以点名的镜头。
共同点不是“用 AI 做 X”,而是“给 X 找到一个可以被判定的单位”。
顺着这个判断,有三件事可以搬走:
第一,给候选起名字,并让名字出现在产物里。 这样人的指令、Agent 的选择、最终的输出共享同一套词汇,复核成本会降到很低。
第二,把创意产物拆成“配方(文本)/ 实现(代码)/ 编排(数据)”三层。 三层各有各的读者,改一层不影响另一层——这是它能同时服务 Agent 和人编辑器的原因。
第三,承诺“预览 = 渲染”,并把它当验收标准。 这是所有“让 AI 生成、让人来改”的产品都必须回答的问题:人的修改,究竟改的是不是最终产物?
如果要给一个具体的下一步,我会选这个:把这个 Skill 的镜头卡格式(名字 + 场景 + 参数 + 节奏)单独抽成一份开放的 spec。 现在它绑定在 Remotion 和一个仓库里;一旦镜头的描述格式标准化,任何渲染后端(Remotion、After Effects 脚本、甚至 Blender)都能消费同一套卡片,那才是真正的“动效资产层”。
项目与资料
- 仓库:Vincentwei1021/video-shotcraft(Apache-2.0)
- Gallery(150 个镜头的动效预览):vincentwei1021.github.io/video-shotcraft
- Showcase(社区作品):showcase.html
- 姊妹项目(旁白视频,锁定人声节奏):video-talkcraft
- 渲染引擎:Remotion(独立许可)
- 音效来源:Freesound(逐文件 CC 许可)
安装三条路:直接让 Agent 装(把仓库链接丢给它)、npx skills add Vincentwei1021/video-shotcraft、或 clone 后 ln -s 到 ~/.claude/skills/ 与 ~/.codex/skills/。国内克隆可用 AtomGit 镜像。
事实核对:星标 / fork / 建库时间 / 许可证取自 GitHub API(核对时间 2026-11-18);124 卡 / 150 镜头 / 十类分布、Workbench 命令与帧级一致、剪映 mac 已测 win 未测、headless Linux 三堵墙、四类交付物、三层授权与 12 个品牌的方法来源声明,均取自仓库 README 与目录说明。示意图为根据文档重绘,非项目原图;文中对“名字即接口”的分析与第十一节的分层判断是我的解读,不是项目表述。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- Jina-OCR-v1:赢在少写,不在写快
- MNN-Pocket-0.3B:不是把大模型缩小,是从两个预算反推形状
- rust-anything:语言迁移不是翻译,是一场可以判负的比较
- SFT 与 RLHF:教接口,选口味,然后收窄
- Mainline:工程判断该住在 Git 里,不该住在数据库里
- Intent-System:它不信任 AI,所以把流程搬出 AI 的上下文
- vLLM:每次重写,改的都是同一本显存账
- Diagram Design:50 种图表是目录,能拒绝你的检查才是产品
- gpu-unlock:GeForce 的半速矩阵算力,写死在八个 4 位字段里
- Octop:单进程是它的地基,也是它的天花板