Omni LoRA:一个 671 MB 的修正,要背两个任务
671 MB。4.7%。224。
第一个是 adapter 的大小,第二个是它相对底座的参数占比,第三个是它改动的模块数量——32 个 transformer block,每块 7 个投影,每个投影一对 A/B,一共 448 个张量。
而它要同时干两件事:文字生成图片,和按文字改图片。
这就是 Qwen-Image-2.1-Uncensored-Omni-LoRA-v0.1:ChatR Labs 在 Qwen-Image-2.1 上训的 rank-128 adapter,2026-10-12 发布,52,762 次下载、106 个 like。
名字里的 “Omni” 容易让人以为它全能。但把它的评测数字摊开看,会发现一个更有意思的事:v0.1 也就是第 32,000 步那个检查点,在把“照做”提高 2.3 分的同时,把普通提示词的分数拉低了 4.0 分。
这篇想说的是:这不是训练不充分,这是容量共享的必然代价。
一、LoRA 的几何:只训练一个乘积
先把 LoRA 说清楚,因为后面所有的取舍都来自这个结构。
微调的本质是找一个权重增量 $\Delta W$,让 $W + \Delta W$ 更好。LoRA 的假设是:这个增量不需要满秩,它可以写成两个细长矩阵的乘积:
\[W' = W + \frac{\alpha}{r} \cdot BA\]其中 $B$ 是 $d \times r$,$A$ 是 $r \times d$,$r \ll d$。$W$ 冻结不动,只训练 $A$ 和 $B$。
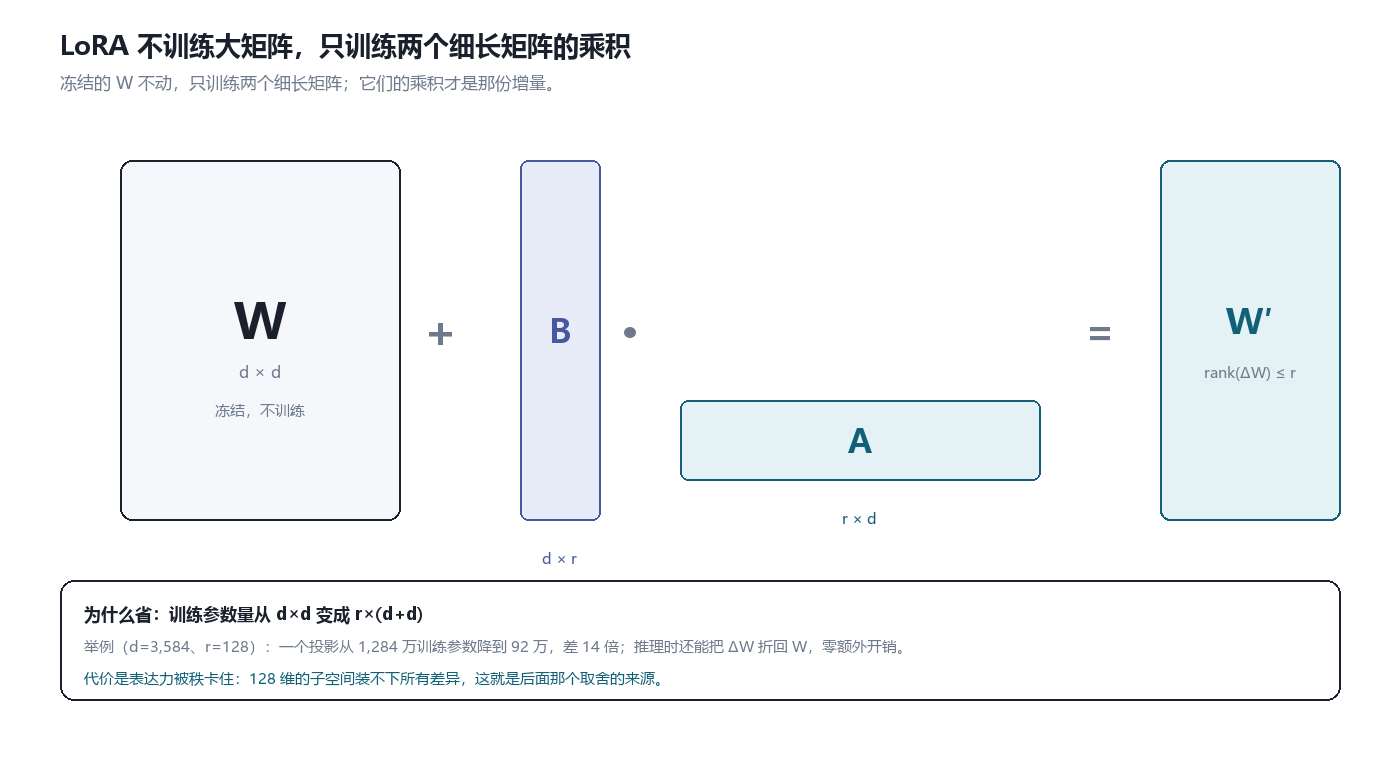
增量被限制在一个秩不超过 r 的子空间里;这也是它便宜、也是它不够用的原因。
省下来的量级很直观:一个 $d \times d$ 的投影,训练参数从 $d^2$ 降到 $2rd$。举例($d=3{,}584$、$r=128$):1,284 万 → 92 万,差 14 倍。而且推理时可以把 $BA$ 折回 $W$,零额外延迟——这一点很多人会误解成“LoRA 推理会慢”,其实合并之后和原模型一样快。
代价同样直接:128 维的子空间装不下所有差异。 你想让模型学会的东西越多、越不一样,这个子空间就越挤。
二、Omni 的含义:一个 adapter,两种输入
“Omni” 在这里不是“全模态”,而是统一处理多个任务。
具体到图像模型,两类任务其实共享了绝大部分计算:
| 文生图 | 图像编辑 | |
|---|---|---|
| 输入 | 文本 | 文本 + 1~3 张参考图 |
| 模型要做的 | 从噪声生成 | 在已有图上做局部修改 |
| 输出 | 新图 | 改过的图 |
| 底座里的路径 | 同一条 | 同一条 |
因为底座是 Single-stream 的 DiT,参考图和文本 token 走的是同一条序列——“编辑”在架构上不是另一个模块,而是另一种 prompt。所以一个 adapter 同时覆盖两者,在结构上是自然的,不需要额外的分支。
这也是为什么模型卡把它写成:“One LoRA for text-to-image generation and image editing.”
三、671 MB 具体改了哪
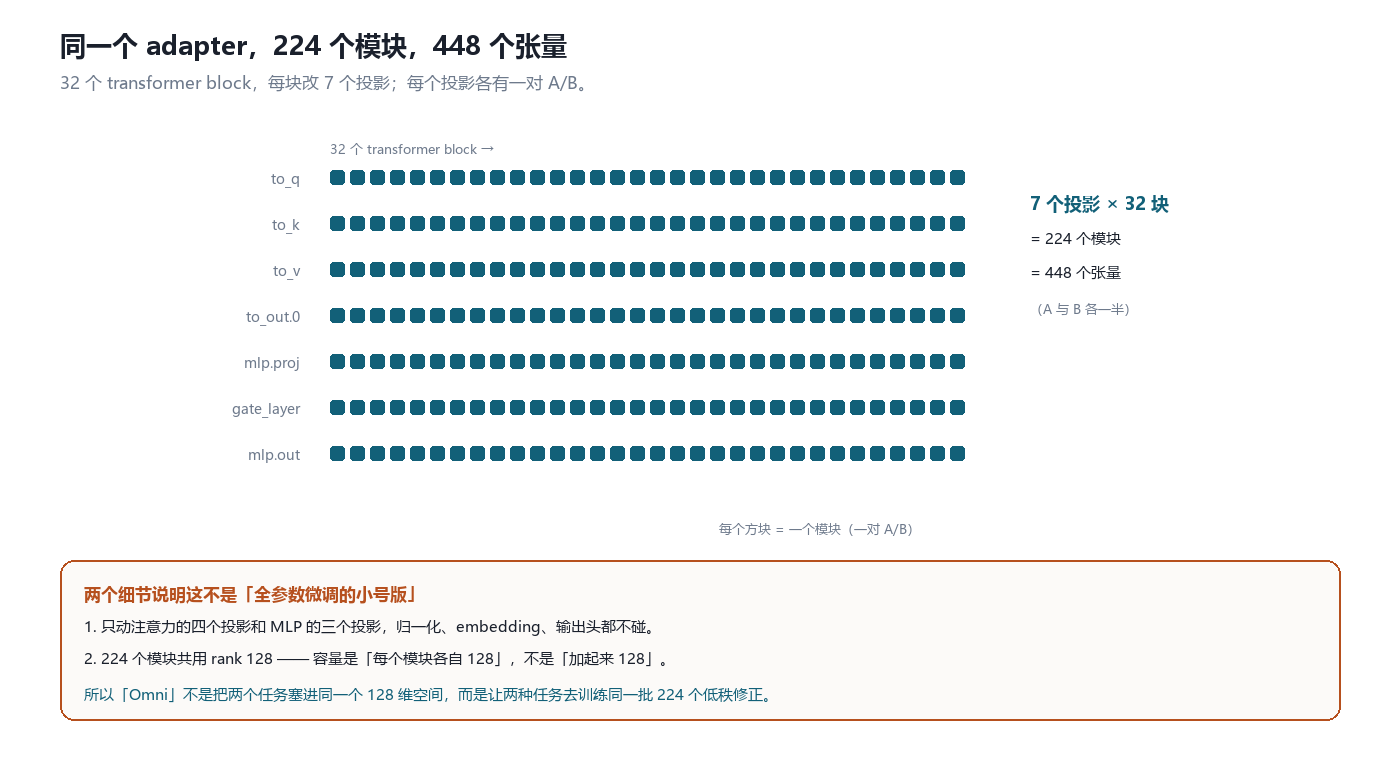
每一行 32 个方块,代表 32 个 transformer block;7 行是 7 个被改动的投影。
官方给的 checkpoint 明细很完整,这是判断一个 adapter 是否“认真做过”的关键信息:
| 项 | 值 |
|---|---|
| Rank / alpha | 128 / 128(alpha/rank = 1.0,折进 lora_B) |
| 适配模块 | 224 个,分布在 32 个 transformer block |
| 目标层 | 注意力 to_q to_k to_v to_out.0;MLP proj gate_layer out |
| 发布张量 | 448 个,BF16 |
| 训练模块 | networks.lora_qwen_image_21 |
| 导出 | Kohya 格式 → Diffusers/PEFT keys |
有三个细节值得单独说:
第一,它不碰归一化、embedding 和输出头。 只改注意力的四个投影和 MLP 的三个投影——这是“改表达”而不是“加知识”位置。
第二,“每个模块各自 rank 128”不等于“整体只有 128 维”。 224 个模块各有自己的低秩子空间,总容量是 224 × 128 维。很多人把这两件事搞混,然后误判 LoRA 的表达力。
第三,alpha 被折进了 lora_B。 所以加载时 strength 设 1.0 就等于训练时的强度;想调弱只能改 adapter_weights,那已经不是“原样使用”了。
四、怎么练的:32,000 步,1.75 个 epoch
训练侧的元数据同样给得很细:
| 项 | 值 |
|---|---|
| 检查点 | step 32,000 |
| 进度 | 8 个计划 epoch 中的约 1.75 个 |
| 每 epoch 步数 | 18,303 |
| 记录的训练样本 | 585,643 条 |
| 训练分辨率 | 1024×1024,开 aspect-ratio bucketing |
| 数据集 | 未发布 |
“1.75 个 epoch”这个数字很能说明问题:它是在训练中途导出的,不是收敛后的最终版本。同一轮训练后来还产出了 step 90,000 的版本(也就是那个量化仓库里合并的权重)。
顺带一个实用提醒:模型卡明确说了它只适配 Qwen-Image-2.1。Qwen-Image、Qwen-Image-2512、Qwen-Image-Edit-2511 的架构不同,不能拿它当底座。
五、代价:容量是共享的
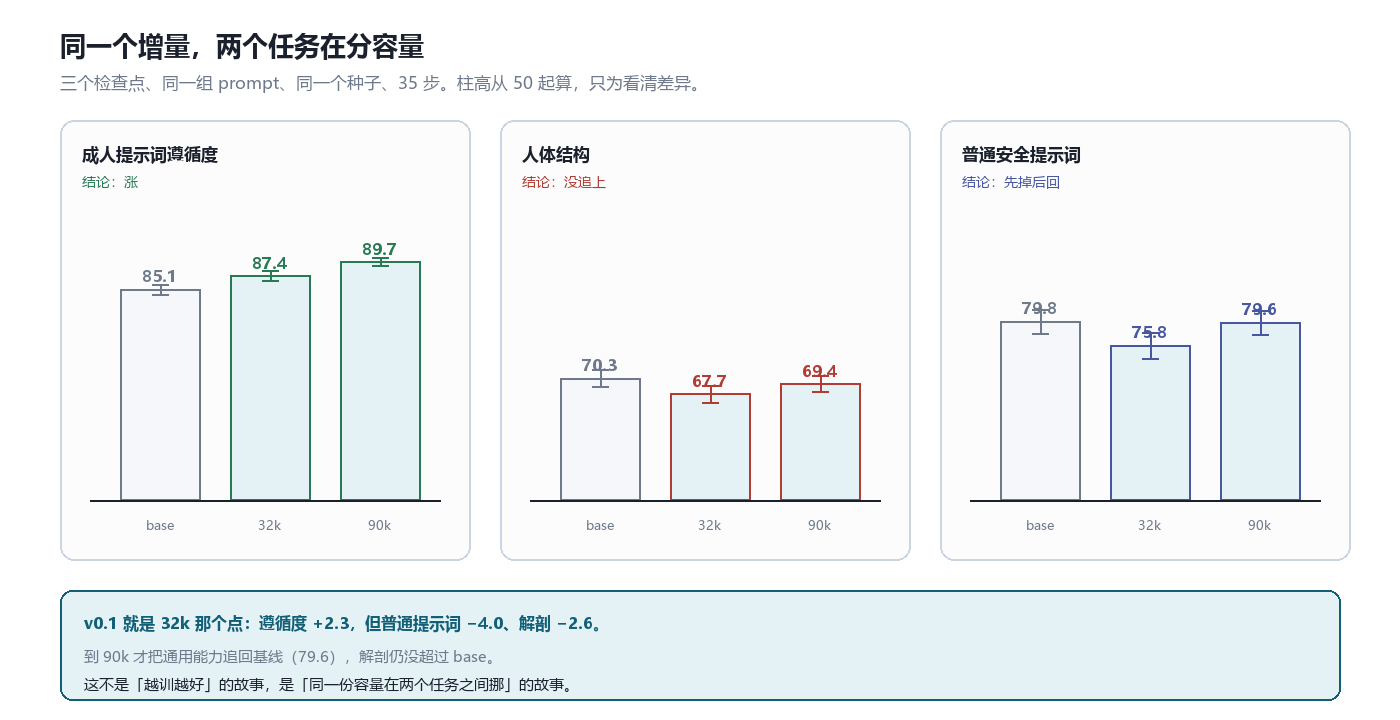
三个检查点、同一组 prompt、同一个种子、35 步;柱高从 50 起算,只为看清差异。
这是全文最重要的一张图。同一轮训练的公开检查点,对着同一个 base 比:
| Benchmark | Base | Step 32k(v0.1) | Step 90k |
|---|---|---|---|
| 成人提示词遵循度(960 张) | 85.1 ± 0.9 | 87.4 ± 0.8 | 89.7 ± 0.7 |
| 人体结构(960 张) | 70.3 ± 1.4 | 67.7 ± 1.4 | 69.4 ± 1.4 |
| 普通安全提示词(300 PartiPrompts) | 79.8 ± 2.0 | 75.8 ± 2.2 | 79.6 ± 2.0 |
读法很关键,因为三行的方向不一样:
- 遵循度是单调涨的:+2.3(32k)→ +4.6(90k),且误差区间不重叠;
- 人体结构从头到尾没超过 base:32k 掉 2.6,90k 才回到 69.4,仍低于 70.3;
- 通用提示词先掉后回:32k 掉 4.0 分(这是它最难看的一行),90k 才追到 79.6。
如果只看“32k vs base”,结论会是“这个 LoRA 让模型变差了”。如果只看“90k vs base”,结论是“通用能力持平、特定能力提升”。
两个结论都对,因为它们描述的是同一条曲线上的两个点。
而这条曲线的形状——先掉后回——正好对应“容量被重新分配”的过程:训练早期,模型把有限的低秩容量挪去学新任务,通用能力先让位;继续训练,它才学会在两个任务之间重新分账。
这也给了一个可检验的预测:如果 rank 翻倍到 256,32k 那个点的通用能力跌幅应该变小。 如果没有变小,说明瓶颈不在容量,而在数据配比。
六、导出与加载:几个容易踩的点
alpha 已经折进 lora_B。 所以你在 Diffusers 里设 adapter_weights=1.0 就是原强度;想要 0.7 的效果得自己调,但那不是作者评估过的配置。
负向提示词必须给一个空格。 留空或省略会让 true CFG 在 true_cfg_scale=5.0 时也不生效。这是 Qwen-Image 系列的通用坑,不是这个 adapter 的。
VAE tiling 要关。 分块解码会产生可见的竖向色带。
它没有少步蒸馏。 35 步起步,别指望 4 步、8 步。
加载只需要三行:
pipe = QwenImage21Pipeline.from_pretrained("Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16)
pipe.load_lora_weights("chatrlabs/Qwen-Image-2.1-Uncensored-Omni-LoRA-v0.1",
                       weight_name="chatrlabs-omni-lora-v0.1-bf16.safetensors",
                       adapter_name="omni")
pipe.set_adapters("omni", adapter_weights=1.0)
然后同一个 pipe,文生图传 prompt,编辑传 image=[...] + prompt。这就是“Omni”在 API 层面的样子:不是两个模型,是两个调用参数。
七、部署现实:adapter 小,不代表好跑
这是一个特别容易误判的地方:671 MB 的下载量让人以为“本地很轻”。
官方 Playground 的实际配置是 两张 RTX 4090 24GB,BF16 管线拆在两张卡上,两个 GPU 一起服务一个请求,并发请求排队。实测(25 步、CFG 4.0;35 步大约乘 1.4):
| 任务 | 输出 | 耗时 |
|---|---|---|
| 文生图 | 1344×768 | 33.2 s |
| 编辑(1 张参考图) | 1024×1024 | 38.4 s |
| 编辑(3 张参考图) | 1024×1024 | 50.5 s |
所以真实成本在底座:LoRA 只省了“训练”,没省“推理”。 671 MB 是增量,14 GB 的底座仍然要装进去;参考图越多,显存和时间越涨。
八、从“一个 LoRA 干两件事”到“让不同 LoRA 分工”
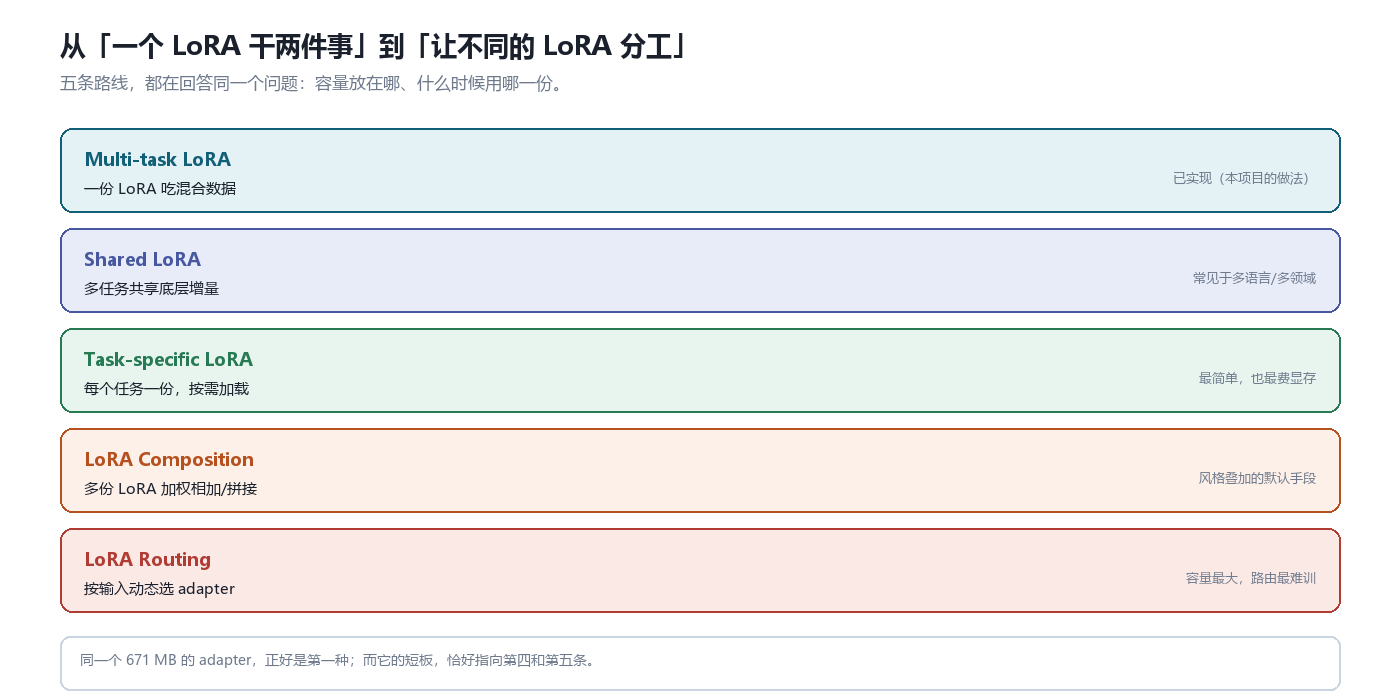
同一个问题,五种答法:容量放在哪、什么时候用哪一份。
这个 adapter 只是其中最简单的一种做法。往旁边看,还有四条路:
| 路线 | 做法 | 代价 |
|---|---|---|
| Multi-task LoRA | 一份 adapter 吃混合数据 | 任务互相挤占(本文的情况) |
| Shared LoRA | 多任务共享底层增量 | 需要设计共享边界 |
| Task-specific LoRA | 每任务一份,按需加载 | 显存与切换成本 |
| LoRA Composition | 多份加权相加 | 强度难调,会互相干扰 |
| LoRA Routing | 按输入动态选 adapter | 路由本身要训,且要防塌 |
我自己的判断是:“一个 LoRA 干两件事”不是终点,而是起点。 它证明了“一个增量可以覆盖两个相关工作流”,但它没有解决“两个任务抢容量”的问题——而后者恰恰是第五条(路由)和第四条(组合)要解决的。
这也解释了为什么这类项目会连续放出 32k 和 90k 两个检查点:同一个实验的两个快照,本身就是一篇关于容量分配的报告。
九、局限
按重要性排:
- 许可非商用。 Qwen Research License,商用要单独授权。这条在技术优点之前。
- v0.1 是中途检查点。 训练到 1.75/8 个 epoch 就导出了;通用能力还没追回来。
- 数据集未发布。 无法复现“两类任务怎么混”这个关键配方。
- 只测 BF16、只测自建测试集。 评测来自 AI Judge(Qwen3.8-27B 判遵循、Gemma 4 31B 判解剖),没有第三方复现。
- 推理成本没变。 671 MB 的增量不改变 14 GB 底座的显存需求。
- 没有任务开关。 一个 adapter 同时背着两个任务,你没法在推理时“只启用编辑”那部分能力。
- 只用 224 个模块。 更深的层、更多的投影都没碰;如果瓶颈在容量,这里是第一个该扩的地方。
十、我的判断
把 LoRA 讲成“省显存的微调技巧”是准确的,但漏掉了它真正有意思的部分:它把“模型该怎么变”压缩成了一个有明确预算的对象。
671 MB、rank 128、224 个模块——这三个数字一旦定下来,能学多少东西、能同时干几件事,就基本被决定了。所以“Omni”这个词的价值不在于营销,而在于它把一个隐含的取舍摆到了台面上:你想让一个增量背几个任务?
三个可以搬走的点:
第一,把 adapter 当成“容量预算”而不是“补丁”。 一个 671 MB 的修正要覆盖两类任务,就意味着每类任务只能分到半个 671 MB 的表达力。评估一个 LoRA 时,先问它背了几个任务。
第二,看检查点曲线的形状,不要只看最后一个点。 32k 掉 4 分、90k 回基线,这条 U 形曲线比“最终分数”信息量大得多——它告诉你容量是怎么被重新分配的。
第三,警惕“小文件”的错觉。 adapter 的大小决定下载量,不决定显存;真正决定能不能跑的是底座、分辨率、参考图数量和推理步数。
如果要给一个具体的下一步,我会选这两个实验:
- 固定数据配比,把 rank 从 128 扫到 256 / 512,看 32k 那个点的通用跌幅是否缩小——这能直接验证“瓶颈在容量”还是“在配比”。
- 训两个 task-specific adapter(文生图一个、编辑一个),与这个 Omni 版在同等总参数量下对比。如果两个专用 adapter 各训各的、加起来还不如一个 Omni,那才是“共享”真正的价值所在;如果反过来,“Omni”就只是一个打包方式。
这两个实验都不需要重训底座,一个 4090 就能起步。
项目与资料
- LoRA 仓库:chatrlabs/Qwen-Image-2.1-Uncensored-Omni-LoRA-v0.1(Qwen Research License)
- 同轮训练的量化合并版:Qwen-Image-2.1-Uncensored-Omni-Quantized(step 90,000)
- 基础模型:Qwen/Qwen-Image-2.1
- 推理依赖:Diffusers、PEFT、Accelerate(仓库附
requirements.txt,锁定了验证过的 revision)
数据核对:671 MB / rank 128 / alpha 128 / 224 模块 / 448 张量 / 32 个 block / 目标层清单 / 32,000 步与 1.75 epoch / 58.5 万条训练样本 / 两张 4090 的部署与耗时 / 三行评测与 AI Judge 型号 / 许可条款,均取自模型卡(核对时间 2026-11-18)。下载量与 like 数取自 Hugging Face API。“4.7% 占比”与“每个模块省 14 倍参数”是我按 671 MB 与 14.23 GB 的 BF16 文件大小算的估算值,模型卡未直接给出;底座 hidden size 等架构细节未在本次逐项核验,示意性举例已在图内标注。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- 麦田(Maitian):平台改版那天,不该让每个用户升级一次
- The Software Engineering Handbook:把工程判断写成一份自由度账本
- Hypit:你编辑的是词,秒是编译出来的
- Omni-Quantized:12 个构建,两套布局,省的是显存不是时间
- video-shotcraft:150 个镜头名,就是 Agent 的接口
- Jina-OCR-v1:赢在少写,不在写快
- MNN-Pocket-0.3B:不是把大模型缩小,是从两个预算反推形状
- rust-anything:语言迁移不是翻译,是一场可以判负的比较
- SFT 与 RLHF:教接口,选口味,然后收窄
- Mainline:工程判断该住在 Git 里,不该住在数据库里