删掉 0.05% 的权重,就能追上全量微调:Deletion Tuning 与一种只做减法的后训练
图片来源:项目仓库
让模型学会新能力,通常意味着往它里面写东西:写新的权重(全量微调)、写低秩增量(LoRA)、写稀疏 delta(稀疏微调)。
这篇论文做了一件相反的事:一个数值都不写,只决定哪些权重应该被清零。
结果有点反直觉。Llama-3-8B 在 GSM8K 上做 GRPO,基座 60.27,全量微调 83.24,而“只删权重”的版本是 83.55;对应的适配器体积是 30,633 MB 对 8.4 MB。Qwen3-30B-A3B 上同样成立:58.43 对 58.54,体积 116,471 MB 对 29.6 MB。
论文是 The Surprising Effectiveness of Deleting Weights in LLM Post-Training(NeurIPS 2026),作者 Jack Lu、Zhenbang Yang、Mike Lasby、Tejas Pote、Yani Ioannou、Mengye Ren,来自 NYU 与 University of Calgary。方法叫 Deletion Tuning。
代码、掩码和实验脚本都开源了:agentic-learning-ai-lab/deleting-weights(MIT),训练好的掩码在 Hugging Face。
这篇文章想讲清楚三件事:它到底怎么学;实验结果有多硬、边界在哪里;以及它对“模型能力到底存在哪”这个问题意味着什么。
一、先把结论和边界说清楚
论文的核心主张是这一句:
把模型不到 0.05% 的权重置零,不做其他任何修改,就能在三种后训练范式上追平全量微调。
三种范式分别是:可验证奖励的强化学习(GRPO)、监督微调(SFT)、在线策略自蒸馏(SDFT)。覆盖两个模型家族、八个骨干,从 0.5B 到 30B 的 MoE。
但“追平”有明确的范围,这一点很多转述会漏掉:
- GRPO 主实验里,只有在每个家族的最大规模上才追平。 Llama1B 上 54.44 对 FFT 的 60.50,差 6 分;Qwen0.5B 差 1.4 分。小模型上论文自己的说法是“恢复 FFT 的 90%–99%”。
- 0.05% 是相对整个模型参数量,不是相对被掩码的那一层的参数量。实测删除比例是 0.035%–0.046%。
- 删除不是剪枝。 剪枝的目标是“删了还能用”,服务于推理效率;这里删除本身就是训练信号,目标是“删了才会”。这个区别决定了后面所有的设计取舍。
二、方法:把微调压缩成“每个权重一个比特”
1. 冻结权重,只学一个符号
给每个目标权重 $W_{ij}$ 配一个同形状的可训练 logit $G_{ij}$。预训练权重 $W$ 完全冻结,前向时乘上一个平滑掩码:
\[\widetilde{W}(t) = W \odot \sigma\bigl(\alpha(t)\,G\bigr)\]其中 $\sigma$ 是 sigmoid,$\alpha(t)$ 是随训练线性上升的“锐度”,从 $10^3$ 升到 $10^4$。这个设计叫 mask sharpening:训练前期掩码是软的,梯度能顺畅地传到每个 logit;训练后期 sigmoid 被拉陡,逼近阶跃函数。
部署时直接用硬掩码:
\[\widehat{W} = W \odot \mathbf{1}[G > 0]\]正 logit 保留预训练值,负 logit 清零。整个适配器就是每个权重一个比特。 论文测过软硬掩码的差距:最多 0.08 个百分点。
这里的可微性是关键。直接学二值掩码没法反传,而用“退火 sigmoid 训练、硬阈值部署”这套组合,既保留了梯度,又保证训练结束时软硬一致。它和 MaskLLM 的双候选 softmax 有直接的代数联系:当候选数取 2、再去掉分组基数约束和采样噪声后,就退化成这里的 sigmoid(附录 F 给了完整推导)。
2. 为什么只挑 gate projection
Transformer 块里能被改的矩阵很多:Q、K、V、O、up、down、gate。论文只动 gate projection,每个块一个矩阵。
理由是 SwiGLU 的结构:
\[\mathrm{down}\bigl(\mathrm{SiLU}(\mathrm{gate}(x)) \odot \mathrm{up}(x)\bigr)\]gate 的输出经过 SiLU 后,逐通道乘在 up 分支上,等于控制了哪些中间通道能被放进 down 投影。删掉 gate 的某个权重,影响的是“通道的门开多大”,而不是直接改某个知识单元。这比动 attention 或 down 投影更“结构化”,也更省参数预算。
MoE 模型上同理:Qwen3-30B-A3B 的 128 个专家里,每个专家的 gate projection 都加掩码,router 完全不动。
3. Wanda 只负责给一个好起点
如果 $G$ 从零初始化,训练一开始的掩码就是随机噪声,搜索空间太大。论文用 Wanda 的重要性分数做先验:
\[s_{ij} = |W_{ij}| \cdot \lVert X_j \rVert_2\]即权重大小乘以输入激活的 L2 范数,$X_j$ 是在任务训练分布上跑一遍校准集得到的。然后按分位数 $\eta = 1/2048$ 把权重分成两拨,分别从两个高斯里采样 logit:
- 高重要性:$G_{ij} \sim \mathcal{N}(0.03,\ 0.01^2)$
- 低重要性:$G_{ij} \sim \mathcal{N}(-0.03,\ 0.01^2)$
初始硬掩码大约删掉 0.18% 的 gate 权重。
重点是:Wanda 只是起点,不是答案。 论文专门做了对照——把 Wanda 单独用(扫八个稀疏度取最好),在六个骨干上最多让精度变化 2.4 分;而训练掩码带来的提升最高到 53.2 分。所以“删得准”不构成解释,“学出来的删除位置”才是。
4. 目标函数里没有稀疏约束
这一点尤其值得说清楚,因为它和很多人的第一直觉相反。损失就是任务损失加上一个很轻的正则:
\[\mathcal{L} = \mathcal{L}_{\text{task}}\bigl(\widetilde{W}(t)\bigr) - \lambda \lVert \widetilde{W}(t) \rVert_2^2,\qquad \lambda = 10^{-5}\]这个正则来自 MaskLLM,作用是轻微偏向“保留幅值大的权重”,相当于一个先验,而不是硬性预算。
没有稀疏度目标,也没有“删得越少越好”的惩罚项。 删除比例是训练自己收敛出来的,最后落在 0.035%–0.046%。这一点很反直觉:如果加一个“尽量多删”的损失,结果可能反而更差——因为模型会去删那些“删了也不影响当前 batch”的权重,而不是“删了能改变行为”的权重。
三、实验结果:0.05% 换来了什么
1. GRPO:规模越大越接近
主实验有两组:Llama3 Instruct 1B/3B/8B 在 GSM8K 上做 GRPO;Qwen2.5 0.5B–14B 与 Qwen3-30B-A3B 在 SimpleRL-Zoo 数学语料上训练,在六个留出数学基准上取平均。基线包括 FFT、LoRA(r=1、r=4)、随机稀疏微调 MTH(99%、99.95% 稀疏度)。
| 模型 | 基座 | FFT | Deletion Tuning | FFT 体积 | 掩码体积 |
|---|---|---|---|---|---|
| Llama1B · GSM8K | 1.21 | 60.50 | 54.44 | 4,714 MB | 1.0 MB |
| Llama3B · GSM8K | 53.53 | 82.49 | 81.49 | 12,256 MB | 3.1 MB |
| Llama8B · GSM8K | 60.27 | 83.24 | 83.55 | 30,633 MB | 8.4 MB |
| Qwen0.5B · SimpleRL-Zoo | 10.44 | 19.01 | 17.64 | 1,885 MB | 0.5 MB |
| Qwen3B · SimpleRL-Zoo | 37.73 | 44.35 | 41.98 | 11,772 MB | 2.7 MB |
| Qwen7B · SimpleRL-Zoo | 40.18 | 51.89 | 52.32 | 29,051 MB | 6.9 MB |
| Qwen14B · SimpleRL-Zoo | 44.37 | 54.87 | 55.43 | 56,343 MB | 11.4 MB |
| Qwen3-30B-A3B · SimpleRL-Zoo | 49.41 | 58.43 | 58.54 | 116,471 MB | 29.6 MB |
几件事值得注意。
第一,曲线是“随规模收敛”的。 1B 上差 6 分,3B 上差 1 分,8B 上反超 0.31 分。这个趋势比单点数字更有说服力:如果方法本身有系统性缺陷,差距不应该随规模单调缩小。
第二,体积差是三个数量级。 Llama8B 上 30,633 MB 对 8.4 MB,约 3,647 倍;30B MoE 上约 3,935 倍。
第三,别把“比 LoRA 小”说过头。 LoRA r=1 在 Llama8B 上是 10.0 MB,Deletion Tuning 是 8.4 MB,同一个量级;真正夸张的对比对象是 FFT。论文的表述是“比 LoRA r=1 更小”,成立,但不是数量级差异。
第四,MTH 在部分格子更好。 Llama1B 上 MTH 99% 拿到 60.73,高于 Deletion Tuning 的 54.44,代价是 68.2 MB 的适配器。这说明“稀疏位置 + 写新值”在极小模型上仍有优势,Deletion Tuning 的卖点不是“所有格子都赢”。
2. 新能力:pass@128 也能拉开
“追平 FFT”可能被解释成“把基座已有的能力调出来了”。pass@k 是对这个质疑的直接回应:如果模型只是变得更“愿意采样到正确答案”,k 增大时基座应该追上来。
| 模型 | 方法 | k=1 | k=2 | k=8 | k=32 | k=128 |
|---|---|---|---|---|---|---|
| Llama8B | 基座 | 53.20 | 66.75 | 83.64 | 92.40 | 95.29 |
| Llama8B | Deletion Tuning | 81.75 | 88.51 | 95.75 | 98.44 | 99.62 |
| Qwen7B | 基座 | 27.35 | 38.75 | 56.18 | 66.26 | 74.01 |
| Qwen7B | Deletion Tuning | 49.39 | 53.22 | 64.64 | 73.23 | 80.08 |
到 k=128,基座仍然低 4.3 分(Llama8B)和 6.1 分(Qwen7B)。也就是说,有些题基座采样 128 次一次都做不对,而删过权重的模型能做对。这是“获得了新能力”最直接的证据形式,虽然它仍然不能排除“能力一直在、只是概率被抬高”的解释——严格区分这两者需要别的实验。
3. 遗忘:这是我认为最有价值的结果
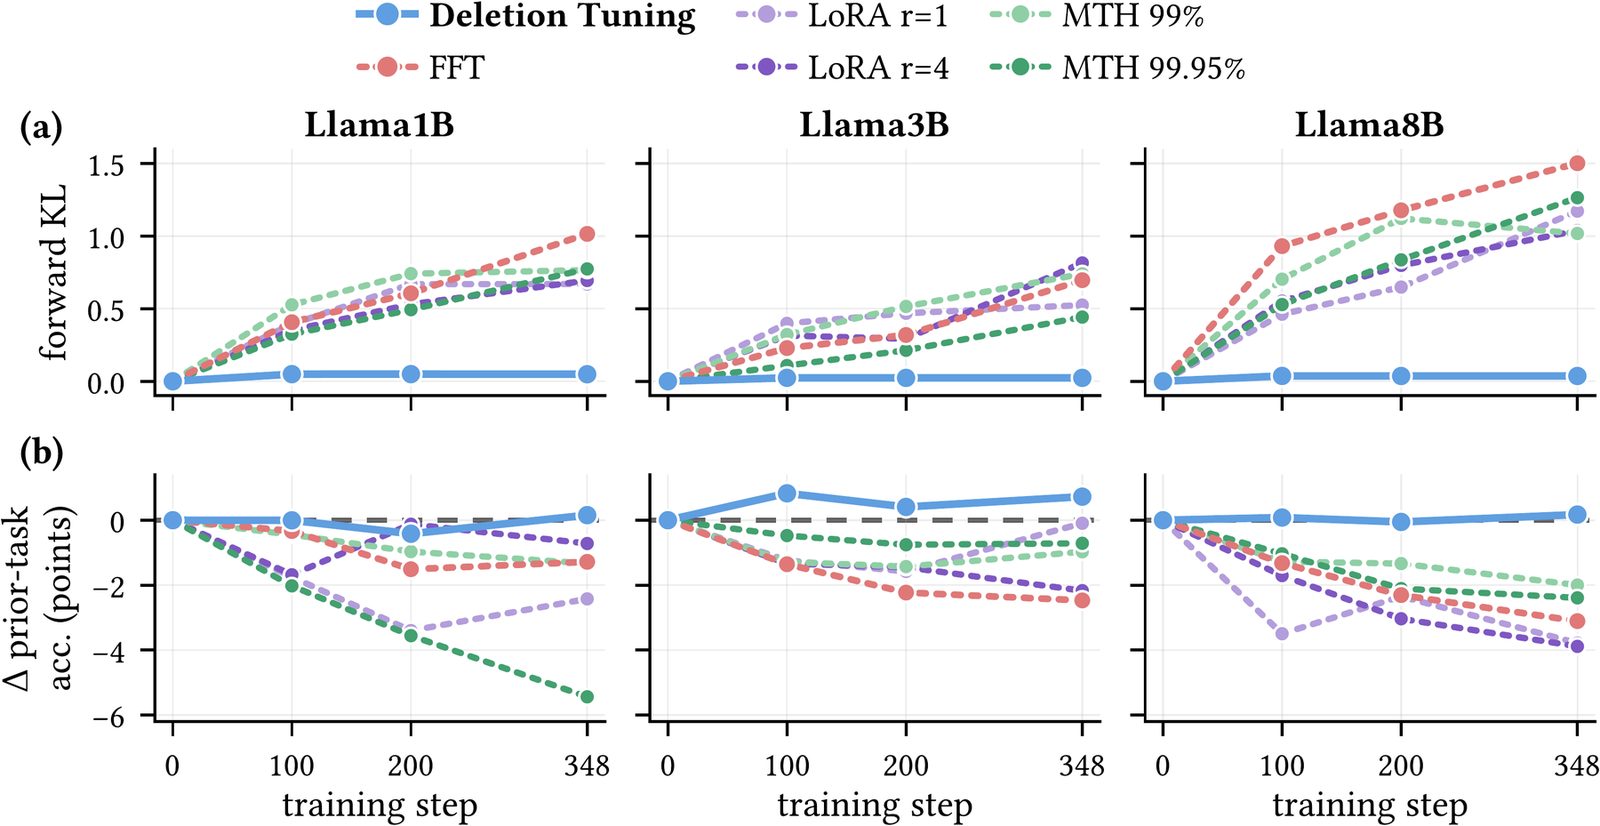
后训练最实际的问题不是“新任务涨不涨”,而是“旧任务掉多少”。论文在 GSM8K 上做 GRPO,同时监控六个先验任务(HellaSwag、MMLU、TruthfulQA、WinoGrande、IFEval、HumanEval)的平均准确率,以及到基座策略的前向 KL。
图片来源:项目主页
- Deletion Tuning 的先验任务准确率始终在基座 ±1 分以内;
- FFT 最终低 1.3–3.1 分;
- LoRA 与 MTH 最多低 5.4 分;
- 前向 KL:Deletion Tuning 全程 ≤ 0.05,FFT 在 Llama1B 上到 1.0、Llama8B 上到 1.5。
前向 KL 是 RL’s Razor 提出的遗忘预测指标,这里它和实际遗忘程度对得上。机制上也不难理解:你只改动模型里极小一部分连接,分布在绝大多数方向上根本没动,遗忘自然小。FFT 的问题不是“学得太多”,而是“改得太散”。
对比之下,MTH 99.95% 训练的参数比例(0.05%)和 Deletion Tuning 删除的比例(0.035%–0.046%)几乎一样,但遗忘明显更重。论文的解读是:关键不只是“改多少”,还有“改哪里、怎么改”——Deletion Tuning 落在非主权重上,MTH 是随机位置。
4. SFT 与 SDFT:并非全胜
GRPO 的更新本身稀疏,Deletion Tuning 天然占优。SFT 是稠密监督,是对方法更严苛的检验。
| 设定 | 基座 | FFT | Deletion Tuning |
|---|---|---|---|
| MMLU-Pro · Llama1B | 10.37 | 16.97 | 18.62 |
| MMLU-Pro · Llama3B | 12.63 | 21.19 | 22.28 |
| BBEH · Llama1B | 2.17 | 8.35 | 5.65 |
| BBEH · Llama3B | 8.87 | 11.39 | 11.39 |
| ToolAlpaca · Qwen7B(SDFT) | 41.24 | 68.04 | 69.07 |
| Science · Qwen7B(SDFT) | 32.35 | 71.20 | 70.61 |
SFT 在 MMLU-Pro 的 14 个学科上按任务各训一个掩码,BBEH 的 23 个子任务同理;SDFT 用 Qwen2.5-7B-Instruct 在 ToolAlpaca 与 Science 上做自蒸馏。
结论要如实说:MMLU-Pro 上 1B 和 3B 都略高于 FFT;BBEH 上 3B 打平、1B 明显落后(5.65 对 8.35);SDFT 上 ToolAlpaca 反超、Science 略低。 这是一个“在多数格子里有竞争力、但存在明确失败案例”的方法,不是万能替代。
四、为什么“只做减法”能奏效
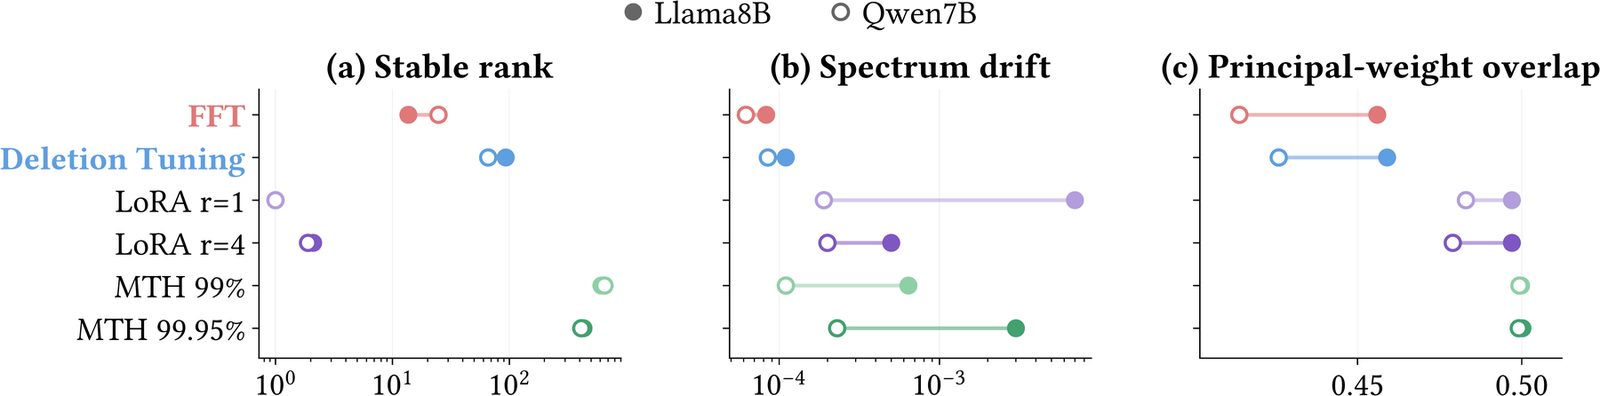
论文没有停在“效果好”,而是去比较各方法学到的权重更新几何。三个指标:
- stable rank(稳定秩):更新用了多少个有效方向;
- spectrum drift(谱漂移):奇异值移动了多远;
- principal-weight overlap(主权重重叠):改动落在基座“主权重”($W_0$ 的 rank-$k$ SVD 重构中幅值最大的那些元素)上的比例。
图片来源:项目主页
结果:
- 谱漂移:Deletion Tuning 在 FFT 的 1.4 倍以内,LoRA 与 MTH 都更远;
- 主权重重叠:Deletion Tuning 0.43–0.46,FFT 0.41–0.46,都低于随机水平 0.5;LoRA 基本贴着 0.5,MTH 也是;
- 稳定秩:Deletion Tuning 最接近 FFT。
低于 0.5 的重叠是个有意思的信号:它意味着更新刻意避开了基座的主权重,和 Zhu et al. (2026) 观察到的“RL 微调落在非主权重上、谱基本不动”一致。
这给了一个还算自洽的解释:RLVR 这类后训练本来就不需要重写知识,它需要的是调整信息的门控方式——哪些通道放行、放行多少。gate projection 正好是干这个的。删掉一部分 gate 权重,相当于在原有表示上做了一次稀疏的、结构化的“路由重排”,而不是往参数里塞新内容。
必须强调,这是相关性证据。论文能说“几何上最像 FFT”,不能说“因此所以有效”。真正的因果链条(删除 → 门控变化 → 特定行为出现)还没有被拆开。
五、工程视角:一个 8.4 MB 的适配器意味着什么
掩码用 bit-packing 打包,再做 zstd 压缩。Llama1B 的掩码 1.0 MB,Llama8B 8.4 MB,30B MoE 29.6 MB。
对工程系统的直接含义:
- 多任务共享一个基座。 一个 base 权重 + N 个掩码文件,切换任务只需换 mask,不需要重新加载一份完整模型。
- 版本管理与分发成本骤降。 一个任务的“权重更新”从几十 GB 变成几 MB,可以像配置文件一样进 Git LFS、制品库、甚至随代码仓库一起发。
- 产物是标准模型。
apply_mask.py把掩码作用到基座后,输出可以被 Transformers 或 vLLM 直接加载的普通 checkpoint。
但有三条边界必须写清楚:
第一,它不加速推理。 权重被置零,稠密矩阵乘法照样要算那些零。要真正省算力,得配合稀疏 kernel 或结构化稀疏格式,这篇论文没有做这件事。它的“轻量”是存储和分发意义上的,不是计算意义上的。
第二,它不省显存。 部署时仍然要加载完整基座,掩码是叠加在基座上的。这不是量化,也不是模型压缩。
第三,掩码和基座强绑定。 换一个基座版本(哪怕只是重新上传的 revision),比特位就可能对不上。这给“掩码即插件”的设想加了一道版本管理约束。
六、和 LoRA、MTH、FFT 到底差在哪
| 维度 | Full Fine-Tuning | LoRA | MTH(随机稀疏) | Deletion Tuning |
|---|---|---|---|---|
| 是否写入新数值 | 是 | 是 | 是 | 否 |
| 可训练参数 | 全部 | 低秩增量 | 选定位置的 delta | 每个权重 1 个 logit |
| 适配器体积(Llama8B) | 30,633 MB | 10.0 MB(r=1) | 26.6 MB(99.95%) | 8.4 MB |
| 位置如何选 | — | 预设层 | 训练前随机定 | 训练中学 |
| 是否限制更新秩 | 否 | 是(r) | 否 | 否(但只减不加) |
| 是否需要预设稀疏度 | — | — | 是 | 否 |
| GRPO 精度(Llama8B) | 83.24 | 83.38 | 83.07 | 83.55 |
| 先验任务遗忘 | 中 | 较大 | 较大 | 小 |
一句话概括差异:LoRA 限制“改多少”,MTH 固定“改哪里”,Deletion Tuning 学习“删哪里”。 三者约束的维度不同,所以可以想象组合——比如先用 Deletion Tuning 找位置,再在位置上做低秩更新——但论文没有做这个实验。
七、没解决的问题
按重要性排:
1. 只改了 gate projection。 每个块只动一个 MLP 矩阵,attention 和 up/down 都没碰。这既是它参数效率高的原因,也可能是它精度上限的来源。放开到更多层会更好还是更差,论文没答。
2. 小模型上不成立。 1B 差 6 分不是小数。如果方法真的依赖“预训练已经学到的表示足够好”,那它在小模型上的失败是可预期的,但也限制了它在端侧场景的适用性。
3. 评测面偏窄。 数学推理、学科知识、工具调用,都是“有标准答案”的任务。开放式写作、长上下文、多语言、代码生成这些更依赖“知识写入”的场景,没有覆盖。
4. 多任务掩码如何共存没有答案。 论文训的是“一个任务一个掩码”。能否把多个掩码合并(取交集?取并集?按任务路由?),冲突时怎么办,都是空白。这恰恰是“共享基座 + 多适配器”落地时最先遇到的问题。
5. 训练成本没有省。 可训练参数少了,优化器状态小了,但前向反向、rollout、验证器打分一样要跑。它省的是存储和分发,不是训练算力。
6. 稳健性有数据,但范围有限。 12 组超参组合内,Llama8B 上都在最优值的 1.6 分内,Qwen7B 上 3.2 分内;初始稀疏度变化 4 倍,精度变化 ≤ 0.8 / 1.7 分。这个范围算稳,但只覆盖了两个模型。
八、总结:从“写什么”到“留哪里”
这篇论文最值得记住的不是”0.05%”这个数字,而是它换了一个提问方式。
过去几年的后训练,主流问题都是“怎么写”:写全量、写低秩、写稀疏 delta。Deletion Tuning 问的是“留哪些”。在这个框架下,预训练权重是不可变的底座,后训练只是在上面做一次极稀疏的选择——选择的结果甚至不需要浮点数,一个比特就够。
这和另一条路线正好互补。之前写过的闭式权重编辑,是在权重里写入一个方向,改的是行为;Deletion Tuning 是从权重里删掉一些连接,改的是门控。两者都在回答同一个问题:模型的能力到底存在哪里,是存在数值里,还是存在连接结构里。
从工程角度看,它给出的东西很具体:8.4 MB 的适配器、基本不掉点的先验任务、能直接被 vLLM 加载的标准模型。从研究角度看,它留下的问题更具体:为什么删 gate 就够了?这个“够”能推广到哪些任务?多任务掩码能不能共存?
至少现在可以确定一件事:让模型获得新能力,不一定要往里加东西。
项目与参考资料
- 论文:The Surprising Effectiveness of Deleting Weights in LLM Post-Training(arXiv:2611.10866)
- 项目主页
- GitHub 仓库
- 训练好的掩码(Hugging Face)
- NeurIPS 2026 Poster
- 相关背景:Wanda(arXiv:2306.11695)、MaskLLM、RL’s Razor(arXiv:2509.04259)、The Multiple Ticket Hypothesis(arXiv:2602.01599)
项目采用 MIT License。本文数据来自论文正文、附录与项目主页;精度均为各方法在验证集上的最佳 checkpoint,适配器体积为对应保存格式的实际大小。实验结论对应论文测试的模型、数据与任务,实际表现取决于基座版本、任务分布与训练配置。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- Blender Kiln:AI 建模缺的不是生成能力,是交付前的度量
- CineCode:每一帧都是时间的纯函数,所以电影可以被检查
- OhMyGame:AI 生成游戏不难,难的是让它自己发现游戏跑不起来
- GPT-2 的一次前向:一条 768 维的向量,被改写 12 次,变成 50257 个分数
- SAELens:重建得越准,特征越不一定是真的
- TokenEconomizer:Coding Agent 的成本按仓库累积,不按任务计价
- Transformer Explainer:把 GPT-2 塞进浏览器,让模型边算边解释自己
- Boubou:本地语音 AI 缺的不是模型,是一层能借给全屋的运行时
- Hy-MT2:把翻译拆成语言家族分头训练,再蒸馏回一个模型
- NNsight:把干预写进前向传播,让同一段代码在 405B 模型上跑