Yogurt:本地优先不是一句承诺,是一组能被算出来的预算
会议助手最容易被忽略的问题不是转录准不准,而是它凭什么算完就必须把录音传上去。
大多数产品的回答是「因为模型在云上」。Yogurt 换了一个回答:把所有预算摆在明面上——实时率 0.5、推荐线 15 tok/s、socket 权限 0o600。三个数字对应三件事:音频跟不跟得上、模型跑不跑得动、别的程序读不读得到。
- GitHub:FrigadeHQ/yogurt(MIT,Copyright 2026 Frigade)
- 文档:
docs/README.md、docs/building.md - 代码口径:
app版本 0.3.28,Electron 44.7.2,node-llama-cpp3.22.1
本文只讲一件事:本地优先在这套代码里不是一句定位,而是一串能被检查的常数与权限位。功能清单在 README 上,比这里好读。
一、三个数字
先看三个数,它们分别来自 packages/picker/src/asr.ts、pick.ts 和 app/src/main/mcp/socket.ts,都不是宣传语:
| 常数 | 值 | 出现在哪 | 它在管什么 |
|---|---|---|---|
KEEPS_UP_RTF | 0.5 | ASR 选型 | 一段音频的「认真读」不能超过它长度的一半 |
MIN_TOK_PER_SEC | 15 | 笔记模型推荐 | 低于这个速度的模型不进「推荐」 |
0o600 | 文件权限 | MCP 的 unix socket | 只有同一个用户账户能打开 |
0.5 是音频的时间预算,15 是生成的时间预算,0o600 是别人的访问预算。这款应用里几乎每一个「能不能」都被换算成了某一个量。
二、它怎么听:不加入会议
Yogurt 不往会议里放机器人。它抓的是这台电脑上的两路声音:麦克风(你这一侧)和系统播放的音频(对方那一侧)。会议软件是 Zoom、Teams、Meet 还是浏览器里的自建页面,对它没有区别。
会议检测也绕开了「接入会议」这条路:它看哪个应用正在占用麦克风,浏览器会议再看标签页标题或附近带会议链接的日历事件,然后弹一句「要不要记」。开始录音仍然要你点一下,不会自己开始;会议结束时它会自己停。
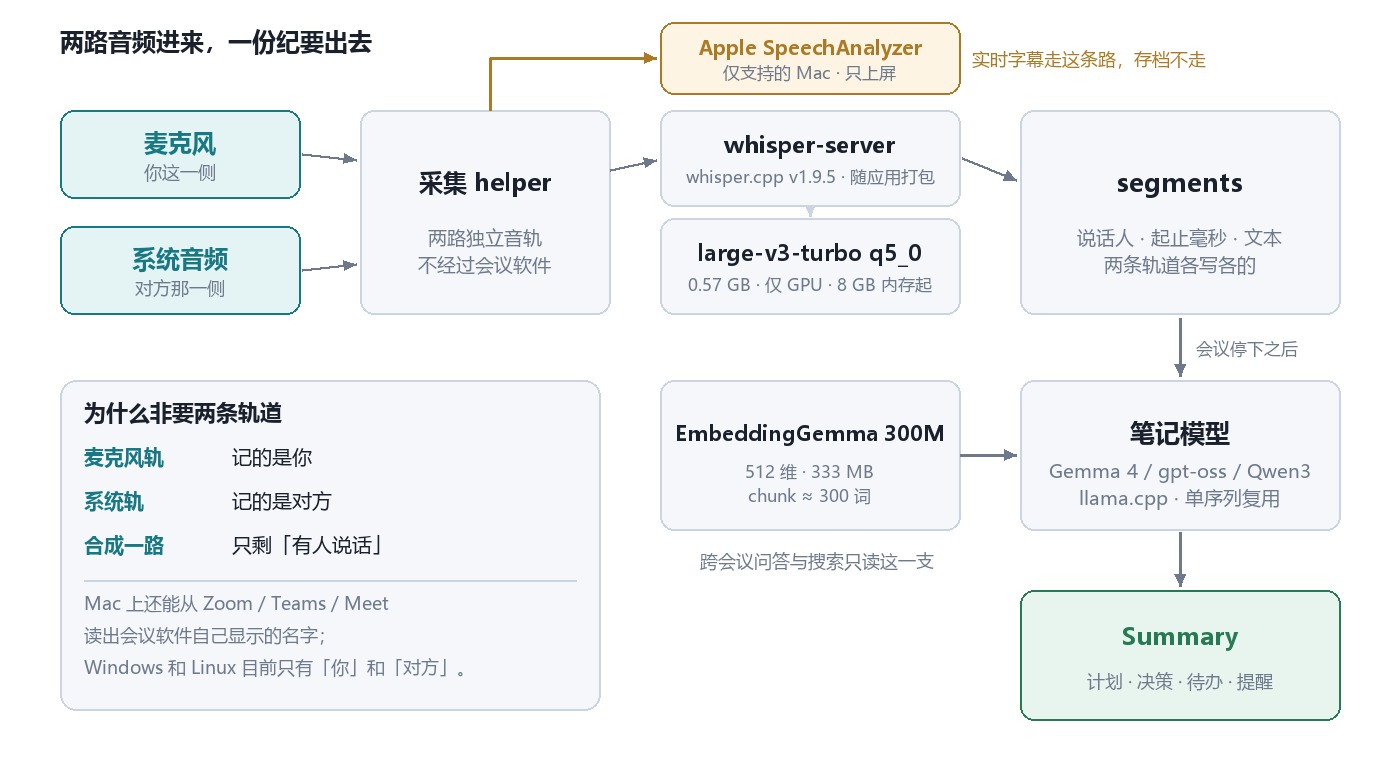
采集分成两条独立音轨,转写、说话人归属和 MCP 的导出都按轨道分开;存档只认 Whisper 的结果。
两条轨道不是实现细节,是说话人归属的唯一来源。如果先混成一路再送进模型,能得到的只有「有人说话」。这也解释了 MCP 里的 get_audio 为什么按 me / them 返回两个文件,而不是一个混音。
Mac 上还能多做一件事:从 Zoom / Teams / Meet 读出会议软件自己显示的发言人名字(需要辅助功能权限)。Windows 和 Linux 目前只有「你」和「对方」。
三、一慢一快,两条转写
同一个会议,Yogurt 用了两套识别:
| 用途 | 后端 | 平台 | 结果去了哪 |
|---|---|---|---|
| 屏幕上的字 | Apple SpeechAnalyzer | 支持的 Mac | 只上屏,不落盘 |
| 存档的转录 | Whisper(turbo / small) | Mac、有显卡的 Win/Linux | segments 与导出 |
README 把这条分工写得很直白:SpeechAnalyzer 供实时字,Whisper 产出保存的转录。这是一个可以借鉴的折中——实时字幕追求延迟,存档追求完整,两者本来就不该共用同一次推理。代价是同一段音频要被听两遍。
Whisper 这一侧走 whisper.cpp,而且 whisper-server 是随应用打包的(catalog 里写着 bundled: true,whisper.cpp 固定在 v1.9.5),所以装的时候不用额外下这个二进制,只下模型:large-v3-turbo 的 q5_0 量化,0.57 GB。
四、0.5:音频能不能跟上
packages/picker/src/asr.ts 里有一句注释解释了 0.5 的来由:一场会议是两条轨道同时在读,所以一个模型要「跟得上」,它把一段音频认真读完的时间最多只能是这段音频长度的一半。
这条线不是在每个平台上都用同一套办法满足:
- Mac 从不测速,按内存挑:8 GB 以上就上 turbo。
- Windows / Linux 没有独显时,turbo 直接被排除,只留 small。理由写在注释里:2 核 CPU 上实测,turbo 要花掉片段长度的 4 到 9 倍。
- Windows / Linux 有显卡时,安装时会真的跑一遍候选模型,按实时率从好到差挑,第一个 ≤ 0.5 的留下,更小的不再测;测完把「CPU 型号 + 核心数 + 显卡」拼成一个 key 缓存起来,换了硬件才重测。
装完发现机器跟不上,Windows / Linux 上的安装会停在这里,而不是让你先记一场糊掉的会。
五、15:模型跑不跑得动
笔记模型这一侧,选型完全是一道内存题。pick.ts 先把机器折算成一个可用池:
| 机器形态 | 池 |
|---|---|
| 统一内存(Apple Silicon) | RAM × 0.7 |
| 独立显卡 | VRAM × 0.95 |
| 显卡 + 系统内存 | split 池,两段相加 |
| 没有 GPU | RAM × 0.5 |
然后判断「装不装得下」:
需要 = 权重 + 0.08 × (ctx / 1024) + 1.5 GB 余量
ctx 只试 16384 和 8192 两档
再估速度:每 token 要读的字节数 ÷ 带宽,乘一个 0.75 的效率系数;带宽按显卡型号查表,查不到就退回 CPU 的经验值。不到 15 tok/s 的模型进不了「推荐」,除非它的 agentScore 比推荐的那个更高,才作为「更聪明」的备选单列;低于 5 tok/s 的连备选都不算。
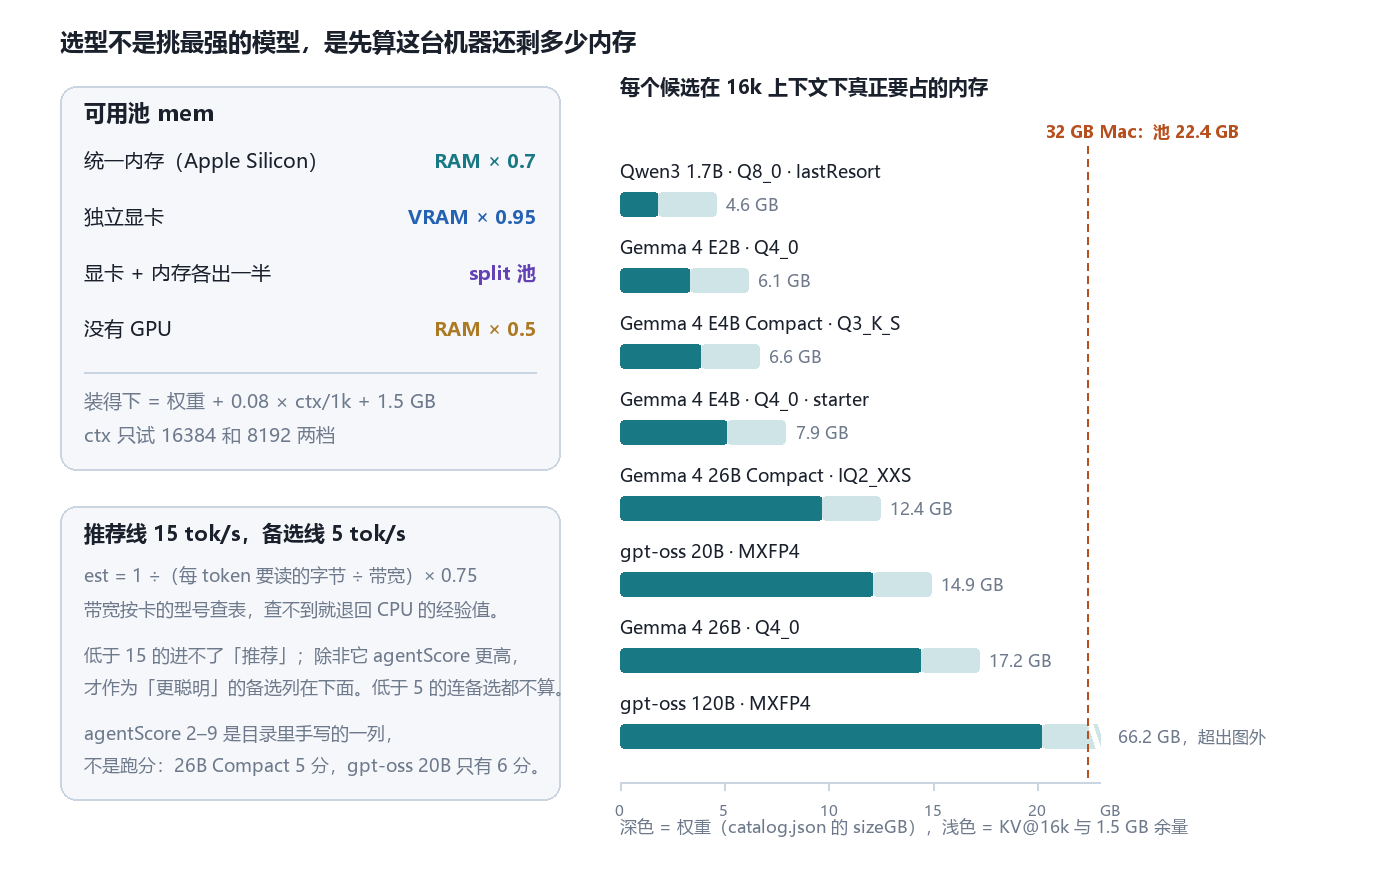
模型阶梯的左边是权重体积,右边是 16k 上下文下真正要占的内存;虚线是一台 32 GB Mac 的池上限。
目录里还有两个细节,说明这不是「把能跑的都列出来」:lastResort 的模型(Qwen3 1.7B、Whisper base/tiny)只在没有更好的能跑时才出现;squeezedOf 的「Compact」是同一个模型的更低比特版本(Q3_K_S、IQ2_XXS),原版能跑时它就不显示。降级路径是被显式建模的,不是运行时才碰上。
六、跑起来之后:一条序列、三级降级
app/src/engine/llm.ts 里能看出本地推理的几个真实约束。
第一,整场会议只有一个上下文序列。注释写得很清楚:一个请求如果和上一个开头相同,就只读新增的那部分。会议纪要这种「同一份长转录、反复问不同问题」的负载,前缀复用省下的就是每次都要重读的那几万字。
第二,显存不够时的降级是三级,不是一级。装载顺序是「默认 → 留出最小上下文的显存 → 完全不上显卡」;如果模型在显卡上根本装不下,就直接跳到下一级。注释里记了这个 bug 的形状:模型把显存占满、只剩一点点上下文,于是每次总结都 InsufficientMemoryError。
第三,思考型模型被切了预算。Gemma 4 走专用 chat wrapper 并且关掉 reasoning,其它架构按家族采样;真的要思考时给一个 thoughtTokens 预算,超了就截断。本地推理的时间是用户的等待时间,思考在这里是成本而不是能力。
还有一条容易被忽略的分支:跨会议检索用的是另一个小模型,EmbeddingGemma 300M(333 MB,512 维),上下文 2048,按约 300 词切块。它和笔记模型共用一个进程,但有自己的上下文,用完可以单独卸载。
七、0o600:谁能读
MCP 是 Yogurt 把自己借给别的 AI 应用的方式:Settings → AI apps 打开,复制一行命令,加到你自己的客户端里。
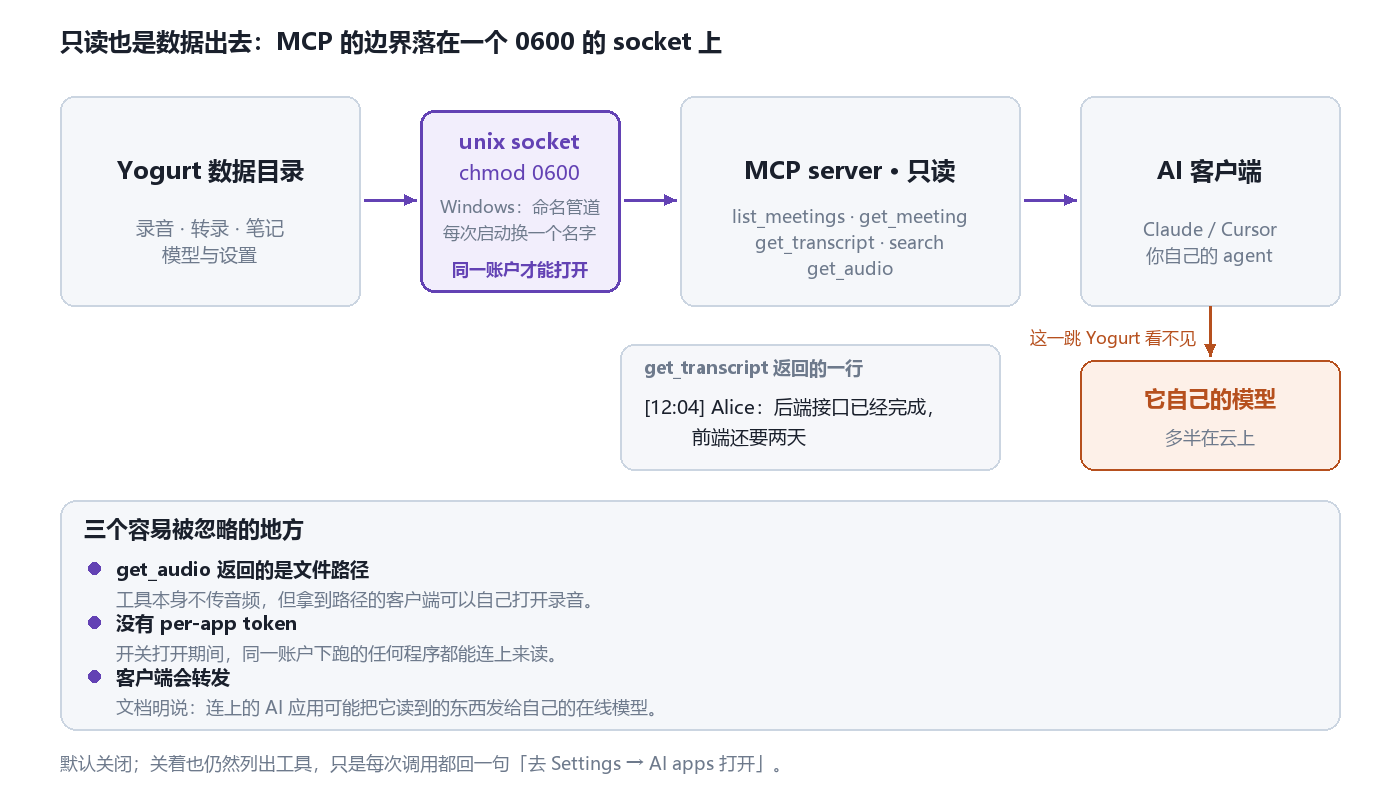
数据不是从应用里「同步」出去的:它在本地开了一个只有本账户能打开的 socket,然后按请求逐条给。
权限边界落在文件系统上,而不是 token 上:
- Mac / Linux 用配置目录里的 unix socket,监听后
chmod 0600;上次崩溃留下的 socket 文件先 unlink 再监听。 - Windows 用命名管道,名字每次启动随机,只存在配置目录里。
- 两端都是「一行一条 JSON-RPC」,超过 1 MB 还没换行就直接断开,回复按请求顺序排队。
工具只有五个:list_meetings、get_meeting、get_transcript、search、get_audio,都标了 readOnlyHint。回收站里的会议对它们不存在。关掉开关时,工具列表照样返回,但每次调用只回一句「去 Settings → AI apps 打开」——这个设计比直接隐藏工具更诚实:客户端知道能力存在,只是现在不给。
但「只读」不等于「没出去」,有三处值得写在产品说明之外:
-
get_audio返回的是文件路径。工具本身不搬运音频,但拿到路径的客户端可以自己打开录音。 - 没有 per-app token。文档的原话是:开关打开期间,同一账户下运行的应用都能读。设置页里显示的「已连接应用」用的是客户端自己报的名字(服务端截断到 60 字符)。
- 客户端可能把它读到的东西发给自己的在线模型,Yogurt 管不到这一跳。
所以真正的隐私边界不是「本地」,而是操作系统账户 + 一个你随时能关的开关。这比「数据不上传」的口号准确得多。
八、代价
本地化的成本可以量化,也都写在文档里:
| 项目 | 数值 |
|---|---|
| 首次下载 | 先约 5 GB 的笔记模型,再按硬件下更好的;64 GB 内存的 Mac 约 14 GB,96 GB 以上约 63 GB |
| 内存下限 | 8 GB(低于此安装会告知) |
| 转录模型 | 0.57 GB(turbo q5_0)/ 0.19 GB(small) |
| 常驻组件 | whisper-server 随包、EmbeddingGemma 300M 约 333 MB |
| Windows | 安装包未签名,首次运行会弹 SmartScreen |
| Linux | 需要 PulseAudio 或 PipeWire;AppImage 需要 FUSE 2 |
它也不是完全不联网:下模型(Hugging Face)、取 Apple 的可选语音资源、查更新。本地推理解决的是「内容不出机器」,不是「机器不上网」。
九、局限
- 说话人名字只有 Mac 有。Windows / Linux 只有「你 / 对方」,要真正的说话人分离得自己接 diarization。
- 平台能力不对等。实时字幕(SpeechAnalyzer)只在 Mac;CPU-only 的 Windows / Linux 连 turbo 都被排除,只能 small。
- 没有 per-app token,也没有读取审计。开关 + 账户是唯一粒度。
- 选型是估算不是实测。速度来自带宽查表乘 0.75,Mac 上完全不测;装完之后真实 tok/s 可能低于推荐线。
- 会议检测只覆盖 Zoom / Teams / Meet。其它软件能录,但不会提醒你。
- 仓库没有架构文档。
docs/下只有安装与构建两篇,机制只能从源码读——本文的结论都来自源码,标注位置如上。
十、我的判断
Yogurt 值得学的不是「把 Whisper 和 llama.cpp 拼起来」,而是它把三个抽象的东西写成了常数:
- 时间:0.5 RTF、15 tok/s、
thoughtTokens预算; - 内存:0.7 / 0.95 / 0.5 的池、0.08 GB 每千上下文、1.5 GB 余量;
- 权限:0o600、1 MB、五个只读工具。
这三组数字构成了一个可以验收的「本地优先」定义。相比之下,「数据不上云」是一句无法验收的话。
如果要继续往下做,我会补的两件事恰好都是「把不可见的变成可测量的」:
- 把权限位再细一层。给每个客户端一个标识、一次授权、一份读取记录;
get_audio单独授权,因为路径本身就是能力。 - 把估算换成实测。Windows / Linux 已经会真的跑一遍转写测速,笔记模型却仍然靠带宽查表。装完之后补一次真实的 tok/s 测量,推荐线才算真的落地。
这和我最近在读的那条线是同一件事:NNsight / pyvene 那套东西之所以有用,是因为它把「模型内部发生了什么」变成了可读的量;本地 AI 应用要让人信,也得先让人能查到自己的数字。
项目与资料
- 仓库:github.com/FrigadeHQ/yogurt(MIT)
- 用户文档:
docs/README.md - 构建说明:
docs/building.md(Node.js 24、pnpm 10.7.0、CMake;Windows / Linux 另需 Rust 与 Vulkan SDK) - 模型目录:
catalog/catalog.json - 选型逻辑:
packages/picker/src/pick.ts、asr.ts - MCP:
app/src/main/mcp/server.ts、socket.ts - 推理:
app/src/engine/llm.ts
数据来源与口径:体积、许可、平台支持来自 catalog.json 与两份官方文档;0.7 / 0.95 / 0.5、0.08、1.5、0.75、15、5 等常数来自 pick.ts 源码;MCP 的权限细节来自 socket.ts 与文档 FAQ。文中所有「一台 32 GB Mac 能跑哪个模型」的说法是我按这些常数代入计算的结果,不是官方机型对照表。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- 拉片笔记:7200 张截图装不进上下文,它把压缩写成了契约
- Airgorah:把 root 赶出 GUI 之后,每个跨边界的参数都得重新验一遍
- WSR:权重确实多给了 15 个点,也让它更敢说「变了」
- Blender Kiln:AI 建模缺的不是生成能力,是交付前的度量
- CineCode:每一帧都是时间的纯函数,所以电影可以被检查
- OhMyGame:AI 生成游戏不难,难的是让它自己发现游戏跑不起来
- GPT-2 的一次前向:一条 768 维的向量,被改写 12 次,变成 50257 个分数
- SAELens:重建得越准,特征越不一定是真的
- TokenEconomizer:Coding Agent 的成本按仓库累积,不按任务计价
- Transformer Explainer:把 GPT-2 塞进浏览器,让模型边算边解释自己