WSR:权重确实多给了 15 个点,也让它更敢说「变了」
「大模型能不能读懂另一个网络的权重」这个问题,很容易写成一串漂亮的演示:给它一个张量,它就开始解释哪一层在管什么。
WSR 的作者选了更难的一条路:不给它跑模型的机会,然后看它还能猜对多少。
- GitHub:suayptalha/wsr(Apache-2.0,2026-11-11 建仓)
- 论文:Weight-Space Reading(alphaXiv 独家,arXiv 仍在审核)
- 口径:README、论文摘要与 alphaXiv 页面;仓库里的代码是论文的评测 harness,但不含论文的实验结果
本文只讲一件事:它测出来的不是「能不能」,而是「多给了多少,以及这份信息有多不可靠」。
一、三个数字
| 数字 | 含义 |
|---|---|
0.730 | 27B 读自己权重时的 balanced accuracy |
0.578 | 同一批编辑,只给它文字描述时的分数 |
53–88% | Muse-30B 上 40 个编辑实测零变化,读者仍预测「变了」的比例 |
第一行是这项能力的上限,第二行是它的对照组,第三行是它的失效方式。三个数字放在一起,才构成一个诚实的结果。
二、读、写、program
WSR 不是单个程序,而是三条命令,对应三种不同的主张:
| 命令 | 给什么 | 要什么 | 允许跑目标模型吗 |
|---|---|---|---|
wsr read | 权重 + 一个已有编辑 | 预测行为往哪个方向变 | 不行,一次都不行 |
wsr write | 权重 + 一个目标 | 自己写出一个编辑 | 有限次,按 passes 计 |
wsr program | 基础模型 + 数据集 + agent | 多轮尝试后交付一个 checkpoint | 同上,练习样本上计次 |
这张表里最容易被忽略的是第四列。读是盲读,写是有预算的试错。很多介绍会把两者混成一句「AI 自己改权重」,但它们在方法上是两种实验:一个在测「权重里有没有可用信息」,另一个在测「给定反馈能不能搜出有效编辑」。
wsr read 的盲是物理意义上的:reader 跑在容器里,没有 GPU,目标模型加载不进来,权重目录只读,内置 harness 下连网络都没有。它能用的只有 W.names(regex)、W.get(name)、W.info(name) 三个只读工具和一段 Python。
三、管线:真值在 GPU 上,预测在没有 GPU 的盒子里
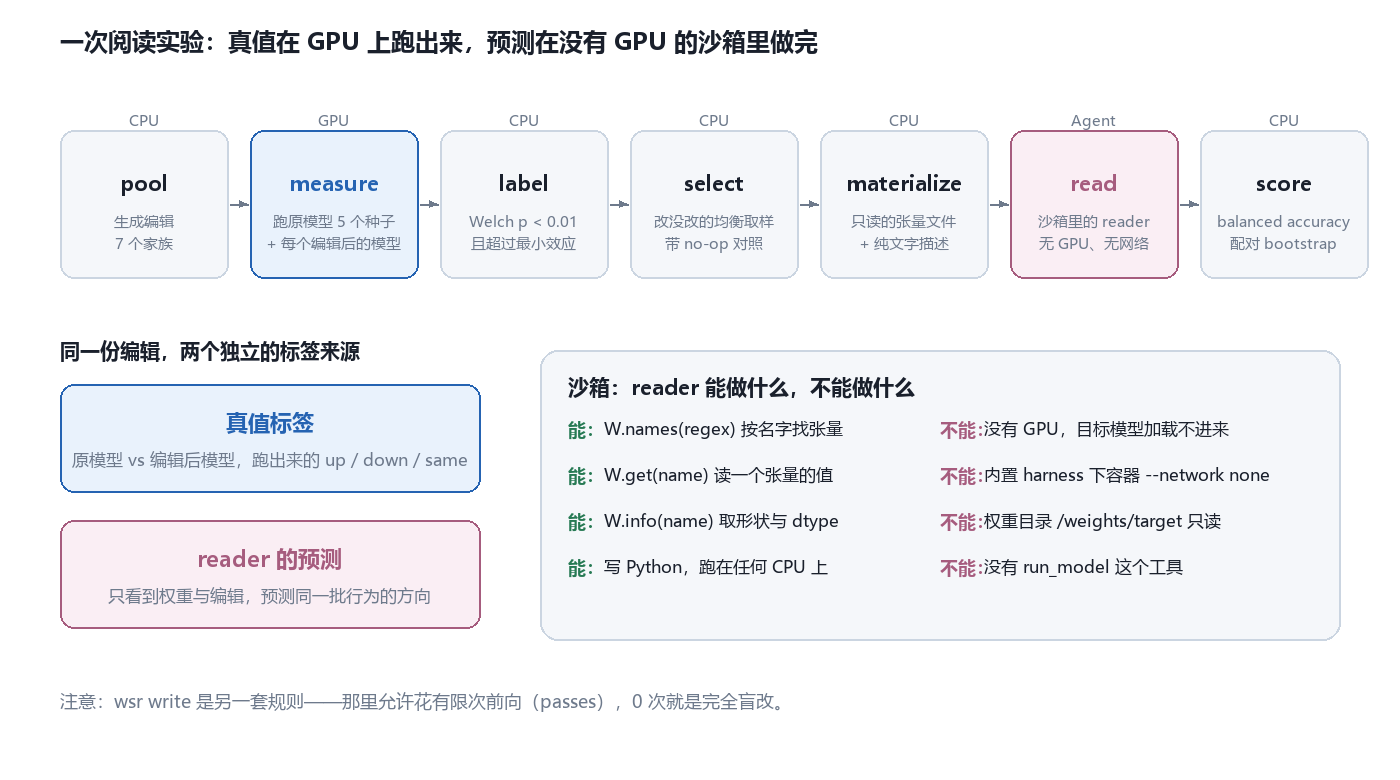
七个步骤里只有 measure 需要 GPU;read 那一步的产物是预测,它要和真值标签对齐后才能算分。
管线本身是标准的对照实验设计,值得学的是它把每个环节的判据都写死了(整篇论文分三个预注册轮次,主结果来自「细微编辑」那一轮):
- pool:七个编辑家族(块缩放/消融、词表行缩放、方向移除、范数匹配噪声、norm gain、no-op 对照、以及它们的剂量版本)。行缩放这类操作可以直接打在
</think>、选项字母、结束符这些 token 行上。 - measure:原模型跑 5 个种子,每个编辑后的模型也跑,编辑是「就地打补丁」到已加载的模型上,所以模型只加载一次。
- label:一个行为算「变了」,必须同时满足 Welch 检验
p < 0.01和最小效应——思考长度要变 10% 以上,比率类要变 0.05 以上。生成被打断的编辑会被单独标成 destructive。 - select:改了的和没改的均衡取样,轮流覆盖编辑家族,并且一定带 no-op 对照。没有这一步,准确率就是「猜变了」的准确率。
- read:每个 reader × target × condition × batch 开一个新沙箱,会话有硬截止——剩 15 分钟时提醒它交答案,到点就停。
- score:balanced accuracy + 配对 bootstrap 区间。
四、主结果:+15.2 个点,代价是更爱说「变了」
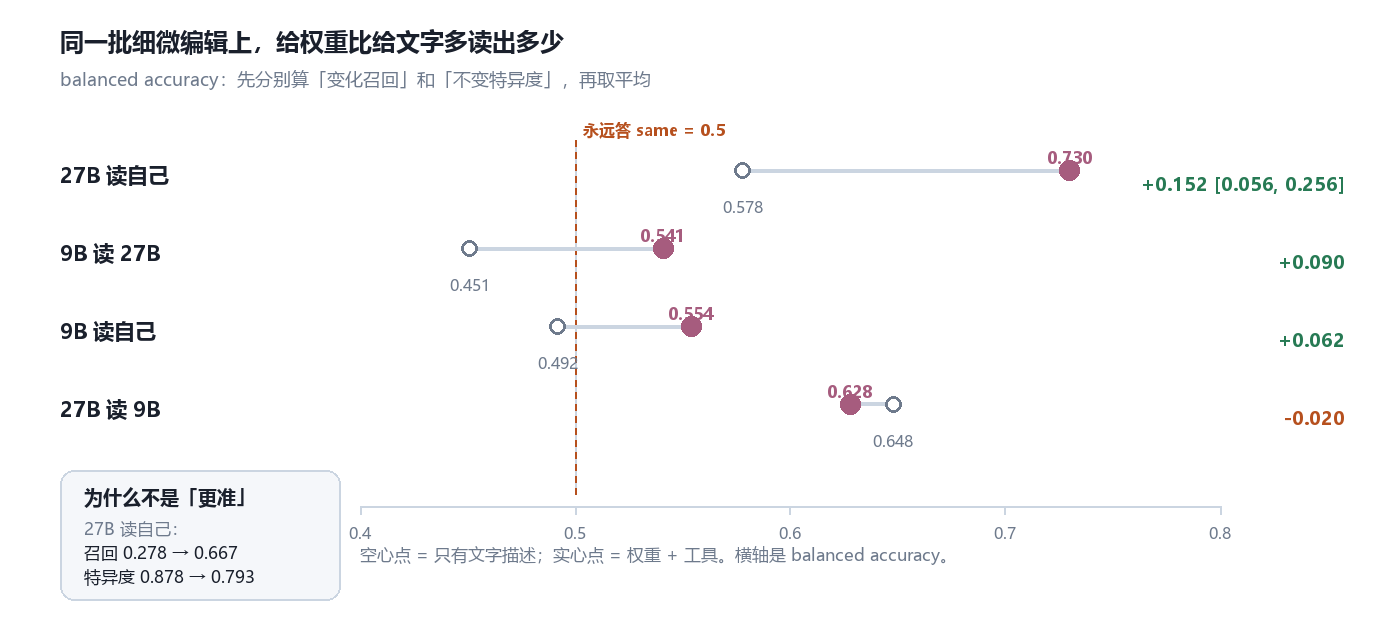
四组 reader → target 配对;空心是只有文字描述,实心是权重加工具。虚线是「永远答 same」的 0.5。
四组配对里三组涨、一组跌:
- 27B 读自己:0.578 → 0.730(+0.152,95% CI [+0.056, +0.256])
- 9B 读 27B:0.451 → 0.541
- 9B 读自己:0.492 → 0.554
- 27B 读 9B:0.648 → 0.628(唯一一组变差)
涨的那三组说明权重确实提供了文字描述之外的信息。但拆开看,涨的来源并不体面:27B 读自己时,变化召回从 0.278 升到 0.667,特异度从 0.878 掉到 0.793。
也就是说,它并没有变得「更懂」,而是变得更敢。原来它倾向于说「没变」,现在它把三分之二的真实变化抓了出来,代价是对着没变的东西也说了更多「变了」。
这里还有一个必须写进结论的分母:主结果建立在 10 个非破坏性且确实改变行为的编辑、共 18 个变化标签上。作者自己把这句话放在正文里——这是一个可测量的效应,不是可靠的通用的预测能力。
五、三个限定,每个都在打自己的脸
1. 自读优势:没有证据
直觉上,模型读自己的权重应该更强。交叉实验(27B 和 9B 互相读)显示,自读对照的区间在每一轮都包含 0。更难看的是:27B 读 Muse-30B 的权重(0.615)显著好于 Muse-30B 读自己(0.468,CI [+0.027, +0.258])。
决定分数的是 reader 的能力,不是「这是谁的权重」。
2. destructive 编辑:测的是「看出坏了」
在全剂量那一轮,多数编辑是破坏性的——模型陷入 8192 token 的重复,或者数学能力大幅下降。在这类编辑上,Muse-30B 读 27B 得 0.594,27B 读自己得 0.593,几乎一样。
这说明一件事:如果在破坏性编辑上建 benchmark,量到的是「损伤检测」,而不是「权重阅读」。看出模型坏了很容易,预测一次细微编辑的方向很难。
3. Muse-30B:预测了不存在的变化
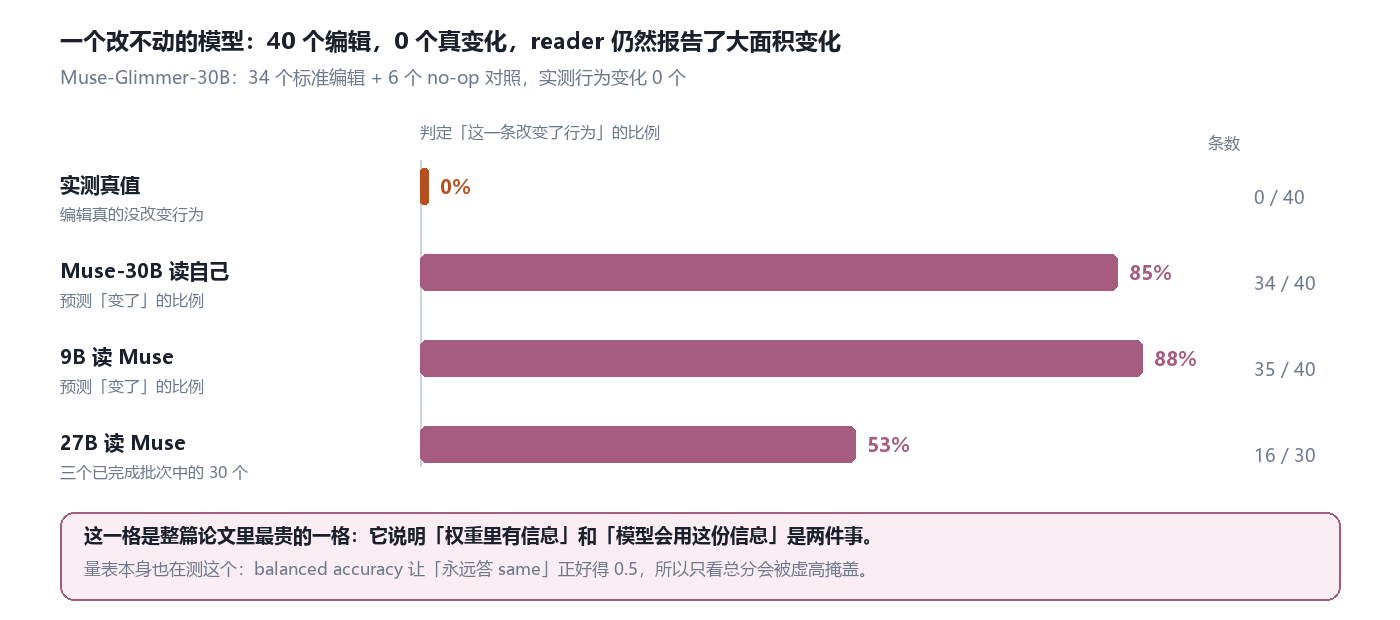
Muse-30B 的 34 个标准编辑加 6 个 no-op 对照,实测行为变化 0 个;读它的模型仍然大面积报告「变了」。
这是整篇论文最贵的一格。Muse-30B 的子层后 RMSNorm 会抵消某些投影输出的均匀正缩放——但这只解释了一部分,作者明确说它不能解释为什么其它标准编辑也全部无效。
而三个读者给出的「变了」比例是 85%、88%、53%。它们不是在读权重,是在读「一个编辑看起来应该会发生什么」。
六、编辑打在哪:结构比张量名重要
wsr 的解剖(anatomy)不是靠正则匹配张量名,而是从张量本身推断落点:哪些矩阵把每个 block 写进残差流、unembedding 在哪、norm gain 在哪(包括 1 + w 这种形式)。
| 结构 | 处理方式 |
|---|---|
| MoE(每专家一个矩阵或融合成 3-D) | MLP 是所有专家 + 共享专家;router 单独成一个编辑家族(R) |
| 混合注意力(Gated DeltaNet + full) | 每层自己的 mixer 输出 |
| 每个子层后都有 norm(Gemma 3、OLMo、Muse) | 缩放它前面的矩阵没用,改成编辑 norm gain(这就是 Muse 那条发现) |
多模态包装(model.language_model.*) | 只认语言模型那一段栈 |
| 栈后的 MTP 块 | 忽略并冻结 |
| 量化 checkpoint(MXFP4、FP8、GPTQ) | 直接拒绝,提示换 bf16 版本 |
「改前面的矩阵没用,得改 norm gain」这一条,是这类工具真正的门槛。一个只会按名字找 down_proj 再乘个系数的脚本,在 post-norm 架构上会得到一堆「编辑成功、行为不变」的结果——而 WSR 选择把这类编辑提前挪到能生效的位置。
七、写和 program:有预算的试错
wsr write 里 agent 有两个工具:check_edit 免费验证(名字、形状、有限值、被冻结的张量、每个张量移动了多少),run_model 花掉一次前向预算。
配置里那句 passes: 10 是关键:10 次前向,只能用在练习样本上,而且练习样本和留出样本不重叠。passes: 0 就是完全盲改。这个设计让「编程」可以被放在一条连续的难度线上比较——盲改、少量试错、多轮迭代。
wsr program 把它包成类似微调的接口:给基础模型、数据集定义的目标、guard suite,然后多轮多尝试。一次尝试要被接受,必须同时满足三条:
- 留出集上的目标分数提升,且配对 bootstrap 区间不含 0;
- 没有任何 guard 行为发生变化(对当前模型做 Welch 检验);
- 编辑不破坏生成。
产出的 model/ 是一个正常 checkpoint,未改动的 shard 用硬链接,所以不额外占盘。这一点比很多「AI 改模型」的演示更实用:交付物能被 Transformers 和 vLLM 直接加载,也能用 wsr export 把编辑重新打到原模型上。
八、代价与局限
- 论文结果不在仓库里。README 明确写了这一点,仓库交付的是 harness 与四组预置;复现要自己准备模型和数据。
- 自编辑实验的 8 个编辑没有公开。所以按原样跑 Full-Dose 那一轮,会少一个编辑家族。
- 证据基数小。主结果是 10 个编辑、18 个变化标签;这不是「LLM 能预测权重编辑」的通用结论。
- 只能读、不能证明读懂了。Muse 那一组里 85% 的预测「变了」全部落空,说明即使给了权重,模型也会用先验去补它读不出来的部分。
- 只支持 decoder-only + safetensors,量化权重直接拒绝。
- 建仓只有几天(2026-11-11),33 star,
0.1的config.json还在兼容期——接口会变。
九、我的判断
WSR 最值得学的地方,是它把一个容易被演示骗过去的问题,变成了三个必须先回答的对照问题:
- 权重比文字多给了什么? 答:在细微编辑上 +15.2 个点。
- 这份优势是「自读」带来的吗? 答:不是,交叉实验每轮都包含 0。
- 它会不会凭空报变化? 答:会,53–88%。
第三个问题是我读这篇时最受触动的地方,因为它和我一直在看的那条线是同一个教训:可解释性工具最大的风险不是解释得不够,而是解释得太顺。NNsight / pyvene 那套干预之所以可信,是因为每次干预都有对应的行为测量作为对照;WSR 把同样的纪律搬到了「读权重」这件事上——先做对照组,再谈能力。
如果要继续往下做,我会加两件事:
- 把「没变」这一侧的样本做厚。现在的 balanced accuracy 已经让「永远答 same」得 0.5,但 Muse 那组说明模型在「看起来该变」的编辑上有系统性偏差。按编辑类型分层报告特异度,比一个总分更有信息。
- 把
passes变成一条曲线而不是一个常数。0、1、10、100 次前向的分数曲线,才能回答「多少反馈能让盲读变成搜索」——这比单点成绩更能说明这套方法的边界。
项目与资料
- 仓库:github.com/suayptalha/wsr(Apache-2.0)
- 论文:alphaXiv / Weight-Space Reading(2026-11-13 提交,arXiv 待审核)
- 安装与快速开始:README(Python 3.10+,
pip install -e ".[hf,report]",约 25 个编辑的 0.5B quickstart) - 编辑与 suite 文档:
docs/suites.md、docs/programming.md - 结构识别:
wsr/anatomy.py、wsr/families.py - 沙箱:
wsr/sandbox.py、sandbox/Dockerfile
数据来源与口径:0.730 / 0.578 / +0.152 [0.056, 0.256] / 召回 0.278→0.667 / 特异度 0.878→0.793 / Muse 的 40 个编辑与 53–88% / 破坏性编辑的 0.594 与 0.593 均来自论文摘要与 alphaXiv 页面正文;p < 0.01、最小效应 10% 与 0.05、5 个种子、15 分钟提醒、七个编辑家族、passes 语义、接受三条件来自 README。图里的条形按这些比例绘制,标注的「条数」是把百分比换算回原始计数(34/40、35/40、16/30),论文摘要写的是比例。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- 拉片笔记:7200 张截图装不进上下文,它把压缩写成了契约
- Airgorah:把 root 赶出 GUI 之后,每个跨边界的参数都得重新验一遍
- Yogurt:本地优先不是一句承诺,是一组能被算出来的预算
- Blender Kiln:AI 建模缺的不是生成能力,是交付前的度量
- CineCode:每一帧都是时间的纯函数,所以电影可以被检查
- OhMyGame:AI 生成游戏不难,难的是让它自己发现游戏跑不起来
- GPT-2 的一次前向:一条 768 维的向量,被改写 12 次,变成 50257 个分数
- SAELens:重建得越准,特征越不一定是真的
- TokenEconomizer:Coding Agent 的成本按仓库累积,不按任务计价
- Transformer Explainer:把 GPT-2 塞进浏览器,让模型边算边解释自己