VoiceStudio:把 ElevenLabs 搬回本地之后,账单换成了许可证
112,128。这是 2026-11-17 的 star 数。仓库建于 2026-04-09,也就是说这些星是七个月里涨起来的。
0.5.8 发布于 11-12。四天之后的 11-16,0.5.9-beta.5 已经打出来了。
第三个数字小得多,也不在 README 里:0 / 73。
项目叫 VoiceStudio,一个本地优先的 AI 语音工作站,能力面写得比大多数同类项目都宽:
- 源码:debpalash/VoiceStudio(AGPL-3.0)
- 官网:voicestudio.sh
- 默认引擎:
k2-fsa/OmniVoice,本地跑,装完先下约 2.3 GB 权重 - 形态:Electron 桌面应用 + 一个跑在
:3900的 FastAPI 后端,另有 Docker、Android、iOS 预览版
我花了两天读它的 docs/——不是 README,是那四十来份工程文档。读完之后的判断是:把它当成“TTS 前端”是看错了。它的工程量集中在编排层,而它最贵的一层在许可证。
这篇只讲后者怎么由前者决定。
一、它是什么:一台工作站,不是一条 TTS 流水线
README 把功能分成三组,这个分法比“支持哪些模型”更能说明问题:
| 组 | 能力 | 背后真正依赖的东西 |
|---|---|---|
| Create | 声音克隆、按文字描述设计声音 | TTS + 说话人条件编码 |
| Produce | 视频配音、有声书、批量队列 | ASR + 翻译 + 时间轴装配 |
| Connect | 听写浮窗、转录、本地 API 与 MCP | 常驻 ASR + 一个 HTTP 面 |
单看这张表,它和“套壳 ElevenLabs”没有区别。区别在仓库结构里:docs/STRUCTURE.md 自己数了一遍——45 个 router、137 个 service 模块、backend/engines/ 下 18 个适配器目录(一个适配器可以覆盖多个引擎,比如 audio.cpp 就同时接了 Breeze-TTS-2 和 dots.tts SOAR)。
一个只会转发 API 的应用不需要 137 个业务模块。它需要的是另一件事:一个声音档案、一次配音、一个批量任务,都得在显存、队列、超时和重试之间活着。
二、三层和一个端口
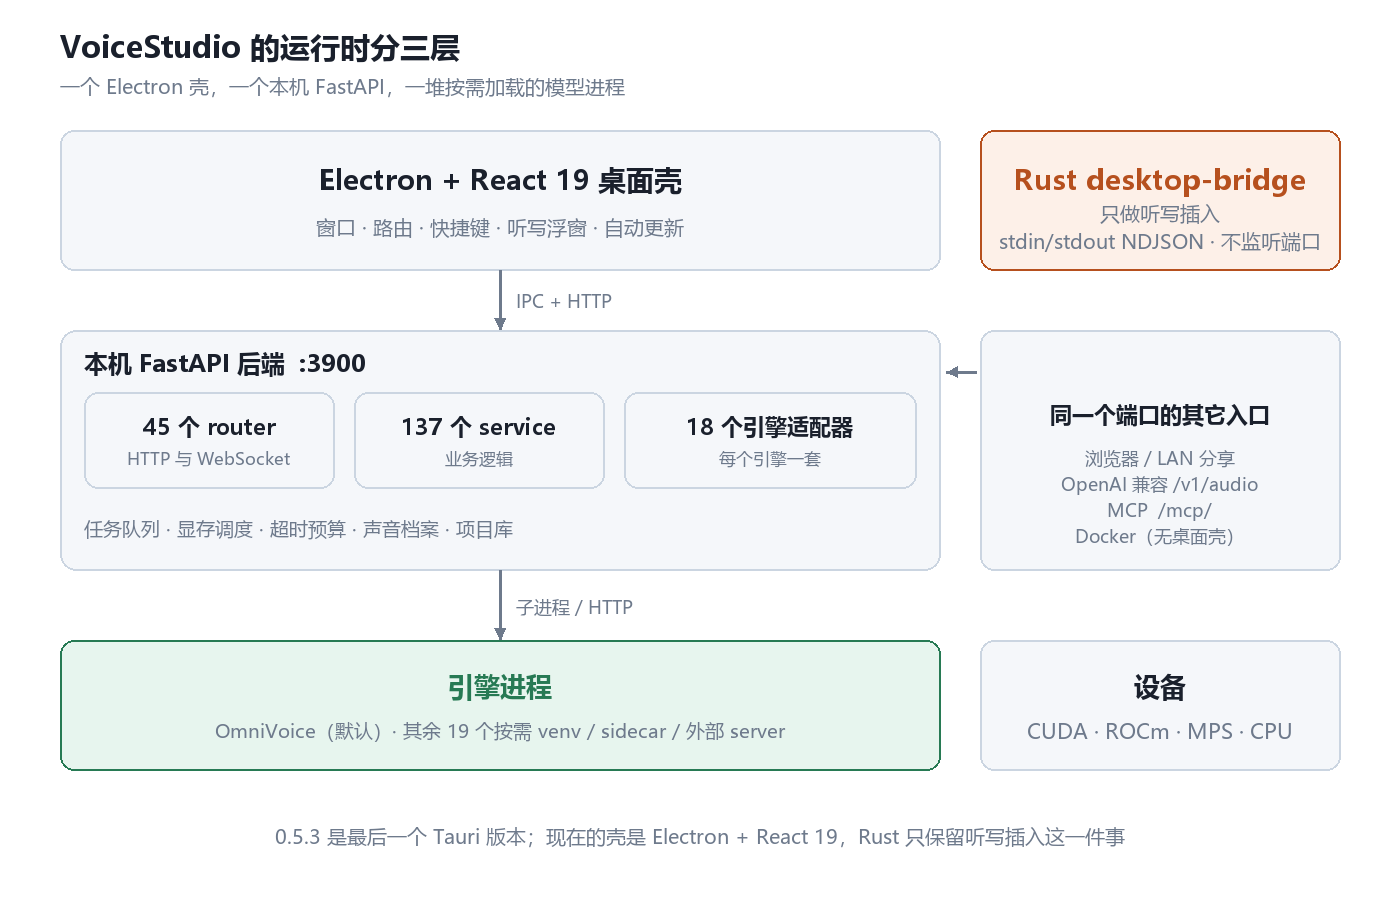
四十五个 router 和十八个适配器都在中间那层;Rust 那一格窄得可以忽略,但它决定“听写能不能插进别的应用”。
值得单独说的是 Rust。native/desktop-bridge 是 Electron 用的原生辅助进程,但它的 README 写得很克制:唯一职责是听写插入。Electron 把自己的 PID 作为第一个参数传进去,两边只用继承的 stdin/stdout 交换按行分隔的 JSON,helper 没有监听端口、没有网络入口。
这不是“用 Rust 提升性能”的项目。它是因为“把文字粘进当前焦点窗口、并还原剪贴板”这件事,在 JS 里做不稳。
另外两条容易被漏掉的事实:
- 0.5.3 是最后一个 Tauri 版本。现在的壳是 Electron + React 19,老用户要单独装新应用。
-
:3900才是产品边界。它同时是 OpenAI 兼容的/v1/audio/speech、转录 WebSocket/v1/audio/transcriptions/stream、MCP 的/mcp/,以及 Docker 与 LAN 分享的入口。
第 2 条是这篇文章的转折点:当一个语音应用把“入口”做成 API,它就必须回答“谁被允许调用”,而 API 的调用者不只有你。
三、646 种语言是目录,不是能力
README 的副标题承诺在 646 种语言里克隆、设计、配音、听写和朗读。这个数字是真的,docs/languages.md 里有一张 646 行的表。
但那张表还有第四列:训练数据时长。
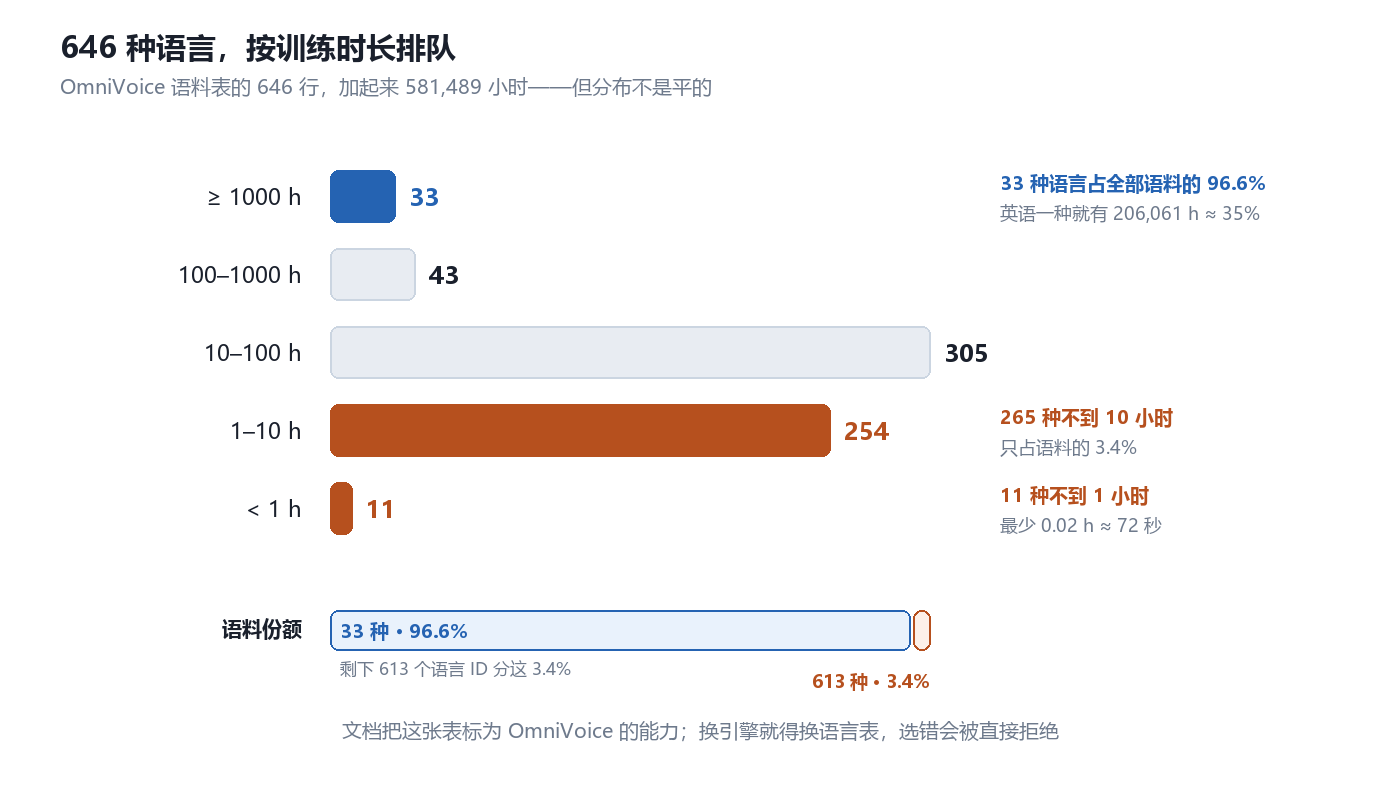
按 docs/languages.md 的表格逐行统计:646 行,总时长 581,489 小时。
把这张表算一遍:
- 英语一种 206,061 小时,占全部语料的 35%;中文 111,343 小时;前六种语言合计约 74%。
- 33 种语言(≥1000 小时)占 96.6%,剩下 613 种分 3.4%。
- 265 种不到 10 小时,11 种不到 1 小时。最少的是 Macedo-Romanian:0.02 小时,72 秒。
72 秒的语料能不能支撑 zero-shot 克隆?官方没有给逐语种的质量分,我也没在文档里找到任何 per-language 评测。所以这是我的推断,不是官方说法:那 265 种更接近“模型见过这个语种”,而不是“模型能在这个语种上交付”。
文档自己也在给这个数字降温。同一页开头就说明:这张目录描述的是 OmniVoice 一个模型;其他引擎有自己的语言集,选中引擎不支持的语种时,合成会带着引擎名和可选值停下,而不是用错的语言生成。
换句话说,646 是目录长度,不是能力半径。换成 CosyVoice 或 IndexTTS,这张表就得重算一遍。
四、二十个引擎怎么塞进一个界面
docs/feature-catalog.md 列了 20 个语音生成引擎和 10 个转录引擎。挑一部分摊开看,能看出适配器的边界画在哪:
| 引擎 | 跑在哪 | 克隆 | 怎么启用 |
|---|---|---|---|
| OmniVoice | CUDA / MPS / CPU | 支持 | 默认,装完就有 |
| CosyVoice 3 | CUDA / CPU | 支持 | 克隆仓库 + requirements |
| VoxCPM2 | CUDA / MPS / CPU | 支持 | pip install "voxcpm>=2.0.3" |
| IndexTTS 2.5 | CUDA / CPU | 支持+情感 | 一键 sidecar 安装 |
| KittenTTS | CPU | 8 个预置 | pip install kittentts |
| GPT-SoVITS | 外部 server | 支持 | 它自己的 API server |
| MLX-Audio | Apple Silicon | 视模型 | pip install mlx-audio |
| OmniVoice GGUF | CUDA / MPS / CPU | 支持 | 安装包自带原生二进制 |
| audio.cpp | CPU + Vulkan/Metal/CUDA | 支持 | 预编译二进制 + 权重 |
这些引擎的输入不是同一种东西:有的吃参考音频,有的要参考音频加转写文本,有的只吃一段文字描述。所以真正被复用的不是模型,是几个约定:
- 参考音频:界面接受最长 75 秒,建议 5–15 秒干净人声。
- 怎么用一段更长的素材:OmniVoice 只取 20 秒,而且不是取前 20 秒,是挑“语音最密的那 15 秒”再转写;VoxCPM2 保留前 30 秒。这些差异由
GET /engines以max_ref_seconds和ref_strategy暴露。 - 超限就拒绝,而不是猜:给一段超过 20 秒的音频配一个整段转写,
/generate会返回[clone_ref_too_long]。
这套约定的价值很实际:换引擎时,用户改的是一个下拉框,不是一整条流水线。
五、显存才是这台机器的主人
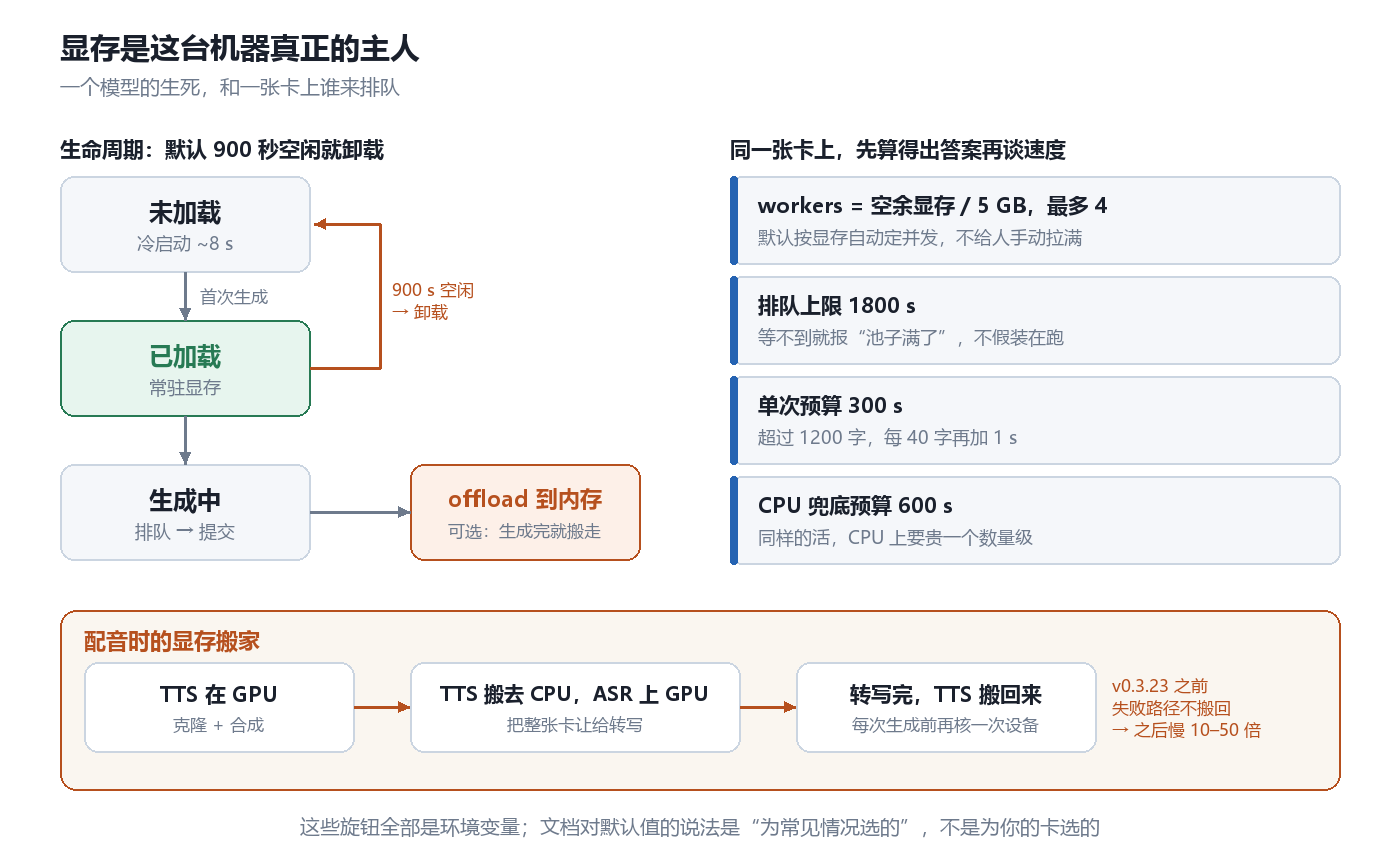
所有默认值都来自 docs/performance.md 的环境变量表;它们不是配置项清单,是一份“这台机器能同时干几件事”的预算。
几个默认值放在一起看,目标用户就很清楚了:
- 冷启动加载权重约 8 秒;空闲 900 秒后卸载,把显存还回去。
- GPU 并发 按每 5 GB 空余显存 1 个 worker 自动定,最多 4 个;MPS 和 CPU 永远 1 个。文档明确写着“10 GB 以下的卡和 Apple Silicon 不要手动调高”,因为两个任务同时超配显存,正好是它最常修的崩溃类型。
- 排队超过 1800 秒报“显存池饱和”,而不是假装在跑。
- 单次生成预算 300 秒,超过 1200 字后每 40 字再加 1 秒;CPU 上的预算单独是 600 秒。
最能说明“编排层才是成本”的,是一个已经修掉的 bug。配音时它会把 TTS 模型搬到 CPU、把整张卡让给 ASR 转写,转写完再搬回来。v0.3.23 之前,这个“搬回来”只写在成功路径上——取消一次配音、报一次错、或者转写时关掉标签页,模型就留在 CPU 上,之后每一次生成都慢 10–50 倍,直到 15 分钟的空闲卸载恰好触发。
用户看到的现象是“随机变慢”,issue 里写的是“是不是按时间段降速”。修法是两条:所有退出路径都搬回来,并且每次生成前再核一次模型在哪张设备上。
我觉得这段比任何跑分都更能解释这个项目的形状:它不是“调模型”,是“管一个会自己跑偏的运行时”。
六、配音:难的不是翻译,是把新句子塞回旧时间轴
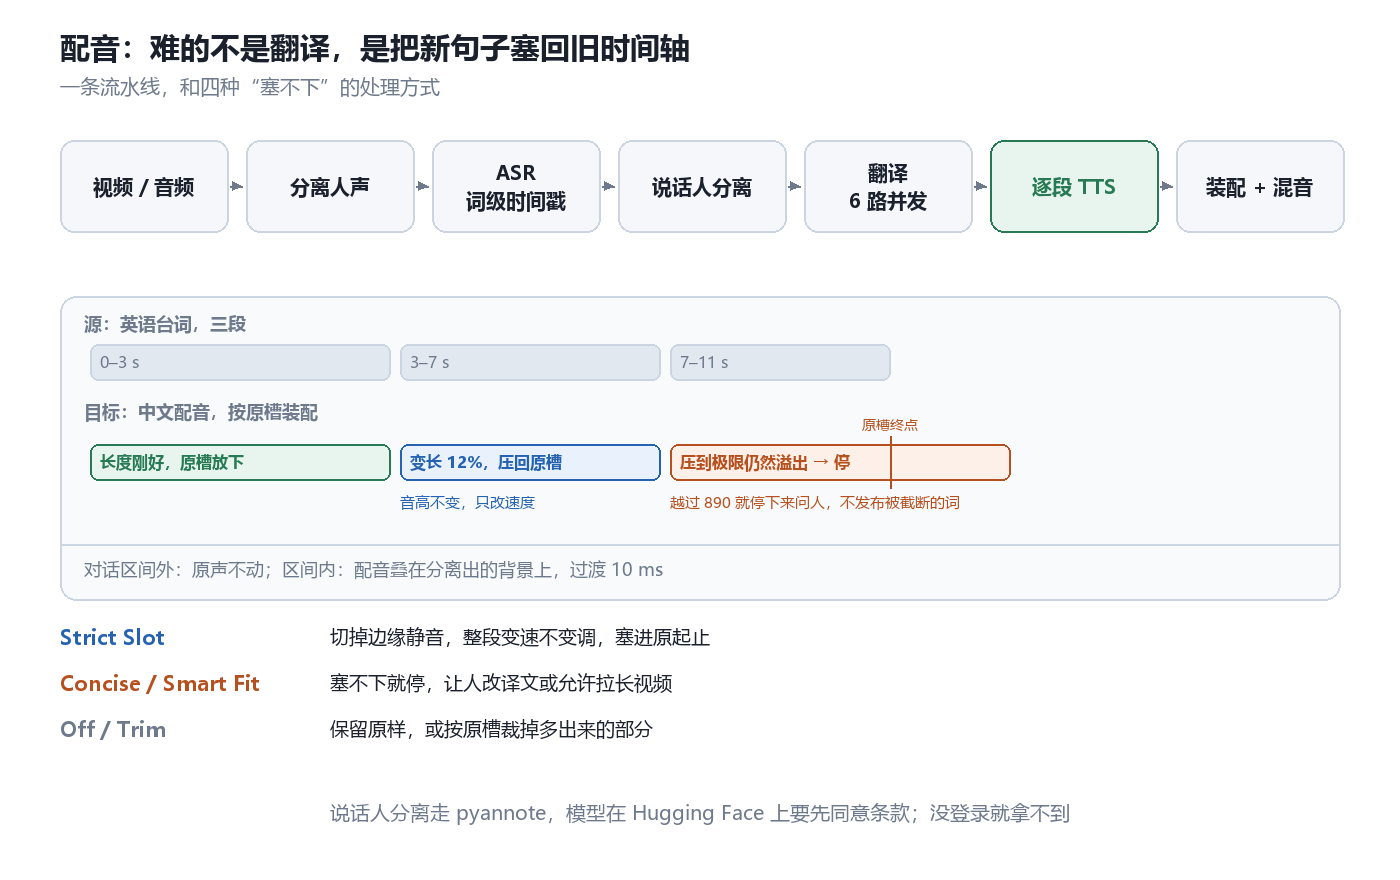
一条英文 3 秒的台词,翻成中文可能要 4 秒;四种模式的区别就是“这多出来的一秒去哪”。
流水线本身不新鲜:抽音频、分离人声与背景、ASR 拿词级时间戳、说话人分离、翻译、逐段合成、装配、混音。新鲜的是最后两步的处理方式:
- Strict Slot:切掉边缘静音,把整段变速不变调地压进原起止。它也承认边界——译文太长或太短,听起来仍可能不自然地快或慢。
- Concise / Smart Fit:压不进去就停,让人改译文或者允许拉长视频。它宁可停下,也不发布被截断的词再报告完成。
- 保留对话区间外的原声:区间外原样不动,区间内把配音叠在分离出的背景上,过渡 10 毫秒。它同时承认这条的极限:从一条混好的音轨里做精确分离,并不保证能做到。
- 口型:文档写得很直白,它不承诺音素级 lip sync,也不自动修正错误的源转写。
还有一个我没想到的细节:Mirror source delivery。它会为每一段量五个指标——响度、语速、音高、音高变化、有声比例——和同一个说话人的基线比,只有明显偏离才写进 Direction 字段,用的词是 urgent / energetic / calm / announcing / whispered / quick / slow。它不推断情绪,只推断“这一句和这个人平时不一样”。
这一整套东西的工程量,比接一个新 TTS 模型大得多。
七、评测:一张空着的表
docs/benchmarks.md 是一份跑分表。它的内容是:
No verified rows yet — this table fills from maintainer runs and community submissions.
表头有六列(引擎、设备、RTF、峰值显存、版本、来源),下面只有一行占位。文档要求每个提交者用仓库里的 scripts/bench_pipeline.py 在空闲机器上跑,把原始输出贴进 PR,“PR 链接就是这一行的来源”。
一个 11 万星的项目,性能表是空的。我不觉得这是缺点,反而是一种诚实:它宁可空着,也不把不同机器上的数字拼成排行榜。
但对读者来说,这意味着一个明确的空白:没有第三方可复现的速度数字。所以才要在这里说清楚——我没有在本机跑过任何一个引擎,本文不会给你任何 RTF、延迟或显存占用。上面所有数字都是文档里写的默认值,不是我的测量。
八、本地优先的边界:钥匙、PIN 和管理员
“本地优先”这句话在没开分享时是自动成立的:后端只绑 loopback,本机客户端免认证。
一旦要给别人用,它就变成一套两级授权:
| 东西 | 作用 | 代价 |
|---|---|---|
OMNIVOICE_API_KEY | 换一个最长 8 小时的会话 | 明文 HTTP 上会被抓,必须套隧道 |
| WebSocket ticket | 30 秒过期、一次性、绑定路径 | 浏览器端要多一步交换 |
| LAN 分享 PIN | 只够“消费”:合成、听写 | 不是管理员凭证 |
SERVER_MODE=1 | 无头部署时放开管理员路由 | 等于信任所有非 loopback 来源 |
文档在这块写得比多数项目谨慎,甚至点名了不要做什么:不要用 tailscale funnel 把语音克隆后端暴露到公网。理由是即使配了 key,一个语音克隆后端也不该挂在公网上。
我的判断是:这套模型的边界划得对(消费和管理分开、PIN 不等于 key),但它只在“你已经有隧道”的前提下成立。本地优先省掉的是暴露面,不是运维。
九、Agent 的那一半:MCP 挂在同一个进程上
MCP 服务不是单独起的,它挂在正在跑的后端上(/mcp/)。九个工具:generate_speech、clone_voice、describe_voice、design_voice、transcribe、三个 list_*、check_health。
三个细节值得抄:
- 一个 agent 一个声音。请求头带
X-OmniVoice-Client-Id(claude-code、codex-cli、hermes),就能把这个客户端绑到一个声音档案上。多 agent 同时干活时,声音成了身份。 - 别把 WAV 塞进 context。默认模式把 base64 音频内联返回;
OMNIVOICE_MCP_OUTPUT_MODE=files改成写盘并返回路径。“an LLM agent pays for every byte it receives in context”——这句话应该出现在每个 MCP server 的文档里。 - 路径是安全边界。
OMNIVOICE_MCP_BASE_PATH之外的文件一律拒绝,相对路径按它解析,符号链接先解析再检查,打开时用 no-follow 描述符。没配 base path 时,所有路径参数直接拒绝。
再加一个 OpenAI 兼容层:把 agent 框架的 TTS base URL 指到 http://localhost:3900/v1,它就能用你克隆的声音说话,而音频不出本机。
十、许可证:这篇文章真正想说的那一层
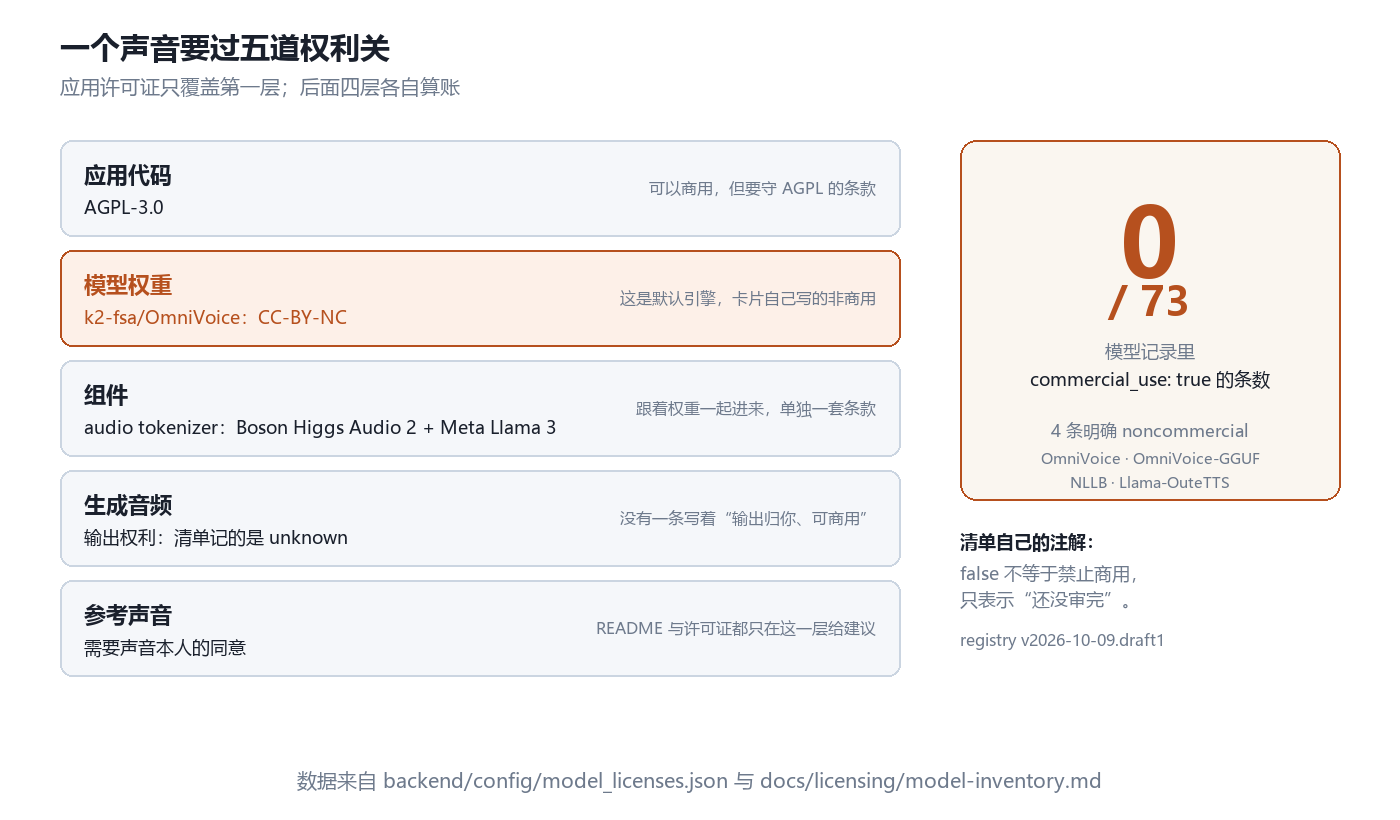
数据来自仓库里的 backend/config/model_licenses.json(registry v2026-10-09.draft1)与 docs/licensing/model-inventory.md。
README 的许可证段落写得很老实:AGPL-3.0 覆盖应用,并允许按其条款做商业使用;但模型权重、声音和生成内容各有各的许可证,Model Manager 会逐个显示。
那句“各自的许可证”值多少钱,要看清单。仓库里维护着一份 73 条模型记录的许可证清单,每条带上游标签、商用审查标记、来源证据链接:
commercial_use: true的记录:0 条。- 4 条被明确标为 noncommercial:
k2-fsa/OmniVoice、Serveurperso/OmniVoice-GGUF(CC-BY-NC-4.0)、facebook/nllb-200-distilled-600M(CC-BY-NC-4.0,配音翻译在用)、Llama-OuteTTS。 - 默认引擎的权重就是 CC-BY-NC。清单的备注(原文英文,这里是译文)写着:被钉住的模型卡把 Apache-2.0 的代码与非商用的权重分开,CC 版本没写;audio tokenizer 还额外带 Boson Higgs Audio 2 和 Meta Llama 3 的条款。
- 输出权利记的是
unknown:没有一条材料给出“输出归你、可商用”的明确授权。
这里必须把话说准,因为清单自己就在防止误读:false 不等于“禁止商用”,它同时覆盖“已知非商用”和“还没审完”;commercial_use: true 才表示“已审查并放行”,而它的定义要求 reviewer、日期、修订号和范围。当前一条都没有。
这也解释了 README 里那个看起来矛盾的结构:左边是免费的 AGPL 应用,右边是卖“Commercial License for your client work”的 Pro 闭源版。从文档推断(官方没这么写),Pro 卖的更像是“把逐模型的授权问题一次性包掉”,而不只是多设备同步。
所以“开源替代 ElevenLabs”这句话要拆成两半:
- 技术上成立。本地跑、无账号、646 个语种 ID、API 兼容、MCP 齐全,这些都是真的。
- 商业上要重算。应用许可证管的是代码;权重、组件、输出、参考声音是另外四道关,每一道都要单独过。
十一、它做不到什么
按重要性排:
- 没有可复现的性能数字。官方跑分表是空的,第三方评测也少。买硬件之前别信任何“XX 倍实时”。
- 646 种语言极度不均。前 33 种占 96.6% 语料;265 种不到 10 小时。先确认你要的语种在长尾的哪一头。
- 商用要逐模型核对。默认权重 CC-BY-NC,清单 0/73 已审。这不是“改个配置”能解决的。
- Windows 上 PyTorch 只有 CUDA。AMD 和 Intel 显卡跑 PyTorch 引擎会落回 CPU;想用 Radeon 只能走 Vulkan 的 GGUF / audio.cpp 路线。Windows 的 ROCm 只支持部分 RDNA 2 卡。
- Windows on ARM 是“UI 原生 + 后端模拟”。x64 的 Python 后端跑在模拟层上。
- 移动端还是 Preview。Android 10+ 和 iOS/iPadOS 17+,iOS 要自己签名侧载。
- 装完不小。Windows 安装包 232.8 MB,macOS DMG 284.7 MB,APK 137.2 MB;第一个模型约 2.3 GB。
- 版本节奏很快。0.5.8 之后四天出了四个 beta。追新要有心理准备,文档与实现偶尔会漂。
- 0.5.3 之前的用户要重装。Tauri 到 Electron 不是升级,是换应用。
- 克隆的边界由你负责。许可证只管“能不能用”,不管“该不该用”。
十二、我的判断
如果我要在自己机器上用它,会先问三个问题,顺序不能换:
- 我要的语种在长尾的哪一头?头部 33 种之内,这套东西是现成的;之外,先去
docs/languages.md查那一行的小时数。 - 我是不是商用?是的话,先读
model_licenses.json,再看 Pro,别从 README 的“AGPL 可以商用”直接推到“生成的声音可以商用”。 - 我的显卡在不在它的设备矩阵里?不在的话,它能跑,但你会一直在 CPU 的预算里。
这个项目最值得学的,不是它接了 20 个引擎,而是它把“换引擎”做成了一件不需要改流水线的事:参考音频的约定、设备路由、显存预算、时间轴装配,都抽到了引擎之外。
但同一件事也带来了它的代价:当“可替换”成为产品能力,权利就变成了逐个替换件的问题。模型可以换,许可证不能跟着换。
这大概是我从这个仓库里学到的最有用的一句话:编排层让你自由,许可证决定这份自由能走多远。
项目与资料
- 仓库:debpalash/VoiceStudio
- 发布:Releases(0.5.8,2026-11-12)
- 官网:voicestudio.sh
- 结构图:docs/STRUCTURE.md
- 性能与环境变量:docs/performance.md
- 配音工作区:docs/electron-dubbing.md
- 本地语音平台:docs/speech-platform.md
- MCP:docs/mcp.md
- 语言表:docs/languages.md
- 许可证清单:docs/licensing/model-inventory.md · backend/config/model_licenses.json
- 跑分表(当前为空):docs/benchmarks.md
许可证:应用 AGPL-3.0。模型权重与组件另计,逐条见上。
图片说明:五张示意图都是我根据 README 与 docs/ 下的工程文档绘制的,不是项目官方架构图;封面同理。文中的 star 数、发布时间、文件体积取自 GitHub API 与 Releases 资产列表(2026-11-17),语种时长统计由 docs/languages.md 的表格逐行相加得出。我没有在本机运行过任何引擎,所以文中不含我自己测的速度数字。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- vLLM:每次重写,改的都是同一本显存账
- Diagram Design:50 种图表是目录,能拒绝你的检查才是产品
- gpu-unlock:GeForce 的半速矩阵算力,写死在八个 4 位字段里
- Octop:单进程是它的地基,也是它的天花板
- DroidDeck:手机跑 PC 游戏不难,难的是让 Android 相信自己正在当主机
- magpie:它调度的不是模型,是会过期的额度
- Aerial:换桌面不是画界面,是在别人的固件里抢前台
- colibri:同一个引擎 184 倍的速度差,全部来自权重住在哪一层
- GEO:最有效的三种写法,官方提示词里都写着“可以编造”
- HelixHarness:Harness 工程的两份契约,一份写成了协议,一份还没有数据