vLLM:每次重写,改的都是同一本显存账
60%–80%。不足 4%。97,076。
前两个数字来自同一篇官方博客,说的是同一件事的两头:现有推理系统会把六到八成的显存浪费掉,而 PagedAttention 分页之后,浪费降到 4% 以下。第三个数字是 star 数——vllm-project/vllm 在 2026-11-17 是 97,076 star、24,913 fork,Apache 2.0,2023-02-09 建库,README 里写的贡献者数是 2000 以上,最新 release 是 2026-11-16 的 v0.34.0。
大部分介绍会停在特性清单上:PagedAttention、Continuous Batching、Prefix Caching、量化、推测解码、分布式。清单没错,但清单不是架构。
这篇只讲一件事:vLLM 从 PagedAttention 到 V1 的每一次重写,改的都是同一件事——显存怎么记账、谁来排班。 看清这条线,你才能判断自己的卡和模型能不能对上它的账本,以及哪些默认值不能照抄旧文章。
一、先算一笔账:瓶颈为什么是 KV Cache
Transformer 逐 token 生成,每生成一个 token 都要用到之前所有 token 的 Key 和 Value。这些中间结果就是 KV Cache,省掉了重复计算,但必须一直占着显存。
它有两个要命的性质:大,而且长度事先不知道。
拿 LLaMA-13B 粗算:2(K 和 V)× 40 层 × 40 头 × 128 维 × 2 字节 ≈ 0.78 MiB 每 token,2048 个 token 就是 1.6 GB 左右——和官方博客给的「单条序列最高 1.7 GB」对得上(这一步是我的算术,博客只给了结果)。一张 40 GB 的 A100 装下 26 GB 的 bf16 权重之后,剩下的显存只够同时跑八条左右的序列。
所以吞吐的天花板不是算力,是「同一时刻能装下多少条序列」。 并发数上不去,GPU 每一步都在等下一批。
| 浪费的形态 | 怎么产生的 |
|---|---|
| 预留 | 长度未知,只能按上限先占一条连续显存 |
| 碎片 | 请求长短不一,结束后留下凑不成整段的小块 |
| 重复 | 并行采样、beam search 反复保存同一段前缀 |
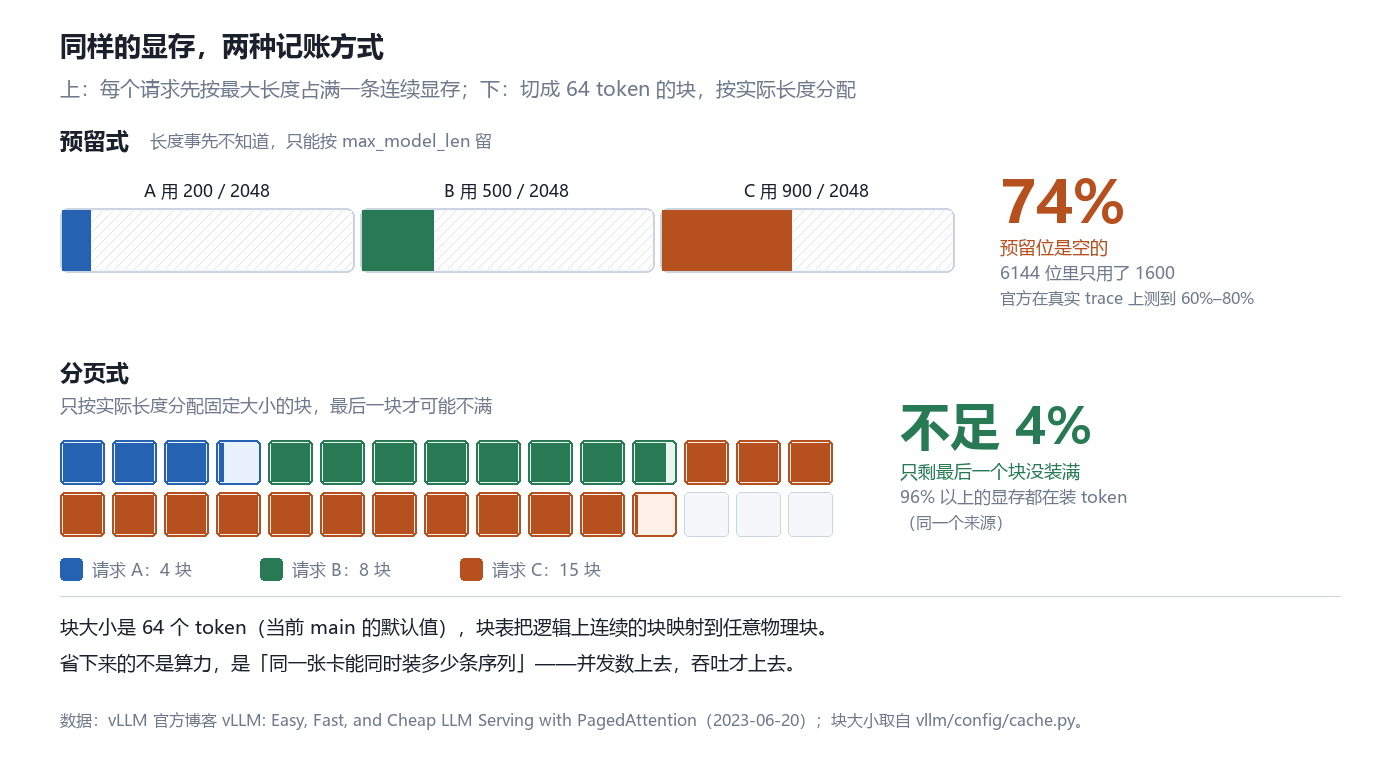
上排是预留式:每条序列按 2048 占满,实际只用了零头;下排是分页式:块按需分配,只有最后一块可能不满。
官方博客的 60%–80% 是在真实 trace 上测的,三类浪费都在里面。PagedAttention 把三类一起压下去:按需分配消掉预留,块池消掉外部碎片,引用计数共享消掉重复——只剩块内那半个块,官方测算是 4% 以内。
二、它不是一个进程,是一组进程
先说一个经常被含糊过去的事实:vLLM V1 部署起来是一组进程,不是「一个服务」。
| 进程 | 数量 | 负责 |
|---|---|---|
| API Server | A,默认等于 DP | HTTP、分词、多模态加载、流式返回 |
| Engine Core | DP,默认 1 | 调度器、KV 块管理、给 worker 派活 |
| GPU Worker | N = DP × PP × TP | 一卡一个进程,加载权重、跑前向 |
| DP Coordinator | DP > 1 时 1 个 | 数据并行之间的负载均衡 |
官方给的公式是 A + DP + N(DP > 1 再 +1)。单机 4 卡 --tensor-parallel-size 4 就是 1 + 1 + 4 = 6 个进程;8 卡 TP=2 DP=4 是 4 + 4 + 8 + 1 = 17 个进程。
这件事的直接后果在 CPU 上:物理核至少要等于进程数,也就是 2 + N;开超线程的机器 1 vCPU 只是半个物理核,所以官方要求 2 × (2 + N) 个 vCPU。原因写得很直白——engine core 跑的是一个不停歇的循环,被别的进程抢走 CPU,调度就排不出来。
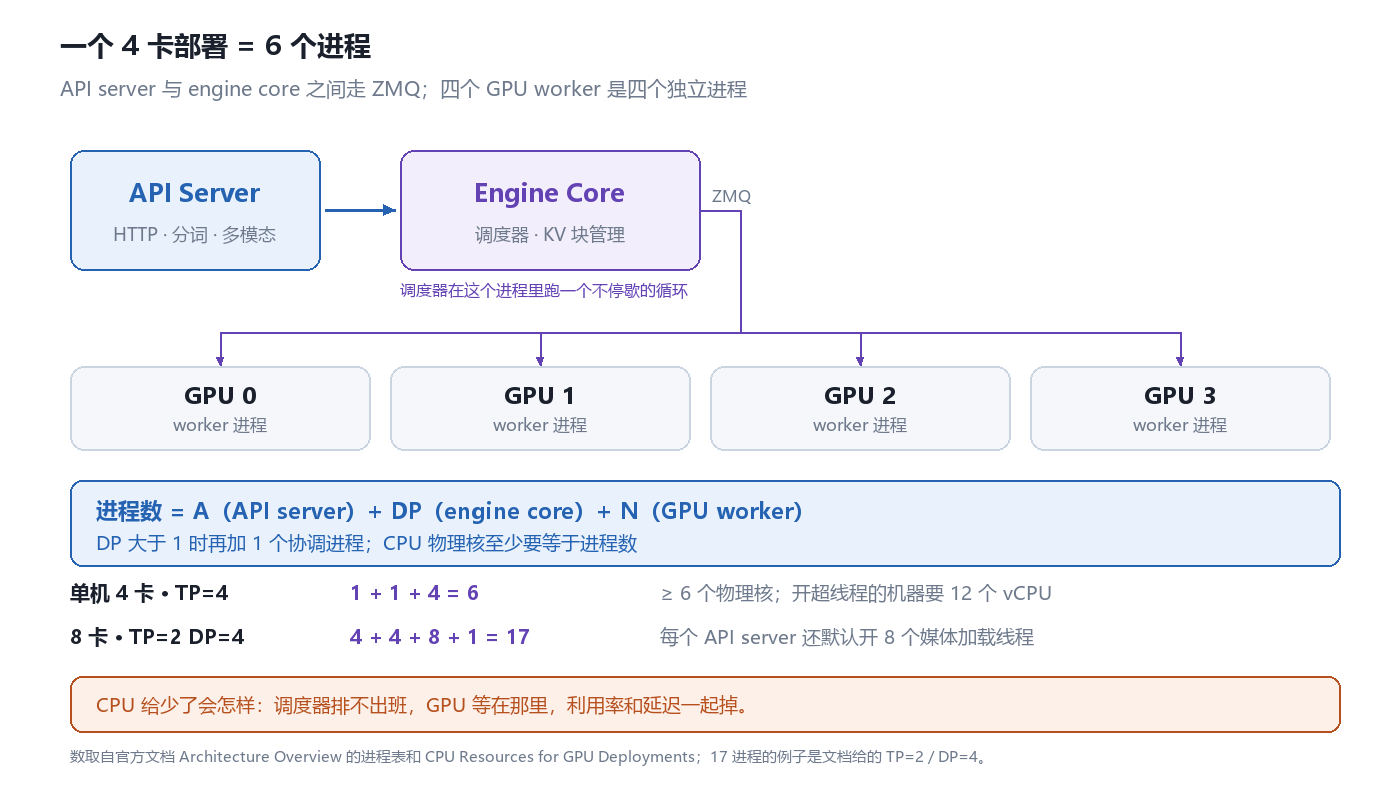
6 个进程意味着 6 个物理核起步;虚拟化环境里 CPU 配额不够,是「GPU 利用率上不去」最常见的原因之一。
启动命令本身很短,但每个参数都对应上文的一笔账:
vllm serve Qwen/Qwen3-8B \
  --tensor-parallel-size 2 \
  --max-model-len 32768 \
  --max-num-batched-tokens 8192 \
  --kv-cache-dtype fp8
--tensor-parallel-size 2 意味着 2 张卡、2 个 worker、加上 API server 和 engine core 一共 4 个进程;--max-num-batched-tokens 8192 是在覆盖那张按显存分档的默认表;--kv-cache-dtype fp8 是拿精度换显存,第八节会说代价。这三件事没有一件是「调优技巧」,全是账本上的取舍。
三、PagedAttention:把 KV Cache 变成可分页的账本
PagedAttention 借的是操作系统虚拟内存那一套:块(block)是页,token 是字节,请求是进程。
每个请求的逻辑块可以落在任意物理块上,中间靠块表映射。分配按需进行,块用完就还回空闲队列,引用计数归零才真正释放;并行采样这种「同一段前缀、多个输出」的场景,可以让多条序列指向同一个物理块,写的时候再 copy-on-write。博客说这套共享能把并行采样的显存砍掉最多 55%,换成最高 2.2 倍的吞吐。
论文(SOSP 2023)给的结论是:同等延迟下,吞吐比 FasterTransformer 和 Orca 高 2–4 倍,序列越长、模型越大、解码算法越复杂,差距越明显。
一个容易过时的细节是块大小。我刚学 vLLM 时记住的是 16 个 token 一块;现在的代码里,vllm/config/cache.py 的 DEFAULT_BLOCK_SIZE 是 64。我特意回去查了 v0.6.3 的 EngineArgs.block_size,那时候确实是 16。
| 版本 | 默认块大小 | 前缀缓存默认 | gpu_memory_utilization 默认 |
|---|---|---|---|
| v0.6.3(2024) | 16 token | 关闭 | 0.9 |
| 当前 main(2026-11) | 64 token | 开启 | CUDA/ROCm 上 1.0,其余 0.92 |
这三个默认值全变过。照抄两年前的教程调参,你会得出完全相反的结论。
代价也要说清楚:块越大,块内浪费越多、前缀命中的粒度越粗;块越小,块表越长、kernel 要跳的次数越多。分页不是让每个请求变快,它是让同一块显存同时装下更多请求。
四、V1 的调度器:没有两个阶段,只有一个预算
教科书讲推理分 Prefill(一次性算完输入)和 Decode(逐 token 生成)两个阶段。V1 的调度器已经把这条分界线拆掉了。
官方文档的原话是:调度器是基于 token 预算的,每一步把一个 max_num_batched_tokens 的预算填满,「没有独立的 prefill 和 decode 阶段」。它只用一张 {request_id: 已经算到第几个 token} 的表,每个请求缺多少就补多少。chunked prefill、前缀缓存、推测解码全都长在同一个循环上。
填的规则是:先满足所有在跑的 decode,再用剩下的预算塞 prefill;塞不下就把 prefill 切成块。 于是计算密集的 prefill 和带宽密集的 decode 混在同一批里,GPU 每一步都有活干。
预算的默认值还跟卡有关,这一条几乎没人提。vllm/engine/arg_utils.py 里按显存分档:B200/B300 这类 ≥160 GiB 的卡,vllm serve 用 16384;H100/H200 用 8192;A100 被特意排除在大预算之外,用 2048——代码注释写着,A100 上调大预算会掉吞吐(PR #17885)。
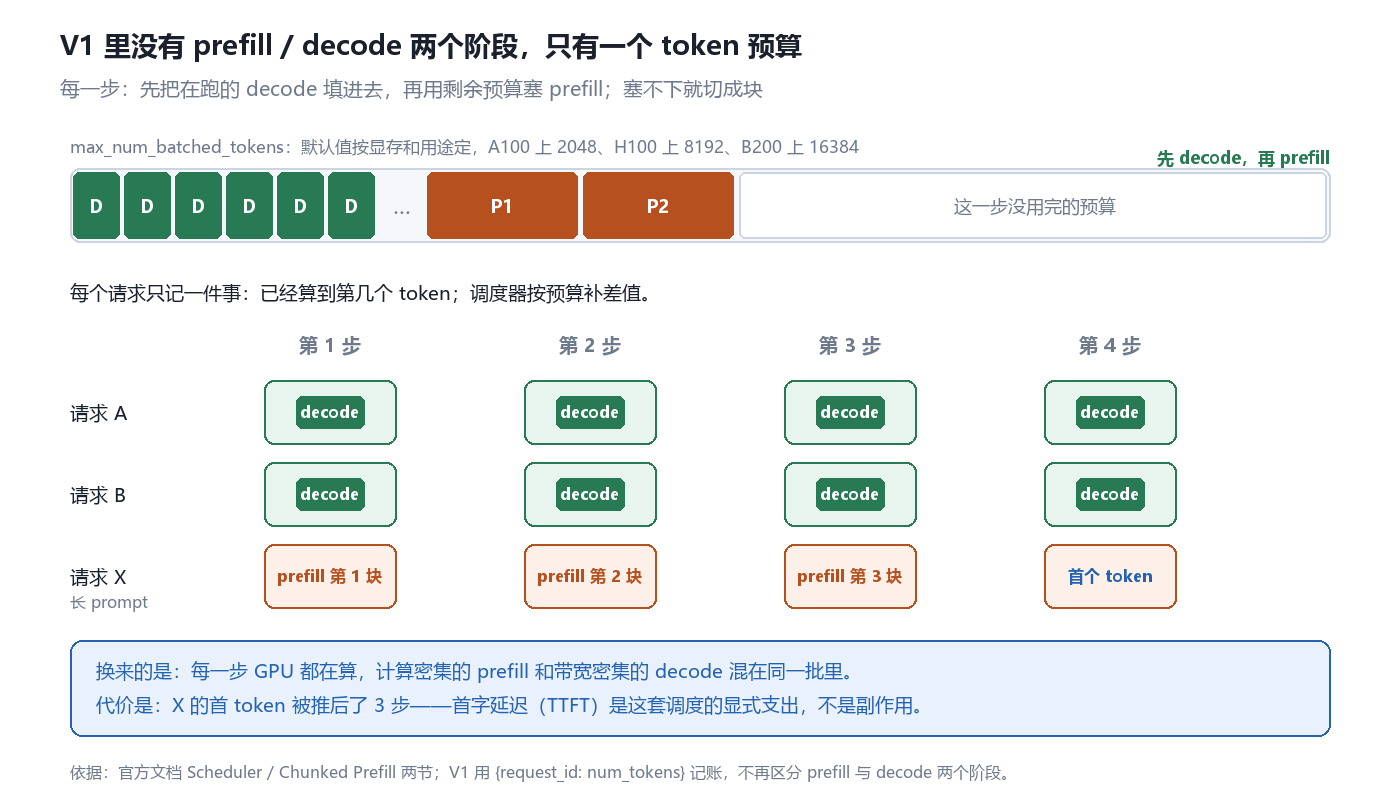
长 prompt 被切成三块、摊到三步里,期间短请求一直按步出字。
代价在这一节里是显式的:长 prompt 的首字延迟(TTFT)会被推后。 一个 32k 输入的请求,在预算 2048 的卡上光输入就要排十几步,而它后面排队的短请求已经答完了。吞吐和首字延迟在这套调度里是对立的两端,不是可以同时优化的两个指标。
顺带两个机制:抢占(preempt)在默认的 FCFS 策略下会挑最晚进来的那个在跑请求,把它踢回队首;--scheduling-policy priority 则可以按整数优先级排。异步调度(async scheduling)让 CPU 在 GPU 执行第 N 步时就把第 N+1 步排好,用占位符顶替还没生成的 token。
五、前缀缓存:命中只能落在整块边界
企业场景的请求多半共享前缀:一段固定系统提示词、一份反复追问的长文档、多轮对话的历史。前缀缓存(Prefix Caching)复用的就是这段前缀算好的 KV。
它的键是链式的:hash(父块哈希 + 本块 token + 额外值)。额外值里放 LoRA id、图像 hash、cache_salt——这决定了「同样一段文字」在什么条件下才算同一个块。
关键限制只有一句:只缓存整块。 官方文档给了一个漂亮的例子:块大小 4,两个请求前 10 个 token 相同,但第 3 块只对上前 2 个 token,于是只命中前 2 块(8 个 token),剩下的全部重算。
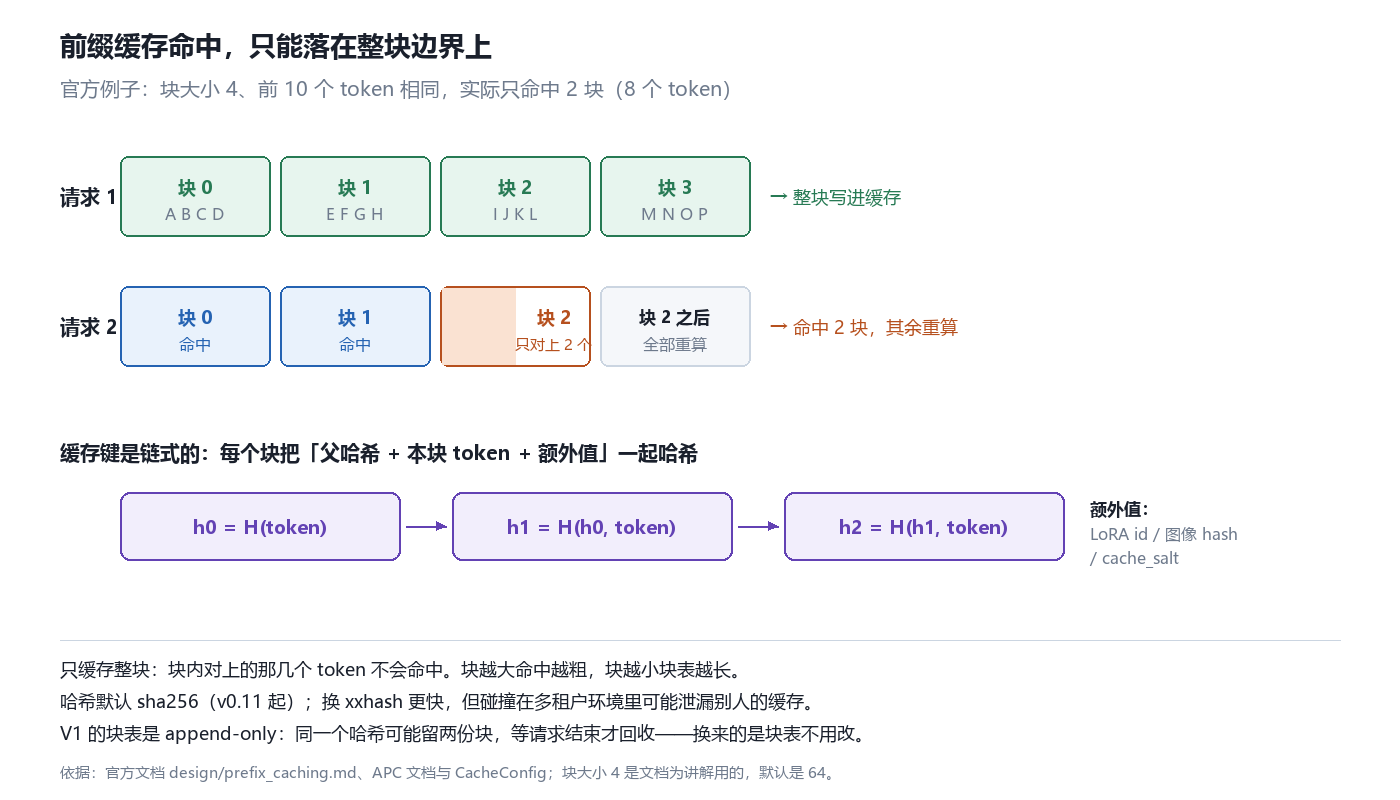
命中只发生在整块边界上;块内对上的那几个 token 不算数。
三个工程细节,读完文档才知道的分量:
- 默认是开的。 v0.6.3 里
enable_prefix_caching默认False,现在CacheConfig里默认True。 - 哈希默认 sha256(v0.11 起)。可以换
xxhash更快,但文档和代码都写了同一句警告:非加密哈希理论上增加碰撞概率,在多租户环境里可能泄漏别人的缓存。要用就配cache_salt把信任组隔开。 - V1 的块表是 append-only。 同一个哈希可能留下两份重复的块,等请求结束才回收;V0 会当场去重。这是一个很典型的 V1 取舍:块表不回头改,换来调度路径更简单。
还有一条边界必须记住:前缀缓存只省 prefill,不省 decode。 回答本身很长、或者每个请求前缀都不同的场景,它几乎没有收益。
六、显存不够时:量完再分,抢了就重算
到这里,账本的「格式」讲完了,剩下两个动作是关于「额度」的。
第一个动作:分配从比例改成实测。 过去要调 gpu_memory_utilization(比如 0.9),先圈一块再往里塞。现在 CUDA 和 ROCm 上默认走 extensible KV cache:启动时跑完 warmup 和 CUDA graph 捕获,量出真正还剩多少,默认值直接是 1.0,剩下的全给 KV Cache。其他平台(TPU、XPU、CPU)仍然是 0.92 的比例。
这个改动把「显存利用率」从调参项变成了测量项。只有当你和别的进程共享同一张卡时,才需要手动把它调小——因为 vLLM 只在 warmup 后量一次空闲显存,看不见之后别人的分配。
第二个动作:不够用的时候,抢了重算。 V1 的默认抢占模式是 RECOMPUTE:释放被抢占请求的块,把它踢回等待队列,等有空间了从头再算。V1 指南把 GPU 和 CPU 之间的 KV 换出直接标成了 Removed——换回来需要一份同样大的内存和一条 PCIe 带宽,而重算只需要算力。
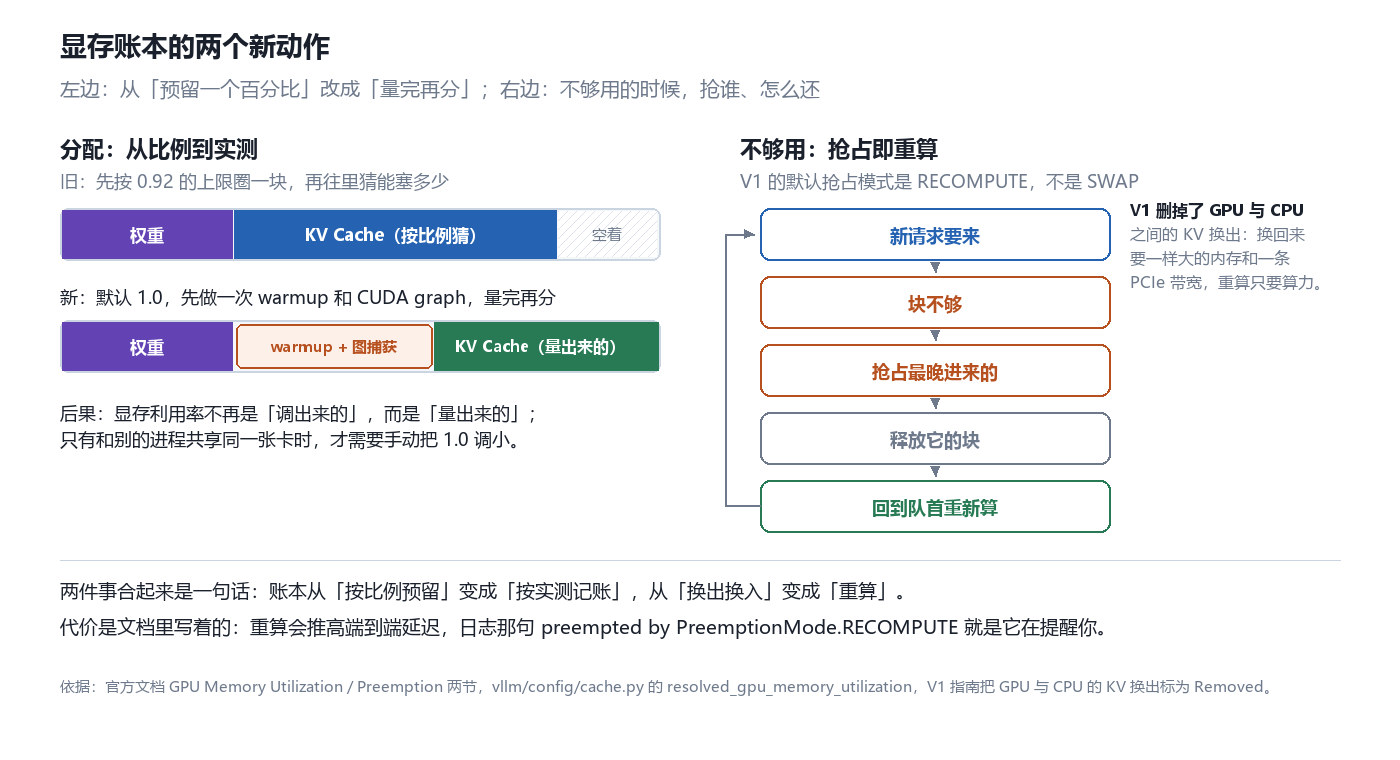
左边是分配方式的替换,右边是抢占后的归还路径。
代价写在文档的日志示例里,我原样抄一句:
WARNING ... Sequence group 0 is preempted by PreemptionMode.RECOMPUTE mode
because there is not enough KV cache space. This can affect the end-to-end performance.
看到这行就该知道:账本已经绷紧了,延迟会被重算拖回去。V1 还有一个反直觉的副作用——官方明说 CUDA graph 捕获比 V0 更吃显存(原因它没写,我猜是统一调度让每个批的形状更碎、要捕获的图更多)。
七、五种切法,一份进程账单
单卡装不下,就要切。README 列了五种,切的是五个不同维度:
| 切法 | 切什么 | 新增的等待 |
|---|---|---|
| Tensor Parallel | 层内的矩阵按列切 | 每层一次 all-reduce |
| Pipeline Parallel | 按层段切给不同卡 | 流水线气泡 |
| Data Parallel | 复制整份模型 | 副本各吃一份权重 |
| Expert Parallel | MoE 专家分散到不同卡 | 路由跨卡通信 |
| Context Parallel | 长上下文切段 | attention 结果要合并 |
它们可以叠加,代价是进程数、CPU 核数和通信层数一起涨——上一节那个 17 进程就是 TP=2 DP=4 叠出来的。
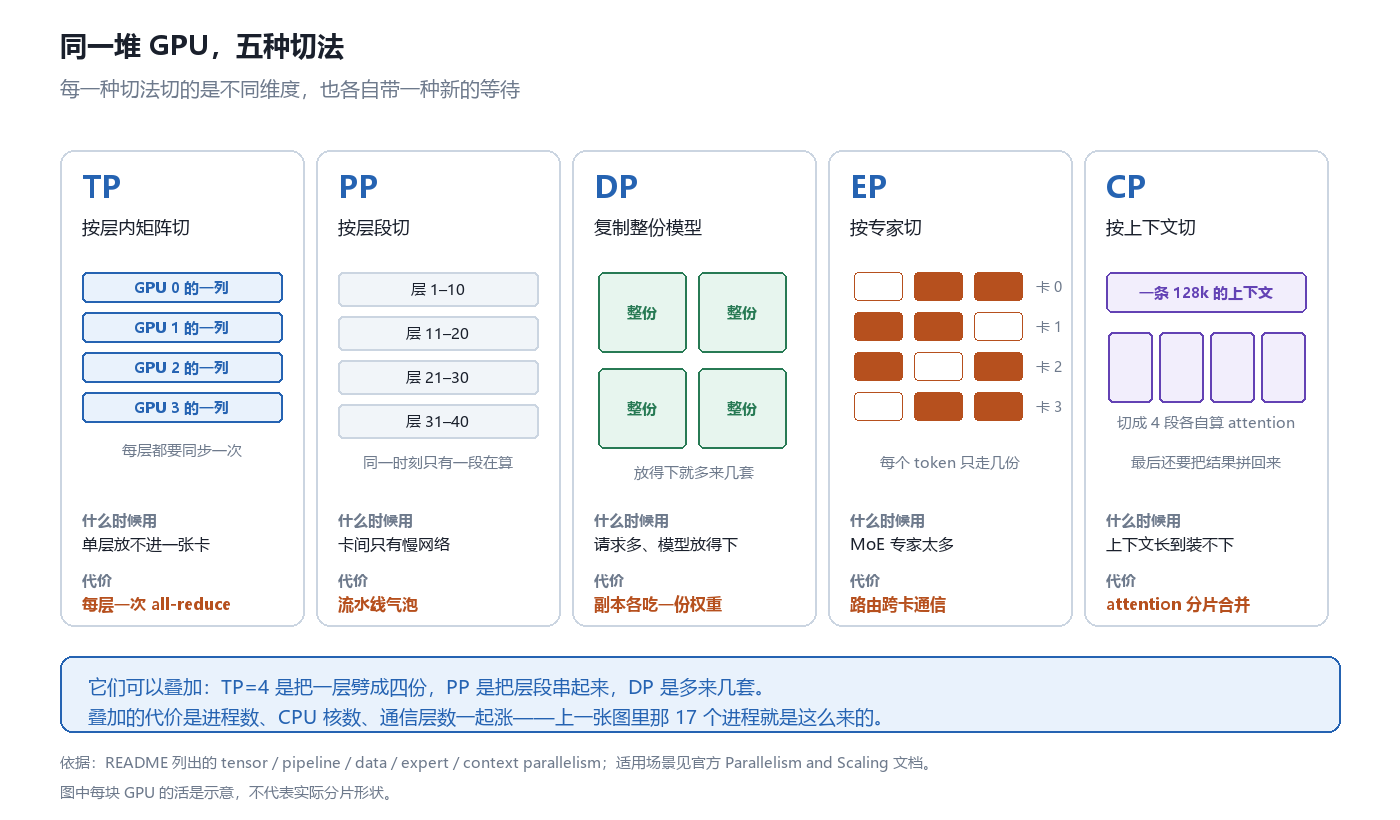
每种切法都在切一个新维度,也都带一种新的等待。
还有一条不在这个表里的路:分离式服务(disaggregated serving)。README 写的是 prefill、decode、encode 都可以拆开部署,让算力密集的 prefill 和带宽密集的 decode 各自用最合适的卡,中间靠 KV 传输连起来。代价是 KV 要从一台机器搬到另一台,网络成了新的瓶颈——这也是为什么它和 Mooncake、LMCache 这类 KV 存储项目常一起出现。
八、量化与推测解码:两次换空间的交易
这两项常被当成「加速开关」,其实都是交易。
量化是拿精度换显存。 README 列的格式已经很全:FP8、MXFP8/MXFP4、NVFP4、INT8、INT4、GPTQ/AWQ、GGUF、compressed-tensors、ModelOpt、TorchAO。KV Cache 本身也能量化,--kv-cache-dtype(配置里叫 cache_dtype)支持 fp8,还有 nvfp4_4over6 这种按 16 个值选 max/6 或 max/4 尺度的新格式。
代价写在启动日志和代码注释里:it may cause accuracy drop without a proper scaling factor。KV Cache 量化影响的是注意力本身,不是权重加载,长上下文任务上掉点会更明显。
推测解码是拿算力换延迟。 小模型(或用 n-gram、suffix 这种不用模型的草稿)先猜几个 token,大模型一次前向验证,接受多少算多少。README 列的方案是 n-gram、suffix、EAGLE、DFlash;文档示例里还能看到 MTP(--speculative-config '{"method":"mtp"}')和草稿模型那条老路。
它不平白无故加速:草稿本身要算,接受率低就白算,高并发下 GPU 本来就被 batch 填满,收益更小。它能帮上忙的场景,通常是内存带宽受限、并发不高、解码是纯串行瓶颈的时候——这一条是我的推断,官方没有给统一的加速倍数,我也不想编一个。
九、支持矩阵:200+ 架构不等于任意组合
README 说支持 200 多种 Hugging Face 架构,覆盖 Decoder-only、MoE、混合注意力与状态空间模型、多模态、Embedding、Reward/分类。硬件上,官方文档的 V1 支持表是这几行:
| 硬件 | V1 状态 | 备注 |
|---|---|---|
| NVIDIA / AMD / Intel GPU | 官方支持 | 主要开发平台 |
| Google TPU | 官方支持 | 有独立文档项目 |
| CPU(x86 / ARM / PowerPC) | 官方支持 | 吞吐另算 |
| Huawei Ascend / Intel Gaudi / IBM Spyre / OpenVINO | 插件 | 装法与成熟度各自不同 |
| Apple Silicon / MetaX / Iluvatar CoreX / Rebellions | 插件 | README 列举,细节看各自仓库 |
但真正要看的是功能矩阵,不是架构数。V1 指南里写着两条容易被忽略的红线:
- Mamba 与混合模型(Mamba-2、Zamba2、Jamba、NemotronH 等)可以跑,但前缀缓存对它们全部不支持。
- Encoder-decoder 只有 Whisper 是原生支持的,其他(BART、Florence-2)要走插件,
Mllama这类建议自己按插件模式实现。
接口方面比很多人以为的宽:OpenAI 兼容 API 之外,还有 Anthropic Messages API 和 gRPC。装法也从 pip install vllm 变成了推荐 uv pip install vllm 再补一条 vllm download-kernels(预编译 kernel,换启动速度)。
十、局限
按重要性排,都是文档里写着的或能从结构里量出来的:
- V1 是重写,不是升级,删了东西。
best_of、请求级 logits processor、GPU 与 CPU 之间的 KV 换出都没了;V0 已经标记为完全废弃(RFC #18571)。老配置搬过来之前先查一遍 V1 指南的功能表。 - CPU 是隐形依赖。 进程数 ≥ 2 + N,物理核少于进程数就会饿死 engine core 那个 busy loop。容器里最容易踩。
- 默认值一直在变。 块大小 16 → 64,前缀缓存关 → 开,
gpu_memory_utilization0.9 → 1.0(CUDA/ROCm),max_num_batched_tokens按卡分档。抄两年前的参数等于抄错答案。 - 前缀缓存只省 prefill,而且要求前缀逐 token 一致——语义相似但措辞不同,命中不了。
- 抢占重算会把延迟打回原形。 高并发下那些
preempted by PreemptionMode.RECOMPUTE的日志不是噪音。 - 块表 append-only 会留重复块。 换来的是调度路径简单,代价是同一份 KV 可能占两份显存,直到请求结束。
- 量化和 KV 量化都有精度代价,文档自己写了
may cause accuracy drop,别把它当成免费的显存。 - 支持矩阵有空洞。 200+ 架构解决的是「能不能加载」,不解决「前缀缓存/推测解码/量化能不能一起用」。Mamba 家族没有前缀缓存就是例子。
十一、我的判断
我认为 vLLM 真正值得学的,不是它调了哪些 kernel,而是它把推理服务当成一个内存分配 + 在线调度问题来解。这个视角一旦建立,很多看起来像「魔法」的数字就都有了出处:2–4 倍来自块表,2.2 倍来自引用计数共享,首字延迟的代价来自 token 预算的填法,preempted 日志来自账本见底。
所以判断一个推理引擎,我会先问三个问题,而不是先看 benchmark:
- 它怎么记账? 按请求一条连续显存、按块、还是按页加前缀哈希——决定了并发上限。
- 谁排班? 一个统一预算、两个独立阶段、还是按优先级加 SLA——决定了延迟的分布形状。
- 账本见底时怎么办? 换出、重算、还是拒绝——决定了尾延迟的形状。
接下来我会盯三件很具体的事,都能在代码里验证:
- 块大小还会不会变。 从 16 到 64,已经出现了
prefix_match_unit这种比块更细的匹配粒度;如果哪天默认值再动一次,说明分页的粒度本身在重新设计。 - 换出会不会回来。 V1 删了 GPU 与 CPU 的换出,但
CacheConfig里已经有KVOffloadingBackend(native / lmcache)——「重算换空间」这条路走到头,账本可能又需要一层外存。 - 调度器会不会长出第三档策略。 现在只有 FCFS 和 priority;真实的多租户服务需要的是按 SLA 的配额,而不是一个整数优先级。
顺便说一句,这和我最近在看的干预接口是同一个问题:KV Cache 是一次前向留下的状态存档,前缀缓存让它变得可寻址、可复用。谁能寻址这些状态,谁就能干预它们——推理引擎的账本,和可解释性工具里的缓存,本质上是一回事,只是目的不同。
项目与资料
- 仓库:vllm-project/vllm(Apache 2.0,97,076 star / 24,913 fork,
v0.34.0,2026-11-16) - 官网:vllm.ai · 文档:docs.vllm.ai
- 架构:Architecture Overview(进程表和进程数公式)· V1 用户指南(V0 废弃、删掉的功能、Mamba 与 encoder-decoder 状态)
- 机制:Automatic Prefix Caching 设计文档(链式哈希、块表 append-only、LRU)· Optimization and Tuning(抢占、chunked prefill、CPU 核心)
- 论文:Efficient Memory Management for Large Language Model Serving with PagedAttention(SOSP 2023,2–4 倍吞吐)
- 博客:vLLM: Easy, Fast, and Cheap LLM Serving with PagedAttention(60%–80%、不足 4%、1.7 GB、55% / 2.2 倍)
数据说明:star / fork / release / 建库时间取自 GitHub API(2026-11-17);进程数、CPU 核心要求、调度器语义、抢占策略、显存分配来自官方文档的 Architecture Overview、Optimization 与 V1 用户指南;块大小 64、前缀缓存默认值、sha256 默认、nvfp4_4over6 等来自 vllm/config/cache.py、vllm/config/scheduler.py、vllm/engine/arg_utils.py 与 design/prefix_caching.md;块大小 16 取自 v0.6.3 的 EngineArgs。文中六张示意图是我按这些文档画的,不是项目官方图表;那个 0.78 MiB/token 和「八条序列」是我自己按 LLaMA-13B 参数算的,官方博客只给了 1.7 GB 这个结果。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- Diagram Design:50 种图表是目录,能拒绝你的检查才是产品
- gpu-unlock:GeForce 的半速矩阵算力,写死在八个 4 位字段里
- Octop:单进程是它的地基,也是它的天花板
- VoiceStudio:把 ElevenLabs 搬回本地之后,账单换成了许可证
- DroidDeck:手机跑 PC 游戏不难,难的是让 Android 相信自己正在当主机
- magpie:它调度的不是模型,是会过期的额度
- Aerial:换桌面不是画界面,是在别人的固件里抢前台
- colibri:同一个引擎 184 倍的速度差,全部来自权重住在哪一层
- GEO:最有效的三种写法,官方提示词里都写着“可以编造”
- HelixHarness:Harness 工程的两份契约,一份写成了协议,一份还没有数据