TokenEconomizer:Coding Agent 的成本按仓库累积,不按任务计价
一个 Coding Agent 在同一个仓库里跑到第 30 个任务,仍然可能重新发现「这个项目的测试要用 python -m pytest」,并且为这次重新发现付费。
这句话以前是抱怨,现在有数字了。微软研究院和 UC Berkeley 的 TokenEconomizer 在 60 条未修改 agent 的 SWE-Bench 轨迹上量了三件事:每轮随请求发出的 23 个工具定义里有 16 个从未被调用;失败任务只占 17%,却吃掉 32% 的花费;仓库里积累 5 个任务之后,30% 的工具调用在重复前面已经做过的动作。
- GitHub:microsoft/TokenEconomizer(Apache-2.0,Python 3.10+)
- 论文:arXiv 2610.22732(2026-10-15,CC BY 4.0)
- 项目主页:tokeneconomizer.github.io
本文只讲一件事:它把成本的计量单位从「任务」换成了「仓库序列」。 三个机制都是这个换位的结果,包括它们在论文里和发布版插件里不一致的那几处。
一、省 token 这件事,为什么一直做不对
先把账单拆开。agent 每转一轮,都要重新发出系统指令、每个工具的完整定义、以及到目前为止的全部历史。prompt cache 给这些重复内容打折,但打折不是免费——论文的原话是 “caching discounts this replayed context but does not eliminate its cost”。
已有的优化几乎都作用在单个任务上:
| 路子 | 怎么省 | 代价 |
|---|---|---|
| 降低推理强度 | 少想 | Pass@1 掉 1.8–10.3 个百分点 |
| 手工改工具集 | 少发几个工具定义 | 靠人猜,且不随任务变化 |
| 轨迹压缩 / 观察过滤 | 把历史压短 | 要改 agent loop 或训练额外组件,不通用 |
| 加 MCP 服务器 | 让 agent 找符号更快 | 多一份工具定义,每轮都要付费 |
注意最后一行。这篇论文测了三个流行的固定策略:RTK(把命令输出压短)、Serena(加语义代码导航)、Aider 的 RepoMap(把仓库符号地图塞进指令)。同一套配置跑遍 6 个仓库,结果是:
三个策略都在 Django 上更便宜、在 SymPy 上更贵;scikit-learn 上只有 RTK 有效,Sphinx 上只有 RepoMap 有效。
没有一个固定策略处处更便宜。把它们混在一起平均,效果接近零——不是因为它们没用,而是因为在 A 仓库赚的钱被在 B 仓库亏的钱抵消了。这是我读完第二节最直接的感受:成本不是 agent 的属性,是 agent 和仓库这一对的属性。
所以论文把优化对象改了:不再优化「一次任务」,而是优化同一仓库里连续任务流(τ1 … τn)的累积成本。
二、可削减的成本长什么样
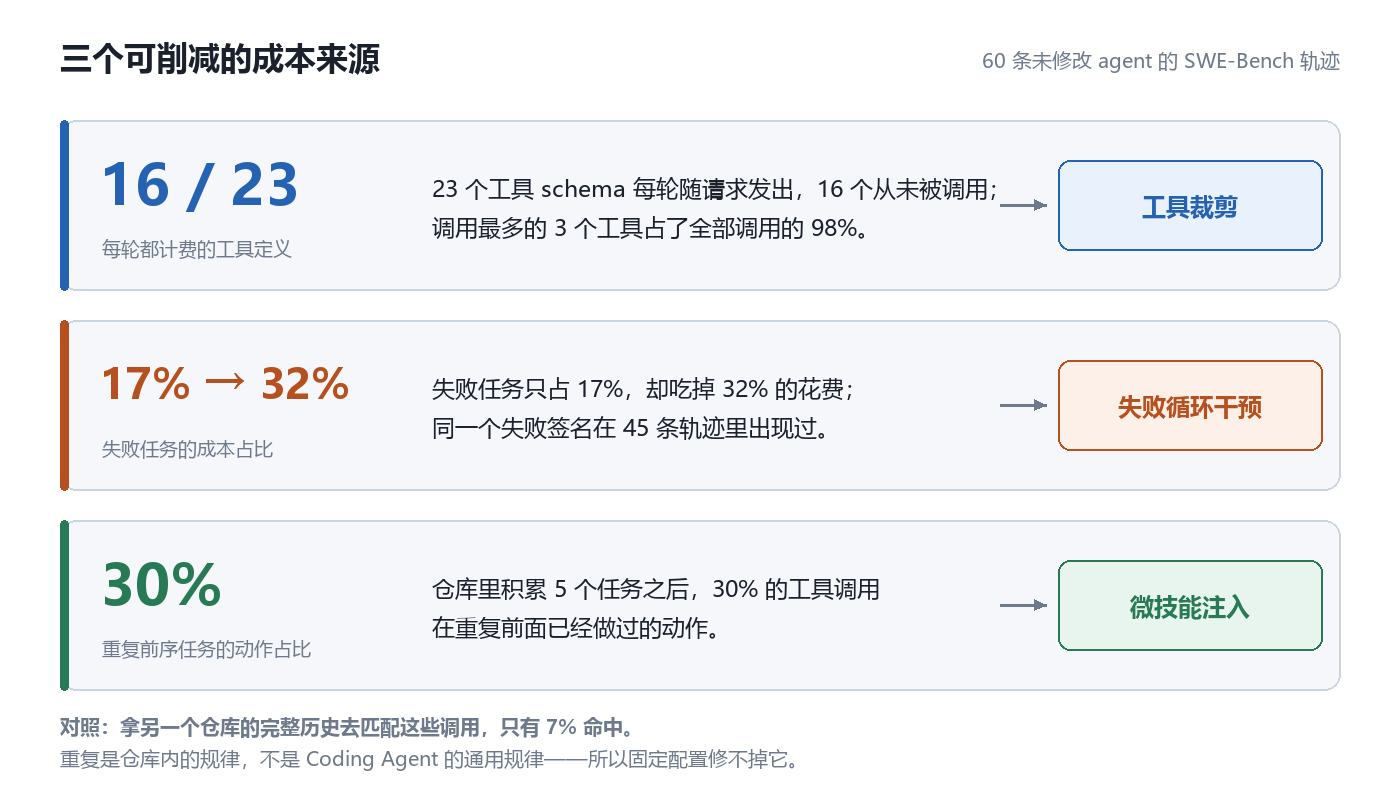
60 条未修改 agent 的轨迹:每一条浪费都对应一个自适应策略,而不是一个固定开关。
三个数字值得各自多说一句。
16 / 23。 agent 每轮看到 23 个工具 schema,可没有任何一个仓库调用超过 7 个;16 个从未被调用,而调用量最高的 3 个工具占了全部调用的 98%。这意味着一份很大的固定开销,换来的边际能力很小。
30%。 「运维性动作」——装依赖、跑测试、看目录——在至少一半任务里重复出现,占工具调用收发字节的 12–28%。关键是趋势:第二个、第三个任务只有 14% 的调用匹配前序动作,一旦前面排了至少 5 个任务,这个比例升到 30%。而拿另一个仓库的完整历史去匹配,只有 7% 命中。
这就是「仓库内规律」和「通用规律」的分界线:7% 是换个仓库也能复用的通用部分,30% 里剩下的那部分只在同一个仓库里出现——可以被记住,但没有人替它记住。
17% → 32%。 失败的执行占任务数的 17%,却占掉 32% 的钱。60 条轨迹里有 45 条重复过更早的失败签名,51% 的花费发生在某条轨迹第一次重复之后。
但这里有一句论文自己写下的反证,很多二手介绍都漏了:50 条成功轨迹里,也有 36 条重复过失败签名,而且重复之后过半的花费落在最终成功的那批轨迹里。所以「重复」不能当失败的判据,只能当「值得看一眼」的信号。第三道机制的全部设计难度都在这里。
三、micro-skills:一条事实要过几道闸门
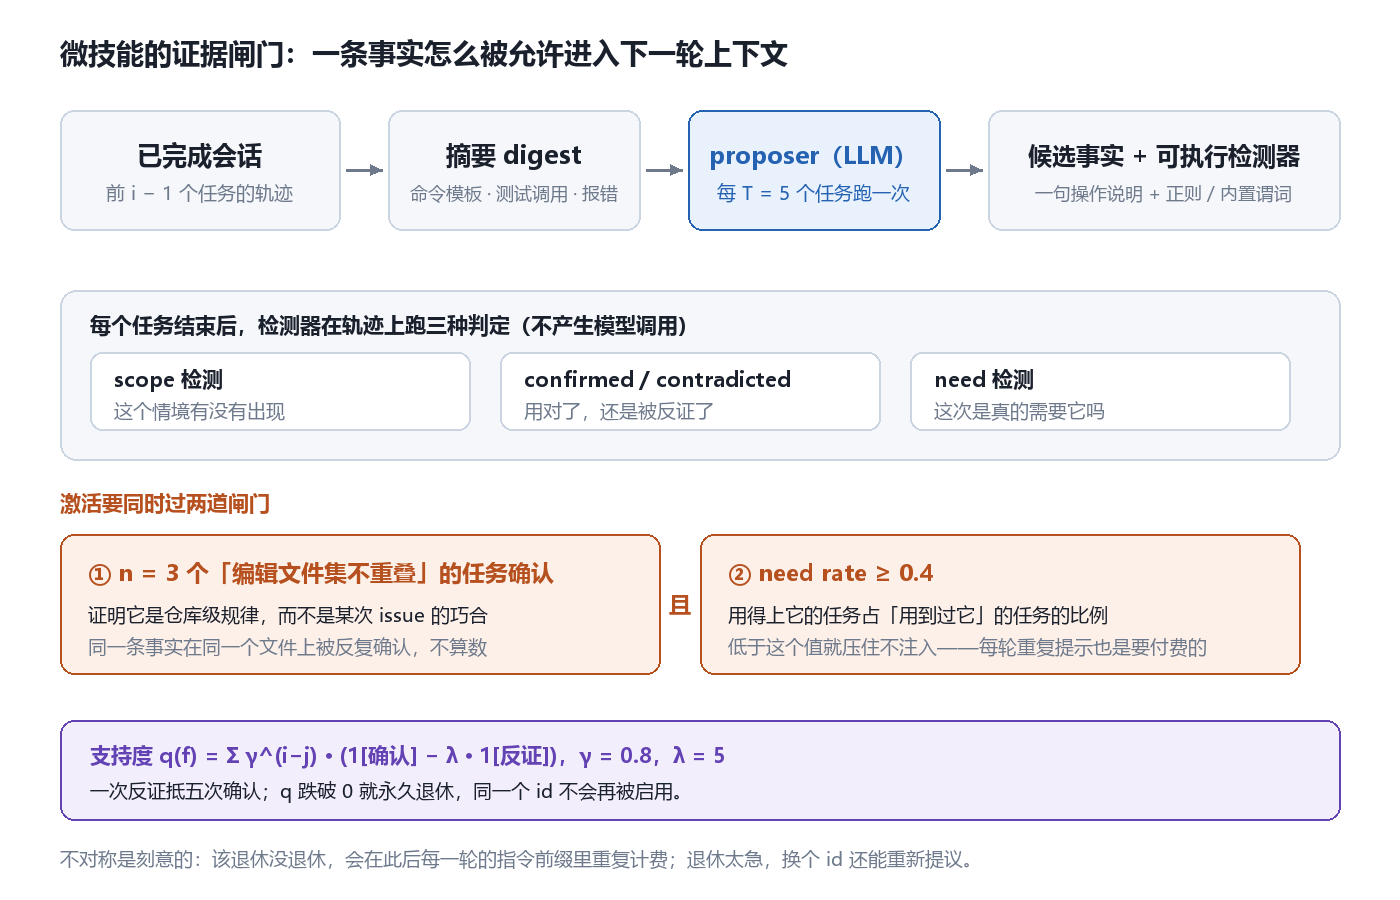
提议是模型的事,验证不是——检测器是可执行的,所以「经验」在这里可以被反证。
机制分两段。上半段是生产:每 5 个任务,一个 LLM proposer 把近期轨迹压成 digest(命令模板、测试调用、报错、改过的文件),起草几条候选事实,每条都带一个可执行检测器——正则或内置谓词,能在真实轨迹上跑。
下半段是验证,也是最容易被讲漏的部分。每个任务结束后,检测器在轨迹上做三种判定:
- scope:这条事实针对的情境出现了没有(比如「写复现脚本」这条,只有在 agent 真的去写脚本时才算被触发);
- confirmed / contradicted:用对了,还是被反证了(比如事实说某包装好了,结果 import 报错);
- need:这次是真的需要它,还是恰好路过。
然后过两道闸门才允许注入:
- n = 3,且三个任务的「编辑文件集不重叠」。 同一条事实在同一个文件上被反复确认,不算数——那可能是某次 issue 的局部知识,不是仓库规律。
- need rate ≥ 0.4。 用得上它的任务,占「触发过它」的任务的比例,低于 0.4 就压住不注入。理由是:每轮重复一条没用的提示,本身也是要付费的。
退出机制有一处刻意的不对称。支持度写成 $q_i(f) = \sum_{j<i} \gamma^{i-j}\left(\mathbf{1}[\text{confirm}] - \lambda\,\mathbf{1}[\text{contradict}]\right)$,其中 $\gamma = 0.8$ 让旧证据衰减,$\lambda = 5$ 让一次反证抵五次确认。跌破 0 就永久退休,同一个 id 不会再被启用。
论文给的解释很实在:两种错误的代价不对称。该退休没退休的事实,会在此后每一轮的指令前缀里重复计费;而退休太急的事实,换个 id 还能重新提议。
我认为这是全文最值得抄的一处设计:它把「记忆」写成了一个带假阴性/假阳性不对称代价的判定问题,而不是一个「把上次的总结塞进 system prompt」的工程活。
四、工具裁剪:先保核心,再谈裁谁
第二个机制反而简单,但细节全在边界条件上。
永远保留 shell 执行和文件读/写/编辑这几类核心工具,其余工具在连续 $k = 3$ 个任务都没被调用后屏蔽。对从未调用过的工具,再加一个 LLM judge,用工具描述和当前任务描述判断相关性——判断前先把任务描述里指向 PR、issue、commit、文件的链接 mask 掉,否则 judge 会靠「任务提到了 .ipynb」这种捷径反推出「需要 Notebook 工具」。
还有一道定期回审:每 $R = 5$ 个任务恢复全量目录,回审期间被调用过的工具永久解禁。这就是「裁剪」和「删除」的区别。
落到发布版插件上,裁剪是写进 agent 自己的设置文件的,粒度跟着 agent 走:
| Agent | 能裁掉什么 | 写进哪里 |
|---|---|---|
| Claude Code | 单个工具 | .claude/settings.local.json |
| Codex | 能力包 | .codex/config.toml |
| Copilot CLI | 整个 MCP 服务器 | .github/copilot/settings.local.json |
| Pi / Droid / Cursor 等 | 暂不支持(无持久化的单工具设置) | — |
插件只追加自己的条目,不动你手写的 deny 规则;它创建的文件会被写进 .git/info/exclude。如果那个设置文件是仓库提交的、或者 JSON 不合法、或者符号链接指向仓库外,它就不写,把结果留成一条「建议」。
五、失败循环:三道闸门,以及「打断」不等于「判死」
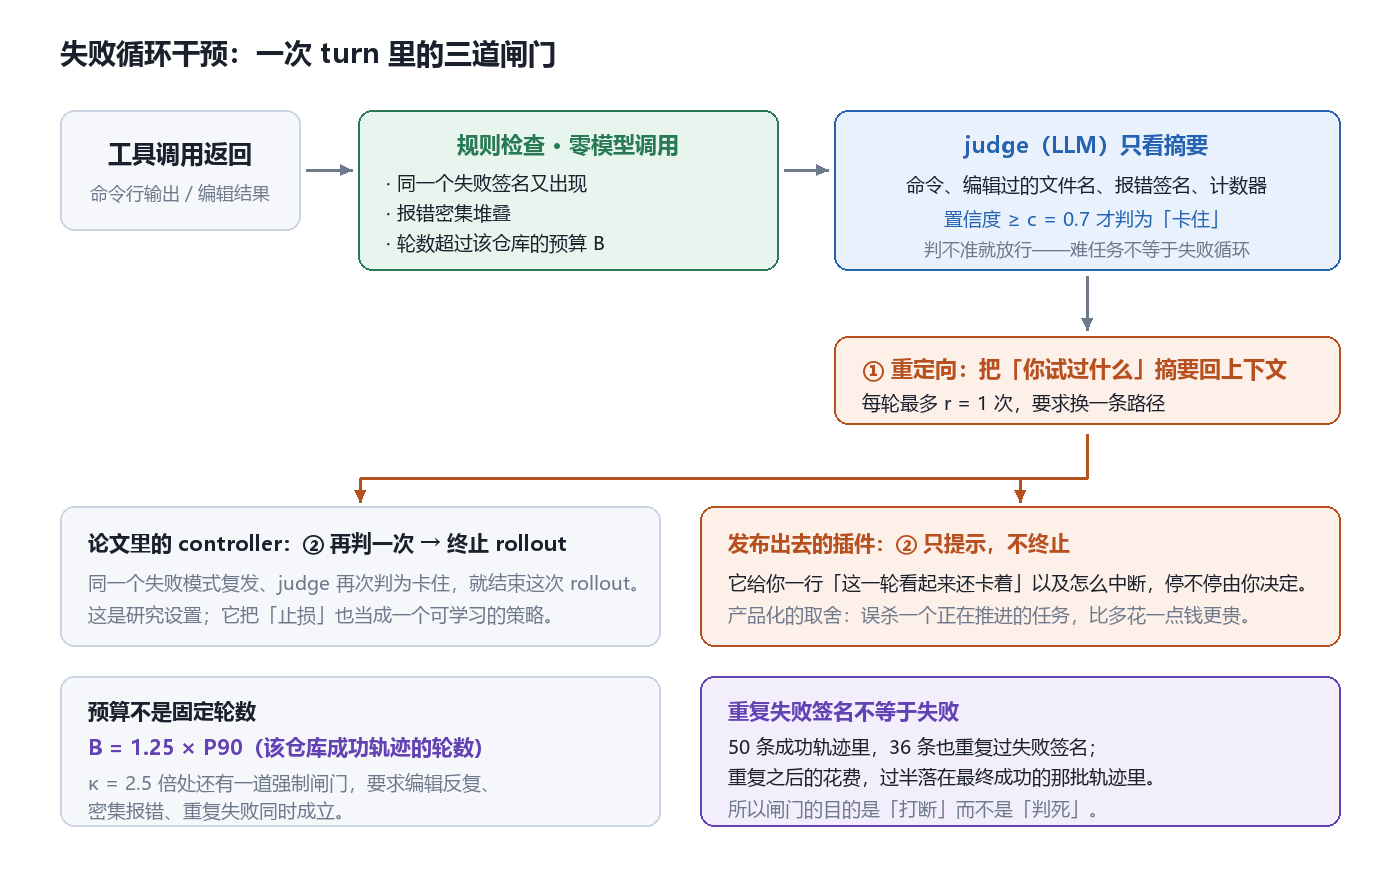
规则检查免费、judge 只看摘要、重定向一次——三道闸门的分工决定了它便宜且不容易误杀。
第三道机制的第一件事,是不用固定轮数。它从该仓库已经成功的轨迹里取轮数的 P90,乘 1.25 当作这次任务的预算:
\[B_i = \beta \cdot Q_p(\{|\xi_j| : j < i,\ y_j = 1\}),\quad \beta = 1.25,\ p = 90\]理由是论文里那个对比:Matplotlib 的失败轨迹比成功轨迹长很多(45 轮 vs 20 轮),而 Sphinx 的失败轨迹只长一点(36 轮 vs 31 轮)。一个全局的轮数上限,在一个仓库上太松、在另一个仓库上太紧。
有了预算,闸门按代价从低到高排:每次工具调用后跑一次纯规则检查(同一个失败签名、报错密集、超过预算),零模型调用;触发后,一个 judge 只看最近动作的摘要(命令、改过的文件名、报错签名、计数器),置信度 ≥ 0.7 才判「卡住」;判为卡住就注入一条重定向,把「你试过什么」摘要回上下文,要求换一条路径,每轮最多一次。再往后,还有一道 $\kappa = 2.5$ 倍的强制闸门,但要求编辑反复、密集报错、重复失败同时成立才触发。
这里出现了论文和发布版插件最实质的一处分歧,我单独放在第七节说。
六、结果:省下的是真钱,Pass@1 也没有被拿去换
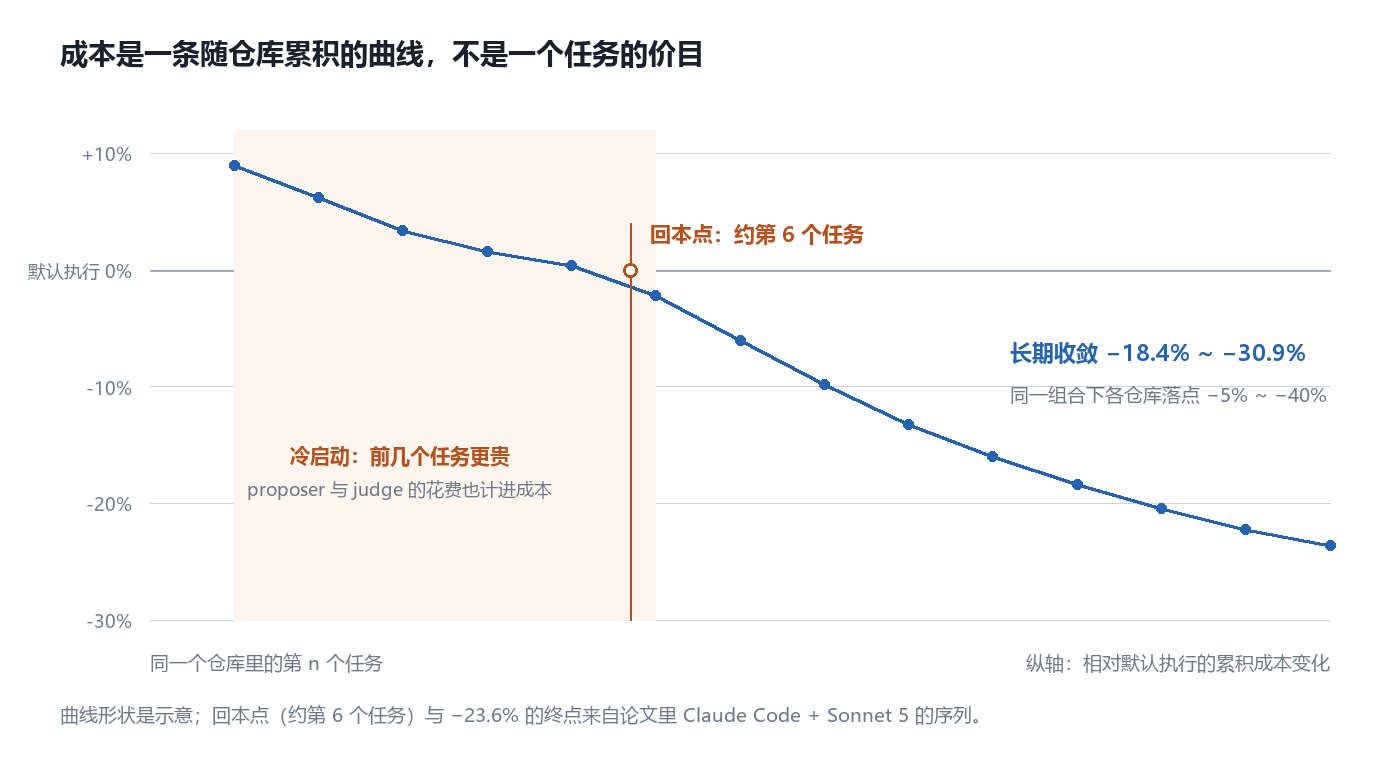
横轴不按真实任务数缩放,曲线形状是示意;回本点(约第 6 个任务)与 −23.6% 的终点来自论文里 Claude Code + Sonnet 5 的序列。
277 个 SWE-Bench 任务,6 个仓库(scikit-learn 60、SymPy 60、Django 40、Sphinx 44、Matplotlib 34、xarray 39),5 组 agent–模型组合。同一仓库内的任务按时间顺序跑,所以第 i 个任务只能用到前 i−1 个的经验。成本按 cache 计价口径算,并且包含 controller 自己产生的每一次模型调用。
| 组合 | 平均成本变化 | Pass@1 变化 |
|---|---|---|
| Claude Code + Sonnet 5 | −23.6% | +1.3 |
| Claude Code + Opus 4.8 | −30.9% | −1.0 |
| Codex + GPT-5.6 Terra | −24.7% | +0.9 |
| Codex + GPT-5.6 Sol | −26.1% | +1.6 |
| Copilot CLI + Sonnet 5 | −18.4% | +2.6 |
表外还有三个点值得单独说:
- 30 个格子全部更便宜。 6 个仓库 × 5 个组合,同一个仓库内每个组合都比默认便宜,落点在 −5% 到 −40% 之间。
- Pass@1 是 4 升 1 降,唯一的下降是 Opus 4.8 的 −1.0。作为对照,同一篇论文里把推理强度降到 medium 或 low,Pass@1 要掉 1.8–10.3 个点——这就是这件事值得做的原因:省下的钱大体上不是拿成功率换的(唯一的例外是 Opus 4.8 的 −1.0)。
- 消融:单靠工具裁剪最省,因为它每一轮都生效;但任何单个机制都追不上三者合用,而单独使用时 Pass@1 仍在默认值的 3 个点之内。
泛化的两组数字,读法比数字本身重要:
| 基准 | 规模 | 成本变化 | 质量口径 |
|---|---|---|---|
| Web-Bench | 102 任务 / 5 个项目 | −16.0% ~ −21.2% | 累积 Pass@2 持平 |
| CredData + ReposVul(安全审计) | 各 100 任务 | −6.4% ~ −19.6% | 检测 F1 持平 |
安全审计那两组的每个任务都在新仓库里,所以 micro-skills 直接关闭。也就是说:当仓库不再连续,收益从 18.4–30.9% 掉到 6.4–19.6%。 这不是巧合,同一个变量在两个实验里各出现了一次。我由此推断:仓库记忆是主要收益来源,剩下的是工具接口和失败循环那部分——论文没有把这个拆分单独列出来。
七、论文和发布版插件,有四处不一致
这是我在读源码说明时花时间最多的地方。论文的 controller 和仓库里装到你机器上的插件,不是同一个东西:
| 维度 | 论文里的 controller | 发布版插件 |
|---|---|---|
| micro-skills | 默认开启,每 T = 5 个任务提议一次 | 默认关闭(proposer 要花钱,收益看仓库),每 k = 3 个会话提议一次 |
| 工具裁剪 | 计数 + LLM 相关性判断 + 每 5 任务全量重审 | 纯计数证据:p = 10 个未使用提示、跨 m = 2 个会话,或 s = 5 个会话;无 judge |
| 循环干预 | 重定向一次,再犯就终止 rollout | 永不终止,最多一次重定向,之后只给你一行「按 Esc 中断」的提示 |
| 适配范围 | 5 组组合、3 个 agent | 4 个主力 agent + 6 个实验性适配,版本窗口写死 |
我不觉得这是「论文注水」。这是两次不同的取舍:论文要的是能力上界(止损也是一种可学习策略),插件要的是装上去不会害你——误杀一个正在推进的任务,比多花一点钱更贵。
但有一个后果得说清楚:README 首页那个「18.4–30.9%」不是开箱即得的数字。micro-skills 默认是关的,你得主动 config set microskills=on 才会拿到论文里那部分收益。
版本窗口也值得抄下来,因为它暴露了黑盒适配的真实成本:
| Agent | 支持版本 |
|---|---|
| Claude Code | 2.1.300 – 2.1.310 |
| Codex | 0.153.1 – 0.164.0 |
| Copilot CLI | 1.0.83 – 1.0.102 |
| Pi | 1.2.0 – 1.3.0 |
一个 patch 号的距离就要重新验证。Cursor 的实验性适配更直白:它拿不到每个 session 的 token usage,所以干脆把成本报成 unavailable。
八、局限
按我判断的重要性排:
- 冷启动是一次赌注。 前几个任务更贵(要付 proposer 和 judge 的钱),Claude Code 那组大约到第 6 个任务才回本。仓库用得越少,越可能净亏——而「偶尔用一次 agent 的仓库」是多数人的常态。
- 样本是 6 个仓库、277 个任务,每个仓库 34–60 个任务。 它证明了「第六个任务之后更便宜」,但没有证明「第 60 个任务之后还会继续便宜」。任务流再长一点会不会触底,论文没有说。
- 主力组合只有 3 个 agent、5 组模型。 而且它靠 hook 吃饭:Codex 0.141.0 之前的版本完全不跑 plugin hook,三个机制一起失效。
- 记忆单元是「仓库」。 monorepo 或者一个仓库里塞了三个服务时,经验会互相串味:A 服务的测试命令被当作整个仓库的规律注入 B 服务。论文没有讨论这种情况。
- 经验过期的清除依赖反证。 一条「用
python -m pytest」的事实,在测试框架迁移后会过期;但如果迁移之后再没有任务碰过那个文件,反证永远不会来,这条事实会一直被注入。这是我从 $q_i(f)$ 的更新条件推断出来的漏洞,论文没有正面处理。 - 计费口径依赖 agent 暴露用量。 拿不到 usage 的 agent 只能报 unavailable,那时「省了多少」就成了估计值。
- 失败循环的判定仍然是启发式的。 judge 只看摘要,判不准就放行——这个保守方向是对的,但也意味着最难的那种「缓慢偏离」(每一步都像有进展,但整体在浪费)它管不到。
九、我的判断
这篇论文最值得拿走的不是三个机制,而是它对状态的定义:
\[(\Delta P_i,\ \mathcal{U}_i,\ B_i) = \mathcal{C}(\tau_i,\ S_{i-1})\]$S_{i-1}$ 是从已完成的轨迹里蒸馏出来的仓库状态,不是聊天记录。这个区别决定了后面所有设计:聊天记录只能被压缩、摘要、塞进 prompt;轨迹可以被检测器验证。
三个机制共享同一个状态,但更新规则各不相同——事实用可执行检测器验证,工具用计数,循环用相对预算。经验能落地的前提是经验可证伪。 这是我在这篇文章里最想记住的一句。
下一步我会想看三个实验,都能测:
- 序列长度的拐点。 现在最长的任务流是 60 个任务(scikit-learn 与 SymPy),把同一条流拉到几百个任务,看累积成本是继续下降还是触底。这是「越用越省」这句话唯一的实证。
- need rate 阈值是真正的旋钮。 $\rho = 0.4$ 决定了注入多少条事实,论文把这个值固定住了、没有扫。扫一遍 $\rho$ 应该能得到一条成本–成功率的曲线,而这正是「注入多少经验」这个问题的答案。
- 跨仓库迁移。 如果把学到的事实按「命令模板」抽象一层,能不能减少 B 仓库的冷启动?论文的对照实验(另一个仓库的历史只命中 7%)说明现在不行,但那是逐字匹配的结论,不是语义抽象的上限。
回到我一直在看的那条线:上下文管理真正缺的不是压缩算法,是「什么值得跨会话保留」的判定器。压缩是在给定的上下文里做减法,而这套东西是在决定哪些内容有资格进入下一次的上下文。前者是编码问题,后者是判定问题——这篇论文给了判定器的三个具体形状,还给每个形状配了假阳性/假阴性的代价。
项目与资料
- GitHub 仓库(Apache-2.0;
python -m pytest tests跑离线测试) - 论文 arXiv:2610.22732(2026-10-15,CC BY 4.0)
- 项目主页(交互图表、逐仓库数字、9 个标注过的案例)
- 插件说明
plugin/README.md(每个 agent 的安装、设置、限制) - 实验框架
experiments/(复跑 SWE-Bench 与 Web-Bench 的那条路)
数字来源:成本与 Pass@1 来自论文与 README 的结果表;23 个工具 schema、30% 重复动作、17%/32% 失败花费来自论文第 2 节的 60 条轨迹(每仓库 10 个任务);超参数($T=5$、$n=3$、$\rho=0.4$、$\gamma=0.8$、$\lambda=5$、$k=3$、$R=5$、$p=90$、$\beta=1.25$、$\kappa=2.5$)来自项目主页的机制说明;插件默认值与版本窗口来自 README。第六节里「仓库记忆是主要收益来源」、第八节第 5、7 条,以及第一节对固定策略失效原因的解释,是我的推断,已在正文里标注。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- Blender Kiln:AI 建模缺的不是生成能力,是交付前的度量
- CineCode:每一帧都是时间的纯函数,所以电影可以被检查
- OhMyGame:AI 生成游戏不难,难的是让它自己发现游戏跑不起来
- GPT-2 的一次前向:一条 768 维的向量,被改写 12 次,变成 50257 个分数
- SAELens:重建得越准,特征越不一定是真的
- Transformer Explainer:把 GPT-2 塞进浏览器,让模型边算边解释自己
- Boubou:本地语音 AI 缺的不是模型,是一层能借给全屋的运行时
- Hy-MT2:把翻译拆成语言家族分头训练,再蒸馏回一个模型
- NNsight:把干预写进前向传播,让同一段代码在 405B 模型上跑
- Safetensors:用 8 个字节和一段 JSON,重新设计大模型的权重文件