Sub2API:把 Claude、OpenAI、Gemini 统一接入,一个开源 AI API 网关的设计与边界
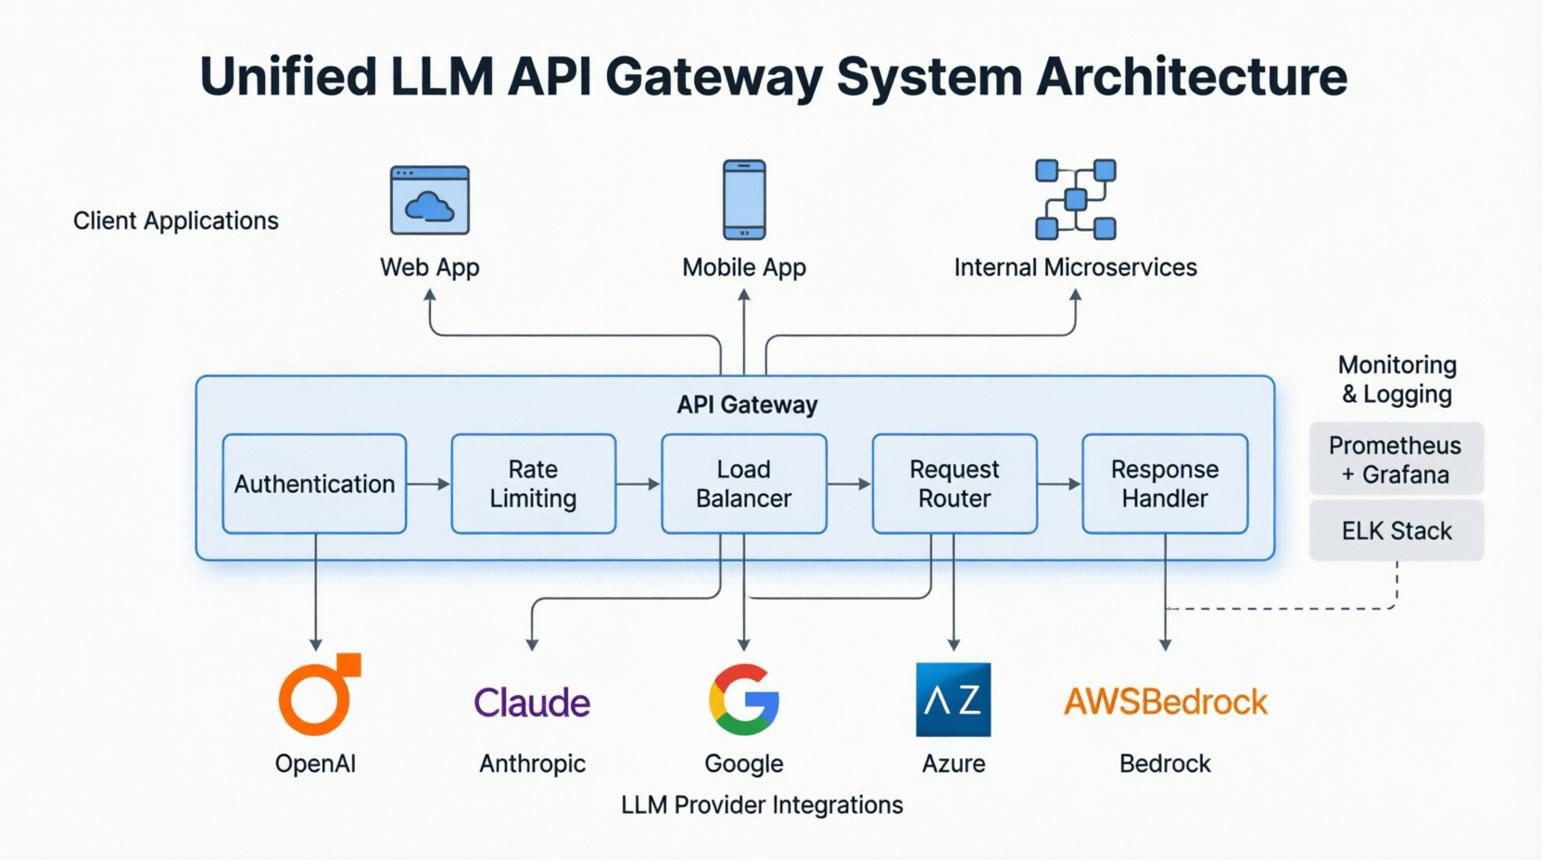
图片来源:ANG YAO AI · Unified LLM API Gateway
当你只调用一家模型时,接入是一件很简单的事:拿到 API Key,写一个 HTTP 请求,结束。
但真实的工程现场往往不是这样。
同一个应用里,可能要同时用到 Claude 的长文本推理、OpenAI 的工具调用、Gemini 的多模态能力;同一个团队里,十个人共用几个上游账号;同一个项目里,财务想知道这个月到底烧了多少钱、花在谁身上、花在哪个模型上。
到了这一步,问题就从“怎么调一个接口”变成了“怎么管住一堆账号和一堆 Key”。
GitHub 上的开源项目 Sub2API 正是围绕这个问题构建的:一个位于 AI 应用与上游模型服务之间的网关,统一管理上游账号、下游 API Key、请求调度和用量结算。
它不是一个模型,也不是一个聊天界面。它是一层基础设施。
一、Sub2API 是什么?
用一句话概括:Sub2API 是一个多上游 AI 账号的统一接入与分发网关。
它向下游提供一套统一的 API 入口,向上游管理多个平台的账号凭证,中间负责鉴权、配额、调度、转发和记账。
传统直连方式下,每个应用都要自己处理所有上游:
AI 应用
   │
   ├──────── Claude API
   │
   ├──────── OpenAI API
   │
   └──────── Gemini API
引入网关后,应用只需要认识一个地址:
                 AI 应用
                    │
                    ▼
              Sub2API Gateway
                    │
          ┌─────────┼─────────┐
          │         │         │
          ▼         ▼         ▼
       Claude     OpenAI    Gemini
          │         │         │
          ▼         ▼         ▼
       上游账号   上游账号   上游账号
这个位置决定了它的价值:把“账号”这件脏活从应用层剥离出去。
应用不再持有任何上游凭证,也不会因为某个账号被封、某个 Token 过期而需要改代码发版;这些事都收敛到网关内部处理。
需要提前说清楚的是:Sub2API 是网关和管理系统,不是模型提供方。模型能力、服务稳定性、计费价格,归根结底仍由上游服务商决定。加一层网关不会让上游变得更快或更便宜,它只是让“管理”变得可能。
二、它到底解决了哪些问题?
1. 多类型上游账号的统一管理
上游账号并不是同一种东西。至少存在两类截然不同的接入形态:
| 类型 | 凭证形态 | 主要难点 |
|---|---|---|
| OAuth 授权账号 | 访问令牌 + 刷新令牌 | 令牌过期、刷新失败、需要重新授权 |
| API Key 账号 | 静态密钥 | 配额、限流、密钥轮换 |
这两类账号的生命周期管理逻辑完全不同:前者要处理授权流程和令牌刷新,后者要处理密钥有效性和配额消耗。
Sub2API 把两者都纳入同一套账号模型,并支持账号状态的启用、禁用、异常标记,以及账号与分组之间的多对多关联。
账号分组的价值在于权限的间接层:用户不直接绑定账号,而是绑定分组;分组里放哪些账号,由管理员决定。换账号、加账号、下线账号,都不需要改动用户侧配置。
2. 面向用户的 API Key 分发
这是整个系统对外的门面。
管理员为每个用户(或每个应用)生成独立的 API Key,并把 Key 绑定到某个分组:
| 用户 | API Key | 分组 | 配额 |
|---|---|---|---|
| 用户 A | sk-user-a... | Claude 组 | 独立配置 |
| 用户 B | sk-user-b... | OpenAI 组 | 独立配置 |
| 用户 C | sk-user-c... | Gemini 组 | 独立配置 |
带来的直接效果有三个:
- 凭证隔离:下游看不到、也拿不到上游凭证。
- 权限收敛:一个 Key 能访问哪些模型,由分组决定。
- 责任可追溯:每一次调用都能落到具体用户身上。
对于团队内部使用场景,第三点往往比前两点更重要——没有归属的用量统计,等于没有统计。
3. 账号调度与并发控制
当一个分组里存在多个可用账号时,网关需要决定:这次请求该发给谁。
                用户请求
                   │
                   ▼
              API Gateway
                   │
                   ▼
              Account Scheduler
                   │
          ┌────────┼────────┐
          │        │        │
          ▼        ▼        ▼
       Account A Account B Account C
          │        │        │
          ▼        ▼        ▼
        Claude   Claude   Claude
调度策略要同时满足几类相互拉扯的约束:
- 负载均衡:避免所有请求压在同一账号上。
- 可用性过滤:跳过已标记异常、配额耗尽或限流的账号。
- 并发上限:账号级并发、用户级并发都要卡住。
- 速率限制:请求速率与 Token 速率是两种不同的维度。
- 会话一致性:同一会话尽量落在同一账号上。
最后一条就是所谓的粘性会话(Sticky Session)。
对多轮对话和 AI 编程工具来说,这一点很关键。如果同一段对话的相邻两轮被随机打到不同上游账号,可能带来上下文缓存失配、会话状态断裂,甚至行为不一致。粘性会话用“牺牲一点负载均衡”换取“会话稳定”。
这是一个典型的工程权衡:完美的均摊并不总是正确目标。
4. Token 级用量统计与成本核算
按请求次数计费是错的。
同一个请求,输入 100 Token 和输入 100K Token 的成本差三个数量级;不同模型的单价不同;缓存命中与未命中的价格也不同。所以计量必须落到 Token 粒度:
| 用户 | 模型 | 输入 Token | 输出 Token |
|---|---|---|---|
| 用户 A | Claude | 120,000 | 30,000 |
| 用户 B | GPT | 80,000 | 20,000 |
| 用户 C | Gemini | 200,000 | 50,000 |
有了这层数据,管理员才能回答那些真正影响决策的问题:
- 哪个用户消耗最多?
- 哪个模型调用频率最高?
- 哪个上游账号承担了主要流量?
- 谁的配额即将耗尽?
- 各模型的成本占比如何?
这也是网关类项目中最容易被低估的部分:记账系统的复杂度,往往不低于转发系统。
5. 内置支付与订阅
项目还集成了支付能力,README 中列出的渠道包括:
- 易支付(EasyPay)
- 支付宝官方支付
- 微信官方支付
- Stripe
也就是说,订阅、充值、配额发放可以在同一套系统里闭环,不需要额外接一个计费服务。
不过这里必须打一个折扣:支付渠道是否可用,取决于商户资质、服务商配置和所在地区的合规要求。代码里有对接能力,不等于你就能合法开通。
6. 多平台、多协议接入
项目覆盖的上游平台大致是这些:
| 平台 | 主要接入方向 |
|---|---|
| Anthropic Claude | Claude 模型及相关工具调用 |
| OpenAI | GPT、Codex 等相关调用 |
| Google Gemini | Gemini 模型及相关工具 |
| xAI Grok | Grok 模型及相关工具 |
| Antigravity | 相关的 Claude、Gemini 接入能力 |
这里有一个必须区分的概念:
统一入口 ≠ 统一协议。
OpenAI 的 Chat Completions 与 Responses API、Anthropic 的 Messages API,在请求结构、流式事件格式、工具调用表达、错误码语义上都不一样。真正的网关要做的是协议适配:把下游的一种请求翻译成上游能懂的形式,再把上游的流式响应翻译回来。
所以 Sub2API 不是一层 reverse_proxy。它需要理解协议。
三、技术架构:Go + Vue 3 + PostgreSQL + Redis
从源码结构看,这是一个标准的前后端分离项目。README 公布的主要技术栈:
| 层级 | 技术 |
|---|---|
| 后端 | Go(Gin) |
| ORM | Ent |
| 前端 | Vue 3 |
| 构建 | Vite |
| 样式 | Tailwind CSS |
| 数据库 | PostgreSQL 15+ |
| 缓存 | Redis 7+ |
| 部署 | Docker Compose / Linux 二进制 |
具体版本号以项目 README 与
go.mod为准,本文不将其作为稳定事实引用。
目录结构大致如下:
sub2api/
│
├── backend/
│   ├── cmd/
│   │   └── server/
│   ├── internal/
│   │   ├── config/
│   │   ├── model/
│   │   ├── service/
│   │   ├── handler/
│   │   └── gateway/
│   └── resources/
│
├── frontend/
│   └── src/
│       ├── api/
│       ├── stores/
│       ├── views/
│       └── components/
│
├── deploy/
│   ├── docker-compose.yml
│   ├── .env.example
│   └── install.sh
│
├── docs/
├── openspec/
└── tools/
这个分层值得注意的地方是 gateway 与 handler 的分离:
-
handler面向管理面(admin API):账号 CRUD、用户管理、Key 管理、统计查询。 -
gateway面向数据面(proxy API):真正承载模型流量的转发逻辑。
管理面和数据面的关注点完全不同。 管理面追求功能完整、交互友好,可以慢;数据面追求延迟低、并发高、错误可控,必须快。把它们混在一个模块里,是很多自建网关最后难以维护的根本原因。
各层职责
Go + Gin:负责 HTTP 路由、中间件、鉴权、限流和请求转发。Go 的 goroutine 模型适合处理大量长连接的流式响应——网关最典型的负载就是“很多条 SSE 连接同时挂着”。
Ent:以代码方式定义 schema 并生成类型安全的查询。相比运行时反射式的 ORM,它在编译期就能发现字段错误,对 schema 频繁演进的项目更友好。
Vue 3 + Vite:管理后台,承担用户、账号、Key、分组、用量、系统设置、运营管理等界面。
PostgreSQL:持久化用户、账号、Key、分组、订阅、用量明细等业务数据。用量记录是典型的时序型写入负载,表设计和索引策略会直接决定后台统计页的响应速度。
Redis:缓存与运行时协调。它的关键作用不是“加速查询”,而是跨实例共享状态:限流计数器、并发槽位、会话粘性映射。当网关部署多个实例时,如果这些状态只存在进程内存里,那么“全局并发上限”就是个假命题。
四、一次请求的完整生命周期
理解一个网关,最好的方式是把一条请求从头跟到尾。
以 Claude Code 调用 Claude 模型为例:
Claude Code
     │
     ▼
Sub2API API Endpoint
     │
     ▼
API Key Authentication
     │
     ▼
User / Subscription Check
     │
     ▼
Group & Model Resolution
     │
     ▼
Rate Limit / Concurrency
     │
     ▼
Account Scheduler
     │
     ▼
Upstream Account
     │
     ▼
Claude Service
     │
     ▼
Response Transformation
     │
     ▼
Usage Recording
     │
     ▼
Claude Code
拆成六个阶段:
第一阶段:鉴权。 校验 API Key 是否存在、是否被禁用、是否过期。这一步必须是常数时间或接近常数时间——它位于每个请求的热路径上。通常的做法是哈希后查缓存,而不是每次查库。
第二阶段:配额与权限检查。 用户是否有权访问该分组?订阅是否有效?是否触发请求数、Token 数或并发上限?这里的判断顺序会影响用户体验:先检查“无权限”还是先检查“超额”,返回的错误信息不同。
第三阶段:模型与账号解析。 从请求体中识别目标模型,映射到分组内可用的账号集合,再由调度器选出具体账号。这一步要处理模型别名、能力映射(比如某账号不支持某模型),以及粘性会话的命中判断。
第四阶段:请求转发。 按上游协议重新构造请求:改 header、替换认证信息、转换 body 结构、保持流式语义。这是协议适配的核心,也是最容易出 bug 的地方。
第五阶段:响应处理。 上游返回 SSE 流时,需要边转发边解析,从中提取 usage 信息;遇到错误响应,要判断是可重试(换账号)还是应直接透传。
第六阶段:用量结算。 把输入/输出/缓存 Token 数、模型、账号、用户、耗时落库,更新配额余量,计算费用。
这条链路里有一个不太显眼但很关键的设计约束:流式响应意味着“响应还没结束,账单就已经在生成”。 如果连接中途断开,usage 可能缺失或截断,结算逻辑必须有兜底策略。
五、几个值得单独拿出来讲的工程问题
1. 并发控制为什么必须放在 Redis
假设账号 A 的最大并发设为 5:
Account A
最大并发:5

当前请求:
Request 1
Request 2
Request 3
Request 4
Request 5

新请求:
Request 6 → 等待或拒绝
如果网关只有一个实例,用信号量就够了。但生产环境通常是多实例 + 负载均衡,此时每个实例各持一个信号量,实际并发就变成了 5 × 实例数。
所以并发槽位必须共享。而流式请求的持有时间可能长达几分钟,这就要求槽位有租约和超时释放机制——否则一次进程崩溃就会永久泄漏并发额度。
2. 粘性会话的实现代价
粘性会话的本质是维护一张“会话标识 → 账号”的映射,并给它设置过期时间。
听起来简单,但边界情况不少:
- 目标账号突然不可用了,会话要不要迁移?
- 迁移后上下文缓存失效,成本如何补偿?
- 映射表过期时间设多长?太短没效果,太长则负载严重倾斜。
这类问题的答案没有标准解,取决于业务更怕“会话断裂”还是更怕“账号过载”。
3. 账号异常的分类处理
上游账号会以多种方式失败:
| 异常 | 合理处置 |
|---|---|
| 访问令牌过期 | 触发刷新,成功则重试 |
| OAuth 刷新失败 | 标记账号需重新授权 |
| 配额耗尽 | 临时移出调度池,按周期恢复 |
| HTTP 429 限流 | 退避 + 短期降权 |
| 上游 5xx | 有限次重试,可切换账号 |
| 网络超时 | 区分“请求未送达”与“响应丢失” |
关键在于区分可重试与不可重试。对非幂等的生成请求盲目重试,可能造成重复计费;而对明确可重试的错误不做切换,则会白白浪费用户配额。
4. 计费准确性比功能数量更难
计费的准确性依赖三件事同时成立:
- 上游确实返回了 usage(有些流式场景需要主动请求或从末尾事件中提取)。
- 价格目录与实际计费规则一致(含缓存 Token 的差异化定价)。
- 结算在故障场景下不丢不重。
任何一环出问题,账单就会失准。而账单失准是这类系统最致命的缺陷——功能少一点用户能忍,账算错了没人能忍。
5. 协议转换的隐藏工作量
把 OpenAI 格式转成 Anthropic 格式,表面上是字段映射,实际上要处理:
- 系统提示词的位置差异(
system角色 vs 顶层system字段)。 - 工具调用(tool call)的结构与流式增量表达。
- 停止原因(
finish_reason/stop_reason)的语义对齐。 - 错误码体系不一致导致的客户端重试行为差异。
每一条都不难,但组合起来就是一个需要持续维护的兼容层。上游协议一改,网关就得跟。
六、怎么部署
项目提供两条部署路径,官方推荐 Docker Compose。
方式一:Docker Compose
mkdir -p sub2api-deploy
cd sub2api-deploy

curl -sSL \
  https://raw.githubusercontent.com/Wei-Shaw/sub2api/main/deploy/docker-deploy.sh \
  | bash

docker compose up -d
docker compose logs -f sub2api
部署脚本会准备 Compose 配置、环境变量、数据目录以及必要的安全密钥。
方式二:Linux 二进制 + systemd
curl -sSL \
  https://raw.githubusercontent.com/Wei-Shaw/sub2api/main/deploy/install.sh \
  | sudo bash
安装后用 systemd 托管:
sudo systemctl start sub2api
sudo systemctl enable sub2api
sudo systemctl status sub2api
首次启动需要通过 Setup Wizard 配置数据库、Redis 和管理员账号。
部署时的几点现实提醒
- 别把管理后台直接暴露在公网。 这类系统一旦后台被拿下,等于所有上游账号一起失守。
- 数据库和 Redis 不要用默认密码。 部署脚本生成的随机密钥要保存好。
- 反向代理要放宽超时。 流式响应可能持续数分钟,Nginx 默认 60s 会直接截断。
- 先做容量评估再上线。 网关本身也要吃 CPU 和连接数,尤其在做流式解析时。
七、它适合谁?
| 场景 | 适用价值 |
|---|---|
| 个人多模型统一接入 | 一个入口管理不同模型的调用 |
| 团队 AI 资源管理 | 分配 Key、控制配额、统计成本 |
| 多模型应用开发 | 减少应用侧对接多家上游的工作量 |
| 内部 AI API 平台 | 统一鉴权、审计与计量 |
| API 网关学习 | 研究 Go 网关、协议适配、账号调度 |
| 订阅与计费系统研究 | 观察用户、套餐、额度、账单的建模方式 |
对于想研究网关设计的开发者,我认为最值得读的是三块:
- 账号调度器:如何在一个不断变化的可用集合上做选择。
- 协议适配层:如何把一种语义映射到另一种语义。
- 计量与结算:如何在流式、失败、重试的场景下仍算得准。
这三块也是任何 AI 网关的核心工程能力,换成别的语言或框架,问题结构是一样的。
八、局限与风险:必须说清楚的部分
1. 它不提供模型
Sub2API 是网关和账号管理系统。模型由上游服务商提供,能力上限、价格、稳定性都不由它决定。
2. 可用性不会因为加了网关而变好
恰恰相反,链路变长了,故障点变多了。网关能做的只是把上游的不稳定包装得更可控(重试、切换、降级),而不是消除它。
3. 最关键的:服务条款风险
项目官方明确提示:使用该项目可能违反 Anthropic 等上游服务商的服务条款,并声明项目仅供技术学习与研究使用,未授权任何个人或组织基于项目开展商业运营。
这不是免责声明式的客套话,而是这类项目的根本性约束。
把订阅账号的额度转卖给第三方、把个人账号包装成 API 对外销售,在多数上游服务商的条款下都是明确禁止的。一旦被判定违规,后果是账号封禁、额度清零,甚至影响关联账户。
所以部署之前需要逐项核对:
- 上游服务商的授权范围与账号使用政策。
- 数据处理与隐私要求(请求内容会经过你的服务器)。
- 当地法律法规对转售、代充、支付结算的要求。
- 是否具备相应的经营资质。
技术上做得到,和合规上做得了,是两件完全不同的事。
4. 许可证
项目使用 LGPL-3.0-or-later。二次开发、修改后分发、以及以库的形式静态链接,都有对应的义务要求。商用前应让法务确认,而不是只看“开源”两个字。
九、总结
Sub2API 的价值不在于“能转发请求”——那是 Nginx 就能做的事。
它的价值在于把分散的东西收拢成一套体系:
- 上游账号从“一堆散落的凭证”变成“可调度、可监控、可下线”的资源池。
- 下游访问从“共享一个 Key”变成“一人一 Key、按组授权、按量计费”。
- 成本从“月底看账单吓一跳”变成“实时可查、按用户按模型拆解”。
从技术视角看,它覆盖了 Go 后端服务、AI API 网关架构、多协议兼容、OAuth 凭证管理、负载均衡与粘性会话、Redis 分布式并发控制、Token 级计费、PostgreSQL 数据建模和 Vue 3 管理后台——一个相当完整的工程样本。
如果你只是想统一调用几个模型,它确实偏重;但如果你想理解“围绕模型调用建立一套账号、权限、调度、计量和运营体系”到底要处理哪些问题,它是一个很好的阅读对象。
最后仍要回到那句话:这类项目的技术价值与合规风险是同时存在的。 研究它的架构是一回事,把它当成生意是另一回事。前者值得投入时间,后者需要先过法务这一关。
项目与参考资料
本文依据项目 README、仓库目录结构与公开资料整理,功能列表与技术栈以仓库当前状态为准;文中架构示意图用于解释通用网关原理,不代表项目的完整实现细节。部署与商用前请自行核对上游服务条款与许可证要求。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- FreeToken:让消费级电脑跑起 284B MoE,一次把整机当成推理集群的系统设计
- TransformerLens:打开大模型的黑盒,用 Hook 和因果干预研究 Transformer 内部
- Train LLM From Scratch:从零开始训练自己的大语言模型
- DeepSeek-V4.1-Flash-1017-Uncensored:不重新训练模型,直接修改权重,让 AI 改变回答行为
- Idol:一张图片生成百万级 3D 高斯模型,AI 正在重新定义三维建模
- Windows 上「保存失败」:文件被占用时原子替换为什么会报错
- 一次 CSS 压缩把整站布局打散
- 把个人站从「魔改模板」改成「薄启动器」
- 从这里开始