Safetensors:用 8 个字节和一段 JSON,重新设计大模型的权重文件
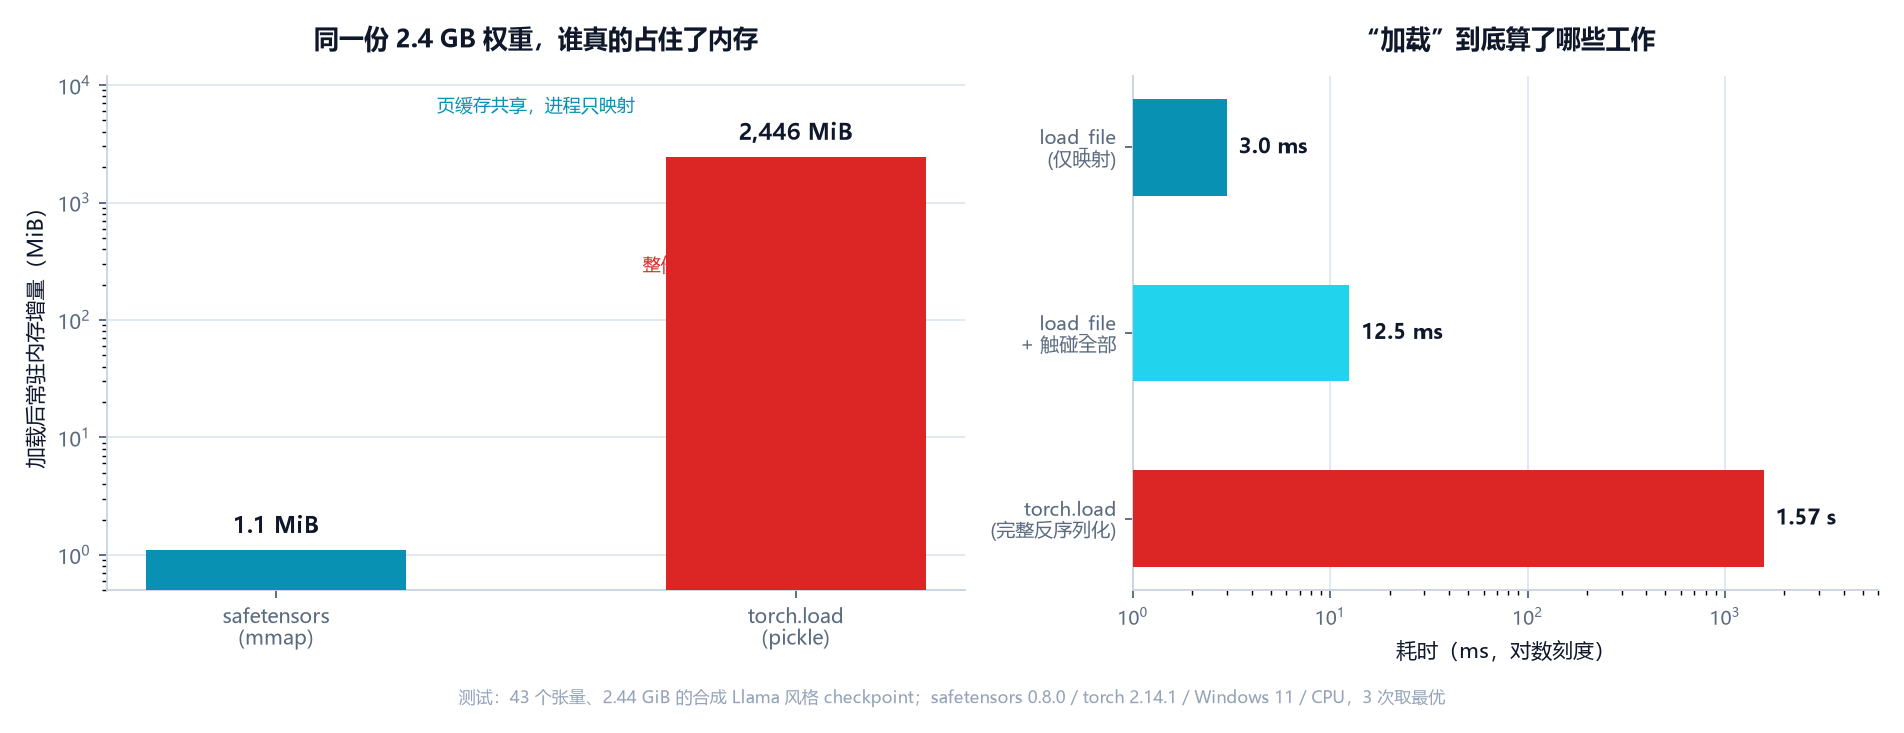
同一个 2.44 GiB 的模型权重文件,用 torch.load 读进来要 1.57 秒、进程常驻内存涨 2446 MiB;换成 Safetensors 的 load_file,3 毫秒、涨 1.1 MiB。
这不是”优化得好一点”的差距,而是两种格式对”权重文件是什么”给出了不同答案:一边是可以执行的 Python 对象图,另一边是一张记录字节位置的目录。
大模型基础设施里,Safetensors 解决的就是这个看起来很底层、实际决定了很多上层设计的问题——如何安全、高效地存储、读取和分发几百 GB 甚至 TB 级的权重。它由 Hugging Face 开发并开源(Apache-2.0),今天的 Transformers、Diffusers、vLLM、llama.cpp、MLX、Candle、ComfyUI 几乎都在用它。
这篇文章想讲清楚四件事:格式到底长什么样;安全性从哪来、边界在哪;”零拷贝”到底零掉了什么;以及——它为什么能成为权重编程的基础设施。
一、权重文件里究竟装了什么
先回到最朴素的问题:一个 .safetensors 文件(或 .bin、.pt)里,到底有什么?
对一个 Transformer 来说,模型参数就是一堆有名字的多维数组:
-
model.embed_tokens.weight:词表嵌入,形状[vocab, hidden]。 -
model.layers.N.self_attn.q_proj.weight:第 N 层的 Q 投影矩阵。 -
model.layers.N.mlp.gate_proj.weight:SwiGLU 的 gate 投影。 -
model.norm.weight:最后一层 LayerNorm 的缩放参数。
这些张量本质上只需要五项信息就能被无损重建:名字、数据类型、形状、字节数、字节在哪里。除此之外的一切——模型怎么前向、有哪些自定义算子、训练到了第几步——都不属于”权重”。
PyTorch 的 state_dict 正是这样一张 name → tensor 的表。问题出在它默认的落盘方式:torch.save 用 Python 的 pickle 序列化整张表。而 pickle 的设计目标是”重建任意 Python 对象”,所以文件里不仅有张量数据,还有告诉解释器如何重建这些对象的指令。
这份”额外的能力”就是后面所有安全问题的源头。
二、一个只有三段的文件
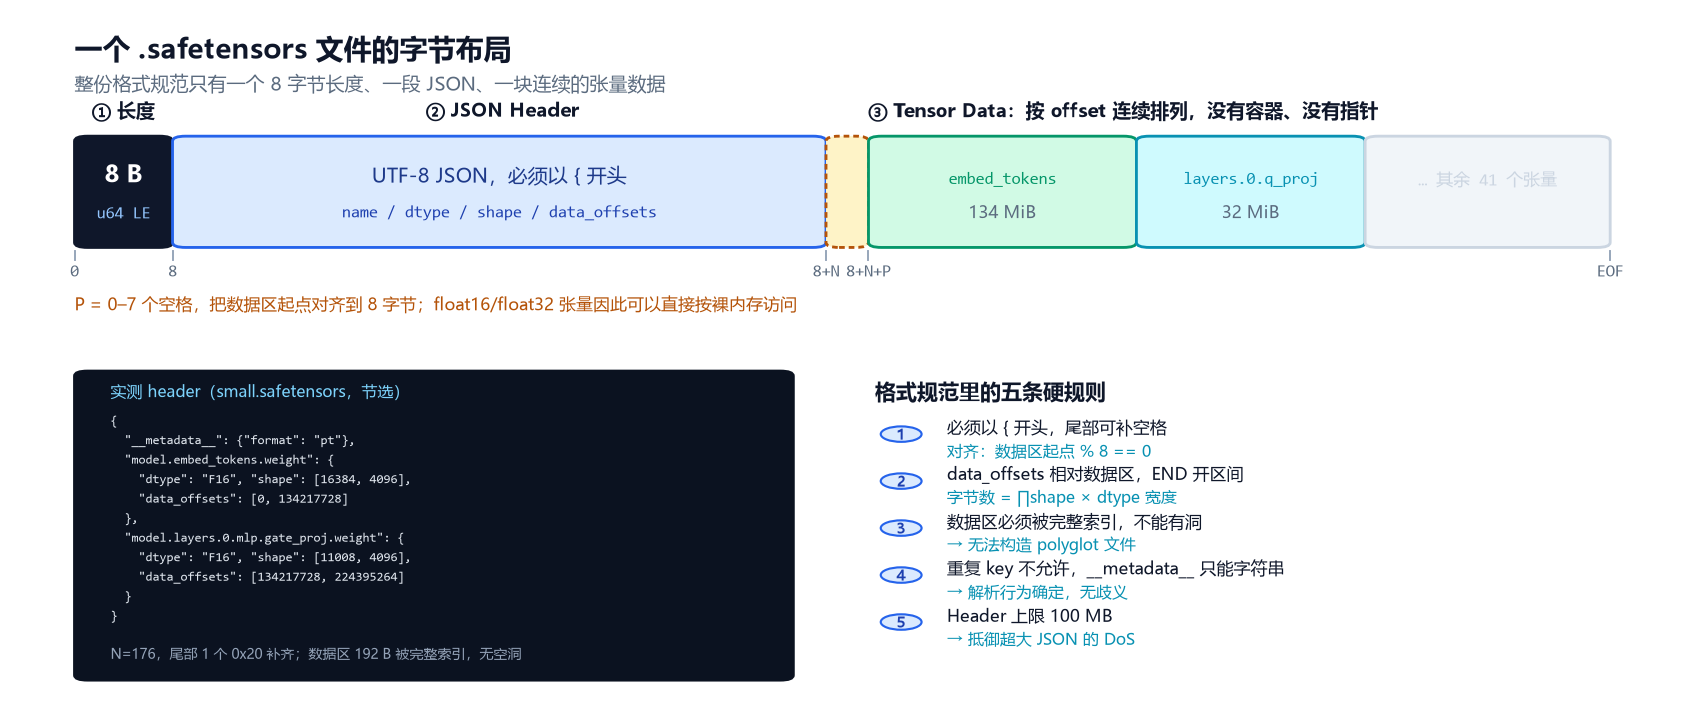
Safetensors 的格式规范短到可以贴在一屏里。整个文件由三段组成:
┌──────────────────────────────┐
│  Header Length   8 字节       │  u64,little-endian
├──────────────────────────────┤
│  JSON Header     N 字节       │  UTF-8,必须以 { 开头
│    name / dtype / shape      │  可用空格补齐到 8 字节对齐
│    / data_offsets            │
├──────────────────────────────┤
│  Tensor Data     裸二进制     │  按 offset 连续排列
└──────────────────────────────┘
1. 前 8 个字节:一个整数
文件开头是一个无符号 64 位小端整数 N,表示 JSON header 的字节长度。
为什么需要它?因为读取方必须先知道 header 有多长,才能准确跳到数据区。这一步是 O(1) 的——不需要扫描文件、不需要解析前面的内容。
2. JSON Header:一张字节地图
紧接着是 N 字节的 UTF-8 JSON。下面是我用 save_file 写出的一个真实文件(只有两个小张量)的 header 原文:
{
  "model.embed_tokens.weight": {
    "dtype": "F32",
    "shape": [8, 4],
    "data_offsets": [0, 128]
  },
  "model.layers.0.mlp.gate_proj.weight": {
    "dtype": "F32",
    "shape": [4, 4],
    "data_offsets": [128, 192]
  }
}
三个字段各有明确职责:
| 字段 | 含义 | 你需要知道的细节 |
|---|---|---|
dtype | 元素类型 | F64/F32/F16/BF16/I64/I32/I16/I8/U8/BOOL,以及 F8_E4M3 等 FP8 |
shape | 维度 | 行主序(C order);[] 表示标量,允许某一维为 0 的空张量 |
data_offsets | [BEGIN, END) 字节区间 | 相对数据区起点,不是文件绝对位置;字节数 = END - BEGIN |
data_offsets 是整个格式的核心。有了它,读取方能在不读任何张量数据的前提下,算出任意一个张量的精确位置和长度。
还有一个特殊键 __metadata__,放的是字符串到字符串的映射(Hugging Face 会写 {"format": "pt"})。注意限制:只允许字符串,不能嵌套任意 JSON。这一条不是洁癖,是为了让解析器的行为完全可预测。
3. Tensor Data:没有容器的裸数据
header 之后就是连续的二进制数据。没有 per-tensor 的头部、没有对齐填充块、没有指向上层的指针——第 k 个张量的数据就老老实实躺在 [offset_k, offset_k + size_k)。
我在实验里验证过一件容易被忽略的事:规范要求整个数据区被完整索引,不能有空洞。也就是说,所有张量的 data_offsets 必须不重叠、不遗漏地覆盖整块数据区。
这条规则挡住了一类攻击:polyglot 文件——同时是合法 .safetensors、又是合法 ELF 或 ZIP 的文件。如果允许空洞,攻击者就能在”合法权重文件”的缝隙里塞进可执行内容;不允许空洞,塞进去的字节就必须被某个张量声明,而声明了就会被当成权重读出来。
另外两个实现细节值得知道:
- 对齐:header 允许在 JSON 后补若干空格(
0x20),实现通常补到让数据区起点是 8 的倍数。这样float32/float16张量直接映射到内存就是天然对齐的。 - 上限:header 最大 100 MB。否则一个声明了 10 GB JSON 的文件就能让解析器先把自己 OOM 掉。
三、安全:把”可执行”从格式里拿掉
pickle 为什么危险
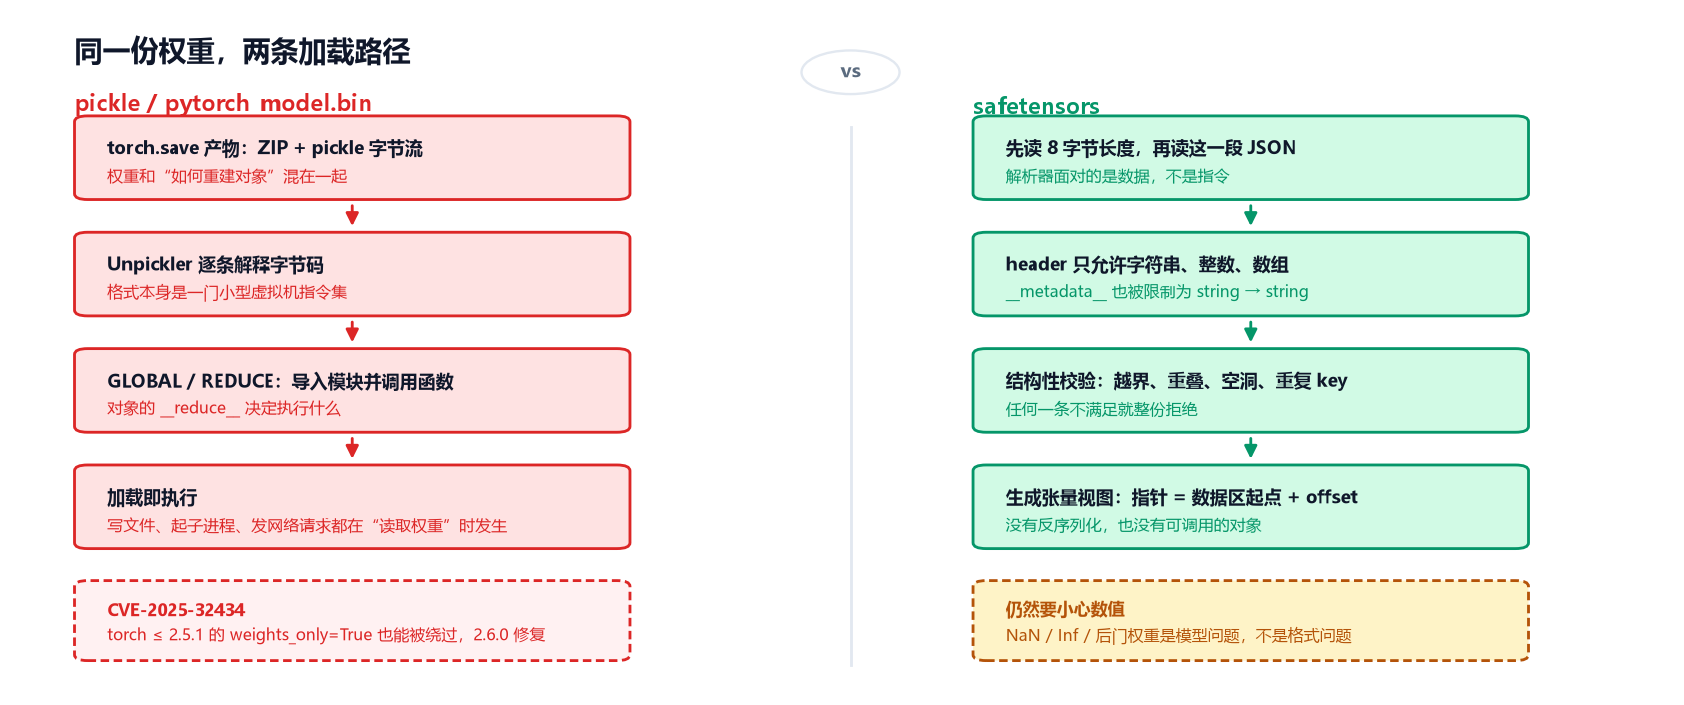
pickle 不是”数据格式”,而是一门小型虚拟机。它的字节流里有一条 GLOBAL 指令,作用是”导入某个模块的某个属性”;配合 REDUCE,就是”拿这些参数调用这个函数”。
所以一个对象可以在反序列化时指定”我要被重建时执行什么”:
import pickle

class Harmless:
    def __reduce__(self):
        return (print, ("[side effect] code from the checkpoint ran",))

payload = pickle.dumps({"w": 1, "x": Harmless()})
pickle.loads(payload)   # 打印:[side effect] code from the checkpoint ran
我实际跑了这段代码:485 字节的 pickle,在 loads 的那一刻执行了里面的函数。这不是漏洞,是 pickle 的设计功能——它需要靠执行代码来重建对象。
把这个能力放进”从互联网下载模型权重”的场景,结论就很清楚了:加载 .bin 等价于运行别人给你的代码。
更麻烦的是,这条防线一直在被推后移:
- PyTorch 长期推荐
torch.load(..., weights_only=True)作为缓解。 - 2025 年的 CVE-2025-32434 证明这个白名单可以被绕过,torch ≤ 2.5.1 受影响,2.6.0 修复(CVSS 4.0 评分 HIGH)。
- torch 2.6 起,
torch.load的weights_only默认值改为True。
只要格式本身允许”重建对象”,安全就永远是补丁式的。
Safetensors 的做法:只描述数据在哪
Safetensors 把整条链路换成:
读 8 字节长度 → 解析 JSON → 校验偏移 → 生成张量视图
没有任何一步需要执行文件里的内容。Rust 实现会在生成视图之前做结构性校验:
- header 长度合法(≤ 100 MB),且必须以
{开头; - 每个张量的
dtype × shape与data_offsets声明的字节数一致; - 偏移不越界;
- 张量之间不重叠;
- 数据区被完整覆盖(无空洞、无截断)。
我构造了三个畸形文件来验证(结果来自实测):
| 构造的破坏 | 结果 |
|---|---|
把某个张量的 END 改大 | invalid shape, data type, or offset for tensor |
| 让两个张量区域重叠 | invalid offset for tensor `model.layers.3.self_attn.o_proj.weight` |
| 截断数据区 4 个字节 | incomplete metadata, file not fully covered |
三条都是整份拒绝,而不是”尽力加载”。这一点比很多人以为的更重要:一个能”部分加载”的格式,会让损坏的文件悄悄变成看起来正常的模型。
但安全边界到此为止
需要把话说清楚,避免过度承诺:
- Safetensors 不检查数值。
NaN、Inf、异常大的权重都能合法存进去。README 里写得很明白:tensor values are not checked。 - 格式没有校验和。 它不负责证明”这份权重就是你想要的那一份”。完整性要靠外部机制:Hugging Face 的 SHA256/Xet、Git LFS 的 OID、你自己签名的 manifest。
- 模型供应链是另一层问题。 后门权重、投毒微调、许可证问题,格式一概管不了。
一句话:Safetensors 消除的是”序列化执行风险”,不是”模型可信问题”。
四、”零拷贝”到底零掉了什么
这是最容易被说糊的一段。先把两条路径摊开。
传统 torch.load 的链路是:
磁盘 → 读入用户态缓冲区 → 反序列化(构造 Python 对象)→ 分配张量内存 → 拷贝数据 → 模型
Safetensors 的链路是:
磁盘 → mmap 建立映射 → 按 offset 在映射区域取视图 → 模型
关键在于第二步:张量不是”被读进来的”,而是”被指向的”。数据仍然在页缓存里,进程只是拿到了一段虚拟地址。
实测
我用一份合成的 Llama 风格 checkpoint 做对比:43 个张量、2.44 GiB,同一台机器、同一份数据,分别存成 .safetensors 和 .bin。
| 指标 | safetensors load_file | torch.load(weights_only=True) |
|---|---|---|
| 保存耗时 | 3.02 s | 3.76 s |
| 加载返回耗时 | 3.0 ms | 1.57 s |
| 加载后常驻内存增量 | 1.1 MiB | 2446 MiB |
| 逐个访问全部张量首尾 | 12.5 ms | 3.6 ms |
前两行说明零拷贝的价值:torch.load 必须把 2.44 GiB 完整复制进用户态堆,进程 RSS 直接涨 2.4 GB;load_file 只建立映射,RSS 几乎不动。
第三行是很多人会漏掉的细节:映射不等于数据已经在内存里。第一次访问某个页会触发缺页中断,把数据从页缓存映射进来。所以”访问全部张量”这步,safetensors 反而要花 12.5 ms——它把成本推到了真正用到数据的时候。这仍然是净赚:那 2.4 GB 里,多卡推理时你可能永远用不到别的卡负责的那部分。
三个必须澄清的边界
- header 不是零拷贝。 JSON 总要被解析成结构体。但 header 通常只有几 KB 到几 MB,相对于几百 GB 的数据可以忽略。
- GPU 上一定有拷贝。 显存没有”磁盘页缓存”这种东西,权重必须从主机内存传到显存。Safetensors 省掉的是”CPU 上多分配一份完整副本”,不是
cudaMemcpy本身。官方 benchmark 里 CPU 快 76.6 倍、GPU(T4)只快 2.1 倍,原因就在这里。 -
load_file返回的映射张量不是”可以随便改的副本”。 写入是私有映射,不会回写文件;想改文件得自己用读写模式映射——这正是第六节要做的事。
官方 README 还记录了一个著名的工程收益:BLOOM 在 8 卡上加载,从原来 PyTorch 权重的约 10 分钟降到 45 秒。这个数字来自特定环境,但它说明的是同一件事:省掉的不是 IO,而是”为了拿到一个张量而必须先构造整个对象图”。
五、懒加载:只碰你需要的那几百 MB
有了 offset 表,”只读一部分”就不需要任何特殊支持,它是格式的自然结果。
from safetensors import safe_open

with safe_open("model.safetensors", framework="pt", device="cpu") as f:
    # 只要形状,不读数据
    slice_ = f.get_slice("model.embed_tokens.weight")
    vocab, hidden = slice_.get_shape()

    # 只要前 128 列
    part = slice_[:, :128]

    # 只要一个张量
    q = f.get_tensor("model.layers.3.self_attn.q_proj.weight")
get_slice 返回的是一个可切片的视图对象,[:, :128] 只读那部分字节。实测中,读一个 45 MiB 的完整张量和读它 8 行(0.17 MiB)都在 1 ms 以内——因为两者都没有真正把数据全部搬进内存。
分片:仓库约定,不是格式规定
真正的百亿、千亿参数模型不会只有一个文件。Hugging Face 仓库里常见的是:
model-00001-of-00004.safetensors
model-00002-of-00004.safetensors
model-00003-of-00004.safetensors
model-00004-of-00004.safetensors
model.safetensors.index.json
index.json 是一张 weight_map,把张量名映射到分片文件名:
{
  "metadata": { "total_size": 16060522496 },
  "weight_map": {
    "model.embed_tokens.weight": "model-00001-of-00004.safetensors",
    "model.layers.0.self_attn.q_proj.weight": "model-00001-of-00004.safetensors",
    "model.layers.20.self_attn.q_proj.weight": "model-00003-of-00004.safetensors"
  }
}
这里要区分两件事:Safetensors 格式本身完全不知道”分片”和”index”的存在——它只是一堆独立的单文件;分片和 weight_map 是模型仓库的组织约定,由 Transformers 一类的加载器实现。
这个组合带来的实际能力是:第 0 号 GPU 只需要读 model-00001 里的 embedding 和前几层,第 2 号 GPU 只需要读 model-00003。每张卡都不需要先加载完整模型再挑自己那份。
README 里还有一个更微妙的优势,叫 layout control:光是”能懒加载”不够,还得让每个张量的数据在文件里挨在一起。如果张量的元信息分散在文件各处,即使能惰性读取,你也得随机访问大半个文件才能凑齐一个张量,磁盘到内存的拷贝次数反而变多。Safetensors 把同名张量的 header 和数据都集中放置,正是为了这一点。
六、把它当文件用:不加载模型,改掉一个 Attention Head
前面都是”读”。但格式设计同样决定了写能做到什么程度——这一点和模型权重拆分、权重编辑、Deletion Tuning 这些方向直接相关。
假设我想把第 3 层 q_proj 的某 128 行权重置零(可以理解为消掉一簇 attention head 的贡献)。传统做法是:load 整个模型 → 改内存里的张量 → save 重新写一遍。2.44 GiB 的文件,实测这条路要 28.37 秒,还要求峰值内存能装下 2.4 GB。
用 Safetensors,根本不需要加载模型:
import json, struct
import numpy as np

path = "big.safetensors"

# 1. 只读 8 字节长度 + header
with open(path, "rb") as f:
    n = struct.unpack("<Q", f.read(8))[0]
    header = json.loads(f.read(n))

# 2. 从 header 里算出目标张量的绝对偏移
key = "model.layers.3.self_attn.q_proj.weight"
begin, end = header[key]["data_offsets"]
rows, cols = header[key]["shape"]

# 3. 以读写模式映射这一块,就地修改
mm = np.memmap(
    path, dtype=np.float16, mode="r+",
    offset=8 + n + begin, shape=(rows, cols),
)
mm[1024:1152, :] = 0.0
mm.flush()
实测:5.87 ms,改的是 128 × 4096 个 float16(1 MiB)。相对 28.37 秒的完整重写,快了约 4800 倍。
改完要验证的不是”跑起来不报错”,而是只有目标区域变了:
| 检查项 | 结果 |
|---|---|
| 目标块全零 | ✅ |
| 第 1023 行、第 1152 行未受影响 | ✅ |
| 其余 42 个张量与原文逐字节相同 | ✅ |
| 文件大小不变 | ✅ |
这件事之所以成立,是四个设计决定的叠加:
- offset 表让你能在 O(1) 内定位任意张量,不需要解析其余数据;
- 8 字节对齐让
float16张量可以直接用裸内存视图访问,不需要中转缓冲; - 行主序 + 连续布局让”取某些行”是一段连续的字节,而不是散落各处的碎片;
- 张量之间没有共享结构,改一个张量不会牵动其他张量的偏移。
为什么这件事对”权重编程”重要
这直接解释了为什么 Deletion Tuning 那类方法能做得那么轻。那篇工作学到的适配器是每个权重 1 个比特的掩码:Llama-3-8B 的掩码 8.4 MB,而全量微调的适配器是 30,633 MB。掩码要生效,就是把 W ⊙ 1[G > 0] 落到权重上——如果每应用一次掩码都要读写一遍整个 checkpoint,这种”1 bit/weight”的优雅就会被工程成本吃掉。
有了可随机访问的格式,”应用掩码”可以退化成:读 header、定位需要改的张量块、就地写回。甚至可以只改被删除的那 0.05% 参数——它们本来就很稀疏。
同样受益的还有:
- 权重拆分:按层/按张量把一个大文件拆成几份,只需要按 offset 复制区间,不需要反序列化再序列化。
- 模型调试:想对比两个 checkpoint 的某一层差异,读那一个张量就够,不必把 140 GB 读进内存。
- 增量分发:只传变化的张量块。
代价:没有事务,也没有校验和
这种”直接改文件”的能力是双刃剑:
- 写坏了就是写坏了。格式里没有校验和,也没有事务日志,进程中途崩溃会留下一个结构合法但内容损坏的文件。
- 实践上必须:先留副本或计算哈希、改完用
load_file重新打开验证结构、对关键张量做逐字节比对。 - 非 1/2/4/8 字节的 dtype(比如 FP8、4-bit 打包)会让”按元素寻址”变得麻烦,任意切片可能落到非对齐地址,官方实现会直接报错而不是悄悄读错。
七、和其他格式比,它站在哪
不同格式的设计目标不同,硬要比”谁更好”没有意义。Safetensors README 里的对照表维度选得很准,我按它的口径整理(✓ 表示支持,~ 表示部分支持):
| 格式 | 安全(不执行代码) | 零拷贝 | 懒加载 | 无文件大小上限 | 布局可控 | 灵活性 | BF16/FP8 |
|---|---|---|---|---|---|---|---|
| pickle (PyTorch) | ✗ | ✗ | ✗ | ✓ | ✗ | ✓ | ✓ |
| HDF5 | ✓ | ✗ | ✓ | ✓ | ~ | ~ | ✗ |
| SavedModel (TF) | ✓ | ✗ | ✗ | ✓ | ✓ | ✗ | ✓ |
| MsgPack (Flax) | ✓ | ✓ | ✗ | ✓ | ✗ | ✗ | ✓ |
| Protobuf (ONNX) | ✓ | ✗ | ✗ | ✗(2 GB 上限) | ✗ | ✗ | ✓ |
| NumPy NPZ | ✓ | ✗ | ✗ | ✗ | ✓ | ✗ | ✗ |
| Safetensors | ✓ | ✓ | ✓ | ✓ | ✓ | ✗ | ✓ |
“灵活性 ✗”是它的自我限定:不能存自定义代码、不能存任意对象。这不是缺陷,是它用功能换来的安全属性。
两个常见的比较对象值得单独说:
- ONNX 存的是计算图 + 算子 + 权重,解决”跨框架交换模型”;Safetensors 只存权重,解决”安全高效地搬参数”。二者不是替代关系——ONNX 自己的外部权重也可以存成 Safetensors。
- GGUF(llama.cpp 的格式)把量化块结构做进了格式:k-quant 的分块缩放因子、张量级的量化元数据,都是为 CPU/端侧推理服务的。Safetensors 不做量化,它存原始精度的权重,量化发生在加载时或另存为 GGUF 时。两者常常在同一条流水线上:HF 上发行 Safetensors,转换脚本读它、量化、写出 GGUF。
八、局限:它明确不做什么
把边界列清楚,比罗列优点更有用。
- 不保存计算图。 层与层的调用关系、Attention 的实现、自定义算子,统统不在文件里。你需要
config.json和模型代码才能把它变成可运行的模型。 - 不保存任意 Python 对象。 优化器状态、训练器配置、自定义类,不能直接塞进来(只能以字符串元数据的形式记录少量信息)。
- 不做压缩,也不做量化。 同样的 FP16 权重存成 Safetensors 不会变小。体积取决于张量数量、形状、dtype 和数值本身;要减体积得靠量化、剪枝、低秩分解。
- 没有校验和、没有加密、没有签名。 完整性、来源可信、访问控制,都要在格式之外解决。
- 不保证跨文件系统的 mmap 行为。 在网络文件系统上,内存映射的语义和性能可能与本地磁盘差异很大;某些场景下老老实实顺序读反而更快。
- 张量数量极多时 header 会变大。 十万个小张量的 header 可能到几十 MB,解析成本不再可以忽略——这时应该合并小张量或调整布局。
- 不支持 strided 张量。 写入前必须
contiguous(),这是一个常见但很容易撞上的坑。
九、在生态里的位置
Safetensors 已经不是”一个可选格式”,而是默认选项:
- 训练/微调:Transformers 的
save_pretrained默认safe_serialization=True;PEFT 的 adapter 也是 Safetensors。 - 推理:vLLM、TensorRT-LLM、SGLang 直接读 Safetensors 分片;llama.cpp 通过转换脚本读入再量化成 GGUF。
- 扩散模型:Diffusers、ComfyUI、Stable Diffusion WebUI 全面使用。
- 端侧/其他语言:MLX(Apple)、Candle(Rust)、
safetensors的 Rust/Node/Python 绑定。
一个典型的 HF 模型目录长这样:
model/
├── config.json                 # 架构与超参(决定怎么解释权重)
├── generation_config.json       # 默认生成参数
├── model.safetensors            # 权重
├── tokenizer.json               # 分词器与词表
└── tokenizer_config.json        # 分词器配置
职责分离得很清楚:config.json 决定”这些张量怎么用”,Safetensors 只负责”这些张量在哪”。
从旧格式迁移
import torch
from safetensors.torch import save_file, load_file

# 1. 只在确认来源可信时,用 weights_only=True 读旧文件
state_dict = torch.load("pytorch_model.bin", map_location="cpu", weights_only=True)

# 2. 直接写 Safetensors(要求张量连续、不共享存储)
state_dict = {k: v.contiguous() for k, v in state_dict.items()}
save_file(state_dict, "model.safetensors")

# 3. 以后这样读
state_dict = load_file("model.safetensors")
model.load_state_dict(state_dict)
两个容易踩的点:
- 共享存储的张量(比如 tied embeddings)会让
save_file报错。要么clone()展开,要么用save_model处理共享。 - 转换不能”洗白”来源。 把恶意 pickle 转成 Safetensors 时,恶意代码已经在你机器上执行过了。转换的价值在于此后的分发是安全的。
十、总结:把”数据”和”指令”分开
Safetensors 最值得学的地方,不是它有多快,而是它的克制。
它没有去设计一个能表达计算图、能存优化器状态、能塞自定义算子的”模型容器”。它只回答一个问题:给定一张”名字 → 字节区间”的表,能不能安全、零成本地把张量交给上层?
为此它做了几件很朴素的事:
- 用 8 字节长度 + JSON 描述布局,任何语言几十行就能实现解析;
- 把”可执行”从格式里彻底剥离,安全不再是补丁;
- 让每个张量的位置可以 O(1) 计算,于是懒加载、切片、分片、原地修改全都成了自然结果;
- 用”数据区必须被完整索引”这种约束,堵住 polyglot 这类结构性攻击。
从整个技术栈看,三个环节分工清晰:训练决定权重如何产生,Safetensors 决定权重如何保存和分发,推理框架决定权重如何被执行。
而它的 offset 设计还打开了一个更有意思的方向:当权重文件从”一个不透明的 blob”变成”一张可寻址的表”,权重就不再只能整体加载,而可以被精确地读取、比较、修改和局部替换。这正是权重拆分、模型调试、以及 Deletion Tuning 这类”只改一点点权重”的方法,能够从论文走到工程的前提。
延伸阅读
| 项目 / 资料 | 关注点 |
|---|---|
| safetensors | 格式规范与 Rust/Python 实现 |
| Safetensors 文档 | API、速度对比、迁移指南 |
| Deleting Weights | 1 bit/weight 的掩码式后训练 |
| Transformers | 权重加载、分片与 index 的实现 |
| llama.cpp | GGUF 格式与量化流水线 |
| vLLM | 高性能加载与分布式推理 |
实验环境:Windows 11 / Python 3.11.9 / torch 2.14.1+cpu / safetensors 0.8.0,2.44 GiB 合成 Llama 风格 checkpoint(43 个张量),CPU-only,计时取 3 次最优。文中所有耗时与内存数字均来自本机实测,不同硬件与文件系统会有差异。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- Blender Kiln:AI 建模缺的不是生成能力,是交付前的度量
- CineCode:每一帧都是时间的纯函数,所以电影可以被检查
- OhMyGame:AI 生成游戏不难,难的是让它自己发现游戏跑不起来
- GPT-2 的一次前向:一条 768 维的向量,被改写 12 次,变成 50257 个分数
- SAELens:重建得越准,特征越不一定是真的
- TokenEconomizer:Coding Agent 的成本按仓库累积,不按任务计价
- Transformer Explainer:把 GPT-2 塞进浏览器,让模型边算边解释自己
- Boubou:本地语音 AI 缺的不是模型,是一层能借给全屋的运行时
- Hy-MT2:把翻译拆成语言家族分头训练,再蒸馏回一个模型
- NNsight:把干预写进前向传播,让同一段代码在 405B 模型上跑