MNN:端侧推理引擎真正的产品,是一张敢标 C 的支持矩阵
端侧推理引擎的 README 一般有两张表:一张写自己支持多少算子,一张写自己比谁快。
MNN 的 README 还有第三张表,是我认为这个仓库最值钱的一页:18 行,4 列,72 个格子,每格标一个字母。
S 是深度优化,A 是可用,B 是有缺陷或没优化,C 是不支持。
按这张表数一遍:S 18 格,A 17 格,B 13 格,C 24 格。三分之一的格子,官方自己标的是「不做」。六个 NPU 后端行加起来,一个 S 都没有。
这是产品文档里少见的自我评价。绝大多数框架把「支持」写成布尔值——支持 Metal,支持 INT4——MNN 把它拆成二维:同一列(精度)在不同行(后端)上的成熟度完全不同,而且它愿意把差的那一档写出来。
MNN 是阿里的端侧推理引擎,C++ 写的,Apache 2.0,已经集成进淘宝、天猫、优酷、钉钉、闲鱼等 30 多个阿里应用,覆盖 70 多个场景;往上还衍生出 MNN-LLM 与 MNN-Diffusion 两个大模型运行时。
- 源码:alibaba/MNN(Apache 2.0)
- 支持矩阵:README 的 Architecture / Precision 表
- 最新版本:3.6.2,2026-10-29 发布
- 文档:mnn-docs.readthedocs.io
- 自己造的模型:MNN-Pocket-0.3B,2026-11-09
本文只讲一件事:为什么应该用「填了多少格」而不是「支持多少算子」来读这个引擎,以及 3.6.2 这一版分别用什么方式填了哪几类格子。
一、先把这张表看完整
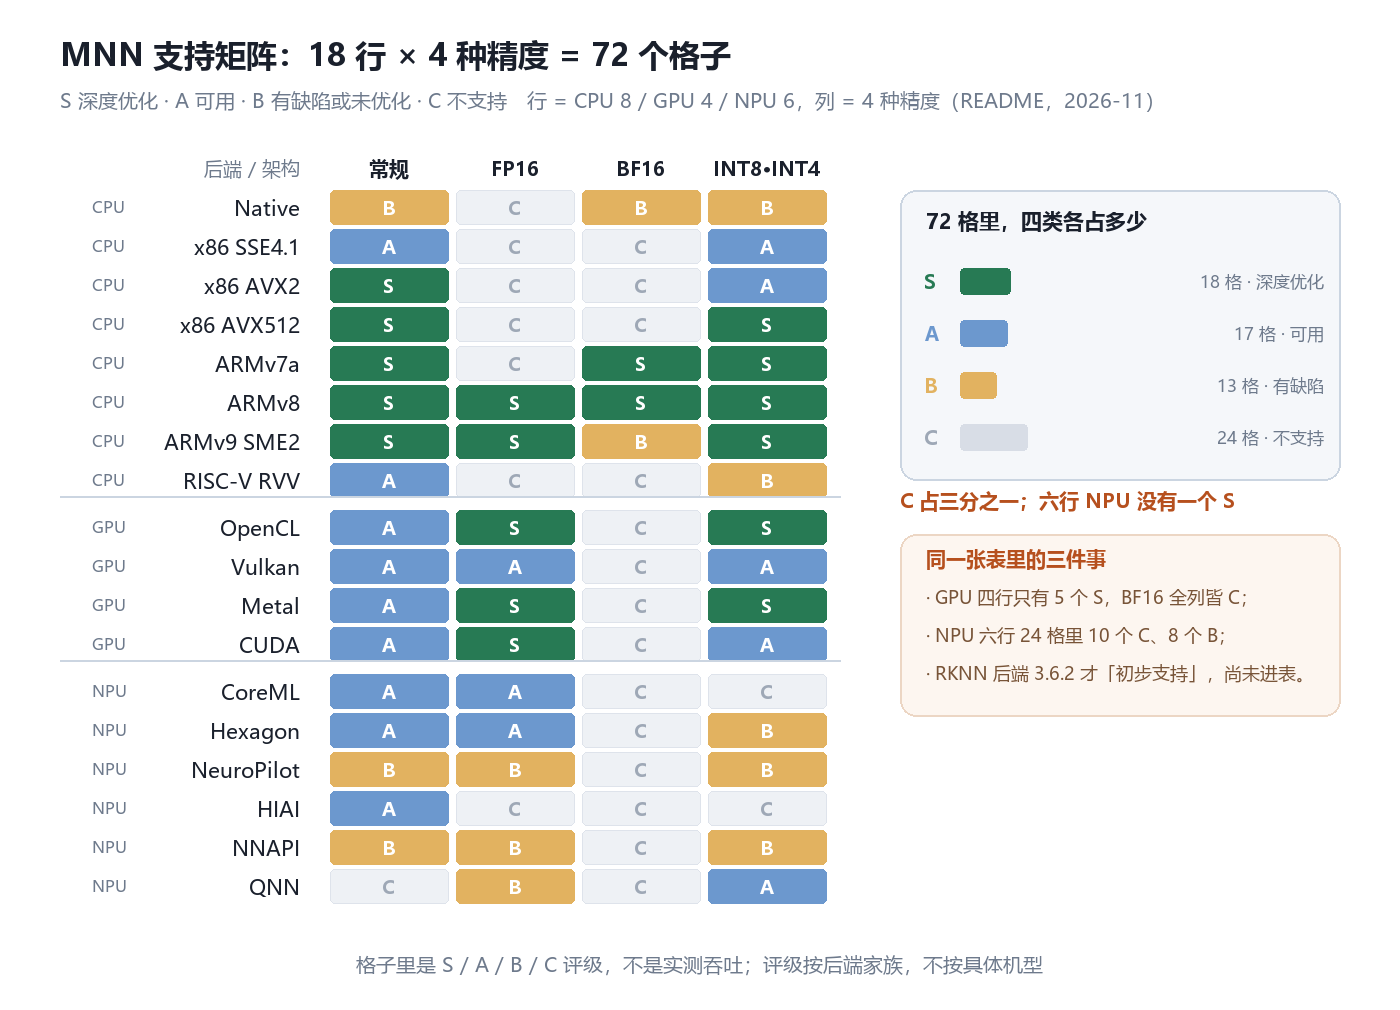
行是后端家族:CPU 8 行(含 x86 与 ARM 的各代 SIMD)、GPU 4 行、NPU 6 行;列是四种数值精度。评级来自 README,不是我的实测。
这张表的信息密度比它看起来高,因为「不支持」不是均匀撒开的:
| 评级 | 格数 | 分布 |
|---|---|---|
| S | 18 | CPU 13(ARMv8 一行 4 格全 S)、GPU 5、NPU 0 |
| A | 17 | CPU 4、GPU 7、NPU 6 |
| B | 13 | CPU 5、GPU 0、NPU 8 |
| C | 24 | 常规 1、FP16 7、BF16 14、INT8 / INT4 2 |
两个结论直接从这张分布里掉出来。
第一,短板不在低比特,在 BF16。INT8 / INT4 那一列 18 行里只有 2 个 C(CoreML 和 HIAI),而 BF16 是 14 个 C——GPU 四行全军覆没。这跟直觉相反:端侧引擎通常最不擅长低比特,MNN 恰好倒过来,3.6 之后 2/3-bit 权重在 CPU 与 GPU 上是全栈支持,BF16 却只在 ARM 的两行上拿到 S(ARMv7a 与 ARMv8,后者要求 ARMv8.6),其余不是 C 就是 B。
第二,NPU 这一栏还处在「能跑」而不是「值得跑」的阶段。六个 NPU 后端,10 个 C、8 个 B、6 个 A、0 个 S。最成熟的是 QNN 的 INT8 / INT4,最别扭的是 QNN 的常规精度——恰恰是 C。
注意评级的粒度:它是按后端家族打的,不是按机型。ARMv8 这一行全 S,不保证你那台机器的驱动、温度和内存带宽能让它跑到官方数字。这张表承诺的是「有人在维护这条路径」,不是「你的手机会快」。
二、为什么「支持」必须是二维的
MNN 的转换器能读 178 个 TensorFlow 算子、158 个 ONNX 算子、163 个 TorchScript 算子、52 个 Caffe 算子。
这些数字很容易被当成能力上限,但它们只描述前端:能读进来,不代表能跑;能跑,不代表在某个精度下被优化过。
一个算子进到引擎里,要在每个后端各实现一遍;同一个后端的实现还要分精度分档。于是整个模型的支持程度,等于它用到的那批算子在这条 (后端, 精度) 路径上最差的那一格。这正是矩阵而不是列表的原因。
举个具体的:Qwen3.5-2B 的权重按 INT4 导出之后——
- 在 Metal 上是 S,并且 3.6.2 专门为它加了 Q4 权重读取和投机解码块的分块计算;
- 在 Hexagon 上是 B,文档口径是对称 INT4 权重配 FP16 激活,不是全整数执行;
- 在 RISC-V 上是 B,同版本给出进迭时空 K3 的实测:8 线程、W4B64 配置下 Prefill(PP512)85.60 tok/s、Decode(TG128)17.68 tok/s。
同一份模型文件,三种完全不同的经验。所以「MNN 支持 INT4 吗」这个问题没有单一答案,只有「在哪一行上、到什么程度」。
三、行是运行时选的,列是导出时定的
矩阵还有一个结构上的不对称,它决定了你在部署阶段到底有多少优化空间。
列(精度)在导出时就定死了。量化位宽、分组大小、lm_head 单独的位置宽,都是导出参数:
python llmexport.py \
        --path /path/to/Qwen3.5-2B \
        --export mnn \
        --quant_bit 4 \
        --quant_block 128
行(后端)在运行时才选。到 MNN-LLM 这一层,它收敛成 config.json 里的几个字段:
{ "backend_type": "metal", "precision": "low", "thread_num": 4 }
backend_type 默认 cpu,Android 上可填 opencl,macOS / iOS 上可填 metal;precision 默认 low,倾向 FP16。
由此得到一个不太好听但很实际的推论:部署阶段你能免费换的只有行,换列要重新导出。这也解释了为什么 MNN 的性能图默认拿「同一台设备的不同后端」做对照——在那个对照里,列是固定的,行是唯一变量,数字才有可比性。换成跨引擎对比,两边的列大概率不是同一列,比的就不是一件事了。
顺带一提,CoreML 那两行还有一个容易忽略的注脚:它在常规精度下走的就是 FP16 的 MIL 张量与权重,Precision_Low 并不是一条独立的执行路径。这类细节不会出现在矩阵里,但会出现在你的精度对账里。
四、3.6.2 的三条填格线
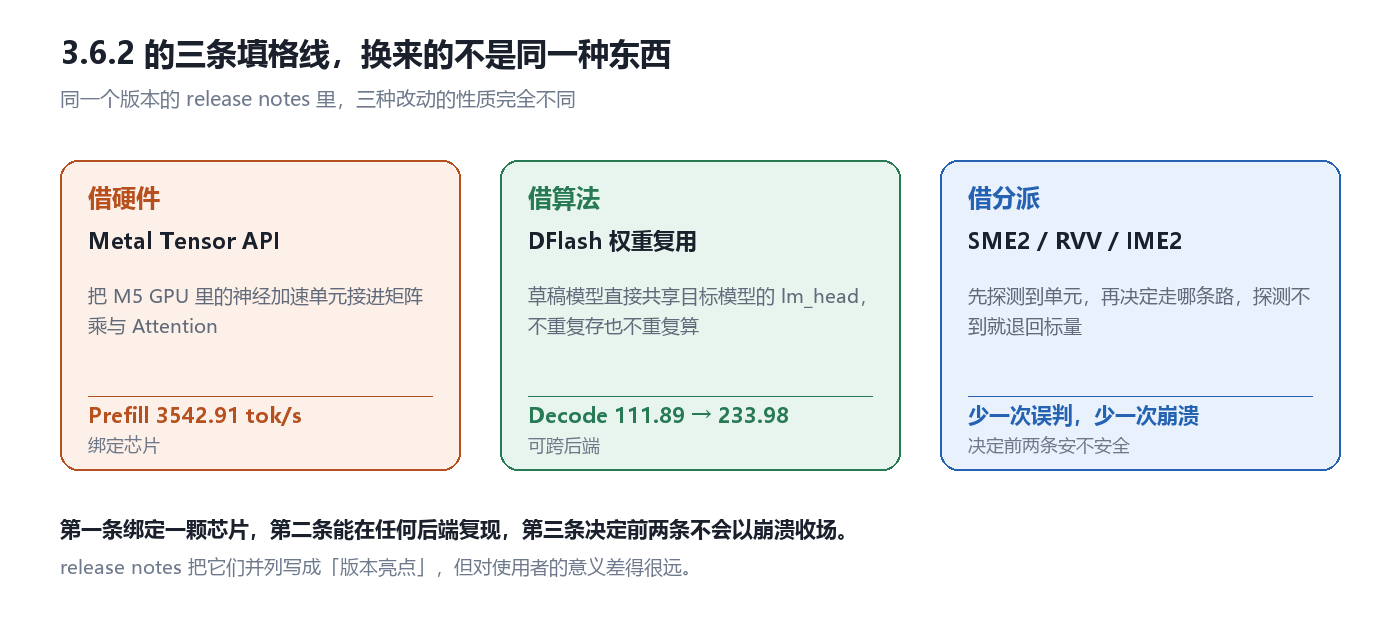
release notes 把它们并列写成「版本亮点」,但对使用者的含义差得很远:第一条绑定一颗芯片,第二条能在任何后端复现,第三条决定前两条会不会以崩溃收场。
三类改动,三种性质:
- 借硬件:通过 Metal Tensor API 用上 Apple GPU 里的神经加速单元(M5 等),把矩阵乘、Attention、LinearAttention 的分块与数据访问重写一遍。
- 借算法:DFlash 投机解码,草稿模型直接共享目标模型的
lm_head,既不多存一份权重也不多算一次输出层。 - 借分派:CPU 侧的 SME2 计算单元检测与 SME2 / NEON 混合执行,RISC-V 侧用
riscv_hwprobe探测能力并保留标量回退。
第三条最不性感,但它是前两条能安全发布的前提。3.6.2 的修复项里专门有一条:RISC-V 上用 riscv_hwprobe 做运行时分派,避免在不支持 RVV 的设备上错误分派——也就是说,探测失败时的行为被当成一个 bug 来修。
五、DFlash:省下的不是一次矩阵乘,是几次目标模型的前向
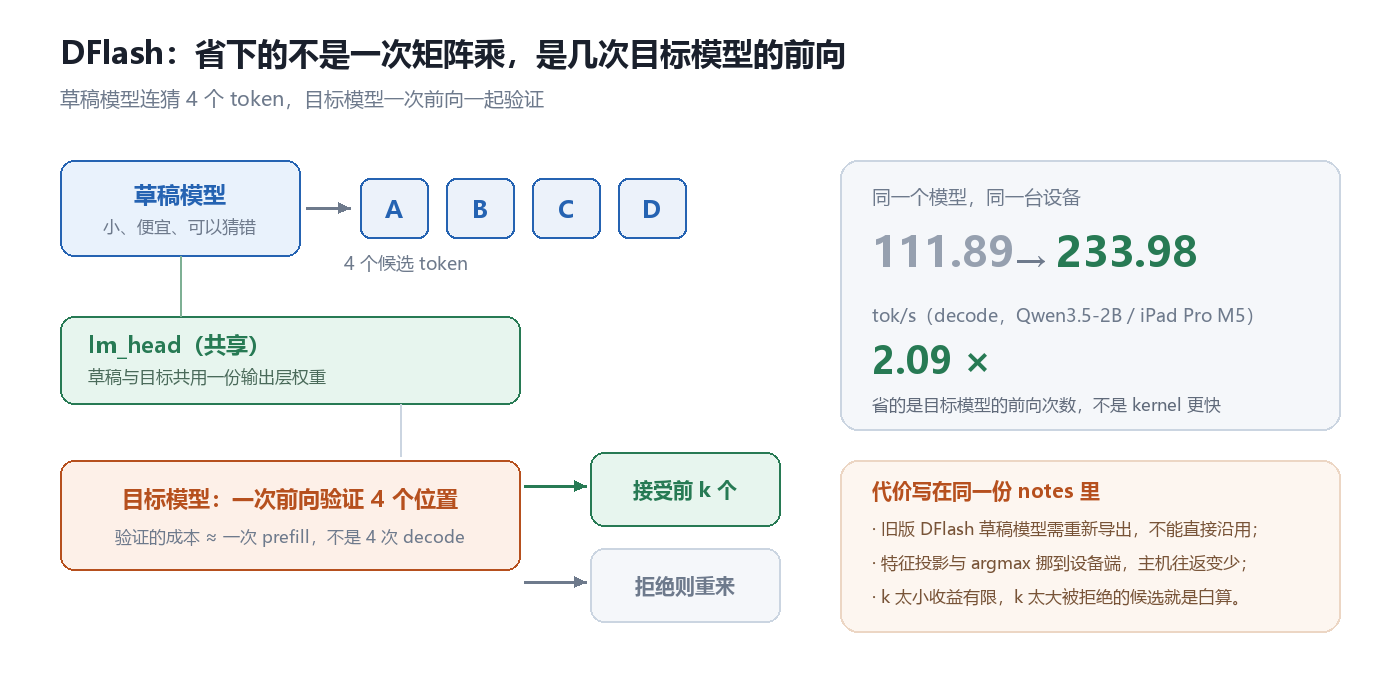
投机解码的收益来自「少跑几次目标模型」,不来自某个 kernel 变快。这也是唯一一类能跨后端复用的优化。
官方给的数字:Qwen3.5-2B 在 iPad Pro M5 的 GPU 上,Decode 从 111.89 tok/s 提升到 233.98 tok/s,2.09 倍。
这个倍数的来源值得说清楚。常规 decode 是一次前向出一个 token;投机解码让便宜的草稿模型连猜几个,再让目标模型一次前向把这些位置一起验证。验证的成本接近一次 prefill,而不是 k 次 decode——所以只要有一半候选被接受,就已经是净赚。
3.6.2 在这一版里加的三件事都指向同一处成本:
- 特征投影、拼接与 argmax 挪到设备端执行,减少主机往返;
- 草稿的 KV Cache 增量维护,不重复计算;
- 草稿模型复用目标模型的
lm_head,减少磁盘与运行时的重复权重。
顺带说个时间线:DFlash 是 3.6.0(2026-06)引入的,3.6.2 才把它调到 2.09 倍,并且 release notes 里带了一句明确的升级提示——旧版 DFlash 草稿模型需要重新导出。所以这个数字是三个月迭代的结果,不是一个版本的天降。
代价也写在同一份 notes 里:k 太小收益有限,k 太大被拒绝的候选就是白算;把更多计算挪到设备端,主机侧能观测到的东西就更少。
六、Metal:接入一颗芯片里原本没人用的单元
Apple 在 M5 这一代 GPU 里放了神经加速单元,通过 Metal Tensor API 暴露。3.6.2 针对它重写了分块策略与数据访问,覆盖矩阵计算、Attention 和 LinearAttention,并顺带补了 W2 / W3 的解码 GEMV、Q4 权重读取与 conv1x1。
结果就是那个 3542.91 tok/s 的 Prefill。
这条线的性质要看清:它只在支持这套 API 的 GPU 上有意义,换一颗芯片就归零。它是「填一格」,不是「把一格填得更好」——同一份代码在别处并不存在。
这也是端侧性能数字难横向比较的根源:官方给的对照组是同一台设备的 CPU 与 GPU,而不是另一个引擎在同一台设备上的表现。前者能证明「你用上了新硬件」,后者才能证明「你的引擎更好」,而后者在公开材料里几乎没有。
七、Hexagon 与 RKNN:进表才算数
Hexagon 是 3.6.2 的重点之一,但它的身份是新后端:3.6.1(2026-07-22)才把 Hexagon 后端发出来,3.6.2 做的是第二轮优化——融合 INT4 GEMV、GatedRMSNorm、norm + RoPE 的融合解码路径,DSP 上的 LinearAttention(Qwen3.5 gated delta rule 与 LFM2 short convolution,分块 prefill 加 HMX 计算),以及 INT4 反量化、HMX GEMM、分组因果 Attention、DMA 双缓冲和 VTCM 工作区。
同一版里还有另一个名字:Rockchip RKNN 后端,3.6.2 的措辞是「初步支持」。
这两句话的差别就是全文的核心。Hexagon 已经在支持矩阵里占了一行;RKNN 还没有。一个后端什么时候算真正被支持?答案是它进表的那一天。「初步支持」意味着能跑通某些模型,但不承诺评级、不承诺优化、也不承诺下一版还在。
官方自己用「有没有进表」来区分成熟度,这比任何宣传语都可靠。
八、反向证据:修复清单是按后端分段的
看一个引擎的广度,除了新功能,还可以看它的 bug 清单长什么样。3.6.2 的「缺陷修复」一节按后端分段:Metal、OpenCL、Vulkan、CUDA、Hexagon、QNN 与多后端 Pooling、CPU 与框架、转换器与安全——正好是矩阵上那批行。
随手挑几条:
- Metal:Attention 的并发访问、mask 与 KVCache 扩容,以及 GPU 命令失败时终止生成;
- OpenCL:Attention 在内存重分配之前的越界访问;
- Hexagon:Attention tile 的数据路径,以及主机写入与排队命令的冲突;
- CPU 与框架:重复 forward 未刷新输入副本、布局变化后复用旧副本、
CPUResizeCache引用过期内存。
这些都不是「某功能不能用」,而是「某个后端在某种形状、某种时序下算错或崩掉」。只有真的有人在这条路径上跑过,才会发现它们。
还有一组更少被讨论的:转换器侧的三个安全修复——限制 ONNX external_data 的读取目录、修复 QNN 导出的命令注入风险、校验外置卷积权重长度。每支持一种新模型格式,就多一个解析器;每多一个解析器,就多一片攻击面。这部分维护成本从来不出现在支持矩阵里,但它真实存在。
所以矩阵的每一格都要持续付费,C 格是不付的那部分。
九、广度的账单
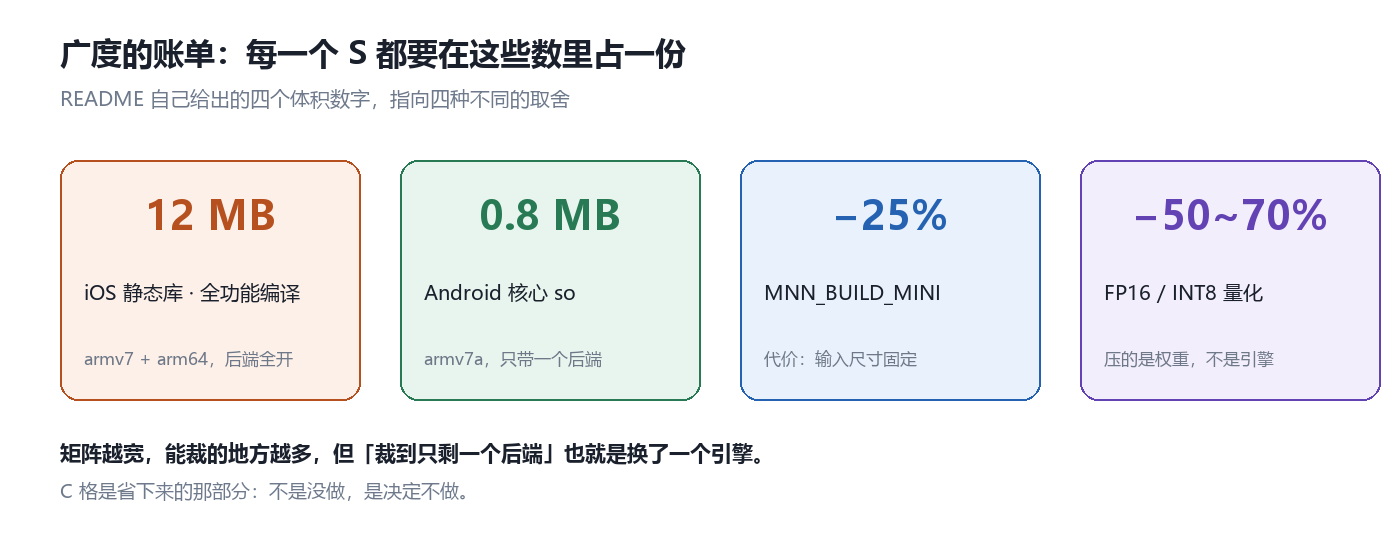
README 自己给出的四个数字,指向四种不同的取舍。每一个 S 都要在这些数里占一份。
- iOS 静态库,全功能编译(armv7 + arm64):约 12 MB,链接后可执行文件增量约 2 MB;
- Android 核心 so(armv7a,c++_shared):约 800 KB;
-
MNN_BUILD_MINI:再减 约 25%,代价是模型输入尺寸必须固定; - FP16 / INT8 量化后的模型体积:减少 50%~70%——压的是权重,不是引擎。
第三条最能说明端侧的取舍逻辑:「轻量」和「动态输入」在移动端是一对互斥项。你要省那 25%,就得放弃变长输入,而 LLM 恰恰是最不能固定输入的那类模型。
矩阵越宽,能裁的地方越多;但裁到只剩一个后端,你得到的就不再是这个引擎,而是另一个引擎。
十、MNN-Pocket-0.3B:把表反过来用
2026-11-04,MNN 团队发了一个自己训练的模型:MNN-Pocket-0.3B。
300M 参数的 dense 模型,32K 上下文,Apache 2.0。INT4(W4A16)加 QAT 之后,MNN 格式的部署包只有 173 MB。预训练用了约 4.1T 中英 token,后训练三段:指令微调、多教师 on-policy 蒸馏、量化感知训练。
这个项目的意义不在参数规模,在于它的方法论写得很直白:硬件感知的架构选择(按端侧内存与算力预算挑结构)加依赖感知的词表裁剪,然后再针对具体硬件做推理侧优化。
也就是说,它不是「等模型训好了再适配引擎」,而是先看矩阵上哪一格能填成 S,再去设计一个能落在那格里的模型。
这带来了一个很实用的口径问题。同一个模型,官方给了两个 decode 数字:
| 来源 | 设备 | Decode |
|---|---|---|
| README | iPhone 18 Pro | 350 tok/s |
| 技术报告摘要 | iPad Pro M5(Metal) | 最高 466 tok/s |
差 33%。不是有人写错了,是两台设备。这就是第一节那张表存在的理由:任何端侧数字都必须带设备名与后端名,否则它不构成信息。
十一、局限
- 评级是后端家族的,不是机型的。S 只说明这条路径有人在优化,不保证你那台机器的驱动、散热和内存带宽能让它跑到官方数字。
- 官方性能数字的对照组是同一设备的不同后端,不是别的引擎。没有跨引擎同机同模型对比,就不能从这些数字推出「MNN 比 X 快」。
- BF16 在 GPU 上全列 C。如果你的链路需要 BF16 的数值范围,MNN 现在不是答案。
- INT8 / INT4 的 S 不等于全整数执行。矩阵的脚注自己写了:这些评级覆盖的是受支持的量化路径,包括 weight-only 量化,不意味着每个算子都走整数流水线。
- 本文所有吞吐数字都是官方公布值。我没有在真机上复现 3542.91 或 233.98,只在本地核对了矩阵的每一格与 release notes 的每一条。
十二、我的判断
这张矩阵最大的价值不是让人挑模型,而是给出了三条可以验证的下一步:
一,看 RKNN 什么时候进表。它现在是「初步支持」,进表意味着有人愿意为它的评级签字。这是一个比任何 roadmap 都硬的成熟度信号。
二,看 2.09 倍能不能在别的后端上复现同样的比例。如果 DFlash 的收益在 Hexagon 或 OpenCL 上也是 2 倍上下,那它属于「算法类增益」,可以跨硬件迁移;如果只有 Metal 上成立,说明它强依赖那里的 Q4 分块与命令回放——那就还是硬件类增益,换芯片即失效。这一条用公开数字就能判,不需要真机。
三,看 MNN-Pocket 这条「按格子设计模型」的路线会不会有第二个模型。一个模型可以是巧合,两个就是方法论。
最后回到我最近一直在读的东西上。做权重编辑、激活干预、表征分析这类工作,第一步通常是把模型跑起来看一眼激活分布——而这张表其实是在提醒:你得先确认自己跑在哪个格子上。一个落在 B 格或 C 格上的实验,结论没法复现,也没法归因。支持矩阵是另一种形式的可观测性:它告诉你哪些数值路径是有人在维护的,哪些是没人跑的。
项目与资料
- GitHub 源码(Apache 2.0)
- README 支持矩阵:本文第一节的全部数据来源
- MNN 3.6.2 发布说明(2026-10-29):性能数字、DFlash、Metal 与 Hexagon 优化的出处
- MNN-LLM 文档:导出参数与
config.json字段 - 官方文档、MNN-Diffusion
- MNN-Pocket-0.3B 技术报告(arXiv:2611.12311)
- 背景论文:Walle,OSDI’22;MNN,MLSys 2020
数据来源为官方 README、3.6.2 Release Notes 与技术报告。支持矩阵的评级与格数由我从 README 表格逐格统计,可能在后续版本中变化;性能数字均为官方在特定设备上的公布值,不代表其他硬件环境。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- vLLM:每次重写,改的都是同一本显存账
- Diagram Design:50 种图表是目录,能拒绝你的检查才是产品
- gpu-unlock:GeForce 的半速矩阵算力,写死在八个 4 位字段里
- Octop:单进程是它的地基,也是它的天花板
- VoiceStudio:把 ElevenLabs 搬回本地之后,账单换成了许可证
- DroidDeck:手机跑 PC 游戏不难,难的是让 Android 相信自己正在当主机
- magpie:它调度的不是模型,是会过期的额度
- Aerial:换桌面不是画界面,是在别人的固件里抢前台
- colibri:同一个引擎 184 倍的速度差,全部来自权重住在哪一层
- GEO:最有效的三种写法,官方提示词里都写着“可以编造”