拉片笔记:7200 张截图装不进上下文,它把压缩写成了契约
一部两小时的电影,按 1 秒 1 帧抽帧,是 7200 张截图。
把它交给任何一个聊天窗口,问题都不在「模型看不看得懂电影」,而在你最多能塞给它多少张图。拉片笔记(Lapian Notes)这个开源项目,真正的设计工作几乎全部花在这件事上:先把 7200 张压到 360 格,再把 360 格压成 12–20 个点,然后给每一次压缩标价。
- GitHub:bkingfilm/lapian-notes(MIT,TypeScript / React 19 / Vite 8,2026-07-08 建仓,797 star)
- 在线试用:bkingfilm.github.io/lapian-notes(抽帧、笔记、生成分析包可用;转码、自动搜字幕、AI 直连要下完整版)
- 口径:README、v0.3.1 → v0.5.3 的 release notes,以及
src/里的源码;界面截图来自仓库docs/
本文只讲一件事:当输入装不进上下文时,一个工具该怎么把「有损」这件事变成可复核的流程,而不是留给模型即兴发挥。
一、三个数字
| 数字 | 是什么 | 出处 |
|---|---|---|
| 7200 张 | 两小时 × 1 秒 1 帧;README 说通常 6000–8000 | 抽帧逻辑 + README |
| 360 格 | 免压缩包流程能送进 AI 的画面上限:4×6×15 张 | domesticAiPackage.ts |
| 12–20 个 | 全片观众体验曲线点的数量,由 prompt 规定 | 分析包里的 prompt.md |
三个数字连起来是一条压缩链,比例都是算出来的:7200 → 360 是 20 : 1,360 → 12–20 又是二十倍量级。
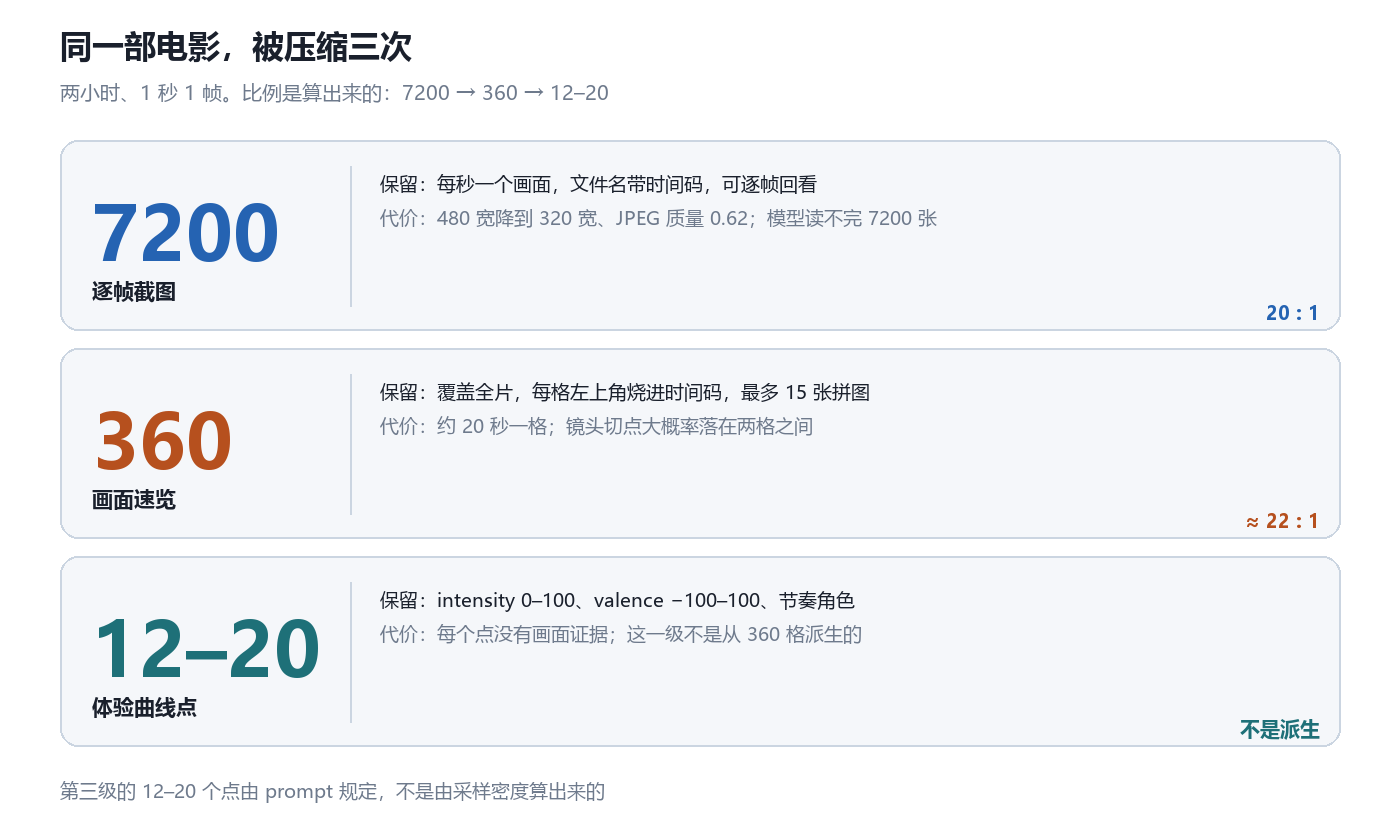
每一级都保留时间码,每一级都丢掉一些东西;第三级的点不是从第二级派生的,是模型对全片下的判断。
先记住第三行末尾那半句——它决定了这篇文章后面每一句「情绪曲线」的可信度该打几折。
二、为什么不能把电影直接交给模型
电影分析这件事,输入形态无非几种,成本和信息量完全不同:
| 输入 | 一次两小时电影的量 | 模型实际拿到什么 |
|---|---|---|
| 原片视频 | 7200 秒 | 拿不到——工具根本不上传视频,只在本机解码 |
| 逐帧截图 | 7200 张,约 70MB | 读不完。免费额度通常只翻开头、中段、结尾 |
| 4×6 拼图 | 最多 15 张 = 360 格 | 能传,但约 20 秒才有一格 |
| 字幕 SRT | 数千行 | 只有文本,画面全丢 |
所以这个项目的第一步不是「调模型」,而是把视频转成模型更容易处理的数据:抽帧得到带时间码的截图,抽字幕得到文本,再把两者和任务说明书一起打包。
也正是这一步决定了后面所有取舍。截图越小越好传、越大越看得清构图,项目选的是 320 px 宽——「AI 认场景和构图用这个尺寸完全够」。这不是审美判断,是一次体积换信息量的交易:v0.3.1 把 480 宽改成 320 宽后,两小时电影的分析包从约 280MB 降到约 70MB,顺带让 ChatGPT 免费版也能稳定上传。
三、管线:四步向导,两次压缩
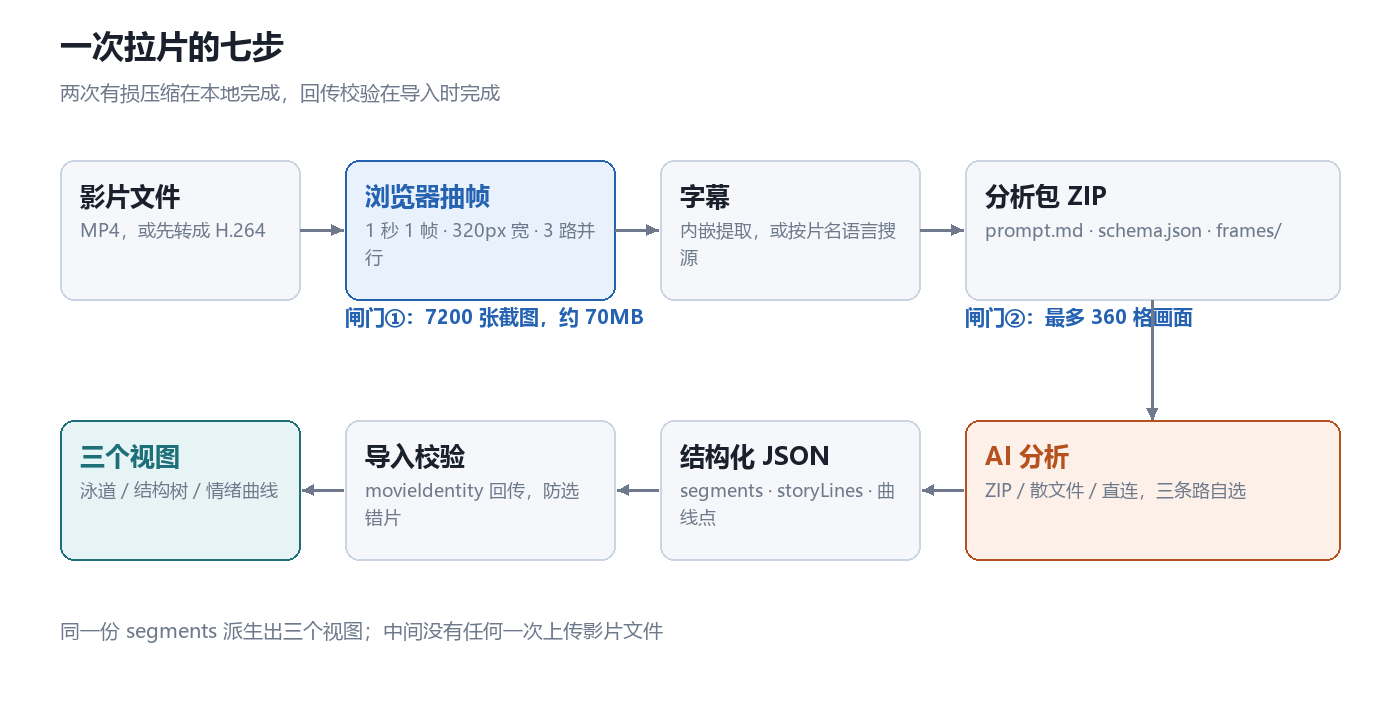
两次有损压缩都在本地完成;只有压缩后的产物会离开这台机器。
界面上是常驻的四步向导:导入电影 → 把分析包发给 AI → 导回 JSON → 精修。拆到源码层面是七步,其中两个位置是真正的闸门:
- 闸门①:7200 张截图,约 70MB。体积在这里定死。
- 闸门②:最多 360 格画面。信息密度在这里定死。
值得单独说的是转码和搜字幕这两件事由谁做。抽帧全在浏览器里完成(videoFrames.ts),但自动转码和自动搜字幕走的是 dev server 的本地插件(transcode-server-plugin.ts、subtitle-server-plugin.ts)——所以静态部署 npm run build 出来的产物会降级成手动操作,在线试用版也因此没有这两项。README 写得很直白:这两项「需要下载完整版」。
四、抽帧:三个常数和一条黑帧闸门
videoFrames.ts 的注释本身就是一份设计说明。三个常数值得抄:
| 常数 | 值 | 为什么 |
|---|---|---|
| 截图宽度 | 320 px | 「再大只是白占空间和上传流量」;高度按原片比例算 |
| 并行解码器 | 3 路 | 串行 seek 时解码器大部分时间在等;注释说 3 路「在普通机器上就能把吞吐拉满」 |
| 黑帧探测 | 开头 30 帧 | 解不出来的片源会抽出几千张纯黑图,一路抽到七千帧才发现白等一场 |
| 黑帧判据 | 最亮像素 ≤ 2 | 用平均亮度会把黑底白字的片头 logo 误判成黑帧 |
| JPEG 质量 | 0.62 | 体积 |
三路并行是按连续区间切分的,不是交错分配——「worker 内部保持顺序 seek,解码器不用来回跳 GOP」。这是那种不写注释就一定会被后来人改坏的细节。
黑帧闸门是我最喜欢的一处:HEVC/H.265、AV1、10bit HDR 这类片源,浏览器读得到时长、解不出画面,drawImage 不报错,只是画出全 0 的纯黑。项目用「开头连续 30 帧全黑就当场停下」来判,并直接告诉你去转成 H.264 的 MP4。这类失效如果没有闸门,用户看到的是「抽帧成功,7200 张黑图」,而工具不会有任何一句报错。
代价也说清楚:即使有 3 路并行,v0.5.0 的成绩是两小时电影约 40 分钟。7200 次 seek 的物理成本没有消失,只是从「近两小时」降下来了。
五、契约:ZIP 里那五个文件
分析包不是「一堆截图」,而是一份带说明书的交付物:
| 文件 | 作用 |
|---|---|
README.md | 告诉 AI 包里有什么、结果怎么导回 |
prompt.md | 任务说明:切段规则、字段要求、剧情线规则、曲线规则 |
schema.json | 必须返回的 JSON 结构,字段要求写在示例值里 |
project.json | 影片元数据 + 每一帧的时间与文件名 |
subtitles.srt / .json | 字幕原文与结构化版本 |
frames/ | 7200 张带时间码文件名的截图 |
prompt.md 里有四句话,决定了这份笔记的质量上限:
- 「按真实剧情变化切分段落,不要按片长平均切。」
- 「每个段落必须写『故事总结』……不要直接复制字幕原文。」
- 「事实纪律:人物名、地名、身份……没有证据就不要写;宁可留空,不要脑补。」
-
keyBeats里每个节拍前标时间码,「方便人工回看核对」。
第 3 条是给幻觉上的锁,第 4 条是给人工复核留的钩子。没有这两条,AI 生成的拉片笔记会非常好看,也非常难验证。
还有一处容易被忽略:导入时校验 movieIdentity。prompt 要求模型把影片名、项目名、源视频文件名原样带回,「用于工具导入时校验是否选错电影」。一个人同时拆两部片子的时候,这个字段能救命。
工程上还有个小事实:这个 ZIP 是项目自己写的(framePackage.ts 里有手写 CRC32 和本地头),只支持未压缩存储,导入时报错是「当前仅支持未压缩 ZIP,请使用本工具导出的文件」。好处是导入导出同一套代码、字段完全可控;代价是 70MB 就是实打实的 70MB,不能靠压缩再省一半。
六、三条投递路径,和一次「不预设 DeepSeek」的决定
| 路径 | 一次送给 AI 的画面 | 适合谁 | 硬限制 |
|---|---|---|---|
| ZIP 全帧 | 7200 张,约 70MB | 能解压的模型(ChatGPT 等) | 免费额度常「偷懒」,只抽看几帧 |
| 国内 AI 免压缩包 | 15 张拼图 = 360 格 | Kimi / 豆包 / 通义 / DeepSeek | 约 20 秒一格;源码注释:牺牲密度换可上传 |
| AI 直连(BYOK) | 同拼图,base64 进消息 | 有 key 的 Gemini / Kimi / OpenAI / Claude | 仅本地完整版,在线版没有转发接口 |
免压缩包这条路的实现比名字讲究:4 列 × 6 行拼成一张 jpg,最多 15 张,每格左上角烧进时间码——因为国内模型收不了 7000 个附件,只能把时间信息焊在像素里。采样间隔是算出来的:ceil(片长 / 360),两小时正好 20 秒。
然后是那个最有意思的产品决定:直连分析的预设里没有 DeepSeek。README 给的理由不是「不支持」,而是:
它是纯文本模型,看不了画面。……预设进来容易让人用残血模式还以为工具就这水平。
想用也不是不行:选「自定义」填 https://api.deepseek.com,取消勾选「附带画面拼图」,工具退到纯字幕分析,prompt 里对应的条款也跟着降级成「没有画面:请完全依靠字幕判断剧情,无法从字幕确认的画面内容不要编造」。
把模型能力的边界写进默认值,而不是写进 FAQ——这个决定比多接一家 API 有价值得多。绝大多数工具的做法是「都支持,效果自己试」,代价是用户用一个残缺配置跑出平庸结果,然后把账记在工具头上。
七、一份 JSON,四个视图
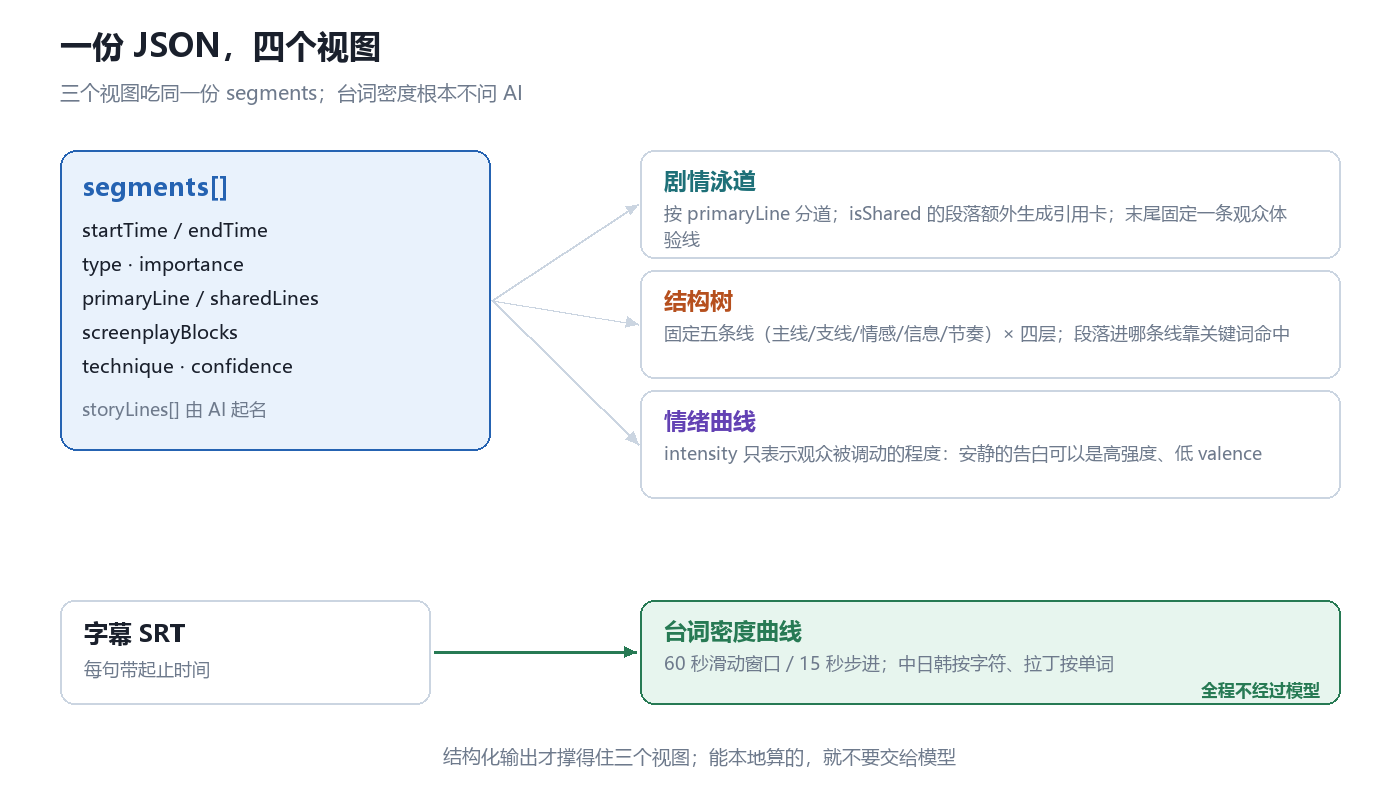
三个视图吃同一份 segments;第四条曲线根本不问模型。
导回 JSON 之后,四个视图的来路并不一样,这一点值得拆开看:
剧情泳道最像「AI 定制」。prompt 强烈建议模型返回 storyLines 数组,为这部片子自己起线名(id 必须是英文小写下划线),工具再固定追加一条「观众体验线」。primaryLine 决定段落落在哪条道,isShared 的段落会在其它线上生成引用卡。
结构树恰恰不是 AI 自由发挥。storyStructure.ts 里写死了五条线(主线 / 支线 / 情感线 / 信息线 / 节奏过渡线)和四层(建立 / 推进 / 转折升级 / 收束),段落进哪条线靠关键词命中:「关系」「情感」「和解」进情感线,「秘密」「真相」「反转」进信息线,「过渡」「转场」「铺垫」进节奏线。AI 负责写段落,工具负责把段落摆进固定的格子。 很多介绍会说「AI 生成结构树」,读了源码才知道格子是工具的。
情绪曲线有一条明确的量表纪律。prompt 写着:intensity 表示观众当下被调动的程度,不是开心程度,也不是剧情重要性;「安静但抓人的戏(告白、崩溃、沉默的对峙)是高强度、低 valence」;不许让强度随时间机械上升;全片至少 3 个明显下压、1–3 个峰值,结尾要有余韵。界面右上角也标着同一句话:强度「不等于开心程度或剧情重要性」。
台词密度是四条里唯一不算 AI 的。60 秒滑动窗口、15 秒步进,中日韩按字符计、拉丁按单词计,字幕跨窗口时按时长比例分摊。纯本地算术。
一句话总结这张图:四个视图里,只有台词密度是测量,其余三个都是判断。 知道哪条是测量,才知道哪条能拿去写论文、哪条只能当参考。
八、人的位置
如果只做到「AI 生成三个视图」,这东西就是个玩具。让它变成工具的是三处人工介入:
- 播放器联动:点段落、字幕行、剧本小节都能跳转到对应时间;「播放本段」会在段落结束时自动暂停。边看边改,是这个品类唯一成立的工作方式。
- 段落深拆包:只装这一段落的帧和字幕,要求 AI 把段落拆到场与镜头级——每 15–30 秒至少一条剧本小节,一段通常 15–40 条,
techniques必填 3–8 条视听手法。这是「一次只问一件事」的典型用法:全片分析负责骨架,段落深拆负责血肉。 - 完成度与段落诊断:
segmentCoverage.ts、segmentProgress.ts、segmentQuality.ts这几个文件做的事情很朴素——告诉你哪一段还没写完、哪一段的标题还是模板句。
导出侧有四种出口:Markdown 笔记、剧本正文、泳道时间轴长图、自包含项目 ZIP。
九、Local-first 的边界在哪
这个项目的定位是 local-first,但「本地」这四个字需要拆开:
| 数据 | 存在哪 | 什么时候离开本机 |
|---|---|---|
| 帧截图 | 浏览器 IndexedDB 缓存 | 导出分析包、发给 AI 时 |
| 笔记与项目 | 浏览器本地数据库 | 导出 ZIP 时 |
| AI API key | 本机浏览器 | 从不——直连是由本地 dev server 转发 |
| 影片文件 | 只读原文件,不复制 | 从不(存的是文件句柄,不是影片) |
| 分析包里的截图 | 用户手动上传 | 交给远程模型的那一刻 |
有两点需要说清楚。第一,本地处理不等于离线分析:一旦你把 70MB 的 ZIP 交给某个远程模型,那些画面就已经离开了这台机器。第二,README 的「数据存储」一节写的是笔记存在 localStorage,但 v0.5.0 的发布说明说自动保存已经搬进 IndexedDB——因为浏览器给了 5MB 限额,长片配大量笔记会写不进去。README 这一行滞后了一个大版本,按发布说明为准。
十、失效模式
按重要性排,这些是文档和源码里写明的坑:
- 免费额度会「偷懒」。 一部电影 6000–8000 张截图,免费模型处理不了这么多,但不会明说,而是只看开头、中段、结尾几张就交差,导回后你会发现段落特别少、内容特别简单。README 的建议是让它按
prompt.md逐段分析、不要抽样。 - 1 秒 1 帧不等于镜头切分。 这套流程没有任何 shot detection,快速剪辑、短暂动作、复杂转场都会落在两帧之间。抽帧解决的是「有没有画面证据」,不是「镜头在哪里切」。
- 黑帧闸门只是拦截,不是修复。 遇到 HEVC / AV1 / 10bit HDR,工具会停下并让你先转码——它没法替浏览器解码。
- 错版字幕会把时间轴撑长。 v0.5.2 加了字幕长度闸门,但也只是提示你裁掉超出部分。
- 刷新之后要重新授权影片。 这里 README 已经落后于代码:
videoHandleStore.ts把 File System Access 的文件句柄存进了 IndexedDB,Chrome / Edge 刷新后点一次「允许」就能接回播放和抽帧;Safari / Firefox 没有这个 API,仍然要重新选文件。README 那句「需要重新选择影片文件」只对后两者成立。 - 情绪曲线是判断,不是测量。 12–20 个点、intensity 0–100,本质上是一次有纪律的主观打分,不能当心理学数据。
- 结构树的归类会漏。 关键词命中不进线,就进主线兜底——一段写得很文学、但不含「转折」「关系」这些词的戏,很可能被摆错格子。
十一、我的判断
这个项目最值得学的不是电影分析,而是它把「模型一定会偷懒」当成产品的一等公民来处理:
- 先把输入压到模型接得住(7200 → 360);
- 再把要求写成契约(
prompt.md+schema.json,含「宁可留空」); - 再在导入时校验(
movieIdentity); - 最后把每一处不确定标出来(强度不等于重要性、关键词归类、免费额度会抽看)。
这四步和我一直在看的那条线是同一个教训:一个 AI 系统的可信度,不取决于它最好的输出,而取决于它有没有为最差的输出准备好标签。
如果要往下做,我会加两件可以验证的事:
- 把抽帧对齐到镜头边界。 现在 360 格是按时间均匀采的,而剧情段落几乎总是从镜头切点开始。用一次廉价的场景变化检测(相邻帧直方图差异就够)把采样点吸附到切点上,同样的 360 格能覆盖更多「转折发生在哪一秒」。
- 给情绪曲线加一列证据。 每个
audienceCurvePoint强迫模型引用 2–3 个帧文件名,或者引用字幕行号。这样「第 47 分钟强度 82」就不再是一个数字,而是一个可以点开复核的主张——和keyBeats带时间码是同一个思路,只是还没推到曲线这一层。
项目与资料
- 仓库:github.com/bkingfilm/lapian-notes(MIT)
- 在线试用:bkingfilm.github.io/lapian-notes(短链
l.bking.film) - 最新版本:v0.5.3(2026-10-26,Windows 启动修复)
- 关键源码:
src/lib/videoFrames.ts(抽帧与黑帧闸门)、src/lib/framePackage.ts(分析包、prompt、schema、ZIP)、src/lib/domesticAiPackage.ts(拼图)、src/lib/storyStructure.ts(结构树)、src/lib/dialogueDensity.ts(台词密度)
数据来源与口径:7200 张、70MB、280MB → 70MB、40 分钟、360 格与 20 秒间隔、12–20 个曲线点、「强度不等于开心或重要性」、movieIdentity 校验、「宁可留空」与「不要按片长平均切」均来自 README、对应版本的 release notes 或 src/ 源码;797 star、建仓日期取自 GitHub API(2026-11-16 查询)。「抽帧快 3 倍」是 v0.5.0 的原话,40 分钟是它的两小时影片数字,两者并不矛盾:倍数按同一台机器算,绝对时间仍然取决于片源和机器。结构树的五线四层、关键词归类、storyLines 的定制与回落、台词密度的窗口参数,都是读 src/ 得到的——README 没有写这些,这也是本文与常见介绍最大的差别。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- Airgorah:把 root 赶出 GUI 之后,每个跨边界的参数都得重新验一遍
- WSR:权重确实多给了 15 个点,也让它更敢说「变了」
- Yogurt:本地优先不是一句承诺,是一组能被算出来的预算
- Blender Kiln:AI 建模缺的不是生成能力,是交付前的度量
- CineCode:每一帧都是时间的纯函数,所以电影可以被检查
- OhMyGame:AI 生成游戏不难,难的是让它自己发现游戏跑不起来
- GPT-2 的一次前向:一条 768 维的向量,被改写 12 次,变成 50257 个分数
- SAELens:重建得越准,特征越不一定是真的
- TokenEconomizer:Coding Agent 的成本按仓库累积,不按任务计价
- Transformer Explainer:把 GPT-2 塞进浏览器,让模型边算边解释自己