Hy-MT2:把翻译拆成语言家族分头训练,再蒸馏回一个模型
先看三个数字。
- 440MB:Hy-MT2-1.8B 的 1.25-bit 版本,塞进手机或笔记本的存储占用。
- 85.70:30B-A3B 在 IFMTBench 上的总分,仅次于 Gemini 3.1 Pro 的 89.08。
- 1T tokens:进入后训练之前,它在翻译数据上又多训了一个量级的中期。
腾讯混元在 2026 年 5 月开源了 Hy-MT2 这一族翻译模型,规格是 1.8B、7B 和 30B-A3B(MoE),支持 33 种语言互译,同时放出了专门评测翻译指令遵循的 IFMTBench。论文是 Hy-MT2: A Family of Fast, Efficient and Powerful Multilingual Translation Models in the Wild(arXiv 2605.22064),代码在 Tencent-Hunyuan/Hy-MT2。
但真正值得研究的不是它支持多少语言,而是它怎么组织训练:先把多语言翻译按语言家族拆成几条互不干扰的分支,各自培养教师,再用两次在线策略蒸馏把能力合并回一个学生模型。
这套流程叫 Family-Centric Post-training(FCPT)。它解决的是一个很具体的问题——多语言模型里,语言之间的相互干扰。
一、上一代暴露的四个问题
Hy-MT2 不是凭空设计的。论文开篇先复盘了 Hy-MT1.5 上线后被真实业务反馈出来的短板,一共四条:
- 专业领域和真实场景不够稳。 金融、法律、医疗有大量固定译法和行业术语,网页、会议记录、社交媒体又充满缩写、口语和不完整句。
- 翻译指令容易被忽略。 用户要求“保留这个词不译”“用文言文风格”“按模板输出”,Hy-MT1.5 经常漏掉约束。
- 和最强闭源模型仍有差距。 论文点名的对手是 Gemini 3.1 Pro 和 GPT-5.5。
- 端侧部署仍然吃力。 Hy-MT1.5-1.8B 的 4-bit 量化版依然需要 1GB 以上存储,延迟也压不下去。
这四条正好对应 Hy-MT2 的四个动作:扩大训练数据覆盖面、把指令遵循当成独立能力来训、上 MoE 提高容量、把量化推到 1.25-bit。
论文里还有一句容易被略过的话:Hy3-Preview 的质量提升明显,于是团队直接把它当成教师模型来提升翻译模型。这句话是理解后面 Chimera Teacher 的钥匙——他们没有为翻译单独训一个巨型教师,而是把已有的强模型改造成教师信号生成器。
二、整体管线:三段训练
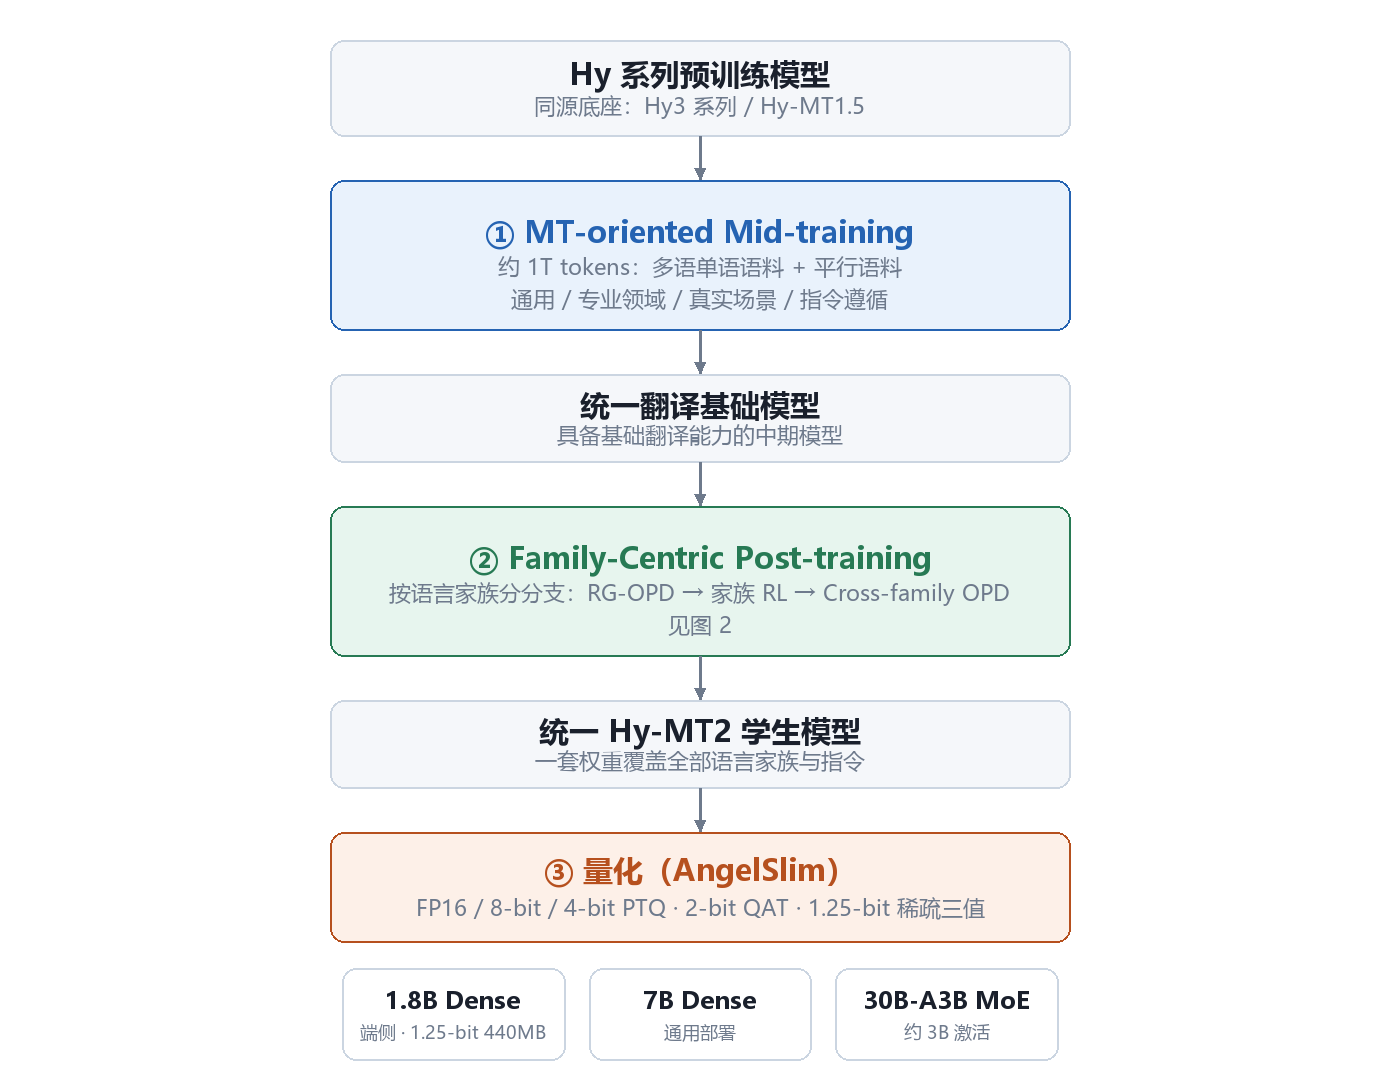
从 Hy 系列预训练模型到三个量化规格,Hy-MT2 的完整路径。
整条管线分三段:
- MT-oriented Mid-training:约 1T tokens,把通用底座改造成“会翻译”的底座。
- Family-Centric Post-training:三个子阶段,RG-OPD → 家族 RL → 跨家族 OPD。
- 量化:FP16 / 8-bit / 4-bit / 2-bit / 1.25-bit 五档。
中期训练这一段看起来最平淡,但它是后面所有花活的前提。训练数据沿两个维度组织:
| 维度 | 内容 | 作用 |
|---|---|---|
| 数据形式 | 多语单语语料、平行翻译语料 | 前者补语言分布,后者建跨语言语义映射 |
| 场景覆盖 | 通用翻译、专业领域、真实场景、指令遵循 | 让模型在进后训练前就见过“脏”输入和约束 |
如果没有这 1T tokens,后面的语言家族分支会各自退化得太快——每个分支拿到的数据量其实变少了,底座必须先足够强。
三、为什么要按语言家族拆开
传统多语言模型的做法是把所有语言的数据混在一起训。听起来很合理:数据越多越好。但混合训练有个隐含代价——模型要在同一组参数里同时适配差异极大的分布。
西欧语言的词形变化、东亚语言的语序和文字系统、中东从右往左书写的语言,它们在 tokenizer 层面的切分方式都不一样。混在一起训,模型不是学不会,而是学得“平均”:每个语族都留一点余量,谁也不够锐利。
FCPT 的做法是反过来:先分,再合。
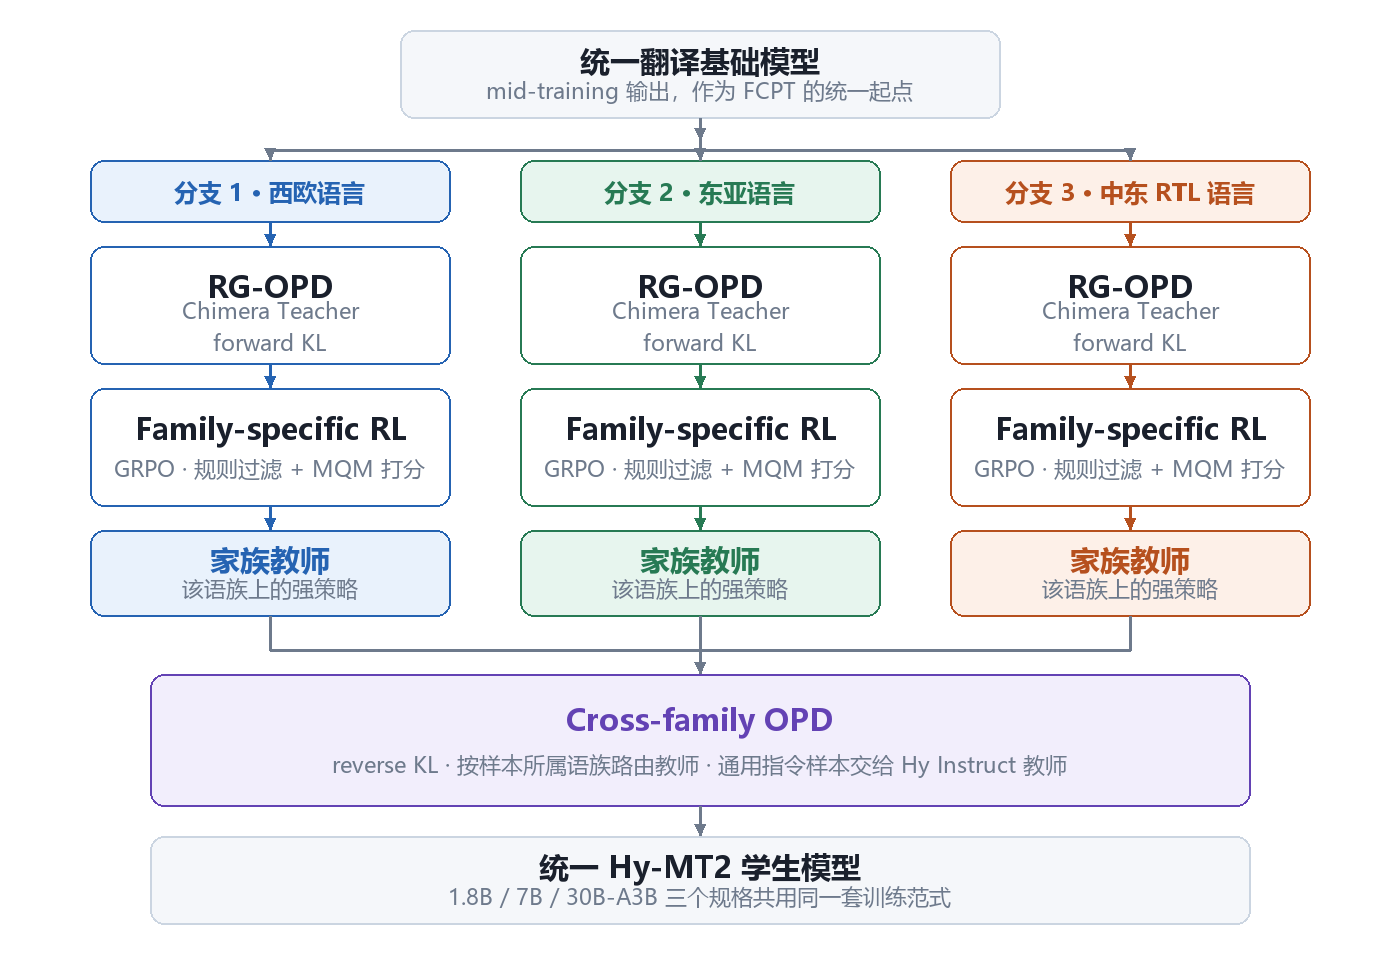
每个语言家族一条分支,各自经过 RG-OPD 和 RL 得到教师,最后由 Cross-family OPD 汇总。
论文里明确列出的分支包括西欧语言、东亚语言和中东 RTL 语言。每条分支内部都吃同一套四类数据:通用翻译、专业领域、真实场景、指令遵循。这样每个教师面对的语言分布更一致,训练干扰更小。
这里有个容易误解的点:分支不是最终产物。 最终发布的是一套统一权重,不是每个语族一个模型。分支只是“培养教师”的临时容器,蒸馏完就丢掉。
这个思路其实可以迁移:任何“多分布混合导致互相拖累”的场景都适用——多领域、多任务、多模态,都可以先分头训出专家,再蒸馏合并。
四、RG-OPD:教师不产出答案,而是给分布
FCPT 的第一阶段是 Reference-Guided On-Policy Distillation(参考引导的在线策略蒸馏)。
先把两个概念区分清楚。
离线蒸馏是拿教师事先生成好的固定输出当标签,学生做监督学习。问题是:学生只在这些固定答案上被纠正,一旦它自己采样出别的路径,没人告诉它对不对。
在线策略蒸馏(OPD) 换成另一套逻辑:学生先按当前策略生成译文,教师再针对这条实际生成的结果给出评价分布。
源句 x
  │
  ├─> 学生 π_θ 采样出译文 y      ← 学生自己的输出,不是标准答案
  │
  └─> 教师对 (x, y) 给出分布 π_T
          │
          v
     最小化 D_KL(π_T ‖ π_θ)
这样学生学到的是“如何评价和改进自己当前的结果”,而不只是“背诵一个参考答案”。
关键在于教师从哪里来。 Hy-MT2 没有训练一个额外的巨型翻译教师,而是构造了 Chimera Teacher:
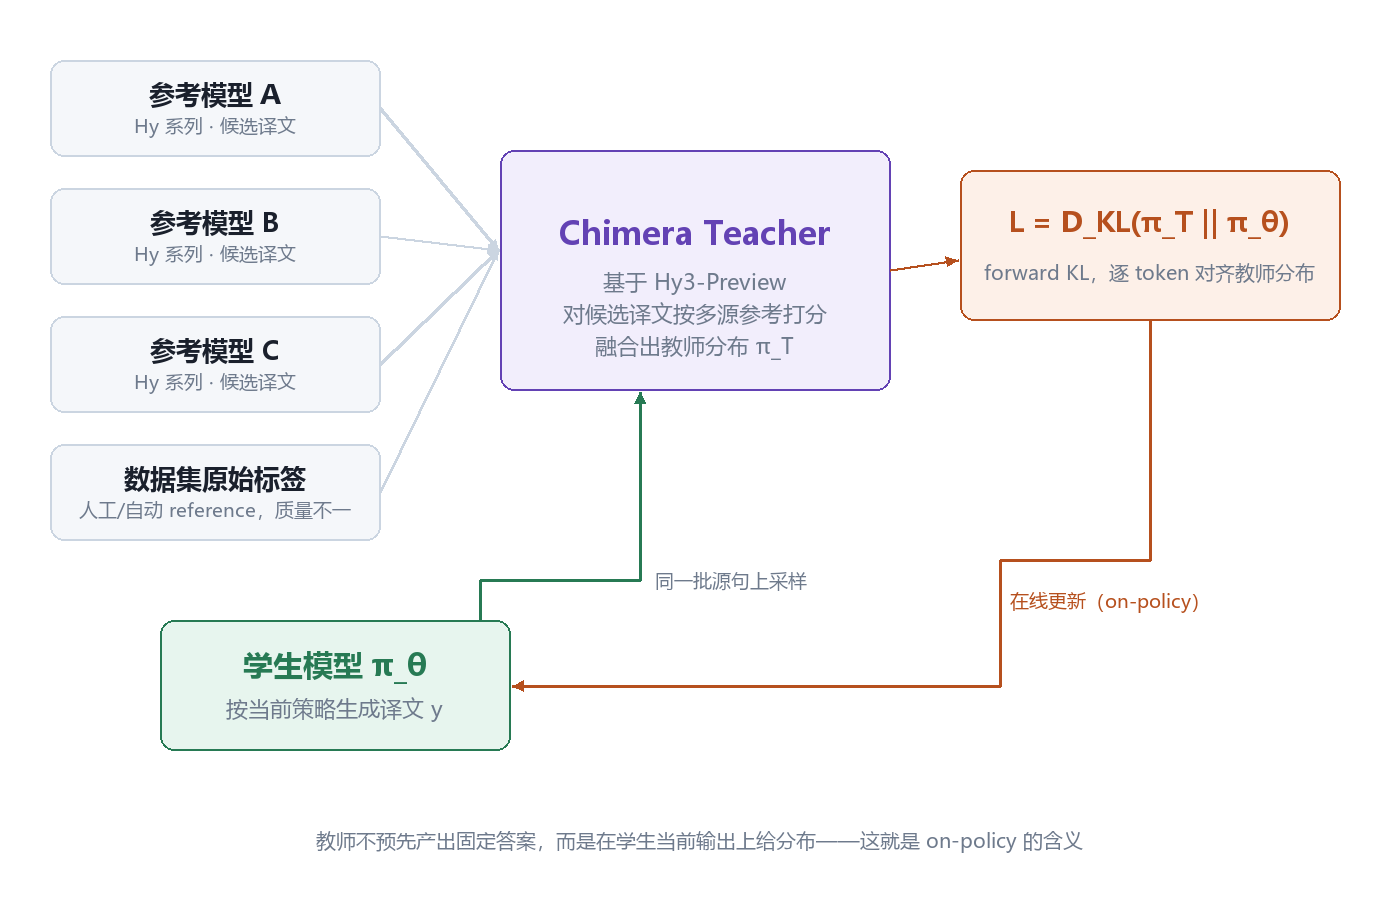
多个参考模型生成的候选译文,加上数据集原始标签,共同构成参考集合 R(x)。
对每个源句 $x$,参考集合 $\mathcal{R}(x)$ 由两部分组成:
- 多个 Hy 系列参考模型各自生成的候选译文;
- 数据集里的原始标签(human reference 或自动构造的 reference)。
Chimera Teacher 以 Hy3-Preview 为底座,把学生输出 $y$ 放到这个多源参考集合里打分,融合出教师分布 $\pi_T(\cdot \mid x, \mathcal{R}(x))$。训练目标是前向 KL:
\[\mathcal{L}_{\text{RG-OPD}} = D_{\mathrm{KL}}\left(\pi_T(\cdot \mid x, \mathcal{R}(x)) \;\Big\|\; \pi_\theta(\cdot \mid x)\right)\]为什么叫 Chimera?论文脚注写得很直白:取自神话里由不同动物拼成的生物,这里指教师信号由多个参考源融合而成。
这个设计有两个现实好处。第一,省掉了一个大教师——不用为了蒸馏再训一个 70B 级的翻译模型。第二,参考集合天然带多样性:不同模型会在“直译还是意译”“术语用哪个”上做出不同选择,教师的分布因此比单一标签更宽。
顺带说一句,Chimera 这个名字在混元系列里不是第一次出现。2025 年 9 月开源的 Hunyuan-MT-Chimera-7B 就是一个“把多个候选译文合并成一个更好译文”的模型。Hy-MT2 的 Chimera Teacher 是同一个思路的延续:多源融合,而不是单点监督。
一个值得注意的选择:前向 KL
前向 KL $D_{\mathrm{KL}}(\pi_T | \pi_\theta)$ 是 mode-covering 的:学生必须覆盖教师分布里所有有概率质量的地方,否则惩罚会很大。反过来,后向 KL $D_{\mathrm{KL}}(\pi_\theta | \pi_T)$ 是 mode-seeking 的:学生只要找到一个教师也认可的模式就行,其他模式可以忽略。
论文没有解释为什么 RG-OPD 选前向、Cross-family OPD 选后向。但从性质上看,这个搭配是合理的:
- RG-OPD 阶段,学生刚进入某个语族,需要尽量吸收教师覆盖的多种译法,前向 KL 逼它别漏;
- Cross-family 阶段,学生要收敛到一个统一策略上,后向 KL 允许它聚焦,不必为每个教师的所有模式买单。
这个对称性是我读论文时觉得最有意思的一处:同一套 OPD 框架,靠 KL 方向完成“扩散”和“收敛”两种相反的操作。
五、家族专属 RL:奖励函数是这套方案里最工程化的部分
RG-OPD 之后,每条分支拿到一个已经适配该语族的模型,接着进入 Family-specific RL Training。
算法是 GRPO,论文写得很明确。但真正值得看的是奖励怎么算——这里能看出团队被 reward hacking 咬过。
第一层:规则预过滤。 译文如果出现严重重复或语言混杂,直接判 0 分,不送进 LLM 评审。这一层几乎不花成本,却拦掉了最典型的退化输出。
第二层:MQM 五维评审。 通过预过滤的译文交给 LLM judge,按多维质量指标(MQM)的错误类型打分,而不是给一个整体印象分:
| 维度 | 检查什么 |
|---|---|
| 术语 Terminology | 术语错误、与术语表不一致、全文用法不统一 |
| 准确性 Accuracy | 误译、过度翻译、漏译、增删内容、未译片段、语言混杂 |
| 语言规范 Linguistic Conventions | 语法、标点、拼写、不可读、语篇与地区习惯 |
| 风格 Style | 与外部参考不一致、语域错误、表达生硬、风格前后不一 |
| 指令遵循 Instruction Following | 目标语言错误、未执行翻译任务、未遵从术语/格式/风格/上下文约束 |
第三层:扣分规则。 从 100 分起扣。致命错误(比如整段用错语言、根本没翻译)直接判 0;重大错误每处扣 10–20 分;轻微错误每处扣 2–5 分。下限为 0。
第四层:长度惩罚。 这一条最能说明问题。给定参考译文长度 $L_{gt}$ 和生成长度 $L_y$:
\[P_{\text{len}} = \min\left(0.5 \times \frac{|L_{gt} - L_y|}{L_{gt}},\; 0.5\right)\]最终奖励是 MQM 分数归一化到 $[0,1]$、减去长度惩罚、再截断到不小于 0。
为什么需要长度惩罚?因为只按质量打分的奖励函数有一个著名漏洞:模型会学会生成极短、极保守、几乎不会出错的句子。 翻译任务里尤其明显——“你好”永远比完整句子安全。长度惩罚把这种策略的收益打掉一半,同时也压制了另一个方向:为凑分而注水。
这套奖励设计不新鲜,但四个层次的分工很清楚:规则过滤管“明显坏的”,LLM judge 管“细微坏的”,扣分规则管“严重程度”,长度惩罚管“钻空子的”。
六、Cross-family OPD:把几个教师合回一个学生
分支训练的代价是部署成本。三条分支就是三套权重,再乘上三个模型规格,运维会崩。
所以 FCPT 的最后一阶段是 Cross-family On-Policy Distillation:把各语族教师的能力迁移回一个统一学生模型。
结构和 RG-OPD 很像,但有两处关键差异。
差异一:教师是路由的。 给定样本 $x$,教师选择函数 $\tau(x)$ 按 $x$ 所属语言家族挑出对应教师:
\[\mathcal{L}_{\text{Cross-OPD}} = D_{\mathrm{KL}}\Big(\pi_\theta(\cdot \mid x) \;\Big\|\; \pi_{T_{\tau(x)}}(\cdot \mid x)\Big)\]差异二:多了一个通用指令教师。 翻译样本走语族教师,通用指令样本走 Hy Instruct 教师。
第二条特别重要。一个只训翻译的模型,很容易在强化翻译能力的同时把“听懂人话”的能力磨掉——用户让它输出 JSON,它给你一段散文。Cross-family OPD 在最后一步把通用指令数据混进来,本质上是在能力合并时做一次抗遗忘。
所以论文把这一阶段称为“统一的多教师蒸馏”:多个语族教师 + 一个指令教师,按样本类型分发。
七、MoE:30B-A3B 省了什么,没省什么
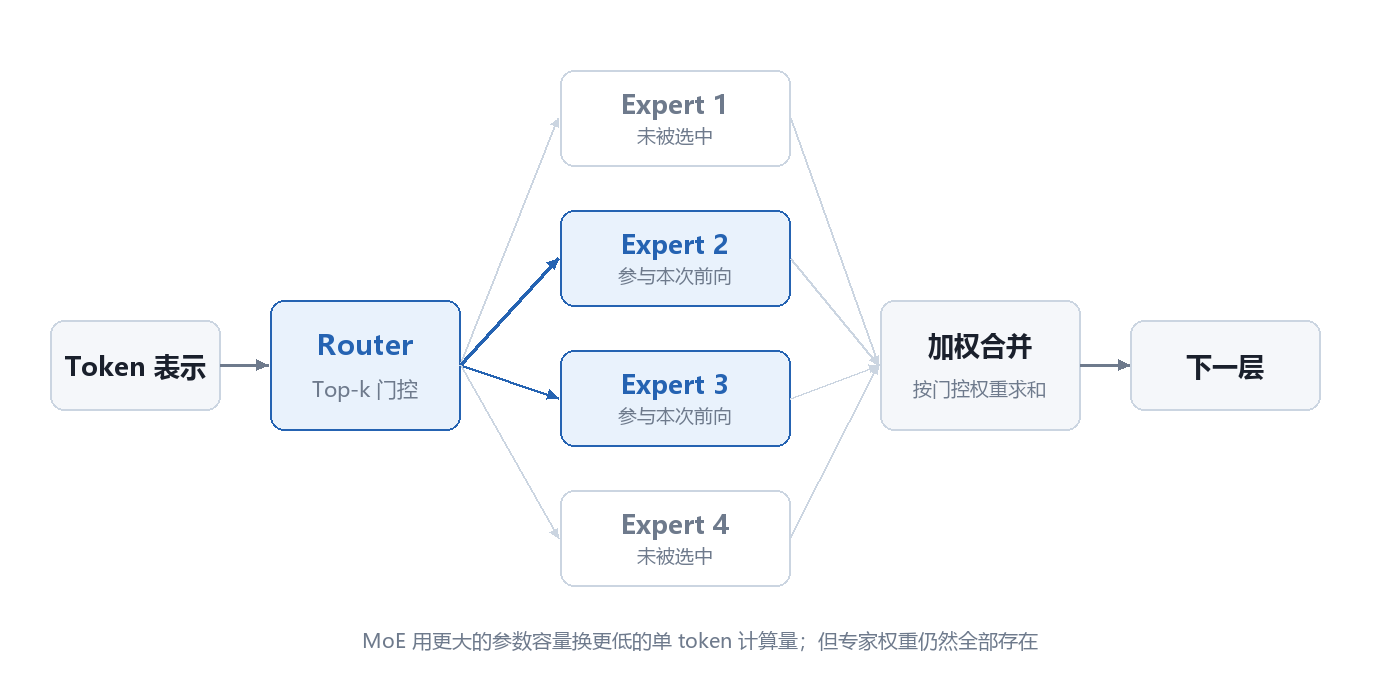
每个 token 只走被路由选中的专家,但所有专家权重都得存着。
Hy-MT2-30B-A3B 用的是混合专家架构。30B 是总参数,A3B 是单 token 激活参数约 3B。
论文给的理由很直接:继续堆 dense 参数能提升复杂翻译场景的理解和表达能力,但推理成本受不了。TransGemma-27B 这类翻译模型是 dense 的,服务端部署很贵。MoE 让模型保留 30B 的容量,单 token 计算量却接近 3B 的模型。
但这里必须泼一盆冷水,很多宣传会含糊过去:
激活参数 ≠ 部署显存。 3B 激活只说明一次前向算了多少,不说明要装多少。30B 的专家权重、KV Cache、运行时缓冲、框架开销,一个都少不了。按 3B dense 模型去估算 30B-A3B 的显存,一定会翻车。
MoE 省的是算力,不是容量。这个区别在端侧尤其致命:手机上跑 MoE,权重照样要占存储,只是每次少算一点。
八、指令遵循:七类模板和一条 JSON 红线
Hy-MT2 把翻译指令整理成了可枚举的模板。README 里给了中英对照的七类:
| 类型 | 约束的是什么 |
|---|---|
| Default Translation | 只输出译文,不加解释 |
| Terminology | 指定术语映射,全句保持一致 |
| Style | 指定风格(文言文、口语、正式书面……) |
| Personalization | 用户偏好列表(简洁、术语保留英文等) |
| Delimiters | 分隔符数量、位置、不可转义 |
| Structured Data 1 | JSON/HTML 等结构锁定,只译可见文本 |
| Structured Data 2 | 结合背景信息消歧后再译 |
结构化数据这一类最贴近工程实践。一个典型的请求长这样:
{
  "title": "User Management",
  "description": "Manage user accounts for ${tenant}",
  "button": "Save",
  "placeholder": "Enter your username"
}
用户的要求是:保持结构、只译值、不动 key、不动 ${tenant} 这类占位符。
模型确实能做到——但这里有一条必须说清楚的红线:模型能遵循结构化指令,不等于它可以替代解析器。 生产环境里,输出必须再过一遍 JSON 解析、Schema 校验和占位符比对。原因很简单:模型的输出是概率性的,而程序结构是二值的。一次花括号丢失就可能让整个 i18n 流水线挂掉。
九、IFMTBench:把“听话”变成可计算的分数
传统翻译评测(BLEU、COMET、xCOMET)只看语义等价。问题是:一段丢掉了术语表约束、破坏了 JSON 结构的译文,语义可能完全正确,分数照样很高。
IFMTBench 就是来补这个洞的。它是独立论文(arXiv 2605.28218),随 Hy-MT2 一起开源。
规模:7,344 条,其中 4,506 条单约束、2,838 条多约束;覆盖中、英、德、法、日、韩、西七种目标语言;指令本身也用这七种语言各写一遍——这一条设计很关键,它把“看不懂指令”和“翻不好”分开了。
约束分成七个维度,按性质又分两类:
| 类型 | 维度 | 判定方式 |
|---|---|---|
| 硬门控 | 术语表、结构化数据、布局/占位符、代码保留、代码标签 | 规则检查,0/1 |
| 软约束 | 风格、上下文一致性 | rubric LLM judge,0–1 |
聚合方式是这套评测最巧妙的地方:
\[\text{IF-Score}(p) = \underbrace{\prod_{c_g \in \mathcal{G}_p} s(c_g)}_{\text{gating product}} \times \underbrace{\frac{1}{|\mathcal{S}_p|}\sum_{c_s \in \mathcal{S}_p} s(c_s)}_{\text{mean of soft scores}}\]门控项是连乘:只要有一条硬约束失败,整条样本直接归零。论文给的理由是工程直觉——结构坏掉的译文,风格再优美也没法用。而软约束取均值。
这个设计同时否掉了一种常见的作弊方式:如果采用加法平均,模型可以用高分风格项掩盖硬约束失败。做奖励信号时,这种掩盖是致命的。
评测还额外报了第二个轴:xCOMET-XXL 翻译质量分。两个轴分开看,才能识别出“译文很流畅但压根没听指令”的模型。
结果里最有信息量的三个现象
| 模型 | 单约束 IF | 单约束 xCOMET | 多约束 IF | 多约束 xCOMET | 总分 |
|---|---|---|---|---|---|
| Hy-MT2-1.8B | 76.76 | 80.74 | 57.61 | 67.80 | 69.36 |
| Hy-MT2-7B | 89.73 | 84.29 | 72.67 | 72.76 | 83.14 |
| Hy-MT2-30B-A3B | 91.94 | 85.55 | 75.80 | 74.79 | 85.70 |
| Qwen3.5-27B | 82.48 | 82.64 | 78.81 | 69.29 | 81.06 |
| gemma4-31B | 84.00 | 83.56 | 72.64 | 69.50 | 79.61 |
| Gemini 3.1 Pro | 91.95 | 83.31 | 84.53 | 69.65 | 89.08 |
第一,单约束上 30B-A3B 已经追平 Gemini 3.1 Pro(91.94 对 91.95),多约束上却差 8.7 分。 这个转折点比总分更有意思:翻译专用后训练能把单条约束做到极致,但“同时追踪多条异质约束”仍然是前沿闭源模型的优势。多约束退化率 17.6% 对 8.1%,差距被放大了一倍多。
第二,指令遵循对模型规模的敏感度,远高于翻译质量。 Qwen3.5 从 0.8B 到 27B,单约束分从 40.92 涨到 82.48,多约束从 7.46 涨到 78.81——十倍。而 xCOMET 那条线只从 70.21 走到 82.64。也就是说,2B 以下的模型基本没有多约束能力,不是“差一点”,是“不会”。
第三,难度分布很集中。 术语表和结构化格式是两道坎,布局和代码保留类约束则接近饱和——几乎所有模型都能保住分隔符,但保住术语表一致性的少得多。这和实际业务里的痛点完全对得上。
论文还提了一个反向指标:单约束下 xCOMET 减 IF 分。正值意味着“译文流畅但约束没听”,负值意味着“为了守约束牺牲了流畅度”。Hy-MT2 的 7B 和 30B-A3B 是负值(−5.44、−6.39),1.8B 反而是 +3.98,Gemini 是 −8.64,而 gemma4 和 Qwen 基本是正的。这个符号差异,比任何单项排名都更能说明“训练目标偏向哪边”。
十、量化:4 个权重怎么塞进 5 个 bit
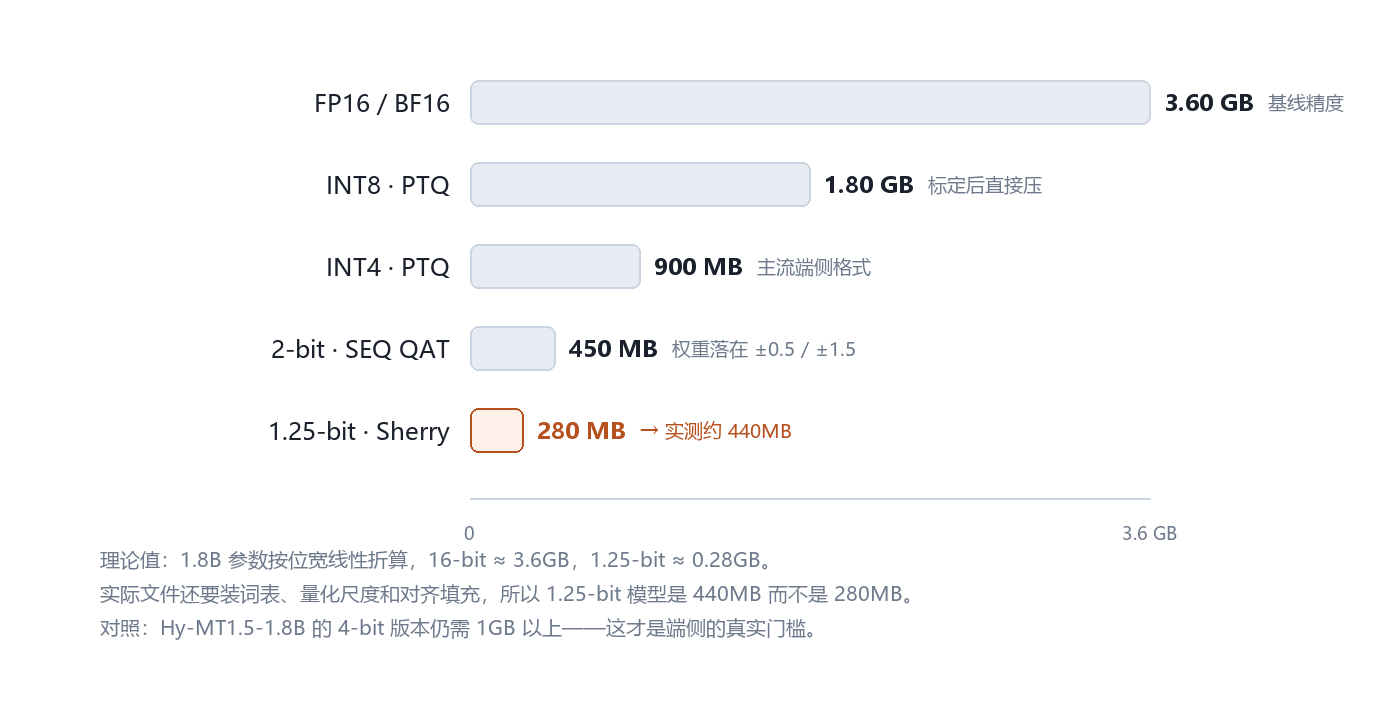
1.8B 模型在不同位宽下的理论体积,以及实测的 440MB。
Hy-MT2 提供了五档精度,但实现路径分三种:
| 档位 | 方法 | 关键点 |
|---|---|---|
| FP16 / 8-bit / 4-bit | PTQ(训练后量化) | 少量标定数据估计分布,不重训 |
| 2-bit | QAT + SEQ | 权重压到 ±0.5 / ±1.5 四个值 |
| 1.25-bit | QAT + Sherry | 稀疏三值 {-1, 0, +1},3:4 稀疏 |
2-bit 用的 SEQ(Stretched Elastic Quantization)把权重映射到 ${-1.5, -0.5, +0.5, +1.5}$。四个电平、等间距、无零值——这是有意为之:没有零,意味着每个权重都必须表态,量化误差被摊到符号上而不是被零吸收。
1.25-bit 用的 Sherry 更有意思。它把权重压成三值 ${-1, 0, +1}$,然后加一条硬约束:每 4 个权重一组,恰好 1 个零、3 个纯符号位。
这个约束带来两个后果:
- 存储上,一组 4 个权重只需要 5 bit(3 个符号位 + 2 bit 记录零的位置),平均 1.25 bit/权重。这是“1.25-bit”这个名字的由来,不是每个权重独立存 1.25 个二进制位。
- 计算上,5 bit 对齐是对 SIMD 友好的粒度。论文专门对比了常规 2-bit 打包和 1.67-bit 不规则打包,结论是 1.25-bit 的规则稀疏在压缩率和推理效率之间更平衡。
QAT 阶段还叠了蒸馏。 低精度模型当学生,高精度模型当教师,损失是 LM loss 加 KL 散度。KL 部分同时用前向和后向,权重不写死,而是按教师对每个 token 的置信度动态调整。这个细节很小,但很实用:高置信 token 用后向 KL 让学生大胆对齐,低置信 token 用前向 KL 让学生别乱猜。
实际收益:1.8B 的 1.25-bit 版本约 440MB,在 Apple A15 上比 Hy-MT1.5-1.8B 的 4-bit 快约 1.5 倍。
注意这里的对比基准是上一代的 4-bit,不是本代的 FP16。这个对比方式是对的——端侧用户关心的是“换代之后有没有更快更小”,而不是“量化损失了多少”。
十一、部署:四条路径,各自的坑
官方给了四套推理方式,成熟度差别很大。
Transformers
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_path = "tencent/Hy-MT2-30B-A3B"
tokenizer = AutoTokenizer.from_pretrained(model_path, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    model_path, dtype=torch.bfloat16, device_map="auto", trust_remote_code=True
).eval()

prompt = "将以下文本翻译成英语,注意只需要输出翻译后的结果,不要额外解释:\n\n今天天气真好。"
messages = [{"role": "user", "content": prompt}]
inputs = tokenizer.apply_chat_template(
    messages, add_generation_prompt=True, return_tensors="pt"
).to(model.device)

with torch.no_grad():
    outputs = model.generate(**inputs, max_new_tokens=4096)
print(tokenizer.decode(outputs[0][inputs["input_ids"].shape[-1]:], skip_special_tokens=True))
需要 transformers>=5.6.0。
一个容易踩的点:采样参数按规格分两套。 1.8B 和 7B 推荐 temperature=0.7, top_p=0.6, top_k=20, repetition_penalty=1.05;30B-A3B 推荐 temperature=0.7, top_p=1.0, top_k=-1, repetition_penalty=1.0。而且模型没有默认 system prompt——别自作主张塞一个进去,那会改变它的输出分布。
vLLM / SGLang
vllm serve tencent/Hy-MT2-30B-A3B --tensor-parallel-size 1
python3 -m sglang.launch_server --model tencent/Hy-MT2-30B-A3B --tp 1
两条命令背后都有一个前提:从源码构建。README 给的是 clone + editable install 的流程,不是 pip install vllm。这意味着升版本时不能只看 pip 的解析结果。
llama.cpp
GGUF 版本能跑,但依赖 STQ kernel,实现在 llama.cpp PR #22836。也就是说:任意版本的 llama.cpp 不一定能读全部 Hy-MT2 GGUF。
还有一个发布节奏上的细节:README 的模型表里,30B-A3B 只列了原始版和 FP8,但 Hugging Face 上已经能找到 30B-A3B-GGUF,社区还有 MLX 的 4-bit 转换。文档表格往往落后于实际发布。
十二、能不能接着训
可以,而且路径给得很全:全参微调、LoRA、DeepSpeed ZeRO 多种配置、LLaMA-Factory 集成。
这对企业场景的意义在于,Hy-MT2 不只是“一个能用的翻译模型”,而是“一个可以变成自家翻译模型的底座”:
Hy-MT2 基础模型
      │
      ├─ 企业术语表 + 历史译文
      ├─ 领域语料(医疗/法律/金融)
      └─ 人工审核过的平行句对
      │
      v
   LoRA / 全参微调
      │
      v
   IFMTBench + 业务集评测
      │
      v
   企业翻译服务
但要说清楚:微调不能替代术语管理。术语一致性靠的是术语表在推理时进 prompt,加上输出后的校验,而不是指望权重里“记住”每一个词。微调真正改变的是表达习惯和领域语感,不是精确的字符串映射。
十三、局限
按重要性排:
1. 多约束指令仍然是短板。 30B-A3B 单约束追平 Gemini,多约束差 8.7 分。复杂业务场景里,“同时守住术语、结构、风格、格式”这类需求,目前还不能完全交给模型。
2. 评测分数是项目方报告值。 解码参数、judge 模型、prompt 模板都会影响结果。IFMTBench 用 gpt-oss-120b 在 temperature 0 下当 judge,换一个 judge 排序可能变化。
3. 极低比特不是无损。 1.25-bit 的三值约束对术语密集、低资源语言、长句结构的影响需要单独测。论文给的是总体结果,不是每个语种的结果。
4. MoE 不省显存。 见第七节。
5. 结构化输出必须外部校验。 见第八节。
6. 语言数量的口径要对齐。 论文和 README 都写 33 种语言(对应 FLORES-200 的 33 种),但 README 的语种表实际列了 38 个条目——多出来的是繁体中文、粤语、藏语、维吾尔语等。“支持 33 种语言”这句话,按哪个口径理解,会影响你对它覆盖面的判断。
十四、我的判断:多教师蒸馏到底蒸馏了什么
这套方案里我最想弄明白的,不是“怎么训”,而是多个教师的能力究竟以什么形式进入了学生。
从表面看,Cross-family OPD 只是让学生去拟合一个路由后的教师分布。但这里有一个隐含的张力:三个语族教师的策略在两两重叠的区域(比如英译中,既是西欧分支也是东亚分支的输入侧)可能给出不同的偏好。学生只有一套参数,它必须在这几个分布之间找到一个折中。
这个折中发生在哪里?是输出层概率的加权平均,还是中间表示层面的某种合并?论文没有回答,而这正好是可以测的:
- 用 NNsight 或 pyvene 在 Cross-family OPD 前后取同一批样本的隐藏状态,看语族间的表示距离是变大还是变小;
- 对比学生和各个教师在特定层的表征相似度(CKA、procrustes),看它更像“三个教师的平均”,还是“按语族切换的子空间”;
- 在 MoE 模型上,直接看路由:不同语族的 token 是否自然聚到不同的专家上——如果是,那 FCPT 的分支结构其实被 MoE 的路由“记住”了。
第三个问题尤其有意思。如果 MoE 的路由模式本身就复现了语言家族的划分,那 Family-Centric Post-training 可能不只是训练技巧,而是在利用架构里本来就存在的归纳偏置。 这个假设用现成的工具就能验证,不需要重训模型。
顺带说,这套“先分头训专家、再蒸馏合并”的范式,可迁移性比翻译本身大得多。任何“多分布混合训练互相拖累”的场景——多领域、多任务、多模态——都可以套用。真正稀缺的不是算力,而是怎么定义“分”的边界:Hy-MT2 按语言家族分,是因为语言家族有语言学依据;换一个场景,边界从哪来?
项目与资料
- GitHub 仓库
- 中文 README
- Hugging Face 模型集合
- Hy-MT2 技术报告(arXiv 2605.22064)
- IFMTBench 论文(arXiv 2605.28218)
- IFMTBench 数据集
- AngelSlim 压缩工具链
模型采用 Apache-2.0 许可;IFMTBench 有独立的许可文件,商用前分别核对。本文数字来自论文与仓库 README,性能结论对应论文的评测配置,实际部署会受硬件、精度和采样参数影响。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- Blender Kiln:AI 建模缺的不是生成能力,是交付前的度量
- CineCode:每一帧都是时间的纯函数,所以电影可以被检查
- OhMyGame:AI 生成游戏不难,难的是让它自己发现游戏跑不起来
- GPT-2 的一次前向:一条 768 维的向量,被改写 12 次,变成 50257 个分数
- SAELens:重建得越准,特征越不一定是真的
- TokenEconomizer:Coding Agent 的成本按仓库累积,不按任务计价
- Transformer Explainer:把 GPT-2 塞进浏览器,让模型边算边解释自己
- Boubou:本地语音 AI 缺的不是模型,是一层能借给全屋的运行时
- NNsight:把干预写进前向传播,让同一段代码在 405B 模型上跑
- Safetensors:用 8 个字节和一段 JSON,重新设计大模型的权重文件