HelixHarness:Harness 工程的两份契约,一份写成了协议,一份还没有数据
一个创建于 2026 年 10 月 27 日的项目,到今天三周,439 个 star、61 个 fork,Apache-2.0,版本号已经写到 1.0.0。
这些数字都不重要。有意思的是它的目录结构:helixharness/reference/ 底下躺着 24 个协议文件——加载协议、评测协议、遥测协议、子代理运行时协议、扫描代理协议、退出码约定、版本策略……一个“插件”而已,写得像一份需要双方签字的规范。
它想解决的事可以一句话说完:让 AI 编程工具按你的项目规矩办事,而不是按它自己见过的代码办事。Codex 和 Claude Code 已经能把代码写出来,缺的不是能力,是“这个项目里什么不能做”、“验收要拿什么证据”、“改完的规矩到底有没有变好”。
- 仓库:didi/helixharness(Apache-2.0,Python 3.10+,插件与平台两个子项目)
- 指南:
docs/user-guide.md/ 中文版 - 示例:
examples/(自带一个 starter 工程、一份需求,以及一个独立的验收脚本——不是让 agent 自己给自己打分)
本文只讲一件事:它把两件事写成了契约——“AI 该读什么”和“Harness 改得对不对”。第一份已经落在协议里,第二份在公开仓库里还只有形状。
一、Harness 是四个目录,不是一句口号
“上下文工程”这个词已经被用坏了。HelixHarness 的做法是把它拆成四个具体目录,每个目录回答一个问题:
| 部分 | 回答的问题 | 落在哪 |
|---|---|---|
| Knowledge | 这个系统怎么运转?业务规则是什么? | docs/knowledge/ |
| Harness | 哪些规则和架构边界 agent 必须遵守? | docs/harness/ |
| Specs | 这次要做什么?拿什么证明做完了? | docs/specs/ |
| Hooks | 关键阶段跑哪些检查? | docs/hooks/ + 宿主自己的 hook 配置 |
这个分法本身不新鲜,很多团队也在做。真正值得看的是它给前两个目录配了一份加载协议:不是“你把文档放那儿,模型自己会读”,而是规定死“什么时候读哪一份、什么情况下不许读”。
顺带说个容易漏掉的背景:项目出自滴滴的金融技术团队,名字里的 Helix 指的是 DNA 双螺旋——他们管这叫 engineering DNA。这解释了为什么整篇文档里的例子都带着金融业务的谨慎(退款、幂等、状态机),也解释了为什么它那么执着于“留证据”。
二、契约一:index 就是路由器
helixharness/reference/loading-protocol.md 是整个仓库里我最愿意推荐读的一份文件。它短,但每一条都可以被检查。
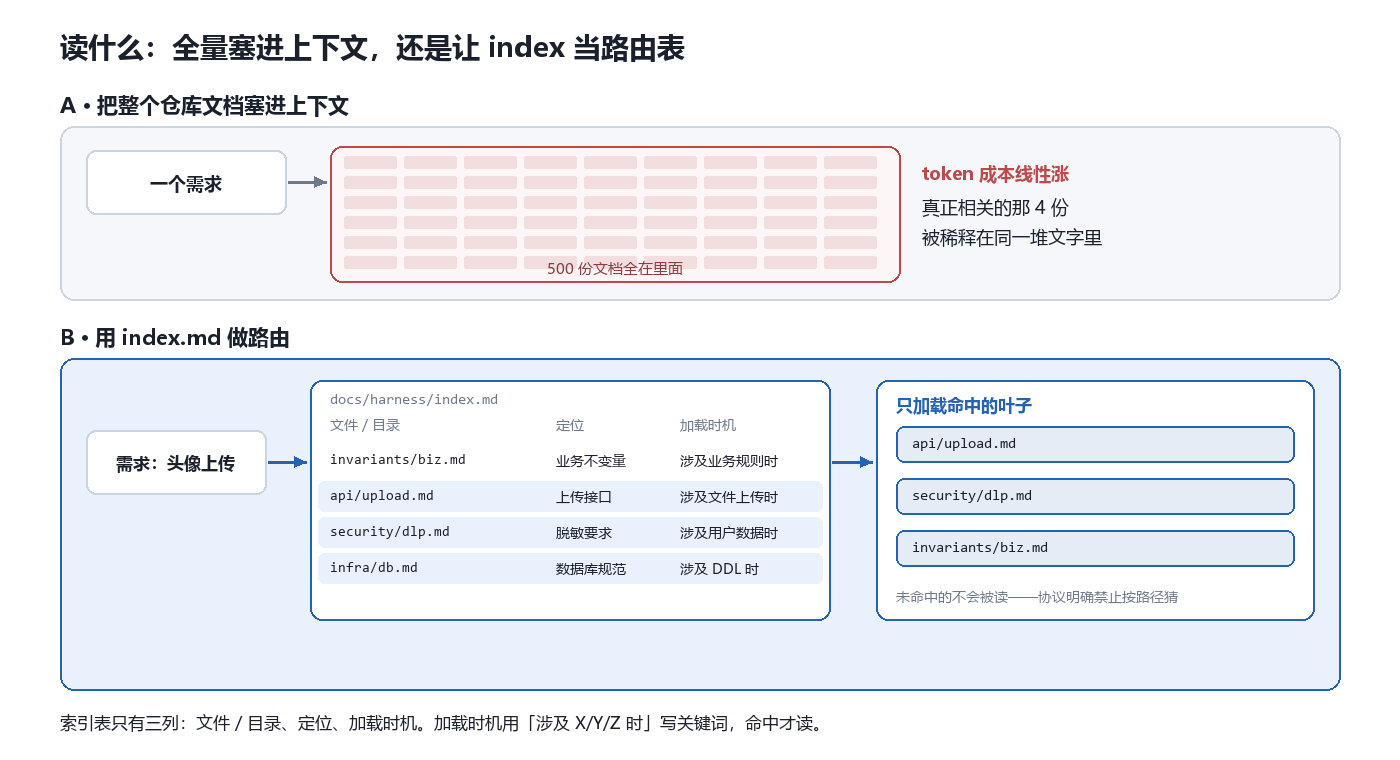
上半是“把 500 份文档全塞进去”的常见做法;下半是协议要求的做法:先读索引,只加载命中的叶子。
规则本身只有几条,但每条都很硬:
1. 每个目录树只有一个根 index.md,格式是三列表。三列分别是“文件 / 目录”“定位”“加载时机”。加载时机必须写成“涉及 X/Y/Z 时”的形式,关键词用斜杠分隔。
2. 只读命中的叶子。逐行评估,命中才读;另外支持一个 必读 标记,写在加载时机列里(例如 propose/review 必读),碰到就无条件加载。
3. 未索引的文件不会被加载,而且禁止猜路径。协议原话是“Agent 不得跳过 index 凭路径猜测读取”。这一条是整个设计的支点——它把“读什么”从模型的自由裁量变成了可审计的事实。
4. 会话内用时间戳去重。首次加载后用 find + stat 取目录最新修改时间做快照;下次再要加载同一目录,先比时间戳,没变就声明“沿用已加载内容”,变了才重读。
5. 两个例外:docs/specs/** 和 docs/hooks/** 由命令直接指定读取,不走索引;而 Archive 阶段完全不加载 harness,只按实际实现和验证报告去挑 knowledge。
第 5 条里的“Archive 不读 harness”值得单独说:归档的时候你不需要知道规矩是什么,你只需要知道这次实际改了什么、证据是什么。这是一个很小的设计,但它避免了“用规则去套实现”的循环论证。
三、这份契约的边界在哪
我欣赏这份协议,恰恰因为它敢把代价写在明面上:
- 索引是要人维护的。新增一份文档忘了加进 index,它对 agent 就等于不存在——不会报错,不会提醒,只是永远不被读到。这比“读了但没读对”更难排查。
- 关键词匹配是字面的。加载时机写成“涉及文件上传时”,那需求里说“头像”、“附件”、“图片”就不一定命中。索引的质量直接等于命中率的上限。
- 它只管两个目录。协议明确写着“本协议只管
docs/harness/和docs/knowledge/两个目录树”,其它地方怎么读不归它管。
也就是说,这套东西不解决“知识怎么产生”,只解决“知识怎么被有纪律地取用”。前半段要靠人写,后半段才是它的功劳。
四、契约二:冻结版本,跑同一组 Case
第二份契约解决的问题是:你改了 Harness(加了一条规则、换了一个加载策略、加了一道门禁),怎么知道它变好了?
直觉答案是“用几天看看”,但那就没法比较了。helixharness-platform 的做法是把软件工程里最老的办法搬过来:
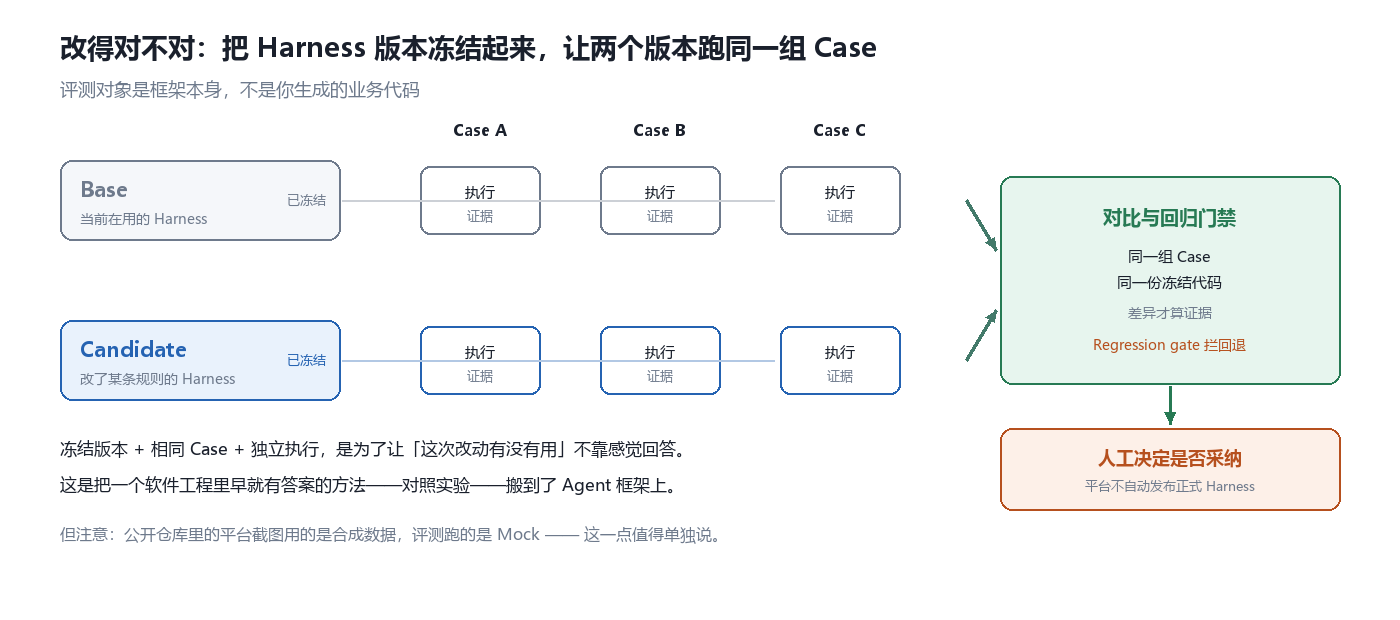
Base 是当前在用的版本,Candidate 是改过的版本,两边都冻结到具体 commit,跑同一组 Case,差异才算证据。
几个关键约束:
- 两个版本都冻结。不是“边改边比”,而是各自固定在一个 commit 上。
- Case 也必须冻结。否则 Case 变了,差异就说不清是谁造成的。
- 有 regression gate。不止看“新的更好”,还要拦住“新的把原来能过的弄坏了”。
- 采纳必须人工。官方措辞很克制:平台不会自动发布正式 Harness,提案和候选变更都要人看。
而且它明确划了边界:评测对象是 Harness 框架本身,不是你生成的业务代码。这句话挡掉了一类误用——别把它当成“给 AI 写的代码打分”的服务。
这套设计我认为是对的。Harness 是一段跑在模型外面的程序,它有逻辑、有分支、有失败模式;那它就理应像代码一样被评测,而不是靠“用起来感觉好多了”。
五、数据从哪来:默认关闭的账本
要比较,就得有数据。这里的设计比草稿里描述的更谨慎,也更值得抄。
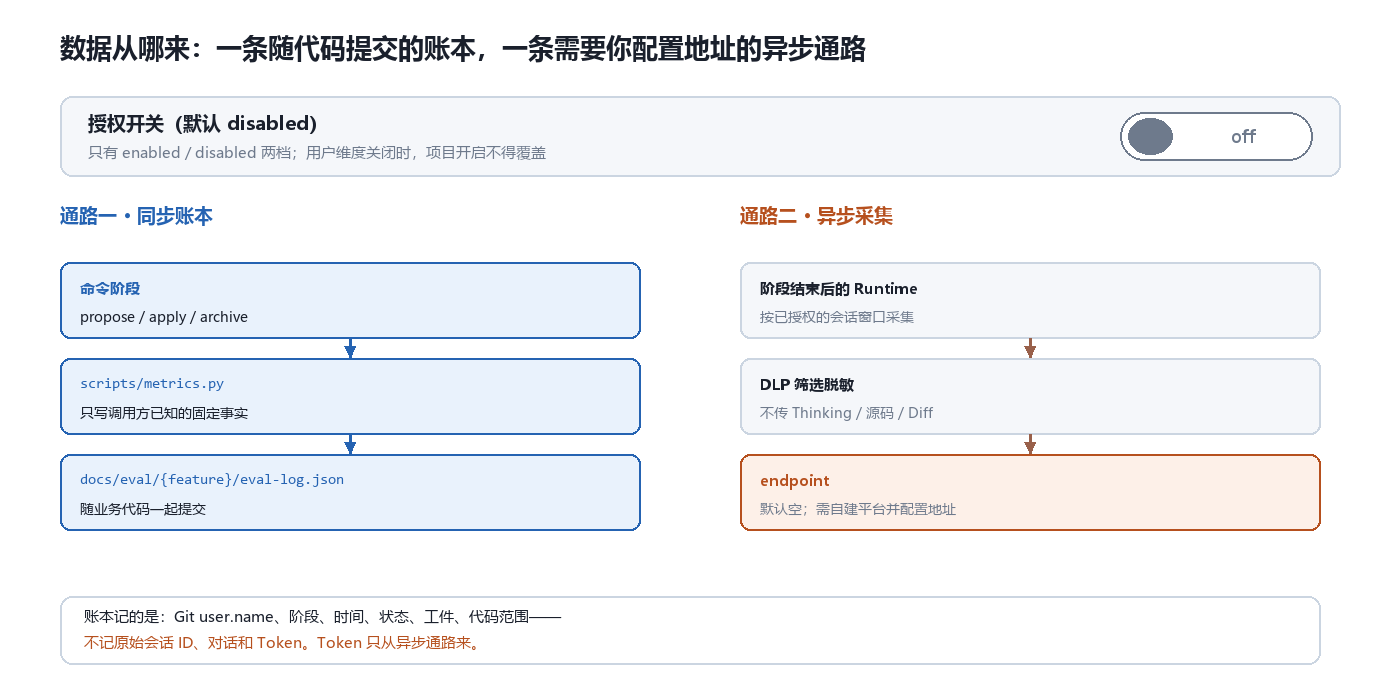
同步账本跟着业务代码走;异步采集要额外的授权与地址。两条路都默认关着。
同步这条写 docs/eval/{feature}/eval-log.json,随业务代码一起提交。它记的是“调用方已知的固定事实”:Git user.name、阶段、时间、状态、工件、代码范围。协议反复强调它不读会话、不调模型、不阻塞业务。
异步这条才涉及 token 和工具调用统计,走“阶段结束后按已授权的会话窗口采集 → DLP 筛选脱敏 → 投递到 endpoint”。而 endpoint 的默认值是空的:你得自己把平台跑起来、配好地址,它才可能上报。协议里甚至专门澄清了一句——“配置地址不代表授权”。
还有三个细节说明作者是真想过:
- 授权只有
enabled/disabled两档,人维度关掉时项目开不掉(会输出WARN:telemetry_user_scope_disabled)。 - 项目指纹是
prj_ + sha256("helixharness-project-v1\0" + 规范化仓库标识)[:16],SSH 和 HTTPS 形式的同一个仓库会归一到同一个指纹;没有 origin 时只在内存里算,绝对路径不落盘。 - 关闭后 30 天再提醒一次,开启后 180 天确认是否维持。提醒时间只由脚本算,agent 不许自己构造缓存。
数据这件事上,“默认关、要地址、要确认、可解释”四条同时做到的项目不多。如果只读 README,你会漏掉这一整层。
六、但是:公开仓库里没有真实评测数据
现在必须说清第二份契约的成色。
翻到 README 讲平台的那一段,三张截图下面有一句话:
All three show the real platform UI with synthetic demonstration data. Evaluation uses Mock execution; the evolution view shows the evidence loop and synthetic evidence summary. These are interface examples, not measured improvements or real model results.
再往下关于 Demo 的说明更直接:内置 Demo 会禁用后台演化与模型分析,而且不生成演化假设——演化页的截图展示的是“概览”,没有生成的 hypothesis 和 candidate。
所以现状是:
| 部分 | 状态 |
|---|---|
| 加载协议(契约一) | 完整协议 + 可执行的规则,已落地 |
| 版本对照机制(契约二) | 机制、冻结、回归门禁、人工采纳都写了 |
| 真实评测结果 | 没有。公开的是合成数据与 Mock 跑出来的界面 |
| 真实模型跑出来的改进证据 | 没有。README 明确说那需要你自己的模型服务与校准过的 Case |
这不是造假——它把话说得很清楚,甚至反复强调“这是界面示例,不是实测提升”。但这意味着:你无法从公开仓库判断这套评测闭环到底有没有用。它证明了形状,没证明效果。
我理解这么做的现实约束:真实评测要花真金白银跑模型,Case 要按团队业务校准,结果也不适合放在一个开源仓库里当卖点。但作为读者,这就是我给它打折的地方——它最有野心的那部分,恰好是唯一没有公开证据的那部分。
七、那已经落地的那一半值多少
把评测放一边,Archive 这一环是实打实的设计:它不自动写库。
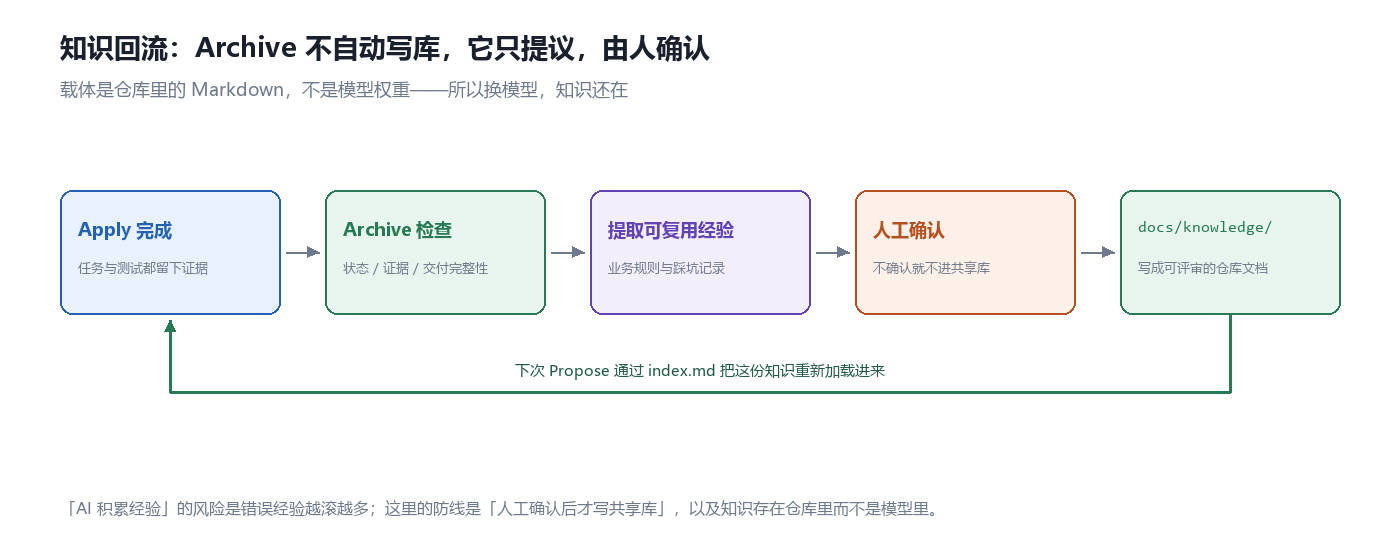
Apply 留下证据 → Archive 检查完整性 → 提取可复用经验 → 人工确认 → 写成 docs/knowledge/ 下的仓库文档 → 下次 Propose 通过 index 重新加载。
这条链上有三个值得学的判断:
第一,知识的载体是仓库里的 Markdown,不是模型权重。所以换模型、换 agent、换供应商,知识都还在。README 那句口号说得挺准:the code ships, the knowledge stays。
第二,“积累经验”必须有一道人工闸门。AI 自动总结的“经验”里混进一条错的,后面每个任务都会继承它,而且越滚越像真的。HelixHarness 的防线就是“Archive 只提议,用户确认才写进共享库”。
第三,知识要能被索引,否则等于没写。这又回到契约一:新写的 knowledge 文件必须进 index.md,否则下一次 Propose 永远不会读到它。两份契约在这里咬合上了。
八、局限
按重要性排:
- 评测闭环没有公开的真实数据。见第六节。这是最大的一个缺口,而且它影响的正是这个项目最想讲的差异化。
- 只有两个宿主。Codex 和 Claude Code。Roadmap 里写着要支持更多 agent、要把工作流阶段做成可配置——也就是说现在的 Propose → Apply → Archive 是固定的三阶段,改不了顺序。
- 索引维护是纯人工成本。漏登记 = 静默失效,没有校验、没有告警。团队越大,这个成本越真实。
- Hooks 不是它自己保证的。官方说得很清楚:hook 的实际执行依赖宿主运行时和工作流配置,并非所有检查都由单一机制兜底。所以“门禁”这件事,你仍然要自己验证。
-
--loop不管发布部署。它串起 Propose → Apply → Archive,遇到需要决策或阻塞会停下来等人——但发版、上线这一段不在里面。 - 平台是给框架维护者的,不是给开发者的。日常开发只需要插件;想跑平台得自己起服务、配地址、准备 Case 和模型服务。这条路径对个人开发者偏重。
- 24 个协议文件的学习成本。好处是可检查,坏处是:要真正接手改它,你得先读完这一堆规范。
九、我的判断
HelixHarness 真正有价值的地方,不是它给了 9 个命令(init / propose / apply / archive / bug-fix / ut / update / status / config),而是它把两件通常靠“感觉”的事变成了可检查的东西:
- AI 读了什么 → 有索引、有加载时机、有“不许猜路径”的硬规则;
- Harness 改得对不对 → 有冻结版本、有同一组 Case、有回归门禁、有人工采纳。
第一条已经写成了协议,可以照着抄。第二条目前只有骨架——但骨架本身也是一种贡献:它至少指出了一条正确的路,即“Harness 的改动应该被对照测量,而不是被主观赞美”。
如果要继续验证这条路,我会盯三件事:
- 有没有人公开一份真实的 Base/Candidate 结果。哪怕只有三个 Case、只有 token 和返工率两个指标。没有这个,这套闭环就无法被外部信任。
- 索引的命中率怎么衡量。现在只有“命中才读”的规则,没有“该命中的有没有命中”的度量。这是可以做的:拿历史需求回放,看本应加载的叶子有没有被加载。缺了这一步,索引质量永远是个体感。
- 三阶段固定会不会成为瓶颈。不同团队的研发流程差异很大,可配置工作流在 roadmap 上——但流程一旦可配置,契约二的对照实验就要重新设计(Case 得跟着流程走)。这两件事是耦合的。
第一点是我最在意的,也是它和我最近在读的那条线的接口:NNsight / pyvene 那套东西的价值,在于它让“模型内部发生了什么”变成可测量、可归因的量。
同一个动作在这里重复了一遍:先让“这次改动有没有用”可以被对照测量,你才有资格说它在变好。HelixHarness 把这件事写成了流程,但还没交出那份测量结果——这不是它一个项目的问题,是整个 AI 工程化领域目前最普遍的空白。
项目与资料
- 仓库:github.com/didi/helixharness(Apache-2.0;
helixharness/插件 +helixharness-platform/平台,两个子项目都能单独安装) - 加载协议:
helixharness/reference/loading-protocol.md - 统计协议:
helixharness/reference/eval-protocol.md - 使用指南:
docs/user-guide.md/ 中文 - 安装与平台支持:
docs/installation.md、docs/platform-support.md - 示例:
examples/README.md
# Codex
codex plugin marketplace add https://github.com/didi/helixharness.git
codex plugin add helix@helixharness-marketplace

# Claude Code
claude plugin marketplace add https://github.com/didi/helixharness.git
claude plugin install helix@helixharness-marketplace
/helix:init
/helix:propose task-filter ./requirements/task-filter.md --loop
--loop 会把 Propose → Apply → Archive 串起来跑,遇到需要决策或阻塞时停下来等人,不包含发布与部署。也可以三个阶段分开执行。
数据来源与口径:star / fork / 创建时间取 GitHub API(2026-11-17);reference/ 下 24 个协议文件、9 个命令、1.0.0 版本号、目录结构均取自仓库当前文件树;三列表索引、必读标记、时间戳去重、“不得跳过 index 凭路径猜测读取”、Archive 不加载 harness、协议只覆盖两个目录,均引自 loading-protocol.md 原文;账本路径、默认关闭、WARN:telemetry_user_scope_disabled、项目指纹算法、30/180 天提醒、“配置地址不代表授权”引自 eval-protocol.md 原文;平台截图为合成数据、评测使用 Mock、Demo 不生成演化假设,引自 README 的平台与 Demo 章节原文;Roadmap(更多 agent、可配置工作流)、示例自带独立验收脚本引自 README。草稿说 Observability 记录 Token 消耗,实际同步账本明确不记 Token(Token 只来自异步通路),本文以协议原文为准;草稿提到评测使用“模型 Judge”,我在 README 与上述协议中未能确认,故本文不写。“索引命中率可度量”“两件事是耦合的”是我的判断,已在正文标注。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- vLLM:每次重写,改的都是同一本显存账
- Diagram Design:50 种图表是目录,能拒绝你的检查才是产品
- gpu-unlock:GeForce 的半速矩阵算力,写死在八个 4 位字段里
- Octop:单进程是它的地基,也是它的天花板
- VoiceStudio:把 ElevenLabs 搬回本地之后,账单换成了许可证
- DroidDeck:手机跑 PC 游戏不难,难的是让 Android 相信自己正在当主机
- magpie:它调度的不是模型,是会过期的额度
- Aerial:换桌面不是画界面,是在别人的固件里抢前台
- colibri:同一个引擎 184 倍的速度差,全部来自权重住在哪一层
- GEO:最有效的三种写法,官方提示词里都写着“可以编造”