Haru-4B:全双工的瓶颈不是架构,是你录不到双声道对话
全双工语音模型最容易被误解的一点,是它的难点看起来在架构上——让模型一边听一边说。
真正的难点在数据上:公开可用的大规模语料里,几乎没有一份同时记录过对话双方各自的声音。一份电话录音只有一个音轨,两个人一起说话时,声音在波形上就是加在一起的一团;谁先开口、谁在附和、谁被打断,全部糊在里面。
Haru-4B 的做法是把这件事反过来。它不假装自己有双声道数据,而是先用一个分离模型把混合录音拆成逐帧对齐的两路,再用拆出来的东西训练。官方技术博客里最诚实的一句是「Without training on any native two-channel conversations」——这句话既是这套方法的底气,也标出了它当下的软肋。
- 权重:higurashi-ai/Haru-4B(Hugging Face,主分发;ModelScope 有同名镜像)
- 代码:higurashi-ai/Haru(Apache 2.0,含 PyTorch / MLX / vLLM-Omni 三套实现与 Web Demo)
- 技术博客:blog.higurashi.ai/melte/haru4b(2026-11-13,另有日文版)
本文只讲一件事:Haru-4B 怎么绕开「拿不到双声道对话」这个死结,以及绕开的代价落在了哪里。功能清单它在 README 上写得更全,我复述没意义。
一、五个数字
先看数字,它们各自对应一件事,也都不是宣传语:
| 数字 | 是什么 | 它在管什么 |
|---|---|---|
| 4000 万小时 | 预训练语音总量 | Stage 1 的规模基准 |
| 1300 万小时 | 分离出来的双工对话 | Stage 2 全部的食材,也是最贵的一段 |
| 160+ / 9 | 覆盖语言数 / 重点语言数 | 多语言能力的天花板与实测面 |
| 60 分钟 | 单条训练样本的最长对话 | 长程交互能被建模到多长 |
| 256 × B200 × 8 天 | 预训练算力 | 一次预训练调用了多少张卡 |
第三个数字值得单独说:160 多个语言是训练数据的覆盖面,真正被当作重点调过的只有九种——英语、西班牙语、葡萄牙语、德语、法语、中文、日语、俄语、韩语。中文在列,不用猜。
二、为什么全双工的数据这么难拿
造全双工训练数据,目前只有三条路,代价完全不同:
| 做法 | 拿到的 | 代价 |
|---|---|---|
| 合成对话(脚本 + 双角色 TTS) | 完全对齐、可控、可无限扩写 | 没有真实的打断、犹豫与附和,TTS 的韵律本身就干净 |
| 原生双声道录音 | 最真实 | 规模小、场景窄、授权链条复杂 |
| 分离真实混合录音(Haru) | 规模大、对话真实 | 分离误差,且恰好集中在重叠语音 |
Haru-4B 明确选了第三条,并且明确拒绝了第一条——博客原话是不使用 LLM 生成的对话,也不用 TTS 合成语音来构造这部分数据。这个选择很关键:全双工要学的东西(打断、抢话、附和)恰恰是合成数据最学不出来的部分,因为合成数据的「真实」本身就是被写好的。
于是问题变成:怎么把一路混合音频,变成两路时间对齐的音频。
三、把一路拆成两路
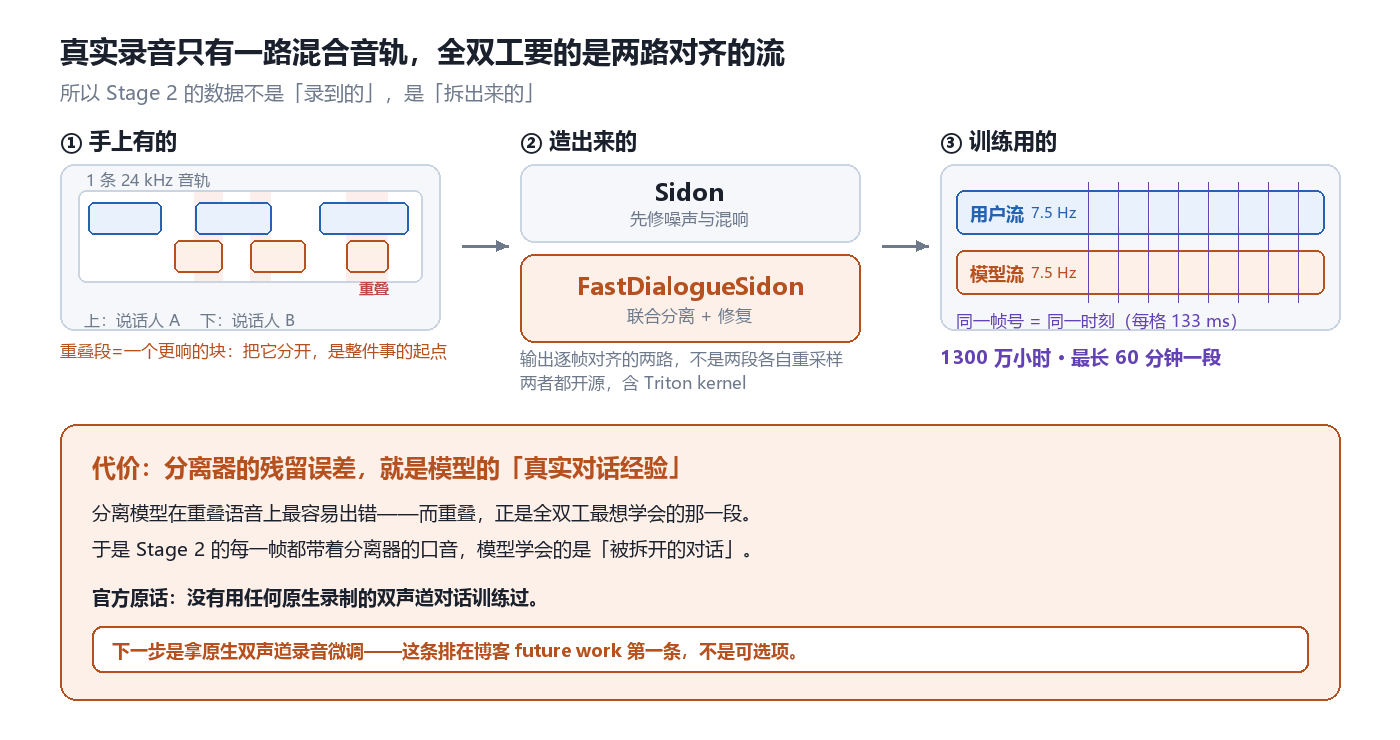
流水线是「先修再拆」:Sidon 修掉噪声与混响,FastDialogueSidon 做联合分离,输出的是同一帧号对齐的两路,而不是两段各自重采样的音频。
两个组件都是他们自己做并且开源的:
- Sidon 是语音修复模型(ICASSP 2026),负责把大规模真实录音里的噪声与混响压下去。他们另外开源了 Sidon-Triton,用 Triton 加速这条预处理流水线——这暗示了规模:4000 万小时的预处理不是能慢慢跑的活。
- FastDialogueSidon 是联合的分离 + 修复模型,把混合录音变成时间对齐的双工流,同样单独开源。
产物是 1300 万小时、最长 60 分钟一段的「双工对话」。这里有个容易被忽略的工程点:分离必须逐帧对齐,不能是两段独立重采样。如果两路各自漂移几个毫秒,「谁在什么时候说话」这个信号就废了,而它正是全双工唯一要学的东西。
代价也写在同一段话里:分离模型在重叠语音上最容易出错,而重叠正是全双工最想学会的那一段。所以模型学到的其实是分离器眼中的对话——它继承的是分离器的先验,不是现场的真实。
四、三路信息,一个位置
拿到双路语音之后,架构问题才登场:这三条流(用户语音、模型语音、模型文本)怎么塞进一个语言模型。
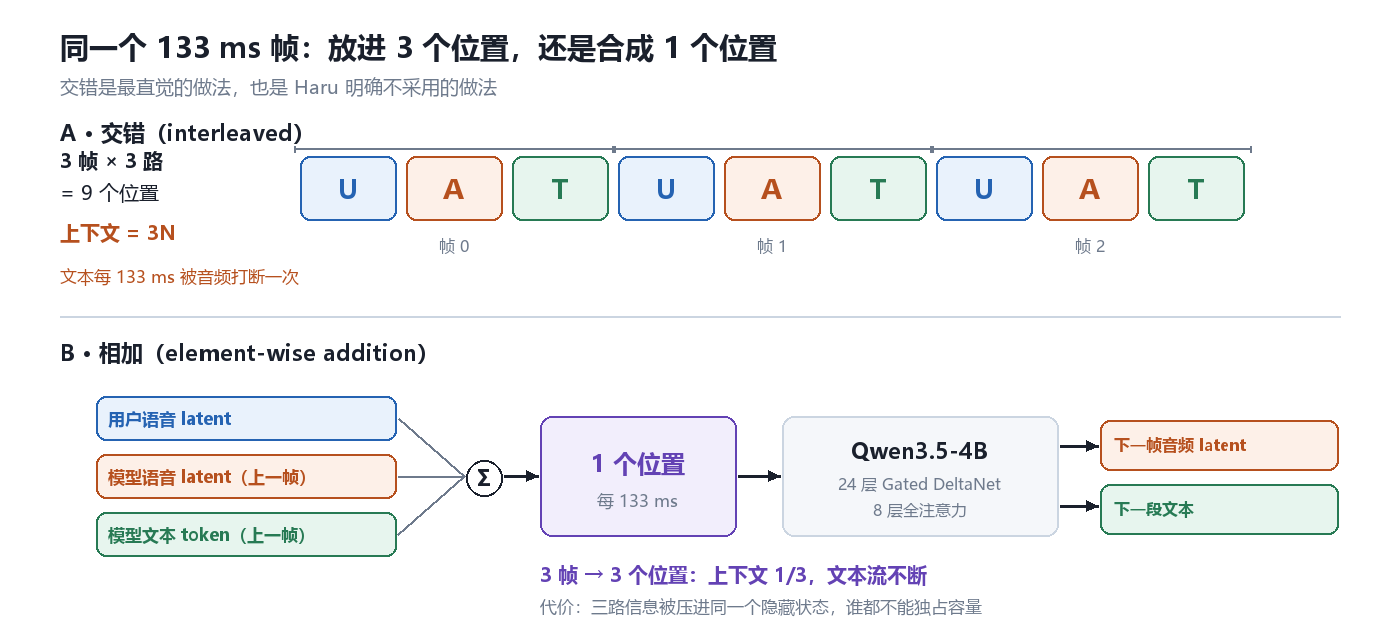
上半是交错:一帧占三个位置,文本每 133 ms 被音频挤开一次。下半是 Haru 的做法:三路相加进一个位置。
最直觉的做法是交错——每 133 ms 一帧,把用户帧、模型音频帧、文本帧排成三个连续位置。Haru 明确不这么做,它把三路各自投影到同一维度,然后逐元素相加,压进一个位置。
博客给的理由是:与交错相比,上下文长度降到约三分之一,同时文本流不被打断。第二条比第一条重要。交错意味着文本每 133 ms 就被音频挤开一次,模型很难在文本上维持连贯的语言建模;相加则让文本流保持连续,音频只是叠加在同一位置上的另一份信息。
顺带一提,这个「多路相加进一个位置」并非 Haru 凭空造的:博客把 Moshi 和 FLM-Audio 都列为这条线的来源(参考文献 2、3)。差异主要落在文本怎么进来——Haru 的答案是下一节的块级对齐。
代价很实在:三路共享一个隐藏状态,谁都不能独占容量。省下三分之二的上下文,同时也意味着语言能力和声学细节要在同一个向量里抢位置。
五、文本按块走,音频按帧走
官方博客里有一句很容易被跳过的细节:文本是按「块」(chunk)走的,不是逐 token。
这句话的分量要看第三张图才明白:
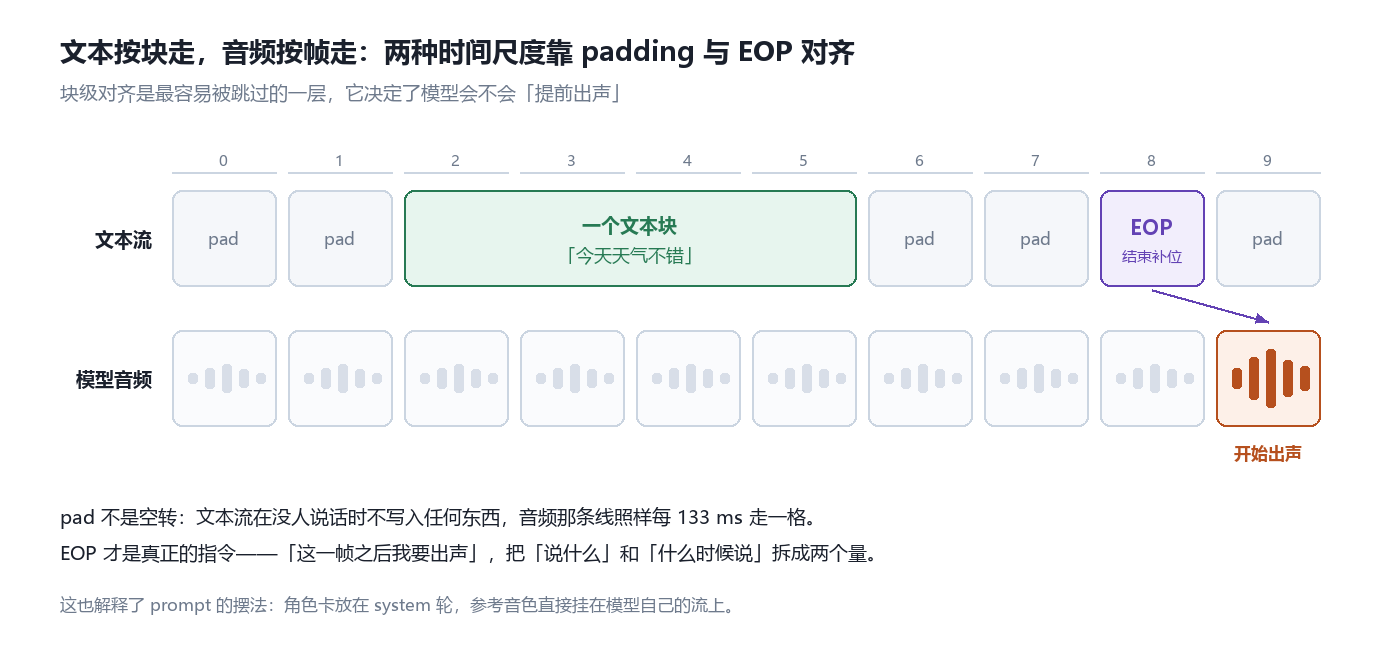
没有文本的帧填 padding;真正要出声的前一帧放一个 end-of-padding(EOP)token。前者是「这会儿没词」,后者是「下一帧我开口」。
文本和音频的时间分辨率差得很远:一个 133 ms 的音频帧里可能半个字都没有,一段四个字的文本块却要横跨好几帧。Haru 的处理是:
- 文本以块为单位写进流里,一帧放一个块(而不是一个字一个位置);
- 块与块之间、以及模型沉默的帧,一律填 padding token;
- 在模型即将出声的前一帧放一个专门的 end-of-padding token。
最后一个才是关键设计。它把「说什么」和「什么时候说」拆成了两个可以分别预测的量。文本流负责内容,EOP 负责时机;模型不必为了让文本对上音频而提前或推迟说话。
这也解释了 prompt 的摆法:角色卡作为 system 轮给出,参考音色直接挂在模型自己的流上当音频输入。人物设定走文本流,音色走音频流,两者在同一个位置上相加——和推理时完全一致。
六、一次采样出音频
音频这一侧的选择也很干脆:不要离散 token,不要多次迭代,不要额外的声学 Transformer。
| 项目 | 配置 |
|---|---|
| 音频表示 | 64 维连续 latent / 帧 |
| 帧率 | 7.5 Hz(每帧约 133 ms) |
| 采样率 | 24 kHz,每帧 3200 个采样点 |
| Codec | VibeVoice 因果声学 tokenizer |
| 生成头 | 4 层 MLP,Flow Matching 训练 + MeanFlow 蒸馏 |
| 采样步数 | 1 步,guidance scale 1~2(默认 1.5) |
对照一下常见的做法就明白省了什么:RVQ 方案一帧要预测多个 codebook 索引,逐层解码;迭代式 flow 方案一帧要跑好几次去噪。Haru 一帧只做一次前向 + 一次采样,7.5 Hz 下每秒只要 7.5 次自回归步。
代价是单步生成的质量上限被蒸馏约束住了,guidance scale 也成了一个必须调的旋钮:往 1 走更自然但更容易糊,往 2 走更清晰但更「用力」。
七、65.2 ms 的账,以及那 133 ms
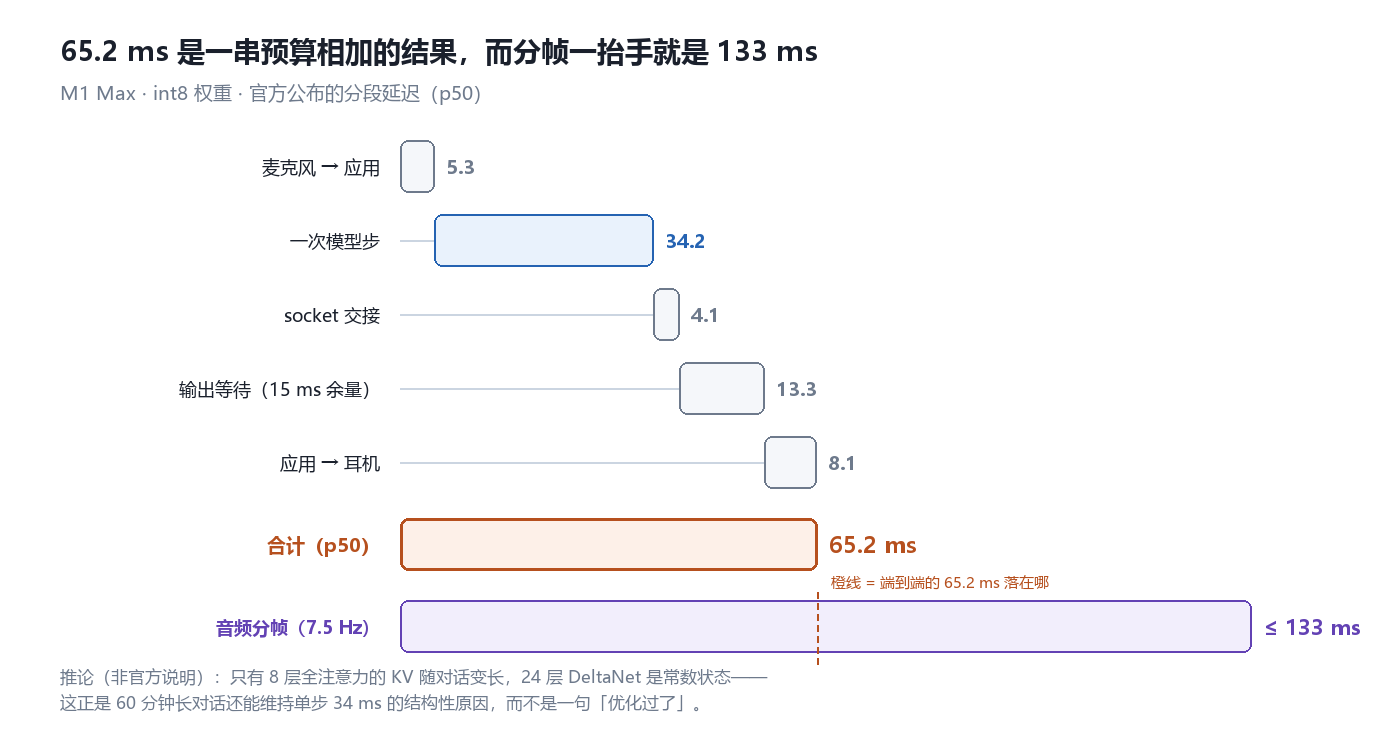
五段均值相加得到的是总和的均值 65.0,官方报的 65.2 是 p50;分布略偏时两者不会相等,这 0.2 是口径差,不是笔误。
官方在 M1 Max 上给出了 int8 权重的分段数据(原生 Swift 应用 + 定制 Metal kernel):
| 阶段 | 延迟 |
|---|---|
| 麦克风 → 应用 | 5.3 ± 0.0 ms |
| 一次模型步 | 34.2 ± 0.5 ms |
| socket 与数据交接 | 4.1 ± 0.3 ms |
| 输出等待(15 ms 余量) | 13.3 ± 1.5 ms |
| 应用 → 耳机 | 8.1 ± 0.2 ms |
| 合计(p50) | 65.2 ± 1.5 ms |
有一点必须连着看:65.2 ms 不包含音频分帧的延迟。7.5 Hz 的帧率意味着最多还要再加约 133 ms 的算法延迟——比整条工程链路加起来还多一倍。所以「65 ms 端到端」这句话在宣传上成立,在体感上,决定延迟的主要是帧率,而不是那五段预算。
另外两组数字可以对一下量级:NVIDIA B300 上,音频编解码加一次语言模型推理合计约 15 ms;PyTorch 实现里用 Triton kernel + CUDA graph 把单帧编解码从 6 ms 压到约 0.7 ms(需要显式开启 codec_backend="triton")。
还有一个官博没写、但从结构上能推出来的点(以下是我的推断,不是官方说明):Qwen3.5-4B 的 32 层不是普通的全注意力堆叠,而是 8 组「3 层 Gated DeltaNet + 1 层 Gated Attention」,也就是 24 层线性注意力 + 8 层全注意力。线性注意力层每步是常数状态,只有那 8 层全注意力的 KV 会随对话变长。这大概率才是 60 分钟长对话还能维持单步 34 ms 的结构性原因——否则一段一小时对话的 KV 早就把显存和带宽吃掉了。
八、入场费在预处理,不在训练
官方公布的预训练配置是 256 张 NVIDIA B200、约 8 天,框架是 Megatron-LM。
这个数字本身不惊人,惊人的是它旁边那句话:预处理阶段的瓶颈让他们必须自己写 Triton kernel,去加速 codec、Sidon 和 FastDialogueSidon。换句话说,这条技术路线的成本重心不在 GPU 训练那 8 天,而在一条 4000 万小时的音频处理流水线。(这一句是我的判断,依据是他们把大部分工程投入放在了预处理模型的加速上。)
这也是我觉得这份工作最值得抄的地方:它把「数据拿不到」当成一个可以工程化解决的输入问题,而不是当成一个前提。相比之下,「等有了好数据再说」在这个方向上等于永远不做。
九、局限
按重要性排:
- 没有任何质量指标。官方给了延迟表、给了数据规模表,却没有给一张质量表——没有 WER,没有主观 MOS,没有「打断成功率」这类真正衡量全双工行为的指标。目前判断它好不好,只能看那几段 demo 视频。
- 它是预训练基座,不是助手。官方原话:不做可靠的事实来源,也不像助手那样遵循指令。当成产品来用会立刻失望。
- 分离误差会被继承。重叠语音处的分离错误,正好落在全双工最想学会的地方;而这批误差在训练里会被当成「真实的对话」。
- 它没见过原生双声道录音。这是官方 future work 的第一条,不是可有可无的加分项。
- 硬件门槛不算低。README 写的是约 12 GB 显存(NVIDIA),BF16 权重之外还要留运行时与音频处理的余量。
- 参考音色要自备,而且要有权使用。仓库不带 voice clip,只接受单说话人、3 秒到 3 分钟的干净音频;官方在 README、模型卡、博客三处都写了「只使用你有权使用的声音」。
-
--share会把流量交给 Gradio。想给外部试用时要注意,这条路意味着演示页面与音频流都经过第三方隧道。
十、我的判断
Haru-4B 值得读的地方,不是「65 ms」也不是「4000 万小时」,而是它把全双工问题拆成了数据问题,并且真的把数据造了出来。分离器不完美,但它是可替换的零件;数据死结不解决,架构再漂亮也训不出来。
如果要验证这条路到底成不成立,我会盯三件可以被公开检验的事:
- 换用原生双声道微调之后,重叠语音段的表现能提升多少。如果提升很小,说明分离误差并没有想象中伤;如果提升很大,说明 1300 万小时里有一大块是分离器的错。
- 扩到 100B+ 之后,单步延迟还能不能守住。这正是线性注意力那 24 层要承担的压力测试。
- 有没有人开始报「时机指标」。EOP 这个 token 的存在本身说明时机是可预测的,但到现在没人报它的准确率与假触发率。
第三点是我最在意的,也是它和我最近在读的那条线的接口:NNsight / pyvene 那套表征干预之所以有用,是因为它把「模型内部发生了什么」变成了可读、可改的量。全双工的对话行为同样需要一个这样的量——「它决定什么时候开口」如果只是 demo 里的一句感觉,那这个方向就还停在演示阶段;如果 EOP 的触发可以被测量、被干预、被画成曲线,全双工才真正进入可以被工程化讨论的阶段。
项目与资料
- 权重:huggingface.co/higurashi-ai/Haru-4B(Apache 2.0)
- 镜像:modelscope.cn/models/higurashi-ai/Haru-4B
- 代码:github.com/higurashi-ai/Haru(PyTorch / MLX / vLLM-Omni,三者共用同一份 checkpoint)
- 技术博客:blog.higurashi.ai/melte/haru4b
- 关联开源:Sidon-Triton、FastDialogueSidon
- 基座模型:Qwen/Qwen3.5-4B
git clone https://github.com/higurashi-ai/Haru && cd Haru
pip install -e ./haru
python -m haru.server --hf-repo higurashi-ai/Haru-4B   # 打开 http://localhost:8998
from haru import DuplexSession, HaruModel
from haru.audio import load_audio, prepare_reference

model = HaruModel.from_pretrained("higurashi-ai/Haru-4B")
voice = prepare_reference(load_audio("voice.wav"))
session = DuplexSession(model, system_prompt=card, reference=voice)

frame = session.start()                  # 模型的第一帧:frame.audio / frame.text
while not frame.done:
    frame = session.step(user_audio)     # 进 3200 采样点,出 3200 采样点
这段 API 里藏着一个容易忽略的调度约定:模型比用户快一帧。start() 返回第 0 帧,之后每次 step() 传用户第 k 帧、返回模型第 k + 1 帧。也正因为如此,step() 的输入必须是 24 kHz、每帧正好 3200 个采样点,而不是「一段音频」。
数据来源与口径:延迟分段、4000 万 / 1300 万小时、160+ 语言、60 分钟样本、256 × B200 × 8 天、65 ms 与 B300 的 15 ms 均来自官方技术博客(2026-11-13);层数 32、hidden 2560、4 层 MLP、guidance 1~2、12 GB 显存、8998 端口、DuplexSession 的用法与「快一帧」约定来自 README 与模型卡;Apache 2.0 许可与 9 种重点语言见模型卡;「24 层 DeltaNet + 8 层全注意力」来自 Qwen3.5-4B 模型卡的 hidden layout 表,Step 成本不随对话变长是我据此做出的推断,已在正文标注。文中「入场费在预处理」与「质量指标缺失」是我的判断,不是官方结论。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- vLLM:每次重写,改的都是同一本显存账
- Diagram Design:50 种图表是目录,能拒绝你的检查才是产品
- gpu-unlock:GeForce 的半速矩阵算力,写死在八个 4 位字段里
- Octop:单进程是它的地基,也是它的天花板
- VoiceStudio:把 ElevenLabs 搬回本地之后,账单换成了许可证
- DroidDeck:手机跑 PC 游戏不难,难的是让 Android 相信自己正在当主机
- magpie:它调度的不是模型,是会过期的额度
- Aerial:换桌面不是画界面,是在别人的固件里抢前台
- colibri:同一个引擎 184 倍的速度差,全部来自权重住在哪一层
- GEO:最有效的三种写法,官方提示词里都写着“可以编造”