gpu-unlock:GeForce 的半速矩阵算力,写死在八个 4 位字段里
同一张 RTX 3090,同一段 BF16 稠密矩阵乘,同一个输入:解锁前 75 TFLOPS,解锁后 125 TFLOPS。
而两遍跑出来的输出,逐位相同。
它没有改精度,没有改计算路径,也没有超频。它改的是每周期能射出几条矩阵指令——而这个「几条」,是 NVIDIA 在出厂默认值里就写好的。
项目叫 gpu-unlock:
- 源码:Zagitta/gpu-unlock(模块与本地打包 GPL-2.0-only,版本 2.0.0)
- 平台:只支持 Linux。Windows 作者明确说不维护,第三方移植自己承担风险
- 形态:一个放进 initramfs、在
nvidia绑定显卡之前加载的内核模块
大部分介绍会说「它解除了 GeForce 的 Tensor Core 限速」。这句话没错,但它把这件事讲得太容易了——好像有个开关本来是关的,拨一下就行。
这篇想拆的是另一件事:那两个寄存器,从驱动侧写进去是无效的。 它们是普通的 MMIO 地址,问题是写权限被一条特权掩码挡在外面,而掩码只能在一个只存在于引导期间、跑在安全处理器里的上下文里才能改。
所以 gpu-unlock 真正解决的从来不是「改哪个值」,而是「怎么抢到那几百毫秒」。它的安装说明里有一大半篇幅在讲时序,理由就在这里。
一、先看三个数字
0。 解锁前后输出的差异位数。README 的说法是 outputs are bit-identical,只有速度变了。
8。 SS0 这一个寄存器里被一起改掉的 4 位字段数。八个字段,一个不少。
100+。 README 里 Ampere 一栏写的用户报告条数,状态是 Stable;Ada 和 Turing 都还是 Experimental。
第三个数字说明这个项目在 RTX 30 系列上已经被踩得比较实了,但也仅限 RTX 30。
二、锁不在驱动里,在两个寄存器的八个 4 位字段里
仓库里有一份 docs/How Ampere was unlocked.md,是整件事最好的入口。它给出的不是「某处有个开关」,而是地址、默认值、位域语义:
| 名称 | 地址 | GA102 默认值 | 管什么 |
|---|---|---|---|
FEAT_OVR_SM_SPD(SS0) | 0x0082381c | 0x00000001 | 八个 4 位字段,覆盖 DP、FFMA、FMLA16、FMLA32、IMLA0–3 |
FEAT_OVR_SM_SPD_1(SS1) | 0x00823820 | 0x00000001 | [3:0] 一个字段,对应 IMLA4 |
FEAT_OVR_PLM | 0x00823804 | 0xffffff8f | 前两个寄存器的读写权限 |
每个 4 位字段的编码是统一的:
-
bit 3:override 使能位 -
bits 2:0:速率选择子,00全速、01半速、10四分之一、11八分之一(后两档文档标注为未确认)
目标值就是 SS0 = 0x88888888、SS1 = 0x8。
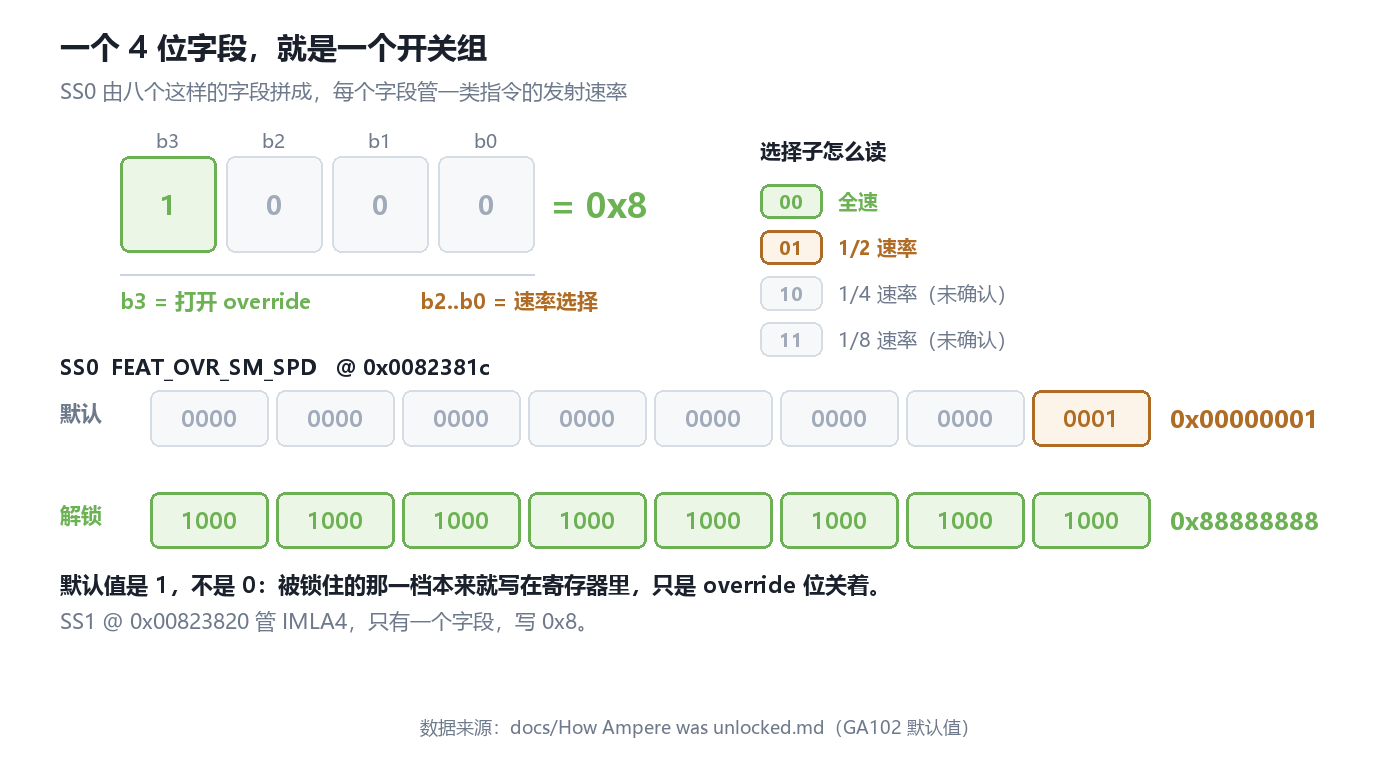
默认值是 1,不是 0。被锁住的那一档本来就写在寄存器里,只是 override 位关着。
这里有个值得停一秒的细节:默认值 0x00000001 的低四位是 0001 ——override 关着,而它请求的速率是「半速」。也就是说,即便有人把 override 位打开而把选择子留在 001,拿到的还是半速。从结果看,这种区分完全可以不写进驱动逻辑:把默认值里的一个数字换个写法就够了(这是我的推断,文档没有描述 NVIDIA 的实现方式)。
七个字段写 0000、一个写 0001,解锁时八个全写 1000。这不是给寄存器打补丁,是把一个本来就有语义的配置项填成另一组合法值。
三、那为什么 nvidia 自己写不进去
因为这八个字段所在的地址,被 FEAT_OVR_PLM 圈在一个特权区里。
按 Consensus-Protocol/cmp170hx 从观测行为反推出的位域模型:
-
[3:0]读保护,一位对应一个特权级(L0/L1/L2/L3),置位表示该级可读 -
[7:4]写保护,同样一位一级,置位表示可写 -
[23:8]源使能,控制哪些片上来源可以发起访问
默认值 0xffffff8f 的低字节是 0x8f,二进制 1000 1111:
-
[3:0] = 1111:四级全部可读 -
[7:4] = 1000:只有 L3 可写,L0/L1/L2 的写全部被挡
L3 对应的就是 heavy-secure 上下文——安全处理器里的代码执行时所在的那一级。从宿主侧、也就是从驱动侧,你连 L1 都算不上。
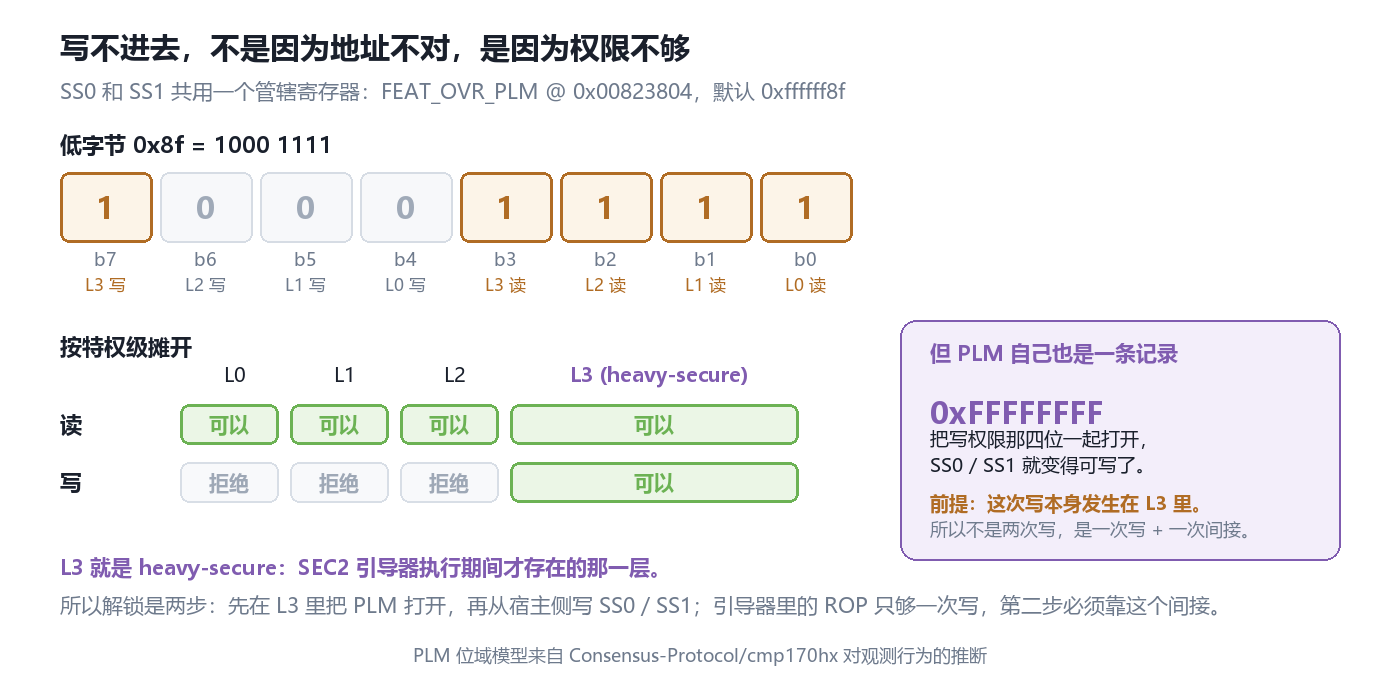
所以「写不进去」不是地址找错了,是这次写没有权限。而这个判断发生在硬件里。
有意思的是,PLM 本身也是一条记录。把 0xFFFFFFFF 写进去,写权限那四位就一起打开了,SS0 和 SS1 立刻变得可以从宿主侧写。
于是问题从「怎么改一个不可写的寄存器」变成了「怎么在 L3 里写一次」。前者在软件层无解,后者是一个引导链问题。
四、一次任意写,和一段被泄漏的调试固件
Ampere 的引导链上有一段代码拿到了 L3 的执行权限:SEC2 的 Booter。它由驱动通过 DMA 送进去,负责接收加密的 GSP 固件、验签、解密、再交给 GSP 执行。
这份 booter 里有一个经典的栈缓冲区溢出。栈被写了,返回地址就可控,就能用 ROP 把现有指令串起来。
麻烦在于固件是加密的,没法反汇编。但文档里记了一笔:NVIDIA 曾经同时发布调试版和生产版 booter,而调试版用了已知的公开测试密钥方案(key index 37)加密。于是有人把它解出来了,然后就是常规的 gadget 挖掘。
挖出来的成果就是 v67 载荷。它能把一个 32 位值写到一个 32 位地址——一次任意写。就这一次。
这一次写,就是整个方案的预算上限。载荷已经接近尺寸极限,写不了第二次,反复启动 booter 又有它自己的问题。所以它没有去写 SS0 或 SS1,而是写了 PLM:花掉唯一那一次写,把门打开,然后 SS0、SS1 用普通的宿主侧 MMIO 写补完。
从「一次写」到「三个寄存器都改好」,中间隔着的就是那条特权掩码。这也是为什么这个项目的技术核心不是「找到某个魔数」,而是「借一次执行权限,换一次间接」。
五、窗口:为什么必须是一个 initramfs 里的内核模块
正常的开机流程里,SEC2 Booter 是驱动送进去并触发的。也就是说,那段 L3 代码的寿命令人遗憾地短:只在引导期间存在,引导完就没了。
等 nvidia 把卡绑好、GSP-RM 起来、宿主和固件之间的 RPC 通信建立,再从驱动侧往 0x0082381c 写东西,什么也不会发生。这条路是关着的,不是参数没调对。
gpu-unlock 的做法是:不跟驱动抢,而是替它先跑一遍。
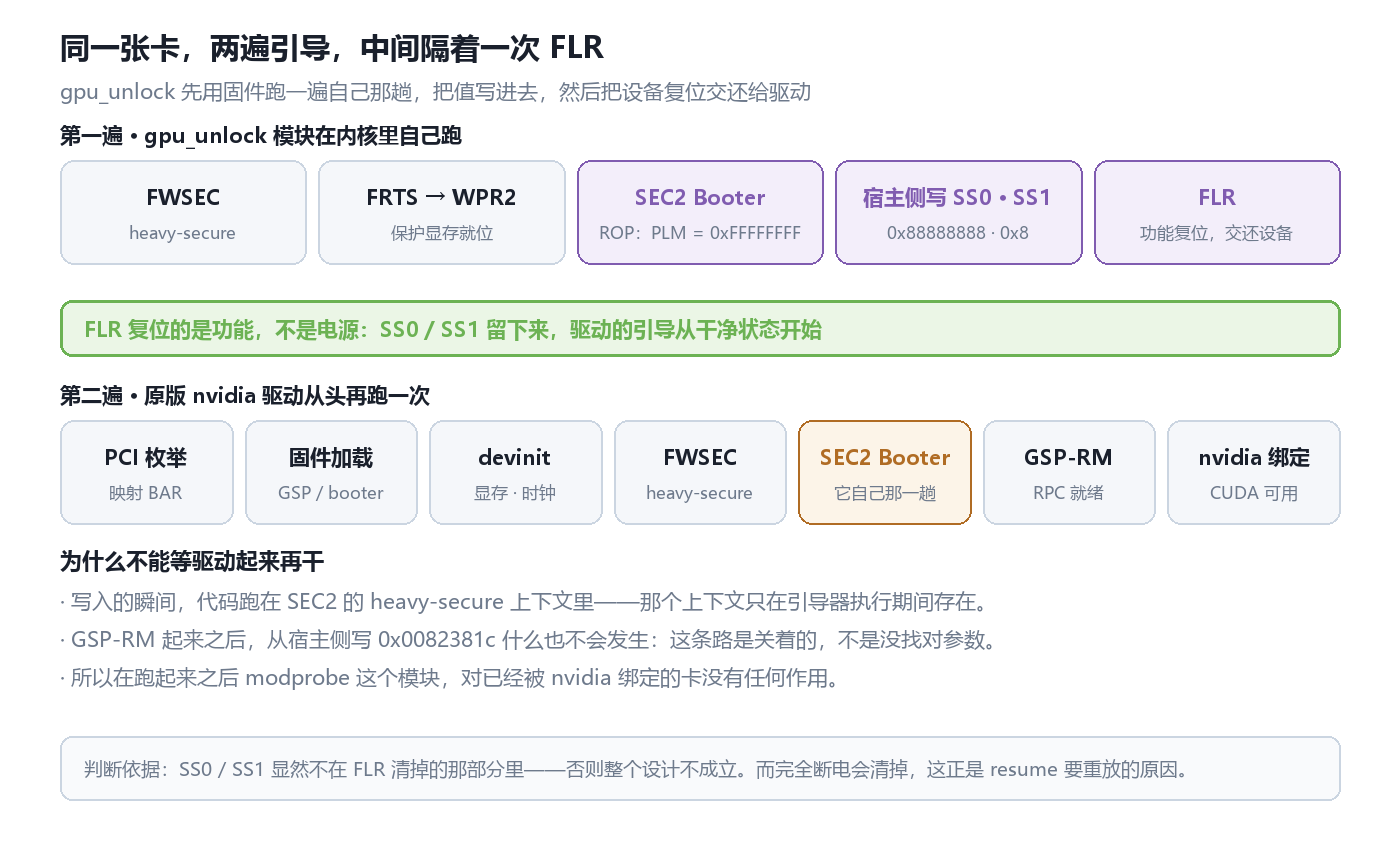
第一遍是自己发起的,第二遍是驱动发起的。中间隔一次 FLR。
第一遍:模块自己把 FWSEC、FRTS、WPR2、SEC2 Booter 跑一遍,在 Booter 里执行 ROP 把 PLM 写成 0xFFFFFFFF,回来由宿主侧写 SS0 = 0x88888888、SS1 = 0x8。
然后对这张卡做一次 PCIe Function Level Reset。
这是整个设计里我觉得最讲究的一步。第一遍跑完之后,卡的状态已经不是驱动期待的那个状态了——驱动要自己发一遍引导。FLR 把功能复位,让驱动从一个干净的设备开始 probe,而它要的东西已经留在寄存器里了。
FLR 复位的是功能,不是电源,所以 SS0/SS1 活了下来。这个判断不是文档写的,是从结果反推的:如果 FLR 会清掉它们,这套设计根本不可能工作。而完全断电会清掉——这正是后面 resume 要重放的原因(第七节)。
也正因为如此,在你已经跑起来的系统上手动 modprobe 这个模块,对一张被 nvidia 绑定过的卡没有任何作用。窗口已经过去了。
六、装的时候步骤为什么长这样
理解了「必须赶在 nvidia 绑定之前」,安装说明里那些看起来啰嗦的设计就都有了解释。
它给三种 initramfs 生成器各写一份 drop-in:mkinitcpio 走 /etc/mkinitcpio.conf.d/zz-gpu-unlock.conf,initramfs-tools 走 /usr/share/initramfs-tools/modules.d/gpu-unlock.conf,dracut 走 /usr/lib/dracut/dracut.conf.d/gpu-unlock.conf。在 mkinitcpio 里它被插在 MODULES 数组中 nvidia 的前一位,这样显示卡变黑的时间最短。
它故意不用 softdep nvidia pre: gpu_unlock。 这是个很容易踩的坑:kmod 只认它读到的第一条 softdep nvidia 行,别的包(nvidia-utils、gddr6_hwmon)只要也写一条,要么把这条盖掉,要么被这条盖掉。两种失败都是静默的。
它默认什么都不做。 只有内核命令行里出现 gpu_unlock.targets= 才干活:
gpu_unlock.targets=all                          # 所有受支持、尚未绑定的卡
gpu_unlock.targets=0000:21:00.0                 # 只处理这些
gpu_unlock.targets=0000:21:00.0,0000:22:00.0    # 逗号分隔
地址就是 lspci -D 打印的完整 PCI 名字,大小写十六进制都行,和 GPU 编号、以及哪张卡在带显示都无关。写了 all 又混进地址、或者写了不支持的卡,会被记一条日志然后忽略。多张卡并发处理,文档说总共大约一秒,和几张卡无关。
顺便记一个对排查很实用的细节:仓库叫 gpu-unlock,内核模块叫 gpu_unlock。journalctl -k -b | grep gpu_unlock 和 modprobe gpu_unlock 都用下划线,用连字符什么都搜不到。
细节里还有几条能看出作者踩过坑:
- 板卡固件留下的 bus mastering(点名了 Supermicro X11)会先被清掉;
- 已经被别的驱动初始化过的卡,直接拒绝;
- 带显示的卡也能解,它的固件 framebuffer(启动 console 和 Plymouth)在复位前才撤掉,屏幕会黑到
nvidia-drm接手; - 如果某张卡的固件永远停不下来,模块会记日志,并且把固件可能还在用的 DMA buffer 保留到下次断电——断电之前不要重试。
还有一个容易被误读的东西:仓库里钉着 610.43.03 的驱动版本。FAQ 里作者专门解释了,驱动只是被拉下来提取它依赖的固件,不是在依赖某个驱动版本。make dist、Debian 源码包和 .nosrc.rpm 都不含 NVIDIA 的压缩包或生成的固件——这是许可上的刻意隔离。
七、唯一会丢状态的事
suspend to RAM 会给显卡断电。断电,字段回到默认值。
所以模块注册了一个挂起通知,位置在 nvidia 恢复显卡的那个通知之前(NVreg_UseKernelSuspendNotifiers=1,当前驱动的默认值;nvidia-resume.service 还要更晚)。恢复时它先把在开机阶段解锁过的卡再解锁一遍,然后驱动才恢复。
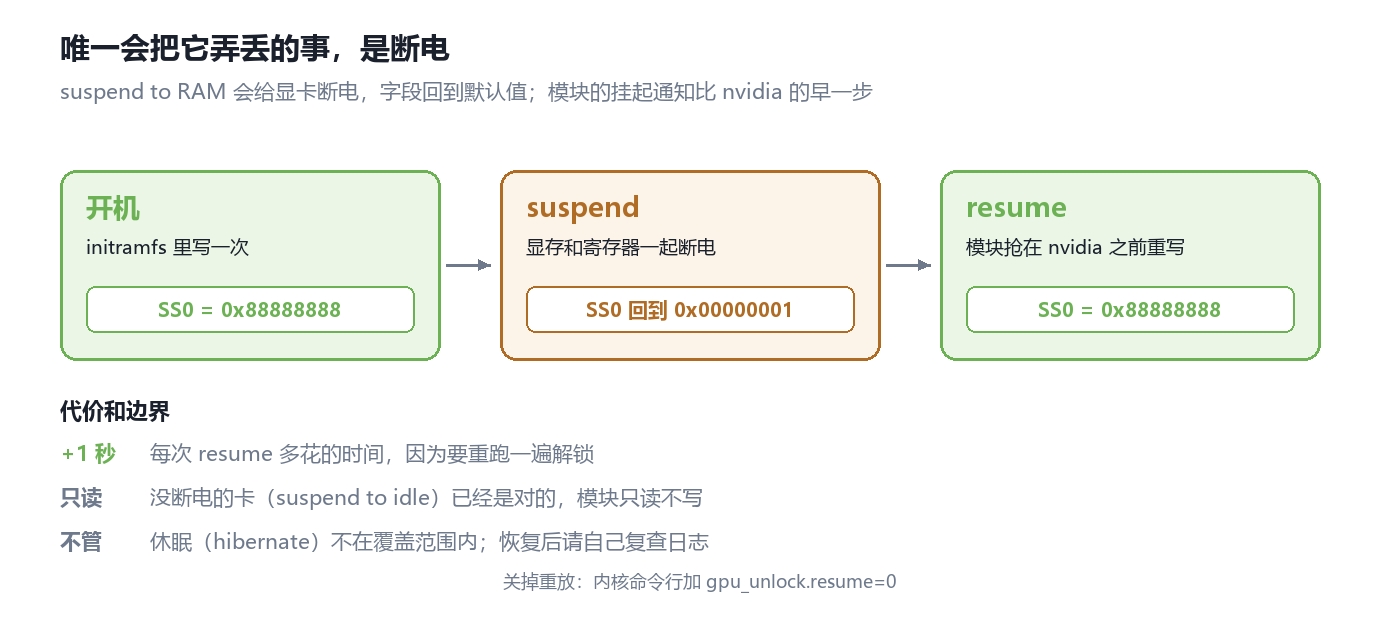
代价是每次 resume 多大约一秒。休眠不在覆盖范围内。
三条边界值得记:
- +1 秒:每次 resume 的固定开销,因为要重跑一遍。
- 只读不写:suspend to idle 那种没断电的卡,字段还是对的,模块只读一遍确认。
- 不覆盖休眠:hibernate 不在支持范围内。恢复之后请自己去看
journalctl -k -b | grep gpu_unlock。
不想要这个行为,内核命令行加 gpu_unlock.resume=0,或者往 /sys/module/gpu_unlock/parameters/resume 写 0。
笔记本是另一个问题:很多机器空闲时会把独显彻底断电,解锁就静默失效了。README 里给的缓解办法是在 /etc/modprobe.d/ 里写 options nvidia NVreg_DynamicPowerManagement=0x00,并且明说只有部分机型有效,预期是混合结果。
八、翻倍的峰值,打折的收益
先看寄存器能保证的东西——BF16、FP32 累加、默认功耗墙下的稠密矩阵乘:
| 显卡 | 解锁前 | 解锁后 | 提升 |
|---|---|---|---|
| RTX 3060 12 GB | 27 TFLOPS | 51 TFLOPS | +87% |
| RTX 3060 Ti | 37 TFLOPS | 68 TFLOPS | +82% |
| RTX 3070 | 40 TFLOPS | 72 TFLOPS | +81% |
| RTX 3080 10 GB | 65 TFLOPS | 113 TFLOPS | +73% |
| RTX 3090 | 75 TFLOPS | 125 TFLOPS | +65% |
| RTX 3090 Ti(450 W) | 88 TFLOPS | 157 TFLOPS | +80% |
| RTX 4070 Ti | 81 TFLOPS | 150 TFLOPS | +84% |
| RTX 4080 | 104 TFLOPS | 193 TFLOPS | +87% |
| RTX 4090 | 165 TFLOPS | 329 TFLOPS | +100%(峰值发射速率) |
注意 RTX 4090 那一行:它先把功耗用完了,Tensor Core 还有余量。所以 4090 那个 +100% 是峰值发射速率,默认功耗墙下的大 GEMM 远拿不到这个数。
再看真实负载,这里才是「值不值得装」的答案:
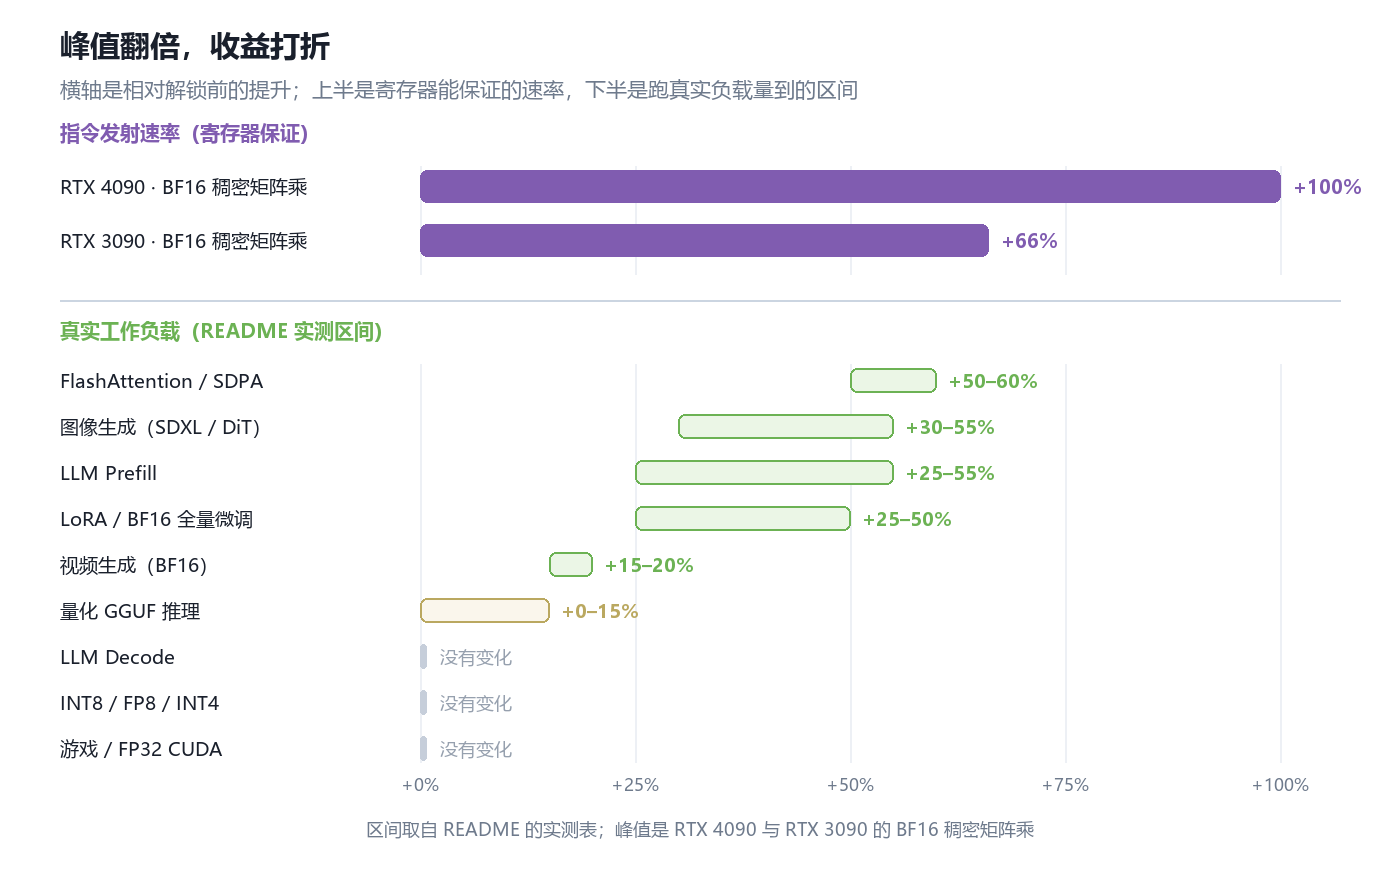
上面是寄存器能保证的,下面是跑起来能量到的。中间那段差距就是这个项目的实际边界。
| 工作负载 | 典型提升 |
|---|---|
| LLM Prefill / prompt 处理(FP16/BF16、AWQ/GPTQ;vLLM、PyTorch、Transformers) | +25–55% |
| 首 token 延迟 | 降低 25–30% |
| LoRA 与 BF16 全量微调 | +25–50% |
| 图像生成(SDXL、SD 1.5、ComfyUI 里的 DiT 模型) | +30–55% |
| 视频生成(Wan 2.2,BF16 计算) | +15–20% |
| FlashAttention / SDPA kernel | +50–60% |
| llama.cpp / Ollama 量化 GGUF | 0–15%,主要出现在长上下文 |
| LLM Decode / 逐 token 生成 | 没有变化 |
| INT8、FP8、INT4 模型 | 没有变化 |
| 游戏与 FP32 CUDA | 没有变化 |
为什么差这么多,其实一张表就能读出来:受不受矩阵发射速率限制,取决于这个 kernel 是在算矩阵还是在等显存。
Prefill 一次处理一大段 token,是稠密矩阵乘,吃得下吞吐;Decode 一次只生成一个 token,瓶颈在显存带宽,Tensor Core 再快也没有东西喂给它。INT8/FP8/INT4 走的是另一条路径,不在这八个字段的管辖范围里——这一点最好记住,量化推理的人基本拿不到收益。
九、它做不到什么
按重要性排:
- Blackwell(RTX 50)不支持,而且作者认为不太可能支持。 别因为 40 系列能用就假设 50 系列也能。
- 笔记本的解锁会静默失效。 独显一断电就回到默认值,缓解手段只对部分机型有效。
- 峰值不是收益。 4090 先撞功耗墙;小 batch、内存受限的工作负载收益接近于零。
- 功耗和温度会上去。 固件层的 throttling 和功耗管理还在,会正常降频,但卡确实在干更多活——电源、散热、多卡机箱风道都得重新算。
- 它借的是一条很深的路径。 在 L3 里改寄存器、做 FLR、抢 initramfs 时序,任何一步出错的表现大概率是「黑屏」或「驱动不加载」,不是一条友好的错误信息。留旧内核、留恢复启动项、留卸载方案。
- 许可要分开读。 模块和本地打包是 GPL-2.0-only;生成的 buffer 派生自钉住的 CMP 参考实现;NVIDIA 固件仍按它自己的条款(见
firmware/NOTICE.md与licenses/)。别把整个仓库当成 GPL。 - 固件 README 自己说了:所有新的硬件上下文仍是实验性的。
- 它不会让 3090 变成 A6000。 显存容量、带宽、CUDA Core 数、Tensor Core 数、额定功耗上限,一个都没变。
十、我的判断
我不觉得这个项目最有价值的地方是「白拿 65%」。
它真正有意思的是把性能优化的边界往下推了一整层。平时说加速,谈的是 kernel 融合、量化、FlashAttention 换实现——都在 CUDA 和 PyTorch 这一层。gpu-unlock 把问题挪到了「谁有权在引导阶段写一个寄存器」,然后发现这里的约束根本不是你写得对不对,而是你在不在那个上下文里。
一旦这么看,它的所有设计选择都是同一句话的推论:必须在 nvidia 之前(所以进 initramfs)、必须自己跑一遍固件(所以从驱动包里提固件)、必须把设备还干净(所以 FLR)、必须每次 resume 重来(所以挂起通知要抢在前面)、必须能关掉(所以 opt-in)。没有一个是「功能」,全是在迁就时序。
但这也正是它的脆弱之处,而且是可以验证的那种脆弱:这条路的起点,是一个签名引导程序里的栈溢出,外加一段用公开测试密钥加密、曾经被发布出来的调试固件。
补掉那个溢出,CMP 170Hx 的扩容和 GeForce 的半速解除很可能一起失效——它们踩的是同一级台阶。这不是猜测,是两份文档摆在一起就能读出来的事:v67 是在 SEC2 Booter 里拿到的执行权,而 GeForce 的解锁复用的就是这套载荷。
所以如果要我压缩成一句:这次解锁不是 NVIDIA 忘了关一个开关,是有人从固件引导链的缝里,把默认值改成了另一个合法值。 缝有多宽,取决于下一版 booter 怎么写。
如果你想自己验一遍,我建议别从 TFLOPS 开始,而是从这三个问题开始:
- 你的负载是 prefill 型还是 decode 型?(拿 vLLM 的日志看 time to first token 和 inter-token latency 的比例)
- 同一段代码在解锁前后的输出是不是逐位相同?(不一致就说明有别的东西在变,先停下来查)
- 把功耗和温度一起记下来——如果卡本来就贴着功耗墙跑,寄存器改了也不会更快,只是更早降频。
项目与资料
- 仓库:Zagitta/gpu-unlock(v2.0.0)
- 原理长文:docs/How Ampere was unlocked.md(本文第二节到第四节的寄存器与引导链细节都出自这里)
- 固件来源与许可:firmware/README.md、
firmware/NOTICE.md - 设备 ID 与每张卡的配方:kernel/gpu_unlock/recipes.c
- PLM 位域模型的出处:Consensus-Protocol/cmp170hx · privilege-level-masks.md
- 前驱项目:amoghmunikote/cmpunlocker
- 兼容性报告与 benchmark 细节:Issues
许可证: 内核模块与本地打包代码 GPL-2.0-only。NVIDIA 固件仍受其自身条款约束,详见仓库 licenses/。
图片说明: 本文五张示意图都是我根据仓库 README、docs/How Ampere was unlocked.md 和 firmware/README.md 绘制的,不是项目官方配图。文中的寄存器地址、默认值、位域语义来自上述文档;性能数据来自仓库 README 的实测表,属于项目公布的测试结果,不是我在自己机器上复测的,也不保证在任何硬件、功耗、软件版本下复现。百分比区间是 README 给出的典型范围,不是精确值。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- vLLM:每次重写,改的都是同一本显存账
- Diagram Design:50 种图表是目录,能拒绝你的检查才是产品
- Octop:单进程是它的地基,也是它的天花板
- VoiceStudio:把 ElevenLabs 搬回本地之后,账单换成了许可证
- DroidDeck:手机跑 PC 游戏不难,难的是让 Android 相信自己正在当主机
- magpie:它调度的不是模型,是会过期的额度
- Aerial:换桌面不是画界面,是在别人的固件里抢前台
- colibri:同一个引擎 184 倍的速度差,全部来自权重住在哪一层
- GEO:最有效的三种写法,官方提示词里都写着“可以编造”
- HelixHarness:Harness 工程的两份契约,一份写成了协议,一份还没有数据