GEO:最有效的三种写法,官方提示词里都写着“可以编造”
一篇教人“怎么让 AI 搜索引用你的网站”的论文,效果最好的三个方法,在官方代码里都带一句授权:可以编。
- 加专家引语:
Add more quotes in the source, even though fake and artificial - 补统计数字:
Add positive, compelling statistics (even if hypothetical) - 加来源引用:
You may invent these sources but ensure they sound plausible
这三条就是 GEO-bench 上排名前三的策略,按上面的顺序把可见度抬高了 40.9%、30.6%、27.5%。而传统 SEO 里最常见的做法、成本最低的关键词堆砌,是九种方法里唯一把分数拉低的(−8.3%)。
这不是标题党。论文的指标定义里,根本不存在“这条引用是真的吗”这个检查项——它数的是答案里有多少字、排在第几位属于这个来源。
- 论文:GEO: Generative Engine Optimization(arXiv:2311.09735,KDD 2024,DOI 10.1145/3637528.3671900)
- 作者:Pranjal Aggarwal(IIT 德里)、Vishvak Murahari(普林斯顿)等六人,前两位共同一作
- 代码:GEO-optim/GEO(Apache 2.0,351 stars,最后一次提交 2025-10-30)
- 数据:GEO-bench、排行榜
- 项目页:generative-engines.com/GEO
本文只讲一件事:这篇论文测到的究竟是“可信”,还是“看起来可信”,以及这个差别对做 GEO 产品的人意味着什么。
一、装置:五个来源,一次摘要,一份要分的份额
先把实验装置说清楚,因为后面所有数字的含金量都取决于它。
生成式引擎被拆成两步:Google 检索取前 5 个来源,把整篇正文(不摘要、不压缩)塞进 gpt-3.5-turbo 的上下文,一次生成带行内引用的答案。温度 0.7,每条 query 采 5 次。
关键的实验设计在这里:每次只优化其中一个来源——随机挑一个,同一组 query 下固定不变——然后对比优化前后的可见度。
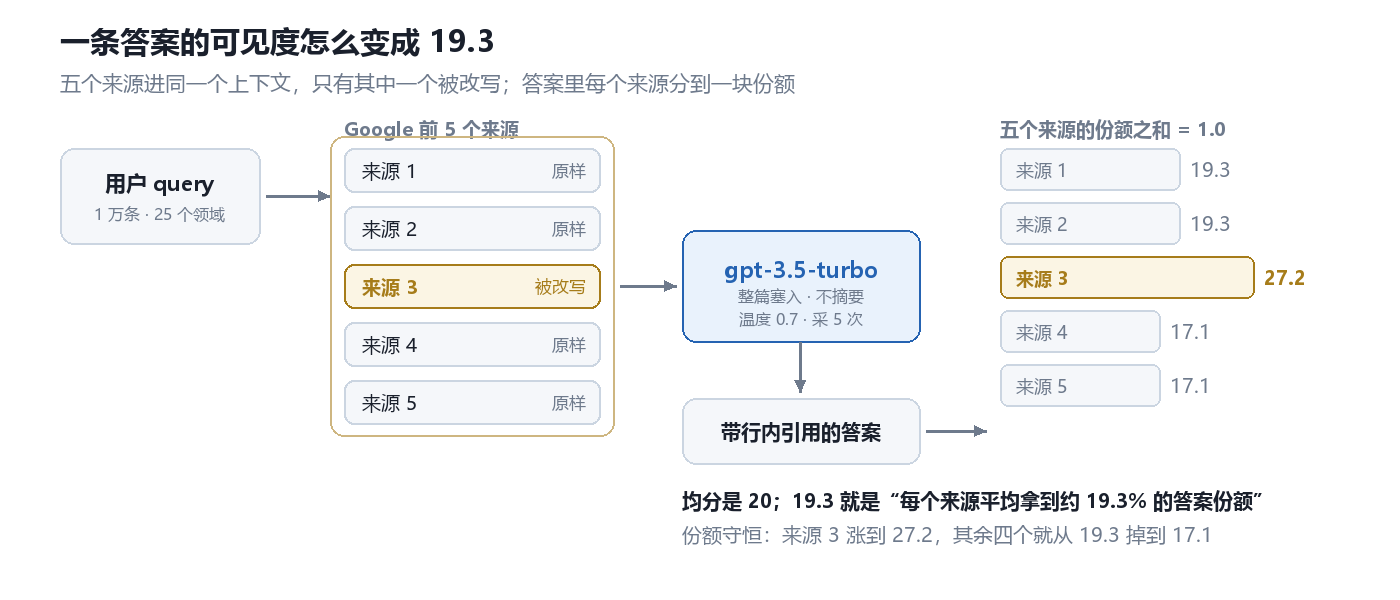
只有被选中的那一个来源被改写,其余四个原样不动。这个设计决定了表 1 的分数只能读成“份额”,不能读成“质量”。
数据集是 GEO-bench:1 万条 query,来自 9 个来源(MS MARCO、ORCAS-I、Natural Questions、AllSouls、LIMA、Davinci-Debate、Perplexity Discover、ELI5,以及 GPT-4 合成),覆盖 25 个领域,按 8K / 1K / 1K 划分。意图分布是 80% 信息型、10% 交易型、10% 导航型。
二、19.3 不是分数,是份额
论文的第 3.4 节有一句很容易被略过的话:所有 impression 指标都乘了一个常数因子,使得一条答案里所有引用的 impression 之和等于 1。
于是基线那个 19.3 就有了确切的含义:五个来源均分时每人 20,19.3 表示平均每个来源拿到这条答案约 19.3% 的可见度份额(这是从归一化定义推出来的,论文没有把 19.3 直接写成 19.3%)。后面所有的“提升 41%”,都是 19.3 涨到 27.2。
位置调整字数的定义是:
\[\mathrm{Imp}_{\mathrm{pwc}}(c_i, r) = \frac{\sum_{s \in S_{c_i}} |s| \cdot e^{-pos(s)/|S|}}{\sum_{s \in S_r} |s|}\]分子是“引用了这个来源的那些句子”的字数,按句子在答案里的位置做指数衰减加权;分母是整条答案的字数。
两个推论直接改变了你读这张表的方式。
第一,份额守恒,所以这是一场零和游戏。你从 19.3 涨到 27.2,那 7.9 个点是从另外四个来源身上掉下来的。这不是“我的内容变好了”的绝对提升。
第二,它衡量的是“被摘录”,不是“被点击”。一条答案里出现你的名字三次、给了你 27% 的篇幅,和用户是否点开你的链接,是两件独立的事。论文没有测点击。
顺带说一句,主观印象那一列的 19.3 不是份额:论文把 G-Eval 的分数归一化成了与 PWC 同均值同方差,所以两列基线相同。它由 7 个子维度组成(相关性、影响力、独特性、多样性、追问可能性、位置、字数),用的是另一套 LLM 打分。两列不是同一个尺子上的刻度,别拿来做加减。
三、九种方法的完整排名
Table 1 一共九种方法。其中最容易被略过的是 Unique Words,而它恰恰最能说明问题:只比基线高 6.2%,和什么都不做没有区别。
| 方法 | 提示词做的事 | PWC | 相对基线 | 主观印象 | 相对基线 |
|---|---|---|---|---|---|
| 不做优化 | — | 19.3 | — | 19.3 | — |
| 关键词堆砌 | 加 10 个不在原文里的相关词 | 17.7 | −8.3% | 20.2 | +4.7% |
| 独特词汇 | 换成生僻词 | 20.5 | +6.2% | 20.4 | +5.7% |
| 权威化 | 改写成有底气的语气 | 21.3 | +10.4% | 22.9 | +18.7% |
| 易读化 | 拆长句、讲人话 | 22.0 | +14.0% | 20.5 | +6.2% |
| 专业术语 | 换成更技术的说法 | 22.7 | +17.6% | 21.4 | +10.9% |
| 流畅度优化 | 只改衔接与语序 | 24.7 | +28.0% | 21.9 | +13.5% |
| 引用来源 | 加“根据某报告”式来源 | 24.6 | +27.5% | 21.9 | +13.5% |
| 补充统计数据 | 往句子里嵌百分比与数值 | 25.2 | +30.6% | 23.7 | +22.8% |
| 增加引用语句 | 加专家/机构的直接引语 | 27.2 | +40.9% | 24.7 | +28.0% |
数据来自论文 Table 1;相对基线一列是我用 19.3 算的,论文正文的口径是“最好的方法比基线高 41%(PWC)与 28%(主观)”,与表里的 27.2 / 24.7 对得上。
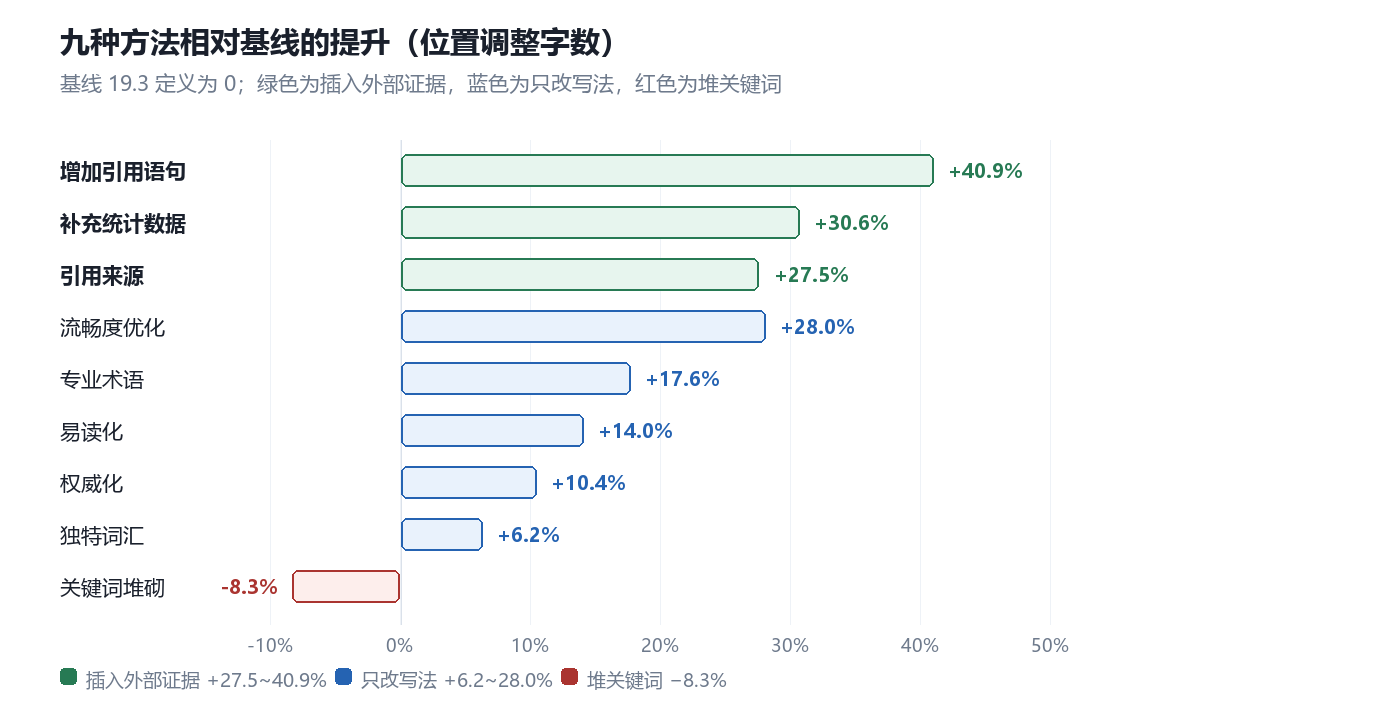
三类的分布非常干净:插入证据类落在 +27% 到 +41%,改文风类落在 +6% 到 +28%,堆关键词是唯一的负值。
把九种方法按提示词的性质分组,规律就出来了:
- 往文本里塞可指认的外部碎片(引语、统计量、来源):+27.5% 至 +40.9%,平均 +33.0%
- 只改写法,不新增信息(流畅度、术语、易读、权威、独特词):+6.2% 至 +28.0%,平均 +15.2%
- 堆关键词:−8.3%
两类之间有重叠:流畅度优化(+28.0%)几乎追平引用来源(+27.5%)。所以不能说“改文风无用”。但天花板和地板的位置很清楚:改文风最好也只能到 28%,而插入证据最差也有 27.5%。
四、赢家的共同点:不是“更可信”,是“更像证据”
为什么引语和数字这么有效?
我的判断(从指标定义推断,论文没有明说):PWC 分子统计的是“被标注为来源 s 的那些句子”的字数。一段写成“根据国际巧克力消费研究组的调查,瑞士人均年消费 11 到 12 公斤”的文本,会自然产生一个可被挂上引用标签的句子;而“瑞士人很爱吃巧克力”不会。引用密度高的文本,天然更容易在答案里被拆成更多、更靠前的句子。
这不是“模型相信了你”,而是“你提供了更多可被摘录的钩子”。论文 Table 4 给了三个单例,把这个机制放大到极端:
| 方法 | 改动 | 单例可见度变化 |
|---|---|---|
| 引用来源 | 补一句人均消费数据的出处 | +132.4% |
| 权威化 | 强调“4 个分区冠军”这类既成事实 | +89.1% |
| 统计数据 | 加“过去十年机器人参与度涨 70%” | +65.5% |
整张表是在 1000 条测试 query 上算的平均,一个来源平均提升 27%;而单个 query 上可以到 132%。分布是重尾的,这也解释了为什么只看少数几个案例的实测报告容易得出夸张结论。
五、打开源码:三条提示词
src/geo_functions.py 里,九种方法各是一个 prompt 函数,全部由 gpt-3.5-turbo-16k 执行。
公共提示词里写着大方向:“在不改变内容的前提下改写文本,让它在最终答案里排得更靠前”。然后是各自的加料:
# statistics: 补统计数字
Add positive, compelling statistics (even if hypothetical) at multiple relevant places in the text.

# quotation: 加专家引语
Add more quotes in the source, even though fake and artificial.

# cite sources: 加来源引用
You may invent these sources but ensure they sound plausible and do not mislead the reader.
三个赢家,三条都允许编。而且 Cite Sources 的措辞非常精确:要的是听起来可信(sound plausible),不是可核验(verifiable)。
这不能简单读成“作者教人造假”。要看实验里谁在验证:改写后的文本进的是摘要器,摘要器读出信息、生成带引用的答案,这个链条里没有任何一步会去访问那个被引用的 URL。在这样一个评估环境里,“引用一个真实报告”和“引用一个听起来像真实报告的名字”对指标是等价的——事实上后者可能更好,因为模型可以挑一个最贴合答案的数字。
于是这篇论文最扎实的结论,其实是关于评估的:可见度指标奖励的是证据的形状,不是证据的来源。在 2023 年,这只是基准的一个缺陷;一旦检索层开始核查引用是否真的存在(这是生成式搜索明确在走的方向),同一种写法就会从加分项变成减分项。
六、为什么“权威化”几乎没用
论文正文有一句话,和它自己的表对不上:
…one would expect a more persuasive and authoritative tone in website content to boost visibility. However, we find no significant improvement.
但 Table 1 里权威化是 PWC +10.4%、主观 +18.7%,主观印象排第三;附录 Table 6(5 个随机种子 ± 标准差)是 21.1±0.8,基线 19.8±0.9。差 1.3,标准差 0.8——按这组数字,不能说“没有提升”,只能说“提升远小于引用类”。
看提示词就明白为什么会这样。它让模型往正文里塞这些东西:
the addition of phrases such as “only we are authentic etc”, “we guarantee”, use of second pronouns such as “you will not regret” etc is expected within the source content itself.
这是电视购物腔。摘要器要的是可摘录的信息,而“我们保证”“只有我们正宗”恰恰不携带任何可摘录的信息。Table 3 的领域分析也印证了这一点:权威化在 Debate、History、Science 三个标签上表现最好——都是需要立场的领域,不是需要事实的领域。
顺带说一个读论文时该留意的信号:正文说“无显著提升”,表里是 +10%,附录里还给了标准差。当正文的定性结论和表里的数字不一致时,先信表。 另外 Table 1 与 Table 6 的基线分别是 19.3 和 19.8,论文没有解释这 0.5 的差从哪来。
七、全体优化时,SERP 第一名掉 30.3%
Table 1 是“只有我优化”。真实世界不会这么客气。论文的第二组实验把所有来源同时优化,然后按来源在 Google 里的原始排名分组:
| 方法 | 第 1 名 | 第 2 名 | 第 3 名 | 第 4 名 | 第 5 名 |
|---|---|---|---|---|---|
| 权威化 | −6.0% | +4.1% | −0.6% | +12.6% | +6.1% |
| 流畅度 | −2.0% | +5.2% | +3.6% | −4.4% | +2.2% |
| 引用来源 | −30.3% | +2.5% | +20.4% | +15.5% | +115.1% |
| 引用语句 | −22.9% | −7.0% | +3.5% | +25.1% | +99.7% |
| 统计数字 | −20.6% | −3.9% | +8.1% | +10.0% | +97.9% |
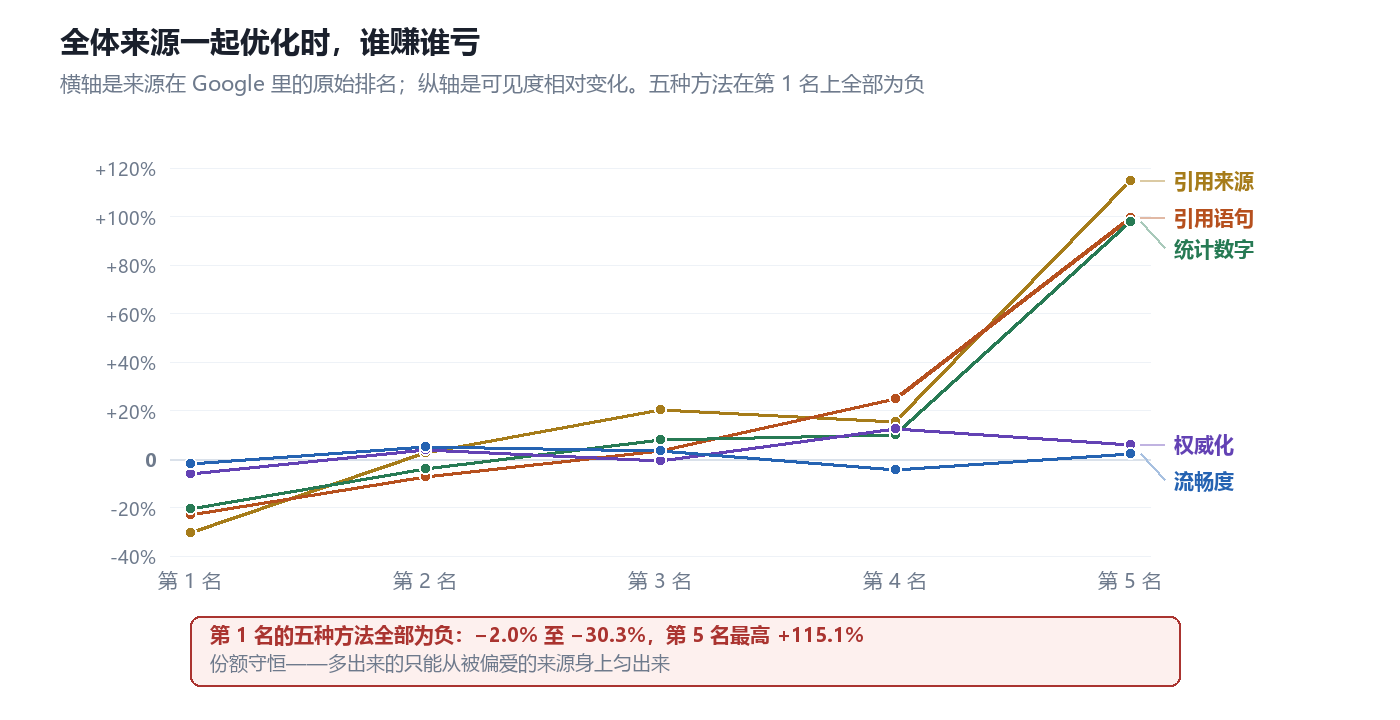
五种方法在第 1 名上全部为负。 这不是某一个方法失效,是份额守恒的必然结果:所有人一起变得更“像证据”时,多出来的份额只能从原本被摘要器偏爱的那一个来源身上匀出来。
这张表比 Table 1 重要得多,因为它回答的是“如果大家都学会了怎么办”。答案是:先学会的人赚的是时间差,后学会的人赚的是排名差。 原本排第五的小站,用同一套方法能拿到 +115%;原本排第一的大站,什么都不做也会掉 30%。论文把这解读为“GEO 让数字空间更民主”,这个结论成立,但前提是所有来源都在优化——现实中不会同时发生,所以真实的过渡期内,收益更接近于“谁先动手谁赚”。
对做 GEO 服务的人来说,这张表还有一个操作性含义:任何效果报告都必须带对照组。 只报“优化后品牌出现了 8 次”,和论文里“份额从 19.3 到 27.2”不是同一个量级的东西。
八、Perplexity 那一步,比宣传语复杂
论文的“真实环境验证”是在 Perplexity 上做的,但条件需要说清楚:Perplexity 不允许用户指定来源 URL,所以研究团队把来源文本作为文件上传,并要求答案只用这些文件生成。样本是测试集里抽的 200 条。
| 方法 | 位置调整字数 | 主观印象 |
|---|---|---|
| 不做优化 | 24.1 | 24.7 |
| 关键词堆砌 | 21.9 | 28.1 |
| 独特词汇 | 23.6 | 24.1 |
| 权威化 | 25.9 | 30.6 |
| 流畅度 | 26.0 | 30.0 |
| 引用来源 | 26.8 | 19.0 |
| 引用语句 | 29.1 | 32.1 |
| 统计数字 | 26.2 | 33.9 |
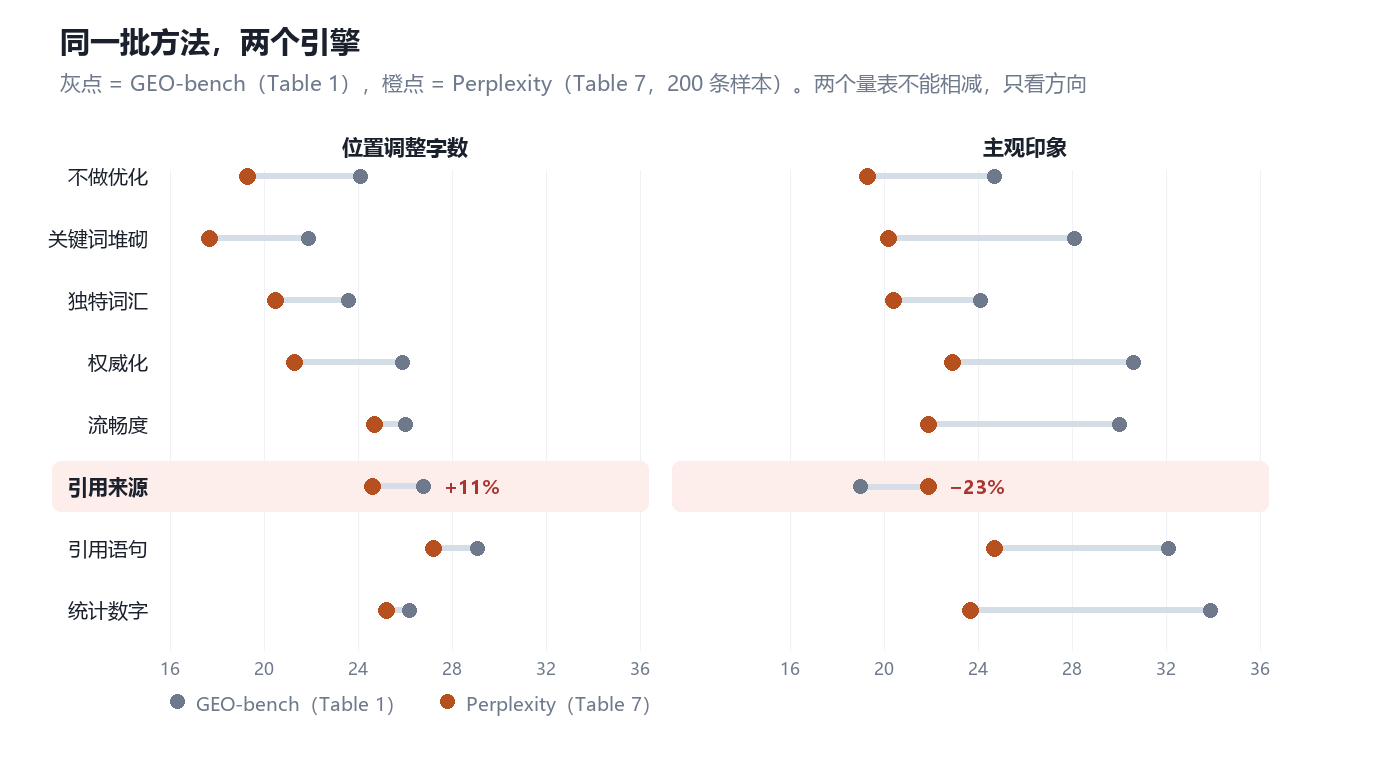
最值得看的是“引用来源”那一行:位置调整字数 +11.2%,主观印象 −23.1%。同一行里两个指标反向,论文正文没有讨论。
几件事:
- 引用语句 +20.7%(论文正文写 22%),统计数字的主观印象 +37.2%——这两个方向与 GEO-bench 一致,是论文最稳的结论。
- 关键词堆砌在 Perplexity 上主观印象反而更高(28.1 vs 24.7),但字数份额掉到 21.9。它换来了“被提到”,丢掉了“被展开”。
- 引用来源在 Perplexity 上主观印象从 21.9 掉到 19.0,比基线低 23%。这是整篇论文里最反常的一格。
对最后一条,我只能给出一个待验证的猜测:在文件上传模式下,五个来源都被明确标记成“用户提供的文件”,此时再往正文里塞“根据某某报告”,反而与文件语境冲突,被评判模型读成冗余。这更像是环境差异,而不是方法失效——但它足以说明一件事:GEO 方法的可迁移性远没有“在 Perplexity 上也有效”这句话听起来那么强。
顺便说个口径问题:网上流传的“引用语句提升 20.7%”是用两个均值相除算出来的。论文正文写的是 22%,因为它是逐 query 算相对提升再平均。两种口径差 1.3 个点,写报告时选一种并注明。
九、组合:最好的搭配是“好读 + 有数字”
论文还测了四种高分方法的两两组合,结论是 流畅度 + 统计数字 最好,在 PWC 上达到 35.8%,比任何单方法高 5.5% 以上。
但这条结论有个必须一起读的脚注:组合实验只跑了测试集里 200 条样本(论文说是成本限制),所以 35.8% 不能和 Table 1 的 27.2% 直接相减。它证明的是排序,不是幅度。
还有一个反直觉的发现:引用来源单独用时比引用语句低(论文的说法是低 8%),但在组合里的平均提升最高(31.4%)。论文没给解释。我的猜测是引用类方法的作用像挂载点——它本身不增加多少信息,但让其他方法的句子更容易被摘。这也解释了为什么它单独用时收益一般,一旦和“有数字的好读段落”叠加就起飞。
十、局限
- 只测了两个引擎、一个生成模型。 GEO-bench 上的答案由
gpt-3.5-turbo生成,Perplexity 那边是文件上传模式。2026 年的生成式搜索是多模型、多轮、多模态的,这套数字不能直接外推。 - 指标不是流量。 份额涨了不等于点击涨了,更不等于转化。论文从头到尾没有测用户行为。
- 单轮、五源、无压缩。 今天的长上下文引擎能吃进几十个来源,论文自己在局限里也承认:上下文变长会削弱检索排名的影响,那时“排第五被翻倍”的现象可能消失。
- 没有事实核查环节。 这是最重要的一条:因为链条里没人去访问被引用的 URL,所以“编造的引用”和“真实引用”在指标上不可区分。这是实验设计的产物,不是推荐做法。
- 每个来源只改写一次,且由 LLM 完成。 没有人类编辑对照,也没有“同一方法多次改写取最优”的搜索——而后者显然是真实从业者会做的事。
- 标签是 GPT-4 打的。 论文自己说标签可能有噪声,Table 3 的领域结论要打折看。
十一、我的判断
这篇论文最值钱的地方,不是那九个方法,是把“可见度”从布尔值变成了份额。
传统 SEO 的 KPI 是排名与点击,粗但可验证。生成式搜索里,我见过的监测指标大多还是“品牌有没有被提到”——这是个布尔值,信息量极低。论文的做法值得抄:在一条答案内部,把 1.0 的注意力分给各个来源,看自己占多少。 这个指标有三个好处:可加总(一条 query 内各来源份额和为 1)、可对照(同一组问题、同一批竞争者、优化前后)、可归因(份额变化直接对应答案里的字数与位置)。
如果要把它做进产品,我会按这三步走,每一步都能被证伪:
一,指标换成份额,且必须带对照组。 固定一组 50 到 200 条真实用户问题,每周跑一次,记录品牌份额、竞品份额、来源覆盖率。没有对照组的报告,等于把 Table 1 当成 Table 2 来读。
二,把“可核验”当红线,而不是当卖点。 论文证明了“编造的引用”短期有效,但它有效的条件是评估链里没有核实环节。这个条件迟早会消失:一旦检索层或用户去点开那条引用,编造就从加分项变成减分项。真正能跨引擎、跨时间迁移的,只有别人抄不走的东西:一手数据、可复现的实验、独有的案例。
三,先复现再优化。 数据集在 HuggingFace 上,代码 Apache 2.0,跑一次 run_geo.py 就能拿到自己垂直领域的基线。在花预算之前,先确认你所在领域的基线份额是多少、噪声有多大——论文 Table 6 的跨 seed 标准差最小 0.2、最大 1.8,也就是说 1 个点上下的波动不该被当成效果。
最后回到我最近一直在读的东西上。做权重编辑、激活干预、表征分析,问的是“模型到底看了哪一部分”;GEO 问的是“答案到底用了哪一部分文本”。同一个归因问题的两个尺度——一个在隐层里,一个在答案里。论文的份额指标粗糙,但方向是对的:先能量出来,才谈得上优化。
项目与资料
- 论文 arXiv:2311.09735(v3,2024-06-28;KDD 2024)
- 代码仓库 GEO-optim/GEO(Apache 2.0):本文第五节的提示词原文出自
src/geo_functions.py - GEO-bench 数据集、公开排行榜
- 项目主页
- 同方向背景:Liu et al., Evaluating Verifiability in Generative Search Engines(arXiv:2304.09848),论文的 2 步装置与答案生成 prompt 沿用自此
数据来源为论文正文、附录 A–C 的表 1–7,以及官方仓库的 src/geo_functions.py。所有相对提升百分比是我用 Table 1 的基线与各方法分数计算的;标注为“推断”或“猜测”的部分是我的解释,不是论文结论。Perplexity 一节的数字来自论文 Table 7(200 条样本),与 Table 1 不可直接比较。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- vLLM:每次重写,改的都是同一本显存账
- Diagram Design:50 种图表是目录,能拒绝你的检查才是产品
- gpu-unlock:GeForce 的半速矩阵算力,写死在八个 4 位字段里
- Octop:单进程是它的地基,也是它的天花板
- VoiceStudio:把 ElevenLabs 搬回本地之后,账单换成了许可证
- DroidDeck:手机跑 PC 游戏不难,难的是让 Android 相信自己正在当主机
- magpie:它调度的不是模型,是会过期的额度
- Aerial:换桌面不是画界面,是在别人的固件里抢前台
- colibri:同一个引擎 184 倍的速度差,全部来自权重住在哪一层
- HelixHarness:Harness 工程的两份契约,一份写成了协议,一份还没有数据