FreeToken:让消费级电脑跑起 284B MoE,一次把整机当成推理集群的系统设计
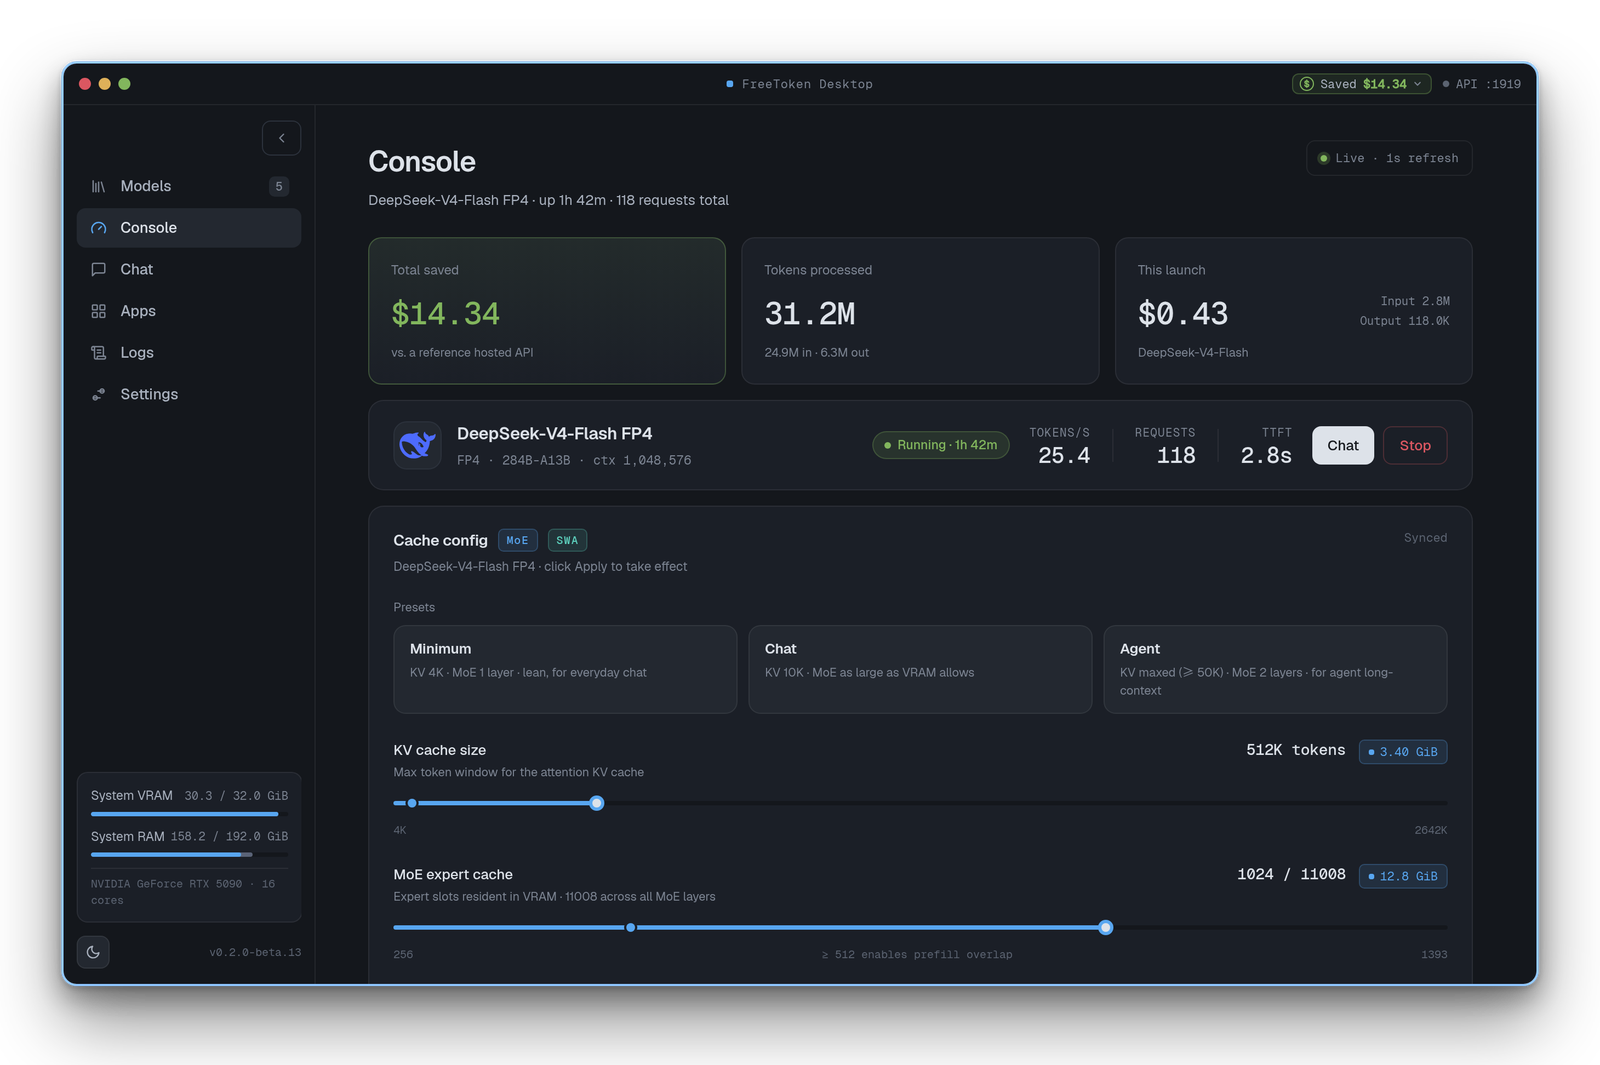
图片来源:FreeToken 仓库
先说一个数字:在 32GB 显存的游戏台式机上,跑 284B 参数的 DeepSeek-V4-Flash;在单张 96GB 工作站 GPU 上,跑 753B 的 GLM-5.2。
不是量化到 2bit 的玩具版本,是能接 Codex、Claude Code 这类真实 agent 的推理服务。
这件事听起来像营销话术,但它背后有一篇正经的系统论文:FreeToken: Efficient Edge-Native MoE Serving with Bandwidth-Adaptive Execution(arXiv 2608.16157,2026 年 8 月),作者来自 Berkeley、MIT、UT Austin 等机构,包括 Ion Stoica、Matei Zaharia、Song Han、Kurt Keutzer。
开源仓库:FlashML-org/FreeToken,Apache-2.0。
这篇文章想讲清楚一件事:为什么“把模型卸载到 CPU”这种老思路不够用,以及 FreeToken 换了一套什么样的资源观。
一、本地推理的真正瓶颈,从来不只是显存
先把常见误解拆掉。
“跑不动大模型”通常被归因于显存不够。于是直觉方案是:权重放 CPU 内存,用时搬到 GPU。llama.cpp 的 --n-gpu-layers、KTransformers 的专家放置,本质都在这个框架里。
但这个框架有一个隐含假设:瓶颈是容量。
真实的瓶颈是带宽,而且不止一种带宽。
看一组数字就够了:
| 资源 | 典型带宽 |
|---|---|
| RTX 4090 / 5090 显存 | 1–1.8 TB/s |
| 双通道 DDR5 系统内存 | 80–90 GB/s |
| 双通道 DDR4 系统内存 | ~50 GB/s |
| PCIe 5.0 ×16 | ~60 GB/s |
| PCIe 4.0 ×16 | ~25 GB/s |
| 笔记本常见的 ×8 链路 | 更低 |
显存和系统内存之间有 10–20 倍的带宽差。这意味着:一旦某个专家的权重不在显存里,它要么走 PCIe 搬过来(慢一个数量级),要么就地用 CPU 算(也慢一个数量级)。
所谓“卸载”,只是把慢的那一步藏起来或者摊薄,并没有消除它。
FreeToken 的出发点不是“怎么卸载得更好”,而是:在给定这台机器的实际带宽组合下,每一步应该把多少工作分给谁。
这是一个调度问题,不是一个容量问题。
二、MoE:机会与麻烦是同一件事
MoE 让前沿模型在消费级硬件上“有可能”运行,原因很简单:总参数量 ≠ 每个 token 的激活参数量。
论文里给了 DeepSeek-V4-Flash 的具体结构:
- 43 层,每层 256 个 routed experts;
- 每个 token 只激活其中 6 个;
- 总参数 284B,单 token 实际参与计算约 13B。
13B 的激活权重,在部署精度下能塞进 RTX 5090 的 32GB 显存。
但紧接着就是那个转折:
稀疏性降低了每个 token 的计算量,却没有按比例降低存储完整专家池所需的内存。
也就是说,显存里放得下“这次要算的”,放不下“可能要用到的”。 剩下那 271B 的专家,必须待在主机内存里,按需进入执行路径。
于是问题的形状变得非常具体:
              Router(GPU 上)
                    │
          ┌─────────┴─────────┐
          ▼                   ▼
   命中显存的专家        未命中的专家
   (直接 GPU 算)            │
                    ┌────────┴────────┐
                    ▼                 ▼
              PCIe 搬到 GPU      留在 CPU 上算
              (占链路带宽)      (占内存带宽)
关键洞察在这里:这两条路不是互斥的,它们消耗的是同一种资源——主机侧内存带宽。
三、三个阶段,三种不同的失败模式
论文把边缘 MoE 服务拆成三个阶段,每个阶段的瓶颈完全不同。这个拆法本身就是全文最有价值的部分之一。
1. Prefill:稀疏性在这里失效
Decode 时每个 token 只碰 6 个专家,但 prefill 一次要处理几千个 token。
几千个 token 的路由并集,几乎覆盖每一层的全部专家。于是:
prefill 阶段实际会把整个专家池流过一遍 CPU–GPU 互联链路。
论文给了一个很具体的账:DeepSeek-V4-Flash 的 FP4 部署,prefill 需要搬运约 140GB 专家权重。
| 平台 | 链路带宽 | 搬运耗时 |
|---|---|---|
| RTX 5090(PCIe 5.0 ×16) | ~60 GB/s | ~2 秒 |
| RTX 4090 / 3090(PCIe 4.0 ×16) | ~25 GB/s | ~5 秒 |
| 笔记本常见 ×8 链路 | 更低 | 10 秒以上 |
对一个“边想边调工具”的 agent 来说,每一轮都多等 2–10 秒,体验直接崩塌。
更麻烦的是第二个成本:重算。
现代前沿模型大量使用混合注意力——DeepSeek-V4-Flash 交替使用全注意力和滑动窗口注意力,Qwen3.6-35B-A3B 用了 gated DeltaNet,Kimi-K3 用了 Kimi Delta Attention。
这类层把整段历史压缩成一个状态。好处是省内存,坏处是:这个状态没法部分复用。
而 agent 框架几乎每轮都在改上下文:
- OpenClaw 会剥掉除最新一轮外的 thinking 块;
- OpenCode 把窗口之外的工具输出替换成占位符;
- SWE-agent 只保留最近 n 条观察。
改完之后,改动位置之后的所有 checkpoint 全部失效,引擎只能回退到最后一个有效点,把中间几千个 token 重新 prefill 一遍。
在消费级 GPU 上,这段重算藏不住——RTX 5090 的稠密 BF16 吞吐大约只有 H100 的五分之一、B200 的十分之一。
2. Decode:命中率与 CPU 上限
Decode 是相反的形态:稀疏,但每一步都可能 miss。
现有引擎的做法是静态放置:加载时决定哪些专家放 GPU,其余留 CPU。问题是路由随 token、随任务变化,预填充时定下的布局,很快就与实际流量脱节。
那“全部交给 CPU 算”行不行?也不行。
论文算了一笔很干脆的账:decode 小批量时专家计算是内存带宽受限的,每个 token 要把路由到的专家权重完整读一遍。消费级 CPU 挂的是双通道内存,DDR5 也就 80–90 GB/s,而 GPU 显存是 TB/s 级。
结论:CPU-only 路径的速度上限,与核心数无关,只由内存带宽决定。
3. 资源管理:边缘设备上没有“专用”
数据中心里 GPU 是独占的。个人电脑不是。
浏览器、桌面合成器、游戏,随时可能抢走几个 GB 显存。于是:
- 可用显存每次启动都不一样;
- 运行过程中还会动态变化;
- KV Cache 随上下文增长,专家缓存的需求却基本恒定——启动时算好的划分,几十轮之后必然失衡。
再加上一个容易被忽视的成本:启动。140GB 的专家池,从 7GB/s 的 NVMe 读一遍就要 20 秒,还没算预热。
而边缘用户的行为模式是:用的时候打开,不用就关掉;换个模型也重启一次。
四、FreeToken 的核心结构:两级专家内存
面对这三个问题,FreeToken 的架构选择是:不做“部分卸载”,而是把 GPU 剩余显存做成一个全局共享的弹性专家缓存。
GPU
 ├── 非专家权重(常驻)
 ├── KV Cache(分页)
 └── 全局专家缓存(弹性,所有层共享)
       └── 每个 slot = 一个 (layer, expert)
            ▲
            │  PCIe
            ▼
CPU 内存
 └── 完整专家池(source of truth,常驻且 pin)
两个设计决定值得单独说:
第一,缓存按逻辑 (layer, expert) 寻址,而不是按张量分片。 一个 slot 装的是评估某个 (layer, expert) 所需的全部张量(gate、up、down 投影)。这样驻留、查找、执行都围绕同一个逻辑标识,而不是一堆碎片的拼装。这也直接决定了后面 FTW 格式的设计。
第二,CPU 池是唯一真相源(source of truth)。 这一条是整个弹性内存管理的前提:GPU 显存只影响性能,永远不影响正确性。 缓存可以随时被重建、缩小、清空,模型输出不变。
五、Prefill:把搬运藏在计算背后
既然 prefill 注定要搬完整层专家,那就别按需搬,按层搬。
FreeToken 采用 全层双缓冲(full-layer double buffering):
时间 ────────────────────────────────────────►

Buffer A:  [GPU 计算 layer l  ] [加载 layer l+2]
Buffer B:  [加载 layer l+1   ] [GPU 计算 layer l+1]
                  ▲
             两者交换角色
关键点在于它加载的是完整一层,而不是“这一层被路由到的专家”。
这个选择初看很浪费,但它是刻意的:
- 加载可以在路由结果出来之前就开始,流水线不会断;
- 传输流与计算流并行,互相不等待;
- 缓冲区与 decode 的专家缓存共用同一个 slot 池,没有独立的 prefill 缓存,也没有阶段切换的握手成本。
论文特别提到一个细节:prefill 期间留在缓存里的条目,会直接成为 decode 阶段的热数据。这是一次免费的热启动。
当然有兜底:如果 slot 池腾不出两个整层,FreeToken 退回按需加载,而不是硬撑到显存溢出。
语义锚点:让 recurrent state 熬过上下文编辑
第二个问题——重算——解法更巧妙。
全注意力层的 KV 可以用 radix 前缀树复用,这是 SGLang 一类系统的标准做法。但 recurrent 层不行:它把整个前缀压成一个状态,没法部分复用,只能靠 checkpoint。
而 checkpoint 很贵:一个状态占的内存相当于几百个 token 的 KV,所以只能存很少几个。存在哪里,决定了它们值不值钱。
FreeToken 的答案是:存在语义边界上。
具体说,就是那些特殊 token 标记出来的位置——thinking 段的起止、工具调用、工具输出、对话轮次。理由很直接:agent 框架的编辑,本质上就是整块地删除或替换这些边界之间的内容。
- OpenClaw 剥 thinking 块;
- OpenCode 换工具输出;
- SWE-agent 删旧观察。
它们删的都是“特殊 token 划定的整块”,而编辑点之前的前缀被原样保留。
于是,锚定在语义边界上的 checkpoint,存活概率远高于随机位置。当一次编辑发生后,引擎从“最深的、位置仍然有效的锚点”恢复:
原始上下文:  [轮1][thinking][工具调用][工具输出][轮2]...
编辑后:      [轮1][thinking][工具调用][✂ 截断][新增内容]
                                    ▲
                            从这里的锚点恢复
                            只重算新增的后缀
全注意力层从前缀树复用 KV,recurrent 层从锚点恢复状态,只有真正新增的后缀需要 prefill。
这是全文我认为最“懂 agent”的一个设计:它不是从模型结构出发的优化,而是从agent 框架实际怎么改上下文反推出来的。
六、Decode:q* 策略,一个公式解决所有硬件
现在到了最核心的部分。
假设某一层有 $m$ 个专家未命中。这些专家可以:
- 走 PCIe 搬进显存,在 GPU 上算,并留在缓存里供以后复用;
- 留在 CPU 上就地算,不改变缓存状态。
问题是:$m$ 个里面,几个该搬,几个该就地算?
FreeToken 的推导很干净。令 $S$ 为单个专家的字节数,$B_P$ 为实测的 PCIe 专家传输带宽,$B_H$ 为实测的 CPU 侧专家处理带宽。
关键前提:两者读的是同一套主机内存。 所以当 PCIe 跑满时,留给 CPU 的残余带宽是:
\[B_R = \max(B_H - B_P,\ 0)\]于是两条并行分支的耗时分别是:
\[T_{\text{fill}}(q) \approx \frac{qS}{B_P}, \qquad T_{\text{cpu}}(m-q) \approx \frac{(m-q)S}{B_H - B_P}\]令两者相等,就得到最优切分:
\[q^{\star} \approx m \cdot \frac{B_P}{B_H}\]这就是 q* 策略。
它有几个很漂亮的性质:
第一,它自动覆盖所有硬件形态。 当 $B_H$ 接近 $B_P$(比如链路极快、内存极慢),$q^\star \to m$,系统退化为“全部搬进缓存”,不需要单独的执行分支。反过来,当 PCIe 很慢而内存带宽充裕,$q^\star$ 变小,更多专家留给 CPU 就地算。
第二,它把“这台机器上该怎么分工”变成一个可测量的量。 $B_P$ 和 $B_H$ 都是部署时在目标硬件上实测的,用的是实际的张量形状,不是规格书上的理论值。论文特别强调这一点:最优配比读不出来,只能量出来。
第三,两条分支的结果可以精确合并。 CPU 和 GPU 各自算部分和,然后相加。没有近似,没有精度损失。 这一点很重要——很多“异构推理”方案在这里就开始丢数值一致性了。
代价是复杂度:调度逻辑、miss 检测、受害者选择全部要放进 CUDA Graph 里,否则每个 MoE 层都要一次主机同步,性能直接归零。
论文的解法是把所有路由相关的控制流变成 GPU 上的数据:一个 kernel 完成去重、驻留判定、算 $q$、选受害者、把逻辑 ID 重写成物理 slot ID 或“交给 CPU”标记。受害者选择用单趟扫描一次找出 $K$ 个 LRU 候选,避免“每淘汰一个扫一遍全缓存”的经典陷阱。
CPU 分支也被捕获进同一张图:固定的 pinned I/O 缓冲、持久化的任务描述符、host function 提交节点,重放时整条异构流水线一次跑完,不需要每个 token 过一次 Python。
七、弹性内存与 FTW:让“启动”和“调整”不再昂贵
三个机制,对应三个现实约束。
1. 运行时重建缓存。 在调度器的安全点上,FreeToken 可以按新的显存预算重新划分并重建 GPU 专家缓存,不需要重启引擎,也不需要重新加载 CPU 侧的专家池。
因为 CPU 池是真相源,这一步天然安全:缓存没了,性能降一点;缓存回来,性能恢复。正确性始终不受影响。
2. 快速启动。 传统做法是:先 pin 一块空内存,再从磁盘读数据填进去。问题是 pin 之后写入会触发缺页和清零,几个 GB 白白浪费。
FreeToken 反过来:先从磁盘直接读进最终的主机布局,读完再 pin。 再加上“冷缓存直接服务第一个请求”(第一次 miss 走正常 decode 路径,缓存自然热起来),预热阶段被整个删掉。
3. FTW 权重格式。 FTW(FreeToken Weight)不是量化算法,而是一种预排版格式。
模型原始 checkpoint 的专家权重是散落在各处的张量。FreeToken 在转换时就把它们按运行时 bank 布局合并好,用 layer × E + expert 作为首维。加载时不需要再做张量发现和重排,直接按对齐块并行直读进预先算好大小的 bank。
前面说的“逻辑 ID 统一”在这里兑现:GPU kernel 和 CPU 执行器共享同一套专家身份,所以一份索引列表可以同时驱动所有 bank 的传输,一次固定形状的 launch 搞定。
八、实测:数字比架构更能说明问题
论文在 6 台机器上做了评测,从 8GB 的 RTX 4060 笔记本到单张 RTX PRO 6000(96GB),跑了 4 个真实 agent 工作负载,对比 llama.cpp、Ollama、KTransformers 和 MoE-Infinity。
| 场景 | 结果 |
|---|---|
| RTX 5090 跑 Qwen3.6-35B-A3B | 77–83 tok/s |
| RTX 5090 跑 DeepSeek-V4-Flash(284B) | 22–25 tok/s |
| 相对 SOTA 边缘引擎 | 1.5–2.3× decode 吞吐 |
| 8GB RTX 4060 笔记本跑 35B | 39.3 tok/s(超过 Codex 生产流量的中位数 33 tok/s) |
| 32GB 游戏台式机 | 可交互地服务 284B 模型 |
| 单张 RTX PRO 6000 | 服务 753B GLM-5.2,约为 llama.cpp 的 2 倍 |
| 五台消费级机器的整体提升 | 1.3–2.1× |
还有两个数字很能说明工程完成度:
稳定性。 从单轮对话切到多轮 agent,FreeToken 的 decode 速率保持在单轮设置的 12% 以内,而对比系统明显退化。原因不难理解:agent 负载的核心特征是“上下文频繁被编辑”,而这正是语义锚点要解决的问题。
尾延迟。 FreeToken 在所有负载下的最差 TTFT 都低于 44 秒;而每个基线都至少有一个设置超过 150 秒——足够让真实的 agent 客户端触发超时。
这两个数字比平均吞吐更有意义。边缘推理的体验由最差的那一次决定,不是由平均值决定。
九、怎么上手
两条路径,覆盖两种使用习惯。
桌面端。 从 flashml.ai 下载 Windows 或 Linux 版本,安装器会把引擎和依赖配置好,界面里可以直接跑模型、对话、调推理参数。对不想碰命令行的用户,这是主要入口。
命令行。 用 uv 安装(推荐):
uv pip install "freetoken[accel]"
或者从源码构建:
git clone https://github.com/FlashML-org/FreeToken.git
cd FreeToken
uv venv && source .venv/bin/activate
uv pip install -e ".[accel]"
装完之后最关键的一点:FreeToken 对外提供 Anthropic / OpenAI 兼容的 API。 这意味着 Codex、Claude Code、OpenCode、OpenClaw 这类现成的 agent 客户端,改个 base URL 就能接过来用。
模型清单、CLI 参数和故障排查都在仓库 docs/ 下,其中「加载失败」有一份专门的诊断脚本,对第一次跑大模型的人来说挺实用。
十、和现有方案到底差在哪
| 维度 | llama.cpp / Ollama | KTransformers | FreeToken |
|---|---|---|---|
| 专家放置 | 加载时确定 | 预热专家 pin 在 GPU | 运行时 LRU 跟随路由 |
| Prefill | 按需取专家 | 部分优化 | 全层双缓冲流水 |
| miss 处理 | 单一路径 | CPU 为主 | q* 按带宽切分 |
| 显存调整 | 需重启 | 需重启 | 安全点热重建 |
| 上下文编辑 | 回退重算 | 回退重算 | 语义锚点 + 前缀树 |
| 权重格式 | GGUF | 自有 | FTW(预排版 bank) |
公平地说,llama.cpp 的 GGUF 生态和跨平台能力仍然是 FreeToken 短期比不了的;KTransformers 在特定 CPU 平台上做了很深的内核优化。FreeToken 的差异化在于它把“这台机器有多少带宽”当成一等公民,而不是把所有机器都当成“小一号的数据中心 GPU”。
论文自己也承认借鉴了很多:架构上跟随 SGLang/vLLM 的 GPU-centric serving,复用了 FlashInfer、flash-linear-attention 的 kernel,也参考了 mini-sglang 的设计。
十一、边界:这套东西不适合什么
写完优点,得写清楚它不解决什么。
1. “能跑”不等于“跑得快”。 5090 上 22–25 tok/s 的 284B,是“可用”级别,不是“流畅”级别。对比一下:跑 7B 模型能到几百 tok/s。
2. 它对硬件有明确偏好。 RTX 30/40/50 系列,CUDA 环境,足够的 PCIe 带宽。PCIe ×8 的笔记本链路会让 prefill 传输成本翻几倍——q* 能优化 decode,但优化不了物理带宽。
3. 内存容量仍然是硬门槛。 284B 的 FP4 权重约 140GB,需要相应的主机内存。显存小可以靠缓存策略缓解,内存小是没救的。
4. 平台兜底路径会明显变慢。 当系统无法 pin 内存或注册 DMA 时(某些操作系统和驱动配置),FreeToken 退回纯 CPU MoE 后端:专家全在可分页内存里,只有激活值过 PCIe。能用,但放弃了快路径的全部收益。
5. 单机优化,不是分布式。 它的目标是“把这台机器榨干”,不是“把几台机器连起来”。多机场景它没有优势。
6. 前沿模型的适配需要持续投入。 20+ 个 MoE 模型的适配列表听起来不少,但每出一个新架构(新的注意力变体、新的专家路由方式),适配层就要跟进。
十二、总结:边缘推理的重心正在从“容量”转向“带宽”
FreeToken 最值得学的地方,不是某个具体技巧,而是它重新定义了问题。
传统思路问的是:怎么把放不下的权重塞进去? FreeToken 问的是:在给定的带宽组合下,每一步的工作该分给谁?
这个转变带来了一整套连锁设计:
- prefill 因为“注定要搬完整层”,所以干脆按层流水,把搬运藏进计算;
- decode 因为“两条路抢同一份内存带宽”,所以用一个 $q^\star = m B_P / B_H$ 的公式精确切分;
- 上下文因为“agent 是按语义块编辑的”,所以把稀缺的 checkpoint 预算花在语义边界上;
- 显存因为“随时会被别的应用抢走”,所以把它做成可热重建的弹性资源。
四条设计,对应四个从真实使用场景里长出来的观察。这不是“把数据中心方案缩小”,而是为边缘设备重新推导了一遍服务栈。
如果说前几年本地推理的竞争是“谁的量化更狠”,那么接下来的竞争可能是:谁更懂这台机器。
项目与参考资料
- GitHub 仓库
- 论文:FreeToken: Efficient Edge-Native MoE Serving with Bandwidth-Adaptive Execution
- 官网与桌面端下载
- 安装文档
- 快速开始
- 支持模型列表
项目采用 Apache License 2.0。本文数据来自论文摘要与正文、仓库 README,性能数字对应论文的测试环境,实际表现取决于 CPU、内存容量与带宽、PCIe 链路、量化格式和上下文长度。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- TransformerLens:打开大模型的黑盒,用 Hook 和因果干预研究 Transformer 内部
- Sub2API:把 Claude、OpenAI、Gemini 统一接入,一个开源 AI API 网关的设计与边界
- Train LLM From Scratch:从零开始训练自己的大语言模型
- DeepSeek-V4.1-Flash-1017-Uncensored:不重新训练模型,直接修改权重,让 AI 改变回答行为
- Idol:一张图片生成百万级 3D 高斯模型,AI 正在重新定义三维建模
- Windows 上「保存失败」:文件被占用时原子替换为什么会报错
- 一次 CSS 压缩把整站布局打散
- 把个人站从「魔改模板」改成「薄启动器」
- 从这里开始