colibri:同一个引擎 184 倍的速度差,全部来自权重住在哪一层
同一个引擎,同一份 int4 权重,同一个模型。
GLM-5.2,744B 参数。在 6 张 RTX 5090 上把专家全部驻留,解码 9.0–9.2 tok/s;同一份权重放在一台 25 GB 内存的笔记本上,专家全部从盘上读,0.05–0.1 tok/s。
两个端点是 184 倍。按最保守的取法(9.0 与 0.1)也有 90 倍。
变的只有一件事:每个被路由到的专家,住在 VRAM、RAM 还是 NVMe。
- 源码:JustVugg/colibri(Apache 2.0,Copyright 2026 Vincenzo Fornaro)
- 文档:justvugg.github.io/colibri,以及仓库里的
docs/ - 规模:13 个引擎(10 个语言模型、1 个图像生成、2 个决策模型),纯 C,无 BLAS,运行时没有 Python 深度学习栈
本文只讲一件事:它怎么把「权重放在哪」变成一个可测量、并且被自己证明「只影响速度」的变量。
一、一个 MoE 的三本账
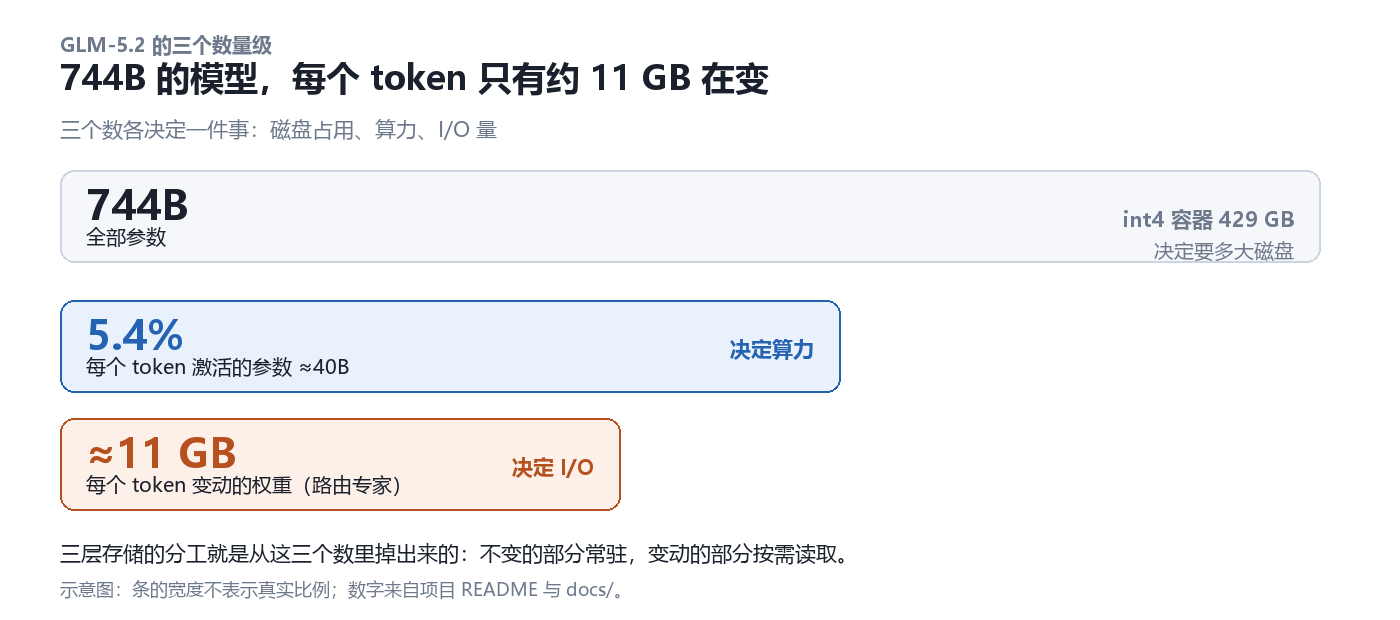
这三条一起决定了整个设计的形状:第一条决定磁盘,第二条决定算力,第三条才决定 I/O。
README 里最关键的三个数字是这么排的:
| 数字 | 含义 | 它决定什么 |
|---|---|---|
| 744B | 总参数,int4 容器 429 GB | 要多大磁盘 |
| ≈5.4% | 每 token 激活的参数,约 40B | 算力 |
| ≈11 GB | 每 token 变动的权重,即被路由到的专家 | I/O 量 |
这组数字推翻了一个默认前提。我们习惯问「这个模型能不能装进显存」,而 MoE 的问法是「哪一部分必须常驻」。
dense 部分(attention、共享专家、embedding)每 token 都要用,留在 RAM;routed 专家只在 router 选中时才需要,放在盘上,用时再读。模型不必装进快内存,它必须被放置。
这也解释了为什么这套设计只对 MoE 成立。dense 模型每个 token 都要过全部权重,「分层」就退化成把同一份东西换个地方放,没有可用的稀疏性。
二、一个模型家族,一份 .c
先说架构,因为它决定了这个项目能长到多大。
每个模型家族一个 C 文件,共享底层头文件。 c/colibri.c 是 GLM-5.2/5.3(也跑 Mistral-Large-4),c/glm53.c 是 GLM-5.3-Flash,c/kimi_k3.c 是 Kimi K3;专家缓存、量化、Tokenizer、GGUF 读取、GPU 后端都在共享的 expert_store.h、quant.h、tok.h、backend_*.c 里。
一个引擎只拥有自己的架构,两个引擎都需要的东西沉到一个头文件里——于是修一次,十个引擎一起受益。
这不是个次要的工程决定。它让「支持一个新模型」的成本变成「写一个 attention + router」,而不是「把模型塞进一个通用图编译器」。
目前它跑的东西,按下载体积排:
| 引擎 | 模型 | 下载 | RAM 下限 |
|---|---|---|---|
kimi_k3 | Kimi K3(2.8T) | 1.56 TB | 32 GB |
mimo | MiMo-V2.6 Flash(309B)/ Pro(1.02T) | 172 / 564 GB | 32 / 54 GB |
inkling | Inkling(975B) | 514 GB | 120 GB(dense 转换后 25 GB) |
deepseek_v4 | DeepSeek V4 Flash(284B) | 167 GB | 16 GB |
deepseek_v41 | DeepSeek V4.1 Flash(552B) | 510 GB | ≈18 GB + 专家缓存 |
colibri | GLM-5.2(744B)/ GLM-5.3 | 429 / 419 GB | 16 GB |
glm53 | GLM-5.3-Flash(321B) | 328 GB | 25 GB |
qwen38 | Qwen3.8-Flash-Next(125B + 51B n-gram) | 186 GB | 24 GB |
qwen36 | Qwen3.6-35B-A3B(也跑 Qwen3-Coder、Qwen3.8-27B、Flint、Muse Spark、LFM3-VL) | 23 GB | 10 GB |
olmoe | OLMoE(7B) | 14 GB | 8 GB |
qwenimage | Qwen-Image-2.1 | 33 GB | 12 GB |
laya / gliner_decide | 两个决策模型 | 0.85 / 1.95 GB | 1.7 / 1.9 GB |
「RAM 下限」是官方表格里的第一个数:低于它模型起不来。这个数字与下载体积几乎脱钩——1.56 TB 的 Kimi K3 只要 32 GB 就能启动。这是这张表里最值得看的一行。
用起来是三步:./start-here.sh 探测硬件、推荐一个能跑的模型、构建引擎、下载权重;./coli chat / web / serve 分别起终端、界面与 API;手上已有 GGUF 的话,./coli import xxx.gguf 直接导入,不重新量化。
三、每个 token 的每一层,都走五个动作
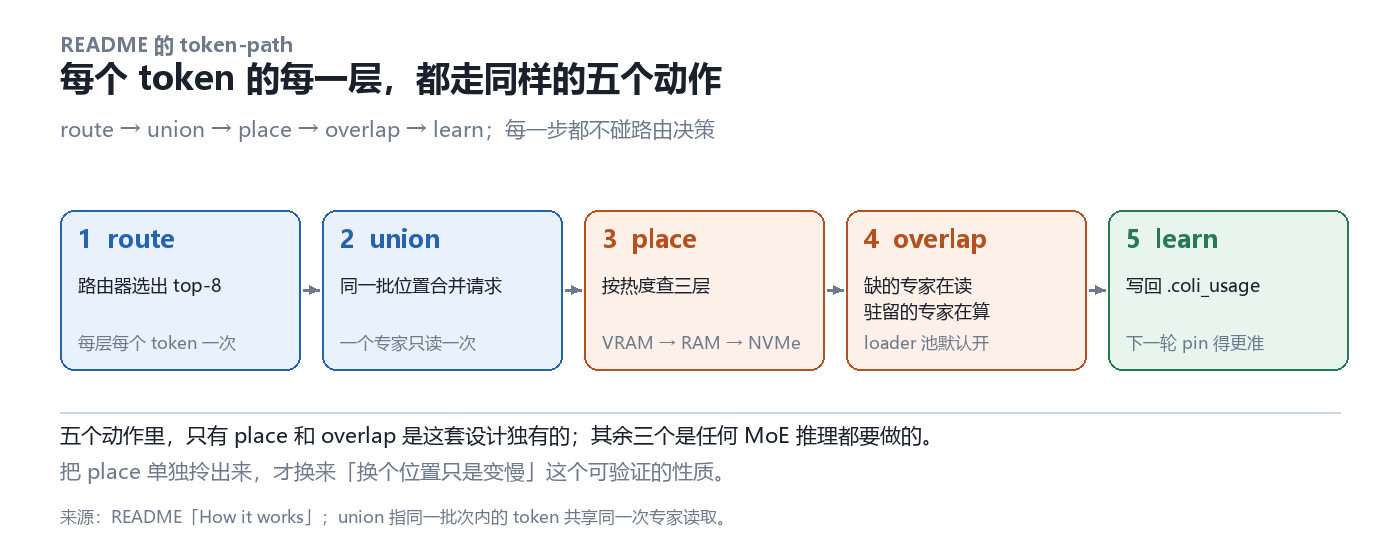
README 把这条路径画成一张图。五个动作里,只有 place 和 overlap 是这套设计独有的。
- route:router 选出 top-k 专家。这是模型自己的决定,引擎不许改。
- union:同一批次里多个位置命中同一个专家时,只读一次。长 prompt 的 prefill 阶段,省下的是同一份权重的重复读取。
- place:按热度查三层,命中就从 VRAM / RAM 拿,没命中就从盘上读。
- overlap:没命中的专家在读的同时,已驻留的专家在算。
- learn:这一轮的路由结果写回
.coli_usage,下一轮 pin 得更准。
第 2 步容易被忽略,但它是「一个专家三块矩阵一次 pread」的前提:gate / up / down 三块权重被组织成一次顺序读,不是三次随机读。
四、三层,和一个会过拟合的缓存
官方把这个机制叫 JIT for weights:编译器不会提前编译整个程序,它观察什么在跑,把热路径编译掉;colibri 观察什么专家在被路由,把热的那些留在快的地方。
规则本身不复杂:每层一个 LRU,加上一个从你自己的对话里学出来、pinned 住的热点集合(.coli_usage,每轮更新)。--policy balanced 之下还会在安全边界做实时替换——一个 LFRU 分数混合衰减的会话频率与最近访问,25% 的滞回,一次最多换四个,防止层间抖动。
三层各自装什么,README 写得很具体:GPU 存最热的专家和 dense 层(Vulkan 下分「专家层」与「dense 链」两件事,后者把整层记成一次提交,运行状态留在卡上);RAM 装 dense 主体、KV 和 LRU 缓存得下的专家;NVMe 装剩下的一切。GLM-5.2 的 RAM 下限是 16 GB、推荐 24 GB——在这台机器上,常驻的只能是 dense 与最热的一小撮专家,其余全部留在盘上。coli plan 会把三层的大小、每个放置的理由和预期瓶颈打印出来,coli doctor 只读地检查一遍。
真正有意思的是官方自己给出的那张覆盖率表。用 Qwen3.6 的历史(每个 int4 专家 1.7 MB)算「pin 多少内存能覆盖多少历史路由」:
| pin 的内存 | 覆盖的专家比例 | 覆盖的历史路由 |
|---|---|---|
| 1 GB | 5.7% | 23.4% |
| 2 GB | 11.5% | 37.4% |
| 4 GB | 23.0% | 56.6% |
| 6 GB | 34.5% | 70.2% |
| 8 GB | 45.9% | 80.5% |
曲线的前半段是这套设计的全部说服力:11.5% 的专家覆盖了 37.4% 的选择。路由确实有结构。
然后是紧接着的那句注解,也是我认为这份文档最诚实的地方:覆盖率是在它自己的历史上算的,必然高估。用 holdout 换一份历史:官方的 Qwen3.8 profile 在自身上覆盖 70%,用同样的专家去跑同一模型的另一次会话,只剩 57.7%。
十二个点的落差,就是「学习型缓存」这个词的真实成本。它不是 bug,是这类方案的固有属性——而且官方把它写在了文档里,而不是留给别人去发现。
五、不等磁盘第二次
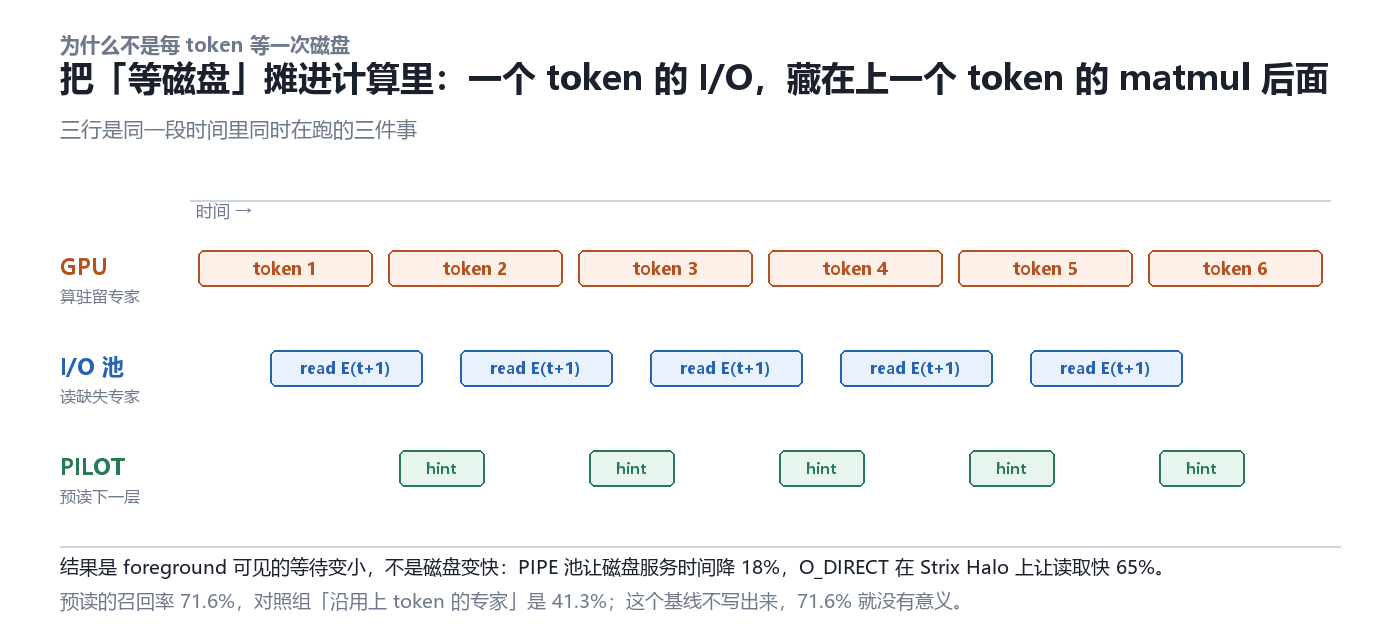
同一段时间里同时跑的三件事。I/O 不是被消除,而是被摊进计算里。
磁盘读一次,代价是一次;读两次,代价就翻倍。所以整套流水线都在避免第二次。
一个专家一次 pread。 三块矩阵排在一起读,不是三次寻道。
loader 池默认开着(PIPE=1)。 8 个 worker 读缺失的专家,驻留的照算,读完了再合进这一层。官方口径是磁盘服务时间降 18%,但真正重要的是前景可见的等待变小——[PROF] 会把这两个时间分开报,重叠是不是真的发生了,你不用猜。
路由预取(PILOT=1)。 把第 L+1 层的 router 套在第 L 层的 post-attention 状态上,能召回真实 top-8 的 71.6%。
这个数字必须配一个基线才有意义:对照组「沿用上一个 token 的专家」是 41.3%。不写基线的 71.6%,只是个好听的广告。
预取本身也有层级:PILOT=1 只发提示,PILOT_REAL=1 把预取的读移出关键路径(大缓存机器上命中率 +11 个百分点),PILOT_TWO=1 把共享专家的结果折进预测(召回 +3%)。
DIRECT=1(O_DIRECT)。 跳过 page cache,在 Strix Halo 上单这一项是 +65%。但在别的盘上是中性甚至更差——文档原话是「在你自己机器上测」。这句话不是免责声明,是这套系统的性质:收益几乎全部来自存储栈的具体形状。
同一份权重,可以来自两块盘
读不动的时候还可以加盘。COLI_MODEL_MIRROR=/second/glm52_i4 让第二块盘持有一份副本,两块独立控制器的 NVMe 实测 +37.5% 解码。
注意后面的限定:加第三块更慢的盘,在加权条带之后是中性的。带宽够了之后,瓶颈换成了调度,不是盘的数量。
往上还有 COLI_NUMA=1——多路机器上把常驻权重摊到各个内存控制器,6 张 5090 上从 5.8–6.8 到 9.0–9.2;以及 cluster 模式,把 routed 专家放到别的机器上。分层从 NVMe 一路延伸到网络,机制是同一个。
六、那条纪律
这一节是全文的重点,也是我认为这个仓库最值得学的地方,而不是它的 184 倍。
README 里有一句承诺:权重住在哪里只改变答案来得多快,不改变是哪些权重、哪些路由决策产出了这个答案。
大多数 offload 方案也这么写,但写完就完了。colibri 把它变成了可执行的判据。
coli tune 会在一台机器上扫一遍调度参数(线程数、NUMA、I/O 重叠、direct I/O、专家缓存大小……),但候选要过四道门才会被保存:
- 中位吞吐至少 +3%;
- 专家命中率变化在 0.5 个百分点以内;
- TTFT / p99 在基线的 20% 以内;
- 最后,每一道 prompt 的 greedy 输出必须逐字节相同——任何一个字节的漂移,直接取消资格。
还有一条我不太在别处见到的收尾:胜出的候选会被重新跑一遍,然后再跑一次基线,用倒序把热缓存剩下的一点便宜还给基线。启动漂移不算优化。
再往外还有两层:每个引擎在 CI 里对着参考实现逐 token 核对;coli plan 默认走 --policy quality,不动量化也不动 top-k。
然后它自己写下了「这条纪律在哪里不成立」,带数字。
-
--topp 0.7:自适应的专家 top-p,少读 30–40% 的磁盘,有损,会打警告。 -
DEGRADE_ZERO=1:预取超时的时候,把 gate 权重低于阈值的专家槽零填充而不是读盘。OLMoE 上阈值 0.03 时约 22% 的槽被清零,perplexity +2.9%;0.05 时约 60%,perplexity +41%。只对 decode 生效(prefill 掉专家会污染 KV cache),而且 GLM-5.2 与 Kimi K3 的对应工作点没有测过——文档原话就是这么写的。 - 还有一处不是例外、而是数值现实:GPU 上加法顺序不同、部分激活保留 f32,所以一段长回答可能和 CPU 的结果差一个词。Vulkan 路径由 CI 用软件驱动对拍。
三处都是「我知道这里会变,我把变化量写出来」。
这套做法比任何 benchmark 表更能说明一个推理引擎的成熟度:它把「优化」和「改模型」分开了,并且给前者装了一扇只能出不能进的门。
七、184 倍那张表
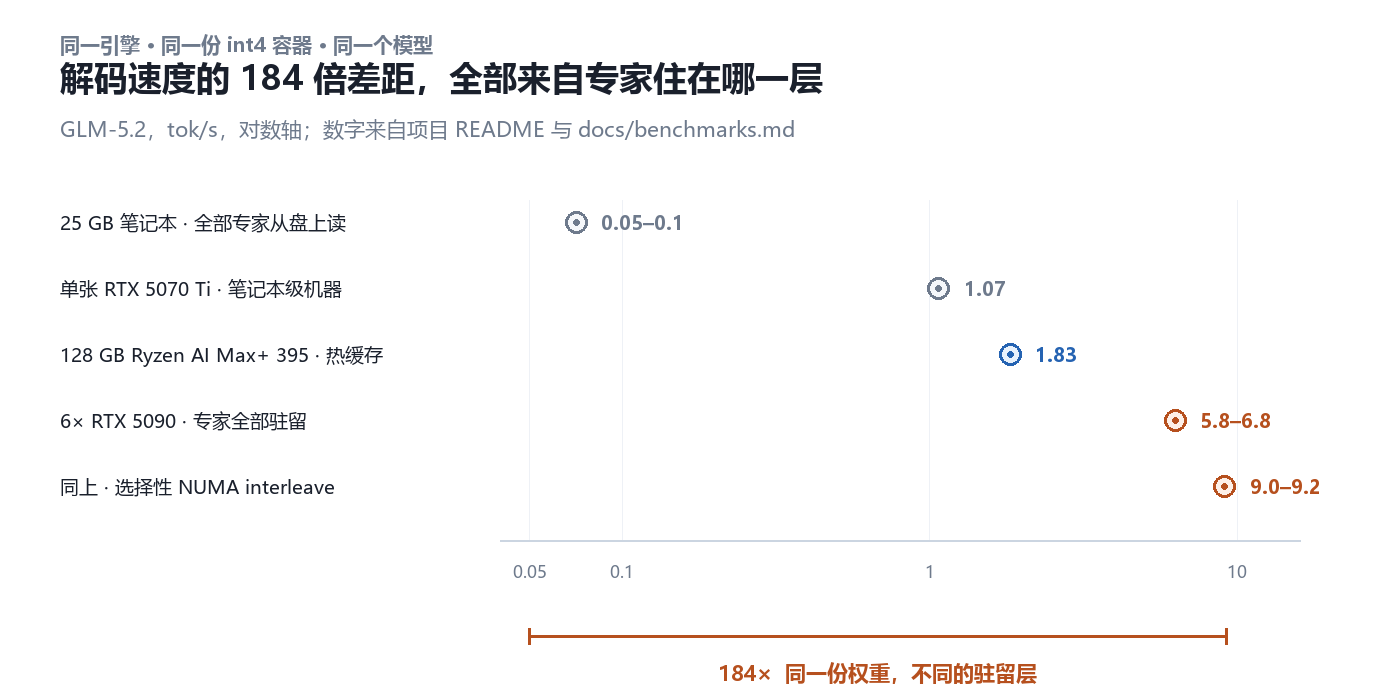
同一引擎、同一份 int4 容器、同一个模型。唯一的变量是专家驻留在哪一层。数字来自 README 与 docs/benchmarks.md,不是同一台机器上的受控对比。
| 机器 | 专家住在哪 | 解码 tok/s |
|---|---|---|
| 25 GB 内存笔记本(冷启动) | 全部 NVMe | 0.05–0.1 |
| 单张 RTX 5070 Ti,笔记本级机器 | 少数在 VRAM | 1.07 |
| 128 GB,Ryzen AI Max+ 395 | 热缓存,部分常驻 RAM | 1.83 |
| 6× RTX 5090 | 全部驻留 VRAM | 5.8–6.8 |
同上 + COLI_NUMA=1 | 全部驻留 + NUMA 交错 | 9.0–9.2 |
这张表最该被读成什么?
不是「25 GB 能跑 744B」——那是营销点,官方自己把 0.05–0.1 tok/s 叫作 honest floor,二十秒一个 token,能跑,不能聊。
该读成的是:放置不是一个微调旋钮,它是两个数量级。在显存里和在盘上,差的是「可交互」与「可运行」这两件事本身。
而且这个梯度不是均匀的。从全盘读到 128 GB 热缓存是几十倍;从热缓存到六张卡全驻留是三倍上下;再叠一个 NUMA 参数,一点四倍。每一步都在换瓶颈:先是 I/O 的次数,然后是带宽,最后是内存控制器的分布。
顺带说一件容易忽略的:这些数字全部由项目自己公布,来源分散在各个 docs/*.md 与 issue 里,测试条件不同。它证明的是「同一份权重在不同位置上的量级差」,不证明「colibri 比别的引擎快」——没有同机同模型的跨引擎对比。
八、同一套动作,用在 KV 上
这篇文章的论点是「放置」,但 colibri 里最漂亮的复用,发生在权重之外。
MLA 的压缩 KV。 GLM-5.2 的 attention 每个 token 只保留 576 个浮点,而不是 32,768——57 倍。这份状态以约 182 KB/token 追加写入磁盘,崩溃安全;关掉对话明天再开,零 re-prefill,官方称与不中断的会话逐字节一致。
PARK。 agent 两轮之间常有一个短请求(比如让它给这段对话起个标题),它不该把整个上下文状态抢走。COLI_PARK 把会话停在原地。Hermes Agent 的第二轮,14,810 个 token,从 86 秒降到 4.9 秒。
System One。 这个是同一个思路最直白的一次表达:把一次昂贵的读取变成一份可复用的快照。
{
  "state": "340 lines, 8 files, no tests.",
  "questions": {
    "review": {
      "type": "choice",
      "instructions": "What should the reviewer do?",
      "criteria": { "merge": null, "request changes": null, "close": null }
    }
  }
}
文档只读一次并 pin 住,之后每个问题只付自己的那几个词。四个问题共享一段指令块:45.7 秒一条,纯生成是 149.2 秒一条。
返回的不是一句话,而是每个选项的概率和一个 confidence,(n·peak − 1) / (n − 1):质量全压在一个选项上是 1,摊平是 0。终端里同时显示熵——低于 0.4 是确定,0.8 以上就该交给人。有一点必须说清楚:usage.output_tokens 统计的是模型读过的选项 token,它一个都没有生成。
同一份直觉,三次落地:权重读一次、会话状态存一次、文档读一次。贵的东西只读一遍,剩下的都是复用。
九、边界
- 稀疏才有分层。 dense 模型每 token 都要过全部权重,这套设计对它没有意义。
- 磁盘不是免费内存。 0.05–0.1 tok/s 是官方写明的下限;NVMe 的延迟和带宽仍然决定体验,colibri 做的是把读取和计算重叠,不是消除差异。
- 所有性能数字都是自测。 没有同机同模型跨引擎的对照,来源分散在 README、
docs/与 issue 里,条件各不相同。 - 「纯 C」指的是引擎。 运行时没有 BLAS、没有 Python 深度学习栈;但
coli启动器、setup_*.py、转换器和 OpenAI/Anthropic 网关都是 Python 3,安装与起服务时它必须在场。 - 每个模型保留自己的许可。 引擎是 Apache 2.0;GLM-5.2 的权重由 Z.ai 以 MIT 发布;Qwen-Image-2.1 只能非商用。
- 集显只在三个模型上默认开(Qwen3.6、Qwen3-Coder、Qwen3.8-Flash-Next)。OLMoE 这种专家本来就全在 RAM 的小模型,开 Vulkan 反而从 23.1 掉到 12.8 tok/s。
- 学习型缓存会过拟合你自己的历史。 70% → 57.7% 是官方数字,不是意外。
十、我的判断
三条可以验证的下一步,都来自项目自己列出的开放问题表。
一,跨会话的 A/B。「学习到的 pin 比纯 LRU 好」目前只有重复工作负载上的证据,官方自己标注了可能过拟合单个 prompt。需要的实验是 held-out、跨 coding / chat / 多语言 / 长上下文四类负载。工具已经在了(usage_coverage.py --holdout),缺的是多份真实历史。这一条用公开工具就能复现,不需要那张 5090。
二,多盘的收益曲线。 +37.5% 只有两个数据点,第三块慢盘在加权条带后是中性的。如果「带宽够了之后瓶颈换成调度」这个解释成立,那么更多盘、更慢盘的组合应该收敛到同一条线。这是个便宜的实验。
三,投机解码与放置的耦合。 开放问题表里有一行我盯了很久:MTP 在专家命中率约 85% 附近曾测到 32% 的损失。也就是说,当大部分专家已经在内存里,多猜几个 token 反而更亏——投机解码的收益依赖 cache 的温度,而 cache 的温度又由放置策略决定。这个 break-even 曲面目前只有零星几个点。
最后回到我上一篇写的东西。我写 MNN 的支持矩阵时,关心的是「同一个模型在不同后端上还是不是同一个模型」;colibri 把同一个问题往下推了一层:同一个模型在不同存储层上,还是不是同一个模型。
前者的答案是矩阵——逐格标出成熟度,C 格就写 C。后者的答案是门禁——输出差一个字节,优化就不许发布。
两种做法在回答同一件事:当一个系统开始为了速度做取舍时,它用什么方式证明自己还是原来那个模型。MNN 用一个愿意标 C 的表,colibri 用一道逐字节的闸。比起任何吞吐数字,这两样东西更难伪造。
项目与资料
- GitHub 源码(Apache 2.0):引擎、CLI、dashboard、桌面壳
- 项目主页:安装与模型目录
- README:三个数量级、五个动作、模型表与全部性能数字的出处
- docs/tuning.md:学习型缓存、覆盖率曲线、预取、
DEGRADE_ZERO、coli tune的判据 - docs/benchmarks.md:硬件阶梯与量化消融
- docs/multidisk.md、docs/cluster.md:多盘与多机
- docs/systemone.md:决策接口、快照与置信度
- docs/gguf.md:直接读已发布的 GGUF,不重新量化
文中所有性能数字均为项目公布值,我未在真机复现;架构、机制与判据核对自 README 与对应文档。184 倍取自公布区间的两个端点(0.05 与 9.2),按最保守取法是 90 倍。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- vLLM:每次重写,改的都是同一本显存账
- Diagram Design:50 种图表是目录,能拒绝你的检查才是产品
- gpu-unlock:GeForce 的半速矩阵算力,写死在八个 4 位字段里
- Octop:单进程是它的地基,也是它的天花板
- VoiceStudio:把 ElevenLabs 搬回本地之后,账单换成了许可证
- DroidDeck:手机跑 PC 游戏不难,难的是让 Android 相信自己正在当主机
- magpie:它调度的不是模型,是会过期的额度
- Aerial:换桌面不是画界面,是在别人的固件里抢前台
- GEO:最有效的三种写法,官方提示词里都写着“可以编造”
- HelixHarness:Harness 工程的两份契约,一份写成了协议,一份还没有数据