CineCode:每一帧都是时间的纯函数,所以电影可以被检查
一个 30 秒、30 fps 的短片是 900 帧。10 分钟就是 18,000 帧。
传统 AI 视频工具面对这个数字的办法是「让模型生成」,而 CineCode 的办法是:写一个函数,调用它 900 次。
renderFrame(t); // t = i / 30,i = 0 … 899
这个选择带来一个副作用,而它才是这个项目真正的价值:因为每一帧都是时间参数的纯函数,所以电影第一次变成了可以被测量、被重放、被逐帧检查的东西。
- GitHub:sarpstar/cinecode(MIT)
- 中文 README:README.zh-CN.md
- Skill 定义:SKILL.md · 镜头词典
本文只讲一件事:它怎么把电影里那些靠感觉的东西,翻译成 agent 跑一次就能知道过没过的检查项——顺便说清这么做的代价。
一、它不是视频模型,是一套装进 agent 的 Skill
CineCode 没有自己的模型。渲染画面不需要任何生成模型——画面是代码画出来的,所以没有模型成本。
它是一套 Skill:装进 Claude Code(或 Cursor、Codex、Antigravity)之后,agent 会按 SKILL.md 的流程问你几个问题、写剧本、写场景代码、调无头 Chrome 逐帧渲染、用 ffmpeg 合成,最后交给你一个 <标题>.mp4。
| 组成 | 是什么 |
|---|---|
SKILL.md | 工作流、要问的问题、硬性规则 |
references/ | 手艺手册:写作、镜头语言、视觉、排版、声音、两种用途 |
scripts/ | Python + Node 工具:初始化、渲染、混音、质检、许可、守卫 |
templates/ | 新片的文件骨架,含快速模式的 film.html 起始页 |
starter/ | three.js 场景:八种预设外观、命名镜头、字幕层 |
styles/ | 58 份风格配方(其中 51 份来自 lemo-opuscar,MIT) |
它建立在 three.js(MIT)和 pmndrs/postprocessing(Zlib)之上,渲染时才从 CDN 加载,不随包分发。作者是 Sarp Yıldız,项目本身是在 Claude Code 和 Cursor 里用 Claude 做出来的——这件事值得记一笔,因为它决定了这套东西的形态:它不是给人用的软件,是给 agent 用的说明书。
二、两种模式,和一条容易被忽略的维度
大多数介绍只说了「快速模式 / 电影模式」,漏掉了另一个正交维度:用途。
| 快速模式 | 电影模式 | |
|---|---|---|
| 适合 | 15 秒到 3 分钟的活儿,一次会话做完 | 多场景、要查资料、要档案素材的长片 |
| 图像 | 单个自足的 film.html | 八种预设外观的 three.js 场景,逐镜渲染 |
| 确认点 | 约 3 个(计划 → 两场关键戏 → 成片) | 约 6–8 个(逐段确认) |
| 修改 | 草稿上最多 2 轮 | 每轮新版本,笔记只作用于被点到的镜头 |
| 声音 | 同一文件里的 Web Audio,离线渲染 | 分层音景 + 旁白 + 音乐 |
而用途这一维才真正改变流程:选「电影」时,检查的是浅景深、颗粒、运镜惯性、可选的 180° 运动模糊和胶片抖动;选「广告与产品」时,检查的是特异性(这部片换成另一个品牌还成不成立)、竞品对比、屏幕上的名称标签、软件界面英雄镜头、品牌色与字体,以及 9:16 / 1:1 / 16:9 三个版本的安全区。
同一个 Skill,两套验收标准。这个设计比「支持更多风格」重要得多。
三、纯函数是地基,不是修辞
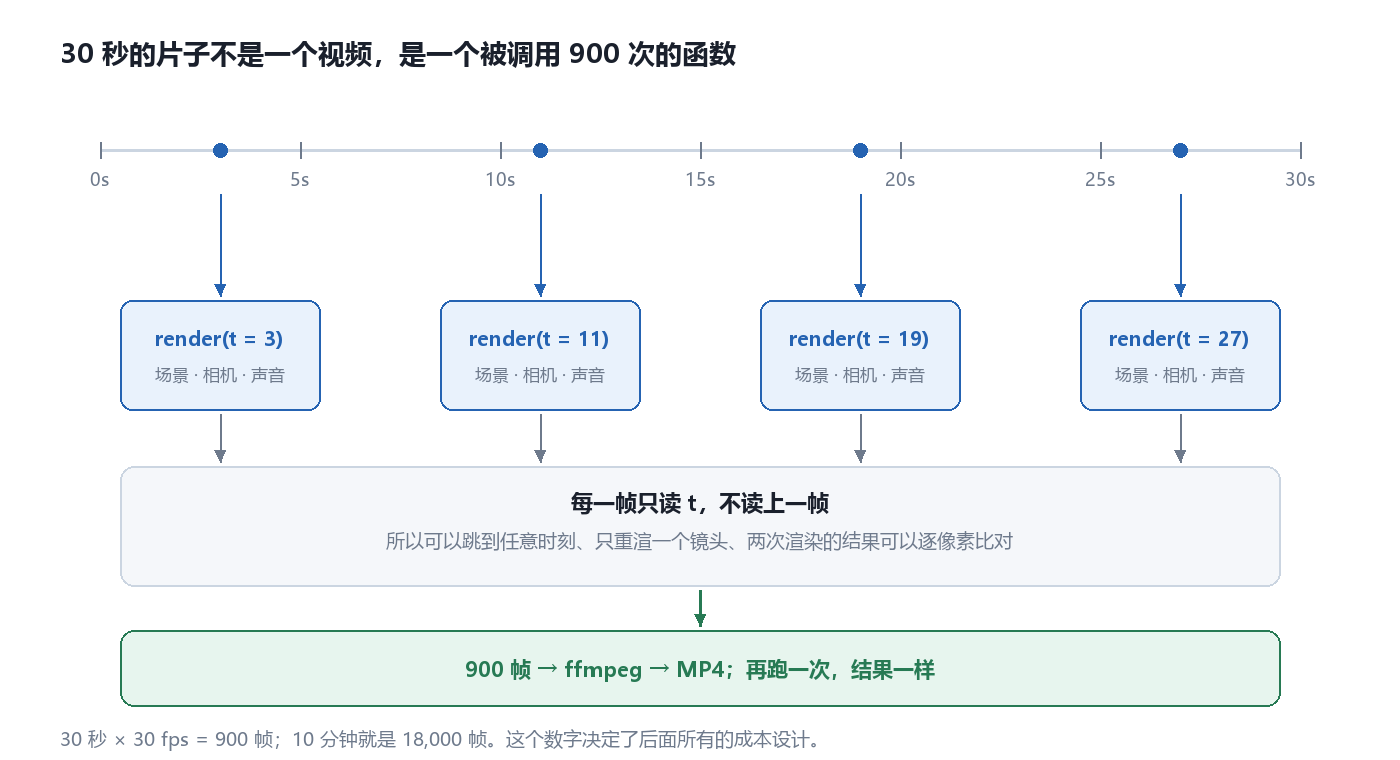
每一帧只读 t,不读上一帧——所以帧与帧之间没有隐藏状态。
README 把它写成一条硬规则:每个镜头都是时间的纯函数(her kare zamanın saf bir fonksiyonudur),重新渲染必须逐帧一致。为了做到这一点,随机数要带种子(起始页里连种子数据的惰性缓存都写好了)。
这条约束换来的能力,全都指向「可检查」:
- 可以跳到任意时刻。不用从头播,直接看第 15 秒。
- 可以只重渲一个镜头。改一句相机参数,只重跑那几秒,不重跑整片。
- 两次渲染可以逐像素比。这就是自动测试的前提:如果渲染不确定,任何视觉回归测试都写不了。
- 可以离线。
film.html用 Canvas 2D 和 Web Audio,无网也能跑;three.js 场景只需一次网络加载库。
顺带一个反直觉的好处:它让「改一个时间点」变成编辑代码,而不是重新抽卡。这正是传统文生视频最难受的地方——你没法指着第 15 秒说「这里推慢一点」。
四、把「感觉」翻译成检出项
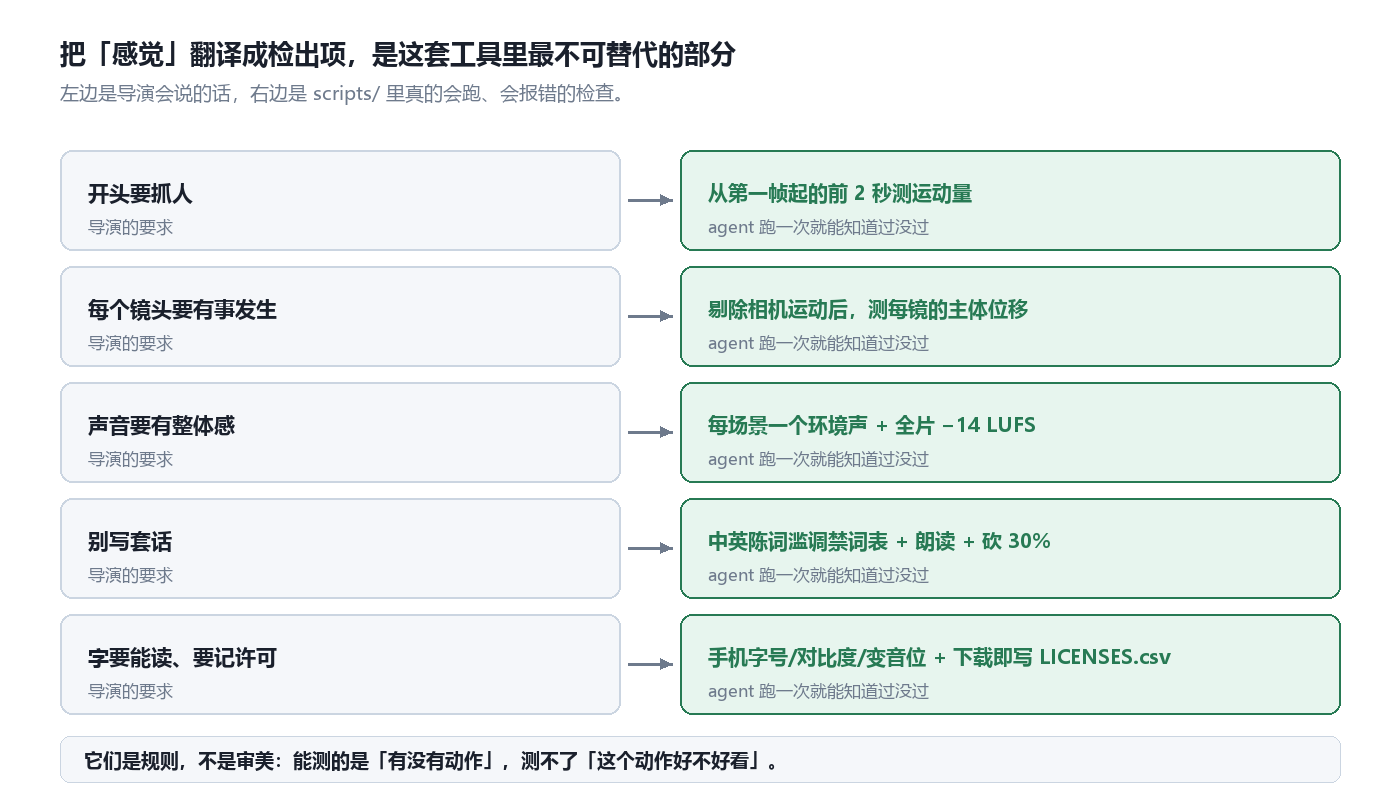
左边是导演会说的话,右边是 scripts/ 里真的会跑、会报错的检查。
这是我认为整套工具里最不可替代的部分。举五处,都能在代码里找到对应:
「开头要抓人」→ 从第一帧起的前 2 秒测运动量。不是「要有动感」这种形容词,是一个会算出来的量。
「每个镜头要有事发生」→ 剔除相机运动之后,测每个镜头里的主体位移。这条很妙:镜头在动的时候,画面永远在变,容易让人误以为「有内容」;把相机运动减掉,剩下的才是主体动作。
「声音要有整体感」→ 每个场景一个环境声 + 全片 −14 LUFS。响度是平台规范,不是审美偏好,所以它可以被检查,也应该被检查。
「别写套话」→ 中英双语陈词滥调禁词表 + 朗读一遍 + 砍掉 30%。写作手册里甚至有一条「先用 30% 的删减轮把稿子压下来」,和一套「第一次看的人能不能看懂」的测试。
「字要能读、素材要能追溯」→ 手机尺寸下的可读性、对比度、变音符号留位;任何外部文件下载的瞬间就写一行许可记录到 LICENSES.csv,成片旁边再生成一份可直接粘贴的 <片名>-credits.txt。
注意最后一条的性质:它检查的不是画面,是你能不能用。这类「法律上的可交付性」被当成流水线的一环,在开源 AI 项目里不常见。
我特意用了「检出项」而不是「评估」:这些脚本输出的是过或不过,不是分数。能测的是「有没有动作」,测不了「这个动作好不好看」——所以它们不能替代审片,只能把需要人看的部分压缩到更少。
五、上下文也是一种预算
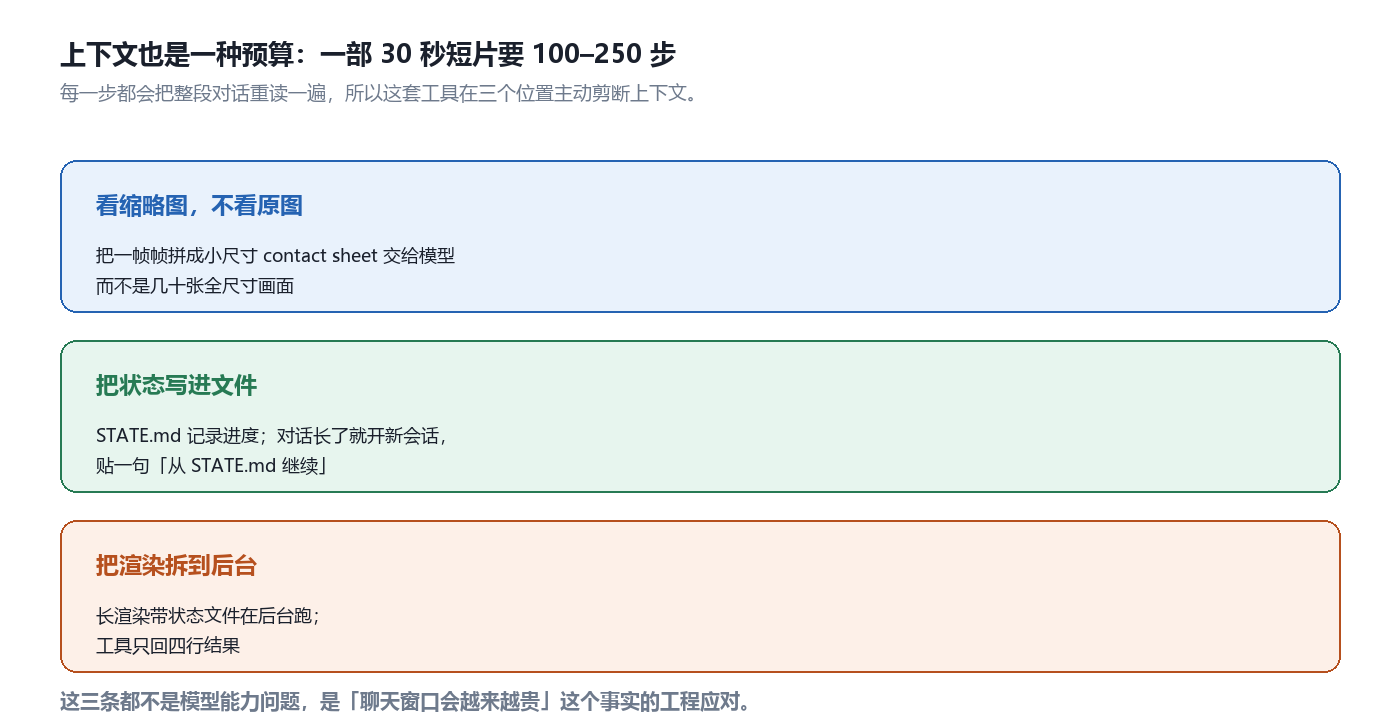
这不是模型能力问题,是「聊天窗口会越来越贵」这个事实的工程应对。
这部分 README 写得很坦白:一部 30–60 秒的短片,在快速模式下通常要 100–250 步;每一步都会把整段对话重读一遍,大部分命中缓存所以便宜,但对话越长每一步越贵。
于是它做了三件和「电影」看起来无关的事:
- 看缩略图,不看原图。agent 检查画面时看的是拼好的小尺寸 contact sheet,不是几十张全尺寸帧。
- 把状态写进文件。
STATE.md记录进度;一个阶段结束、对话变大时,Skill 会建议开新会话,你贴一句「从 STATE.md 继续」就能接上——因为状态在文件里,不在对话里。 - 把渲染拆到后台。长渲染带状态文件在后台跑,工具只回四行结果;助手 agent 有 25 步上限,文件类工作交给更轻的模型,判断类工作才留在主模型。
这三条合起来是一个我最近越来越确信的判断:做 agent 产品,上下文预算是产品设计的一部分,不是运维细节。OhMyGame 用「30 秒超时 / 最多 4 个会话」控制工具输出,这里用「缩略图 / STATE.md / 后台渲染」控制对话长度——手法不同,约束的是同一个东西。
六、一套能装进 agent 的说明书,长什么样
项目结构本身就是设计:SKILL.md 定流程和硬规则,references/ 放手艺,scripts/ 放工具,templates/ 给新片骨架,starter/ 给 three.js 场景,styles/ 放 58 份配方,tests/ 放测试。
三处值得单独看:
脚本不引依赖。scripts/ 只用 Python 标准库和 Node 内建模块,three.js 从 CDN 按固定版本加载。这意味着装这套东西不会污染你的环境,也不会有「半年后 pip 解不出来」的问题——一个要装进别人 agent 的工具包,这点很关键。
规则在能拦的地方变成钩子。guard.py 配 hook.cjs,在 Claude Code 里把三条流程规则变成即时拦截:没给用户看就问、没给用户看就渲染、用户刚确认就停。换个 agent,这些拦截就没了,只剩事后的检查脚本——同一套规则,两种执行强度。
测试要跑真东西。python3 -m unittest discover -s tests;加上 CINECODE_BROWSER_TESTS=1 会真的启动 Chrome 和 ffmpeg 跑一遍。CI 在每个提交上跑 Windows 和 Ubuntu——这也是它能说出「Windows 上端到端还没试过」的原因:测过的和没测过的,它分得清。
七、局限
- Windows 上还没有端到端跑通过一部完整的片。README 自己写明:Windows 上从头到尾一部电影「还没试过」。
- 守卫钩子只在 Claude Code 里生效。
make.py、qc.py这些工具在 Cursor、Codex 里一样跑,但有三类错误是钩子当场拦下的(没给人看就开问、没给人看就渲染、确认后立刻停),换 agent 就没了。 - 近景人脸是硬伤。代码画出来的脸,最好走风格化或剪影;真人质感、复杂肢体动作、自然运动仍然是生成模型的领域。
- 它是程序化动画,不是摄影。材质、光照、模型都得自己搭;「电影感」靠的是镜头语言和调色,不是物理真实的渲染。
- 仍然是逐帧渲染。900 帧还好说,18,000 帧就是几 GB 磁盘和几十分钟起;所以它才需要低分辨率草稿、contact sheet 和分段渲染。
- 许可证的责任在发布者。工具会记录、会生成 credit 文件,但公开素材的合规、你自己品牌资产的授权,最终仍然是你的事。
八、我的判断
这个项目值得学的不是「AI 做视频」,而是它处理不可测领域的方式:
先把能测的部分测掉,再把测不了的部分交给人,并在流程里明确规定「人在哪里看」。它没有假装 QC 能判断好不好看,而是用一整套检出项把人需要看的范围缩小到「两场关键戏 + 一次草稿 + 一次成片」。
第二个值得学的是它把专业手册当成一等公民。references/ 里不是提示词模板,是手艺:命名镜头词典给每个运动配了「观众的感觉、默认时长、速度、缓动」;排版手册要求字体支持变音符号、在手机尺寸下可读、许可干净;写作手册有禁词表和删减轮。这些东西换一个模型也不会失效,因为它们描述的是电影,不是模型。
三个我会想测的点:
- 检出项和人工评分有多相关?把同一批片子交给 5 个人打「开头抓不抓人」,再和那个 2 秒运动量的测量值求相关。如果不相关,该换指标。
- contact sheet 丢了多少信息?agent 只看缩略图判断画面,会不会系统性地漏掉细节问题(文字溢出、纹理错误)?这直接决定它能不能自己验收。
- 分阶段确认真的省钱吗?6–8 个确认点会拖长对话,但减少返工。哪一边更贵,得用
usage.py的 token 明细去算,而不是靠感觉。
回到开头那 900 次调用。它的意义不在「用代码代替模型」,而在于把创作过程变成一个有中间状态的程序:中间状态可以被检查、可以回滚、可以只重跑一部分。电影能不能因此变好,取决于写代码的那个 agent 有多少品味;但至少,它的错误现在有地方可查了。
项目与资料
- GitHub 仓库(MIT)
- 中文 README · 英文
- SKILL.md(流程、提问与硬规则)
- 镜头与转场词典
- 快速模式手册 · 电影模式手册
- 依赖:three.js(MIT)· pmndrs/postprocessing(Zlib)
事实来源:两种模式、两个用途、确认点数量、八种外观、58 份风格配方、−14 LUFS、100–250 步、Windows 未端到端验证、守卫钩子仅限 Claude Code、LICENSES.csv 与 credit 文件,均取自仓库 README 与 references/;镜头词典的单行写法(dolly in, 3 s, slow ease-in-out, toward the figure)取自 README 原文;「900 帧 / 18,000 帧」是 30 秒 × 30 fps 与 10 分钟 × 30 fps 的算术。第八节三个待测点、以及「检出项把人的审片范围压缩」这一定性判断是我的推断。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- Blender Kiln:AI 建模缺的不是生成能力,是交付前的度量
- OhMyGame:AI 生成游戏不难,难的是让它自己发现游戏跑不起来
- GPT-2 的一次前向:一条 768 维的向量,被改写 12 次,变成 50257 个分数
- SAELens:重建得越准,特征越不一定是真的
- TokenEconomizer:Coding Agent 的成本按仓库累积,不按任务计价
- Transformer Explainer:把 GPT-2 塞进浏览器,让模型边算边解释自己
- Boubou:本地语音 AI 缺的不是模型,是一层能借给全屋的运行时
- Hy-MT2:把翻译拆成语言家族分头训练,再蒸馏回一个模型
- NNsight:把干预写进前向传播,让同一段代码在 405B 模型上跑
- Safetensors:用 8 个字节和一段 JSON,重新设计大模型的权重文件