Boubou:本地语音 AI 缺的不是模型,是一层能借给全屋的运行时
文本模型的本地部署已经被 Ollama 这类工具拉平了:下载、运行、调 API,三步。
语音不行。
不是因为语音模型弱,而是因为语音这件事没有“一次请求、一次响应”的形状。麦克风一直在出数据,扬声器一直在放声音,用户随时可能插话,系统必须随时判断“现在该听还是该说”。这一层没人替你写,模型再好也用不起来。
Boubou 做的就是这一层。它是一个 Rust 写的命令行工具,一条命令在本地跑起开源语音模型,再加一条命令,把麦克风借给同一 Wi-Fi 上的手机、浏览器和机器人。代码 MIT,项目在 Beta。
- GitHub:runboubou/boubou
- 官网:runboubou.com
一、语音 AI 卡在哪一层
把语音对话拆开,至少六个部件:
| 部件 | 作用 | 常见坑 |
|---|---|---|
| ASR | 语音转文字 | 采样率、静音切分、口音 |
| LLM | 理解与生成 | 首 token 延迟 |
| TTS | 文字转语音 | 首包延迟、音色一致性 |
| VAD | 判断有没有人在说 | 阈值、环境噪声 |
| AEC | 消掉扬声器回传的声音 | 参考信号对齐、非线性失真 |
| Audio Runtime | 设备、缓冲、线程、进程 | 抖动、爆音、设备抢占 |
前三个是模型问题,后三个是系统问题。而系统问题决定了体验:模型再好,如果它听不见你插话,或者把自己的回声当成用户输入,对话就没法进行。
传统做法是自己把这些拼起来:装 Whisper、装 llama.cpp、装 TTS、写音频环回、处理采样率转换、再想办法把“停止生成”的信号送到模型进程里。能跑通,但每个项目重来一遍。
Boubou 的定位就是把这一层收进一个二进制里。
二、三条命令的边界
它的使用面很窄,也很清楚:
npx boubou@beta run LFM3-Audio-2B    # 在本机对着麦克风说话
npx boubou@beta serve LFM3-Audio-2B  # 把这次对话共享到局域网
npx boubou@beta ask LFM3-Omni-2B photo.png "What is in this picture?"
run 是终端里的语音聊天:Esc 暂停,Enter 继续,Ctrl+C 退出。第一次运行会下载约 1.4GB,并请求麦克风权限。
serve 打印一个浏览器链接和一张二维码,手机扫码就能对着电脑上的模型说话。
ask 用的则是 Omni 模型的多模态能力——除了听和说,它还能看图。
配套命令也都是“模型运维”那一套:list 列模型、pull 预下载、doctor 检查运行环境、run --offline 离线跑。模型和运行时缓存在 ~/Library/Caches/boubou(macOS)或 ~/.cache/boubou(Linux),可以用 BOUBOU_HOME 换位置。
三、两种模式,和它们的价目表
Boubou 支持两条完全不同的技术路径,这是它最值得看的设计。
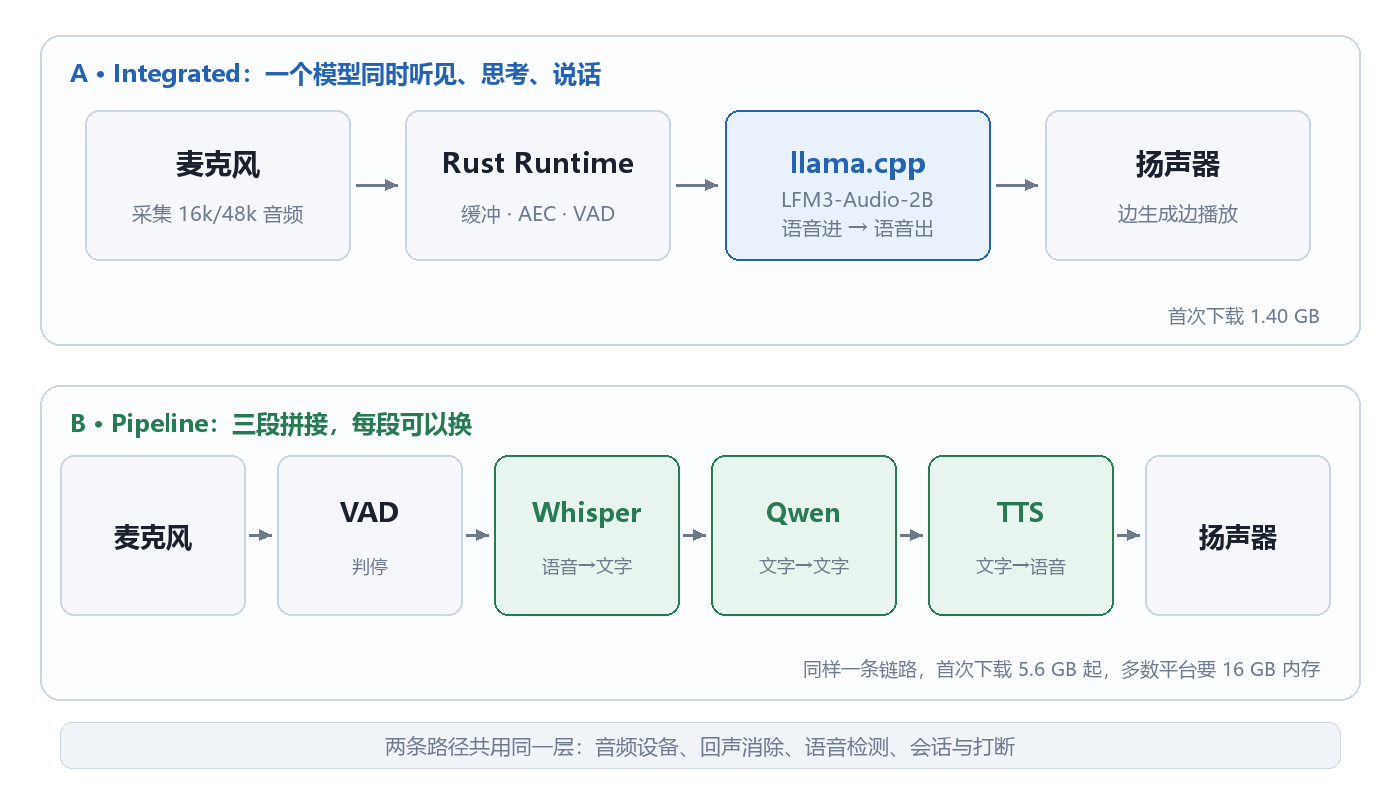
Integrated 一个模型全包,Pipeline 三段拼接;下面的运行时是共用的。
Integrated:一个模型同时听见、思考、说话,跑在 llama.cpp 上。默认的 LFM3-Audio-2B 就是这一类,液态 AI 的音频模型,18 种语言、2 个音色。
Pipeline:语音识别 → 语言模型 → 语音合成,三段各自独立。Boubou 的模块化模型是一个锁定版本的 Hugging Face speech-to-speech 流水线(v1.1.0),ASR 默认 Whisper,LLM 默认 Qwen,TTS 可以换。
两种模式在代价上差距很大,官网的模型库把账算得很清楚:
| 模型 | 类型 | 语言 / 音色 | 下载 | 内存 |
|---|---|---|---|---|
| LFM3-Audio-2B | Integrated | 18 / 2 | 1.40 GB | 8 GB+ |
| LFM3-Omni-2B | Integrated | 23 / 2,支持视觉 | 1.61 GB | 16 GB+ |
| LFM2.5-Audio-1.5B | Integrated | 仅英文 | 1.27 GB | 未标注 |
| qwen3-tts | Pipeline | 10 / 9 | 3.75 GB 起 | 16 GB+ |
| pocket-tts | Pipeline | 7 / 27 | 5.63 GB 起 | 16 GB+ |
| kokoro | Pipeline | 8 / 54 | 5.91 GB 起 | 32 GB+ |
| supertonic | Pipeline | 31 / 10 | 5.98 GB | 未标注 |
| omnivoice | Pipeline | 646,支持克隆 | 8.85 GB | 未标注 |
| chattts / mms-tts | Pipeline | 中英 / 英文 | 5.9 GB 左右 | — |
多数 Pipeline 一上来就是 5.6GB 起(qwen3-tts 稍低,3.75GB 起),因为它其实一次装了三个模型:Whisper、一个 Qwen、一个 TTS。Integrated 只要 1.4GB,是因为它把三件事塞进了一个模型。
这就是“统一模型 vs 拼接流水线”的老账:拼接灵活、可替换、每个环节都能挑最好的;统一模型省资源、省延迟、少一次文本中转(也就少丢一层语气和停顿)。
还有一条容易被忽略的平台事实:官网按系统筛,Linux 纯 CPU 只有 3 个模型可用,就是三个 Integrated;Pipeline 在 Linux 上基本要求 NVIDIA GPU,qwen3-tts 和 chattts 则要 macOS 15+。
四、Rust 在守什么
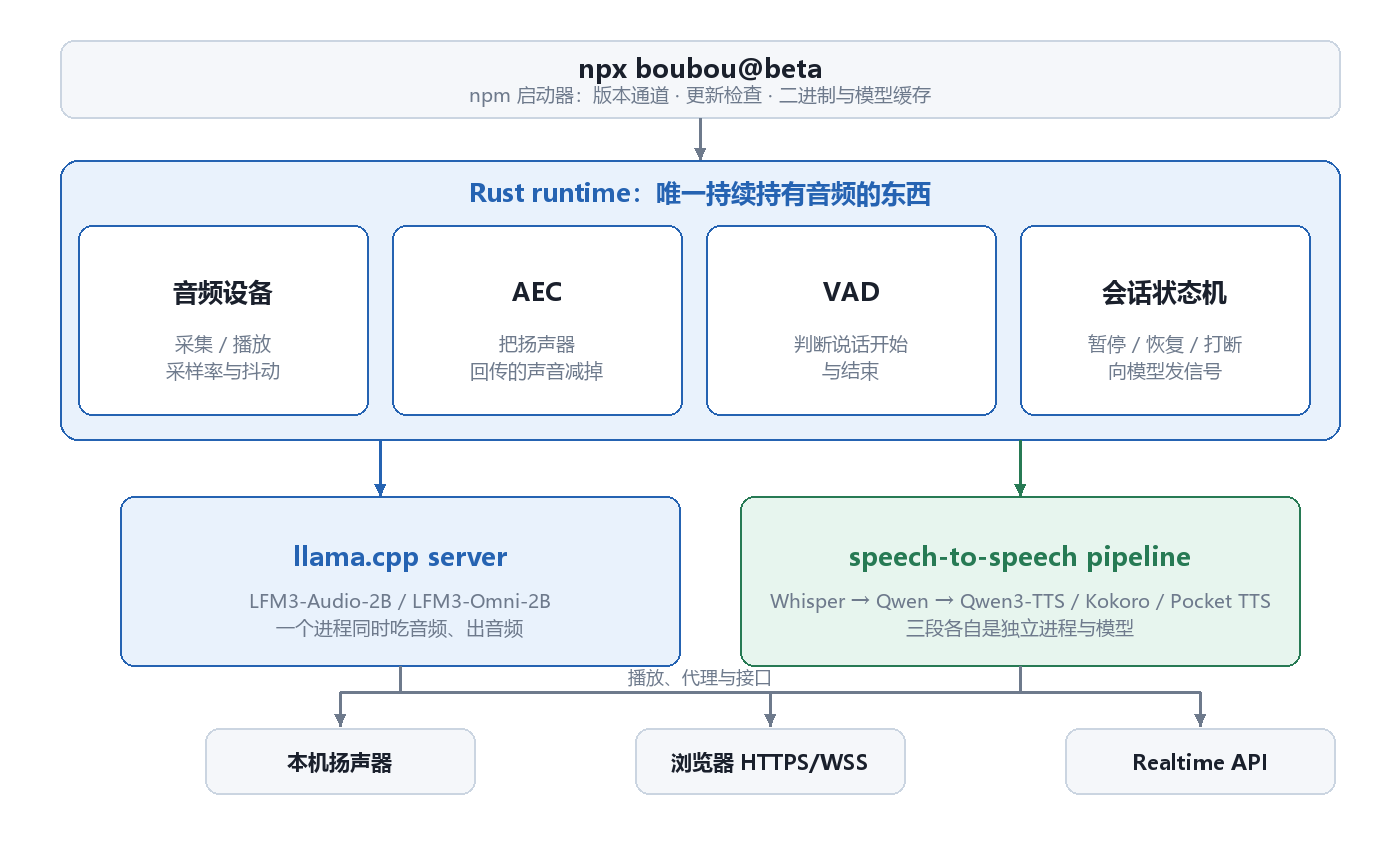
Rust 层不跑推理,它跑的是“持续存在”这件事。
看到“用 Rust 写的语音 AI”,很容易误以为是“推理用 Rust”,其实不是。Boubou 的推理交给 llama.cpp 或 Python 的 speech-to-speech 流水线,Rust 负责的是另一件事:唯一持续持有音频的那个进程。
这件事必须由一个长期存活的进程来做,原因很具体:
- 音频设备是独占的。麦克风被别的应用抢走,采集就断了;采样率协商失败,出来的就是噪声。
- 回声消除需要参考信号。AEC 要把“我刚刚播放的声音”和“麦克风收到的声音”做对齐,所以播放和采集必须在同一个地方拿到——分给两个进程就没法对齐。
- VAD 需要连续的历史。判断“这句话说完了没有”,看的是过去几百毫秒的能量和过零率,不是单个音频块。
- 打断需要能随时杀死生成。用户一开口,得立刻停止播放、停止生成、清掉队列,再开新一轮。这套状态机放在哪个进程里,决定了打断有多快。
所以架构是:Rust 持有设备与会话,模型是被管理的子进程(llama.cpp server 或 pipeline),两者之间用本地接口通信。模型崩了可以重启,设备不能。
这也解释了一个官方细节:LFM2.5-Audio-1.5B 的说明里写着“打断需要更久,因为 Boubou 会重启它的服务”。同一个运行时,不同模型的可打断性不一样,区别就在这个模型服务能不能被单独叫停。
五、打断:体验的分水岭
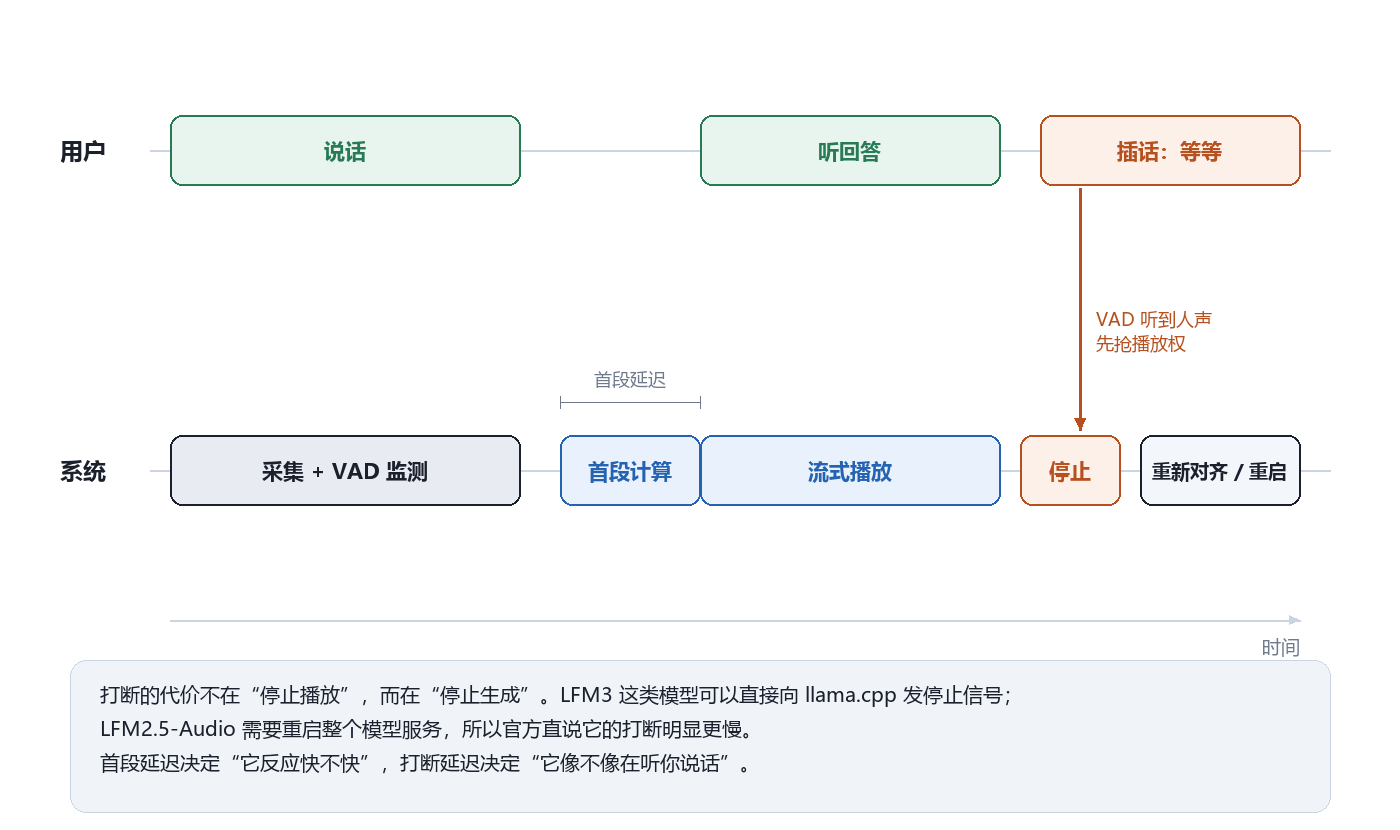
一轮对话被插话打断时,两边各自在做什么。
大多数语音助手是“回合制”的:你说完,它想,它说完,你再说。用户插话?等着。
真人的对话不是这样。你说到一半发现对方理解偏了,会直接插一句“等等,我是说……”。系统必须能在这个过程中停下来。
Boubou 把这件事拆成两个延迟:
- 首段延迟:VAD 判定你说完了 → ASR 出字 → LLM 出第一个 token → TTS 出第一段音频。这一段决定“它反应快不快”。
- 打断延迟:VAD 听到人声 → 停播放 → 停生成 → 清队列 → 开始处理新输入。这一段决定“它像不像在听你说话”。
两者的优化手段完全不同。首段延迟靠模型小、靠流式、靠并行(ASR 边说边出字,TTS 边出字边合成)。打断延迟靠的是架构:能不能向模型进程发一个“停”的信号,以及这个信号要多久才生效。
这也是我觉得最值得测的一个指标。官方已经承认 LFM2.5 需要重启服务才能打断,那就意味着这类模型的打断延迟是“进程重启级”的(数百毫秒到数秒);而 LFM3 这类可以被直接叫停的模型,延迟应该是“信号级”的。同样叫“支持打断”,体验是两个物种。
六、serve:把麦克风借出去
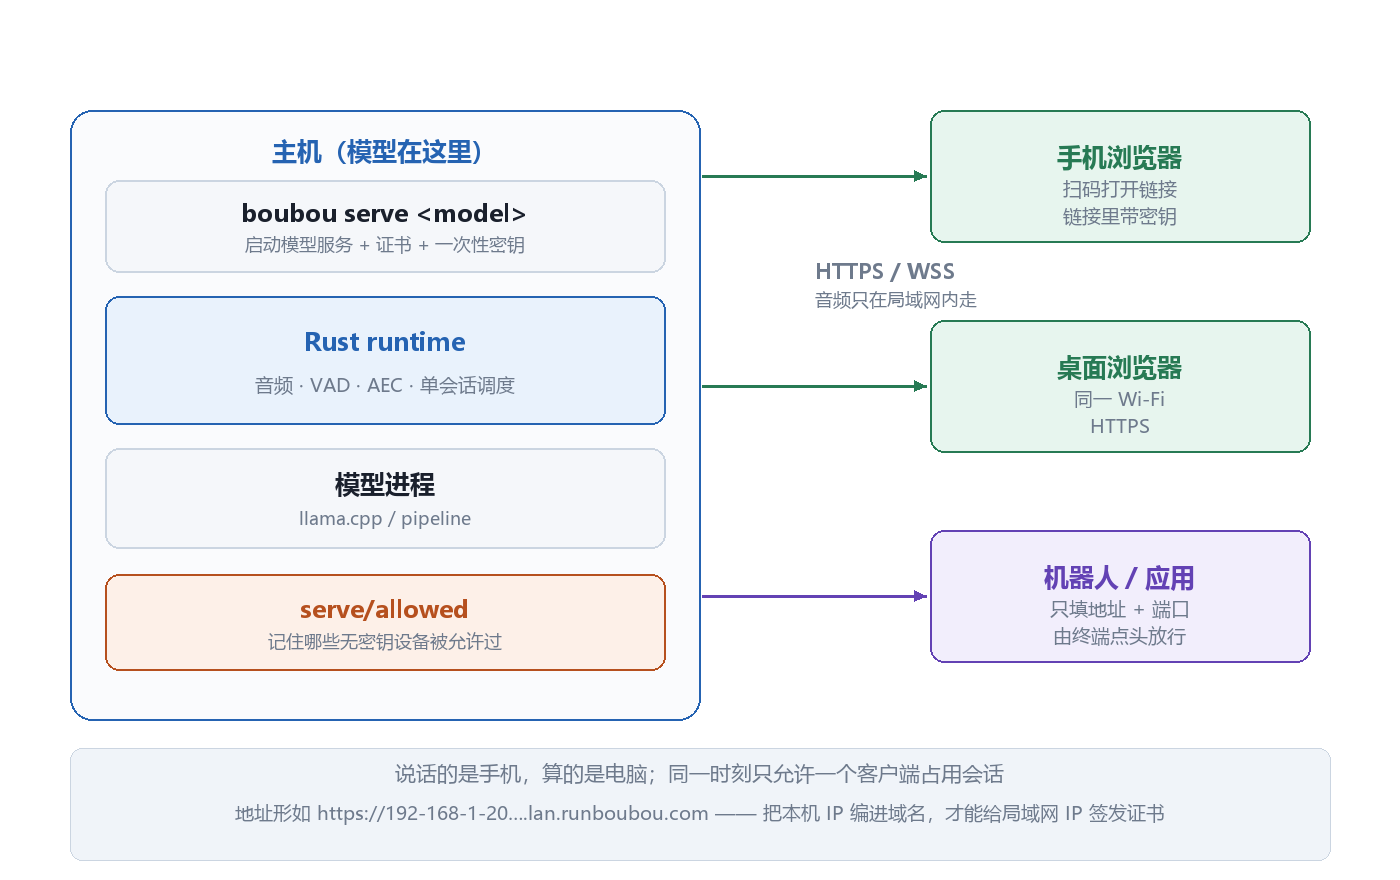
主机算模型,客户端只负责采集和播放。
serve 是 Boubou 最有产品感的部分。它解决的是一个很实际的痛点:语音模型跑得动的地方,往往不是你说话的地方。
笔记本在书桌上,你在厨房;模型在 Mac mini 上,你在客厅。把模型搬到手机上不现实,但把音频送到电脑上很现实。
于是拓扑变成:手机采集音频、通过 HTTPS/WSS 送给主机、主机推理、把音频流回手机。手机不需要 GPU,也不需要下载模型。
这里有三层设计值得单独说。
1. 默认 HTTPS,而且证书能过
局域网 IP 没法直接申请证书——CA 不给 192.168.1.20 签证书。而浏览器只在安全上下文里给麦克风权限,http://192.168.x.x 连麦克风都拿不到。
Boubou 的做法是:把 IP 编进域名。地址长这样:
https://192-168-1-20.….lan.runboubou.com
Boubou 会向 lan.runboubou.com 申请一张覆盖这个域名的证书;私钥在本机生成、也留在本机,签发服务只经手请求。于是浏览器看到的是一个正常域名配正常证书,麦克风权限和 WSS 都成立。
这个技巧不新(很多本地开发工具都用类似的 wildcard DNS),但用在“手机扫码就能说话”这个场景里,体验差别巨大——用户不需要装根证书,也不需要点过警告页。
不想用这个服务也可以:--local 只监听本机,--self-signed 自签名(需要在浏览器里信任),--offline 完全离线。
2. 密钥在链接里,也在二维码里
终端打印的链接带访问密钥。扫码即授权,等于“谁拿到链接谁就能用麦克风”。
这带来一个很直白的安全结论:不要把链接发到群里,也不要截图发社交媒体。 官方 README 专门写了这一句。
3. 无密钥设备走“终端点头”
机器人、嵌入式设备往往只能填“地址 + 端口”,塞不进一长串带密钥的 URL。Boubou 的处理是:这类连接进来时,终端弹一句“某 IP 想不用密钥连进来,允许吗?”,按 y 之后记住,存在 serve/allowed 里。
这个设计很务实:用人在场的那一刻做信任决策,而不是让设备去实现一套密钥管理。代价是首次连接必须有人守着终端。
顺带说清楚边界:只有 Pipeline 模型提供 OpenAI 兼容的 Realtime 接口和语音合成接口,Integrated 模型暂时没有;WebRTC 也不支持,走的是 WebSocket。
七、npm 当分发通道:一个容易被低估的工程决定
Boubou 的入口是 npx boubou@beta。用 npm 分发一个 Rust 二进制,看起来别扭,但解决了几个真问题。
它的启动器在每次执行命令前会检查更新,跑 release channel 上的最新版(beta 可以毕业成 stable)。几个细节值得注意:
- 更新装进用户缓存,不需要管理员权限;
- 更新使用你用户级/全局的 npm 配置,不读当前项目的
.npmrc——避免某个项目把 registry 改成内网镜像时静默失败; - 检查失败就警告,然后用上一个可用版本,不阻塞使用;
-
doctor、--offline、BOUBOU_NO_UPDATE_CHECK=1都可以跳过检查。
模型不随包更新而重下,运行时更新会复用已校验的文件,只有版本和服务端都支持时才做增量下载。
这是一个典型的取舍:用 npm 换“零安装门槛”,代价是多了一层启动器和更新逻辑。 对 Beta 项目来说,这个取舍是对的——先让人跑起来,比先让人装对更重要。
八、安全:本地不等于安全
“本地推理”经常被当成安全属性。它不是。
Boubou 在 run 模式下的隐私承诺是实的:不要账号、不要云端 API Key、不上传音频和转录、下载完可以离线、没有遥测。这一层没有问题。
但 serve 打开了另一面:
| 风险 | 具体形态 | 缓解 |
|---|---|---|
| 链接泄露 | 密钥在 URL 里,截图/转发即授权 | 只发给自己的设备;用完 Ctrl+C |
| 明文回退 | HTTP/WS 不加密 | 优先用默认的 HTTPS/WSS |
| 局域网嗅探 | 同一 Wi-Fi 下的其他人 | WPA2/3 + 不共享网络 |
| 公网暴露 | 端口转发到公网 | 不要做;这不是多租户服务 |
| 无密钥设备 | 地址+端口即可发起连接 | 终端逐个批准,记录在 serve/allowed |
还有一条架构约束:一次会话只能有一个客户端。这更像是单条音频会话的必然结果,而不是没做完——AEC 的参考信号只有一路,两个客户端同时说话时,回声消除和 VAD 都会失去依据。要多客户端,得先做会话隔离和音频资源调度,那是另一个产品。
九、和 Ollama、llama.cpp、Whisper 的关系
这四个东西经常被放在一起比较,其实不在同一层:
| 项目 | 解决什么 | 类比 |
|---|---|---|
| llama.cpp | 模型怎么推理 | 引擎 |
| Whisper / Kokoro / Qwen3-TTS | 单项能力 | 零件 |
| Ollama | 文本模型怎么被管理和调用 | 文本的模型服务器 |
| Boubou | 语音会话怎么被组织和共享 | 语音的会话服务器 |
Boubou 自己就用 llama.cpp 跑 Integrated 模型,用 Hugging Face 的 speech-to-speech 跑 Pipeline。它不是替代品,是编排层。
这个位置的价值在于:模型会换,运行时可以不变。今天默认 LFM3,明天换一个更好的音频模型,用户侧的命令和接口不用改。
十、局限
按重要性排:
- Beta。 命令、参数、模型列表都在动,别拿它当生产依赖。
- 平台窄。 macOS 要 Apple Silicon + 13.3+;Linux 纯 CPU 只有 3 个模型;Windows 不在 README 的支持范围内,不要假设能用。
- 单客户端。 见第八节,这是音频会话的结构性约束,不是修个 bug 就能放开。
- 打断质量取决于模型。 官方自己标了 LFM2.5 打断慢,说明“支持打断”这句话在不同模型上不等价。
- 模型许可证不统一。 代码是 MIT,但模型不是:chattts、mms-tts、omnivoice 在模型库里明确标了 non-commercial。商用前逐个核对。
- 替换组件不设防。
--model_name、--stt会直接从 Hugging Face 拉模型,Boubou 不校验你指定的模型。这既是自由,也是风险。 - 回声消除不是万能的。 外放音量、房间混响、设备延迟都会影响效果,官方也没有承诺“任何设备上都能全双工”。
十一、我的判断:语音运行时有三场考试
Boubou 的产品直觉是对的:本地 AI 的下一层不是更强的模型,而是“能力怎么被别的设备调用”。 但它能不能站住,取决于三场考试,而且都能测:
第一场:首段延迟的分解。 把“用户停止说话”到“第一段音频播出”拆成 VAD 判停窗口、ASR 出字、LLM 首 token、TTS 首包四段,各自计时。哪一段是大头,决定了该换模型还是该改流水线——这个测量用日志加时间戳就能做,不需要改代码。
第二场:打断延迟的分布。 不只是平均值,要看 P95。用户插话十次,有九次在 200ms 内停住,一次卡了 2 秒,感受就是“它有时候不听我说话”。而 LFM2.5 那种“重启服务”的实现,分布形状会完全不同。
第三场:真实房间里的 AEC。 官方 demo 都是安静环境、内置麦克风、中等音量。真正的考验是外放音量拉满、房间有混响、麦克风和扬声器离得近。这一场不过,serve 场景(手机外放 + 电脑麦克风)就会变成“它一直在自言自语”。
如果这三场都过得去,Boubou 这类工具的位置会很稳:它不跟模型厂商竞争,它做的是把模型变成家里的一台设备。这个位置在文本侧已经被 Ollama 占了,语音侧还空着。
项目与资料
代码 MIT;模型各自许可不同,商用前分别核对。本文数字来自项目 README、官网模型库与接入文档,实际体验会受设备、房间声学和模型版本影响。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- Blender Kiln:AI 建模缺的不是生成能力,是交付前的度量
- CineCode:每一帧都是时间的纯函数,所以电影可以被检查
- OhMyGame:AI 生成游戏不难,难的是让它自己发现游戏跑不起来
- GPT-2 的一次前向:一条 768 维的向量,被改写 12 次,变成 50257 个分数
- SAELens:重建得越准,特征越不一定是真的
- TokenEconomizer:Coding Agent 的成本按仓库累积,不按任务计价
- Transformer Explainer:把 GPT-2 塞进浏览器,让模型边算边解释自己
- Hy-MT2:把翻译拆成语言家族分头训练,再蒸馏回一个模型
- NNsight:把干预写进前向传播,让同一段代码在 405B 模型上跑
- Safetensors:用 8 个字节和一段 JSON,重新设计大模型的权重文件