Blender Kiln:AI 建模缺的不是生成能力,是交付前的度量
一个自称做完的模型,被另一个 Agent 看穿了。
这是 Blender Kiln 仓库里最不起眼、也最能说明问题的一条记录:一个吉祥物模型,建模的会话自己检查完、认为可以交付;换一个新的审核 Agent 只看六张渲染图,第一轮就列出 16 个被漏掉的缺陷——头发上的火苗被读成犄角、手掌没有手指、后颈秃了一块。
- GitHub:elithril/blender-kiln(MIT,作者 Nicolas Dolphens)
- 依赖:Blender 4.4 及以上,基准测试跑在 5.2.2
- 定位:一个 Claude Code 插件,把 3D 资产的生产流程写成 31 条铁律 + 27 份参考文档
它已经被引在 3DCodeBench(arXiv:2606.01057)的第一节里。但真正让我想写它的不是这个,是它对自己的要求:仓库的贡献指南只有一句话——主张必须被测量,不能靠推理。
所以本文不讲「AI 也能建模了」,只讲一件事:一个 AI 交出来的模型,怎么证明它能用。
一、三个数字,三种「像」
先看三组数,它们分别代表三种完全不同的「像」:
| 场景 | 数字 | 它证明的事 |
|---|---|---|
| 修一份生成器输出 | 191,520 面 → 9,000 面,11.4 MB → 0.63 MB | 能跑,不等于能装进游戏 |
| 从照片重建灯笼 | 形状分 0.885 → 0.888,跑完 8 轮审核 | 分数不动,缺陷会动 |
| 同一件资产的开销 | $6.04 → $13.19 | 质量不是免费的 |
第一行是「能运行」和「能交付」之间的差距。第二行是我认为最值得读的一段:审核轮次把分数从 0.885 推到 0.888,几乎等于没动;但同一批资产被审出来的缺陷,是 16 个这个量级。第三行是它的价格——单件成本翻倍。
这三件事放在一起,才是一个可用的判断:AI 3D 的瓶颈不在生成得多像,而在没人拿数把它量过一遍。
二、一个生成结果,离可交付还差六件事
文生 3D 工具的交货方式是「一个能打开的 GLB」。生产端的收货标准是另一套:
| 生成器通常给到的 | 交付要求 |
|---|---|
| 面数不可控 | 面数落在设定的档位内 |
| 拓扑乱、有洞 | 闭合、法线一致、无非流形边 |
| 材质只存在 Blender 里 | glTF 里材质节点不丢 |
| 尺寸靠猜 | 1 单位 = 1 米,底面落在 Z=0 |
| 没有日志 | 每个阶段留 Checkpoint,可续跑 |
| 没人复核 | 有人(或另一个 Agent)签过字 |
kiln 的仓库里有一份现成的对照:一份原始的 TRELLIS 输出,191,520 个三角面、11.4 MB,带着 13,732 条非流形边和 10,220 条开放边。修完是 9,000 面、0.63 MB、两条边数都是 0——玻璃球太薄、撑不过体素重网格,于是按它的剖面用旋转体重建了一遍,整件再闭合、减面。整个过程 16 分钟。
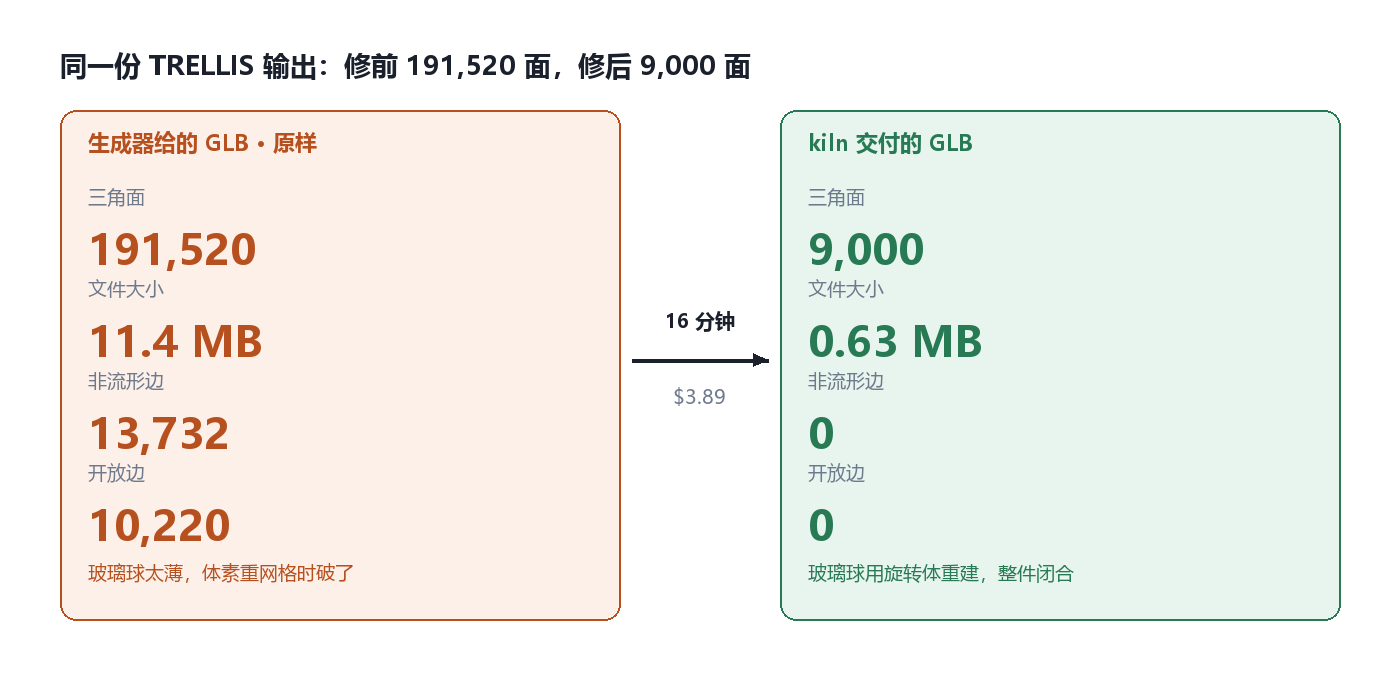
左边是生成器的交货状态,右边是 kiln 交付的 GLB:面数与边数不是「优化」,是两个不同物种。
这段流程里没有一步需要模型「看懂」什么:非流形边能数,开放边能数,薄壁能不能活过重网格能测。kiln 的设计正是把这类判断从模型手里拿走——交给脚本。
三、四层:谁判断,谁执行,谁不撒谎
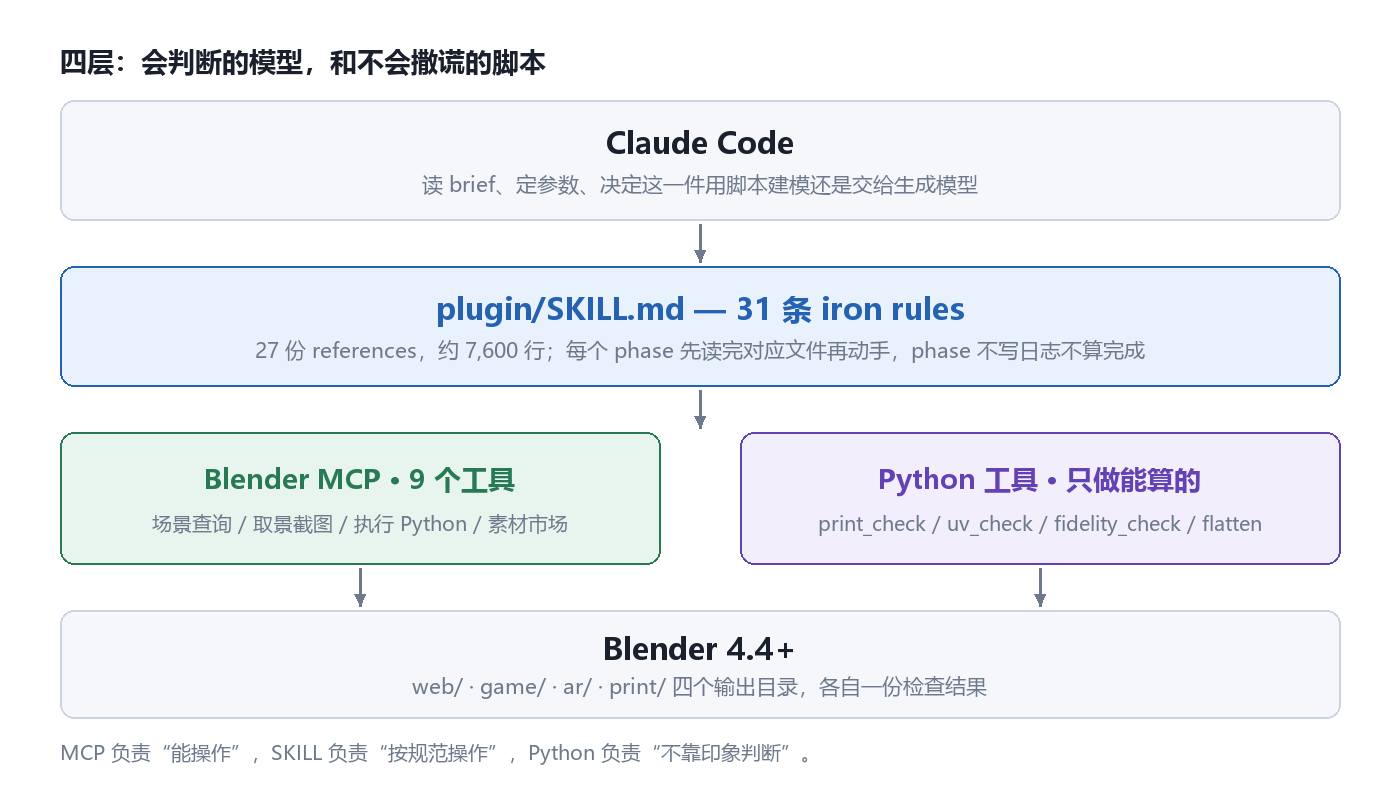
模型负责判断,SKILL 负责约束判断,Python 负责在模型判断错的时候把它拦下来。
从上往下看:
- Claude Code 只做两件事:读懂 brief,决定这一件用脚本建模、用几何节点、从市场拿,还是交给生成模型。默认是脚本建模,不接任何 AI 后端。
- plugin/SKILL.md 是 31 条铁律(26 条核心 + 5 条批处理专用),配上 27 份
references/、约 7,600 行。它的用法不是「塞进上下文」,而是每个阶段开始前必须先读完对应那一份,读完再动手。 - 两个执行面:Blender MCP 给模型「手」(ahujasid 的
mcp-for-blender自 2.1.9 起 9 个工具,以及 Blender 基金会的官方 Lab MCP,两套都支持);Python 工具给「尺」(print_check、uv_check、fidelity_check、flatten等)。 - Blender 4.4+ 落地,产物按用途分到
web/、game/、ar/、print/四个目录,每个目录带自己的检查结果。
铁律里最能说明这套设计取向的几条:
- Rule 4:永远不硬性限制面数。超了就提醒,不阻断——因为一个人物和一个木箱不该用同一个预算。
- Rule 6:永远不静默销毁。减面、简化、删除,一律先给前后对比、等用户选,连 auto 模式也不放开。
- Rule 7:阶段不写日志就不算完成。作者是在实测里发现这条必须写死:三个被要求「每阶段写日志」的会话,最后都只在开头写了一次。
- Rule 20:永远不用
gltf-transform optimize。它内部带simplify,会顺手把几何削掉。
这不是提示词工程,是流程工程。把「模型该判断什么、脚本该判定什么」切开来,是它和「给 AI 一段 prompt 让它建模」最本质的差别。
四、九段流水线,一道横切的关卡
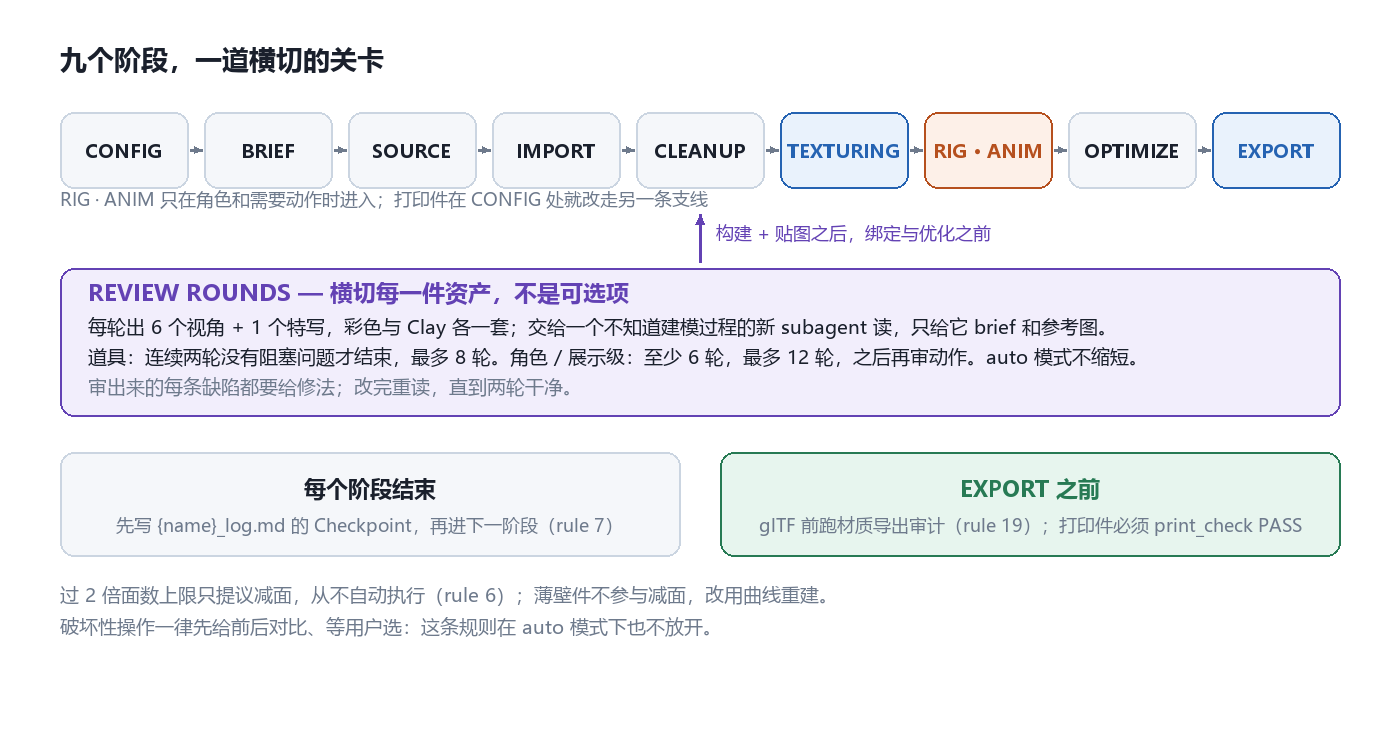
CONFIG 到 EXPORT 是可枚举的;REVIEW ROUNDS 不在序列里,却横切每一件资产。
九个阶段,每个阶段有自己的入口文件和出口条件:
| 阶段 | 这一阶段真正在做的事 |
|---|---|
| CONFIG | 先问用途:Web、游戏、AR、3D 打印,四套参数完全不同 |
| BRIEF | 把自然语言整理成结构化规格(类别、风格、面数档、格式) |
| SOURCE | 选来源:脚本、几何节点、市场、生成模型、参考图重建 |
| IMPORT | 命名、尺寸、原点、朝向、场景组织——最容易被跳过的一步 |
| CLEANUP | 合并重点、重算法线、清理孤立件、查融合边、应用变换 |
| TEXTURING | 优先用 CC0 扫描素材,再按照片调色;先查 UV 再烘焙 |
| RIG · ANIM | 只有角色和需要动作时进入,见第八节 |
| OPTIMIZE | WebP 纹理 → Draco,分步做,永远不一步 optimize |
| EXPORT | 材质导出审计通过才允许写 glTF;打印件必须 print_check PASS |
打印是另一条支线:CONFIG 里声明「要打印」,后面的建模方式就变了(见第七节)。
五、审核轮次:换一双没有参与建造的眼睛
这是整套设计里我认为最值得抄的一条。
问题很朴素:创建模型的会话,也是判断模型好不好的会话。 它看到的是自己想造的东西,不是屏幕上真实存在的东西。
kiln 的做法是把这两件事拆给两个 Agent:
- 每轮产出一张 review sheet:6 个视角 + 1 个局部特写,彩色与 Clay 灰模各一套。特写专挑检查报出来的薄弱处。
- 每一轮交给一个新的 subagent,它只拿到 brief、参考图和这几张图,看不到建模过程、看不到上一轮的结论。
- 它逐条列缺陷,并区分「阻塞」与「细节」;每条都要给修法。
- 结束条件是连续两轮没有阻塞问题。道具最多 8 轮;角色和展示级资产至少 6 轮、最多 12 轮,之后还要再审动作。auto 模式不缩短轮次。
那 16 个缺陷就是这么出来的。还有一个更细的例子:角色行走时膝盖会「啪」地反折,建模会话没看出来,审核会话看出来了。
这套机制真正解决的,是评价权的问题。生成者给自己打分,几乎必然偏高;把打分权交给一个不知道你怎么建的第三方,才有意义。
六、分数几乎没动,抓到的东西变了
审核有代价,而且作者把代价也算进去了。
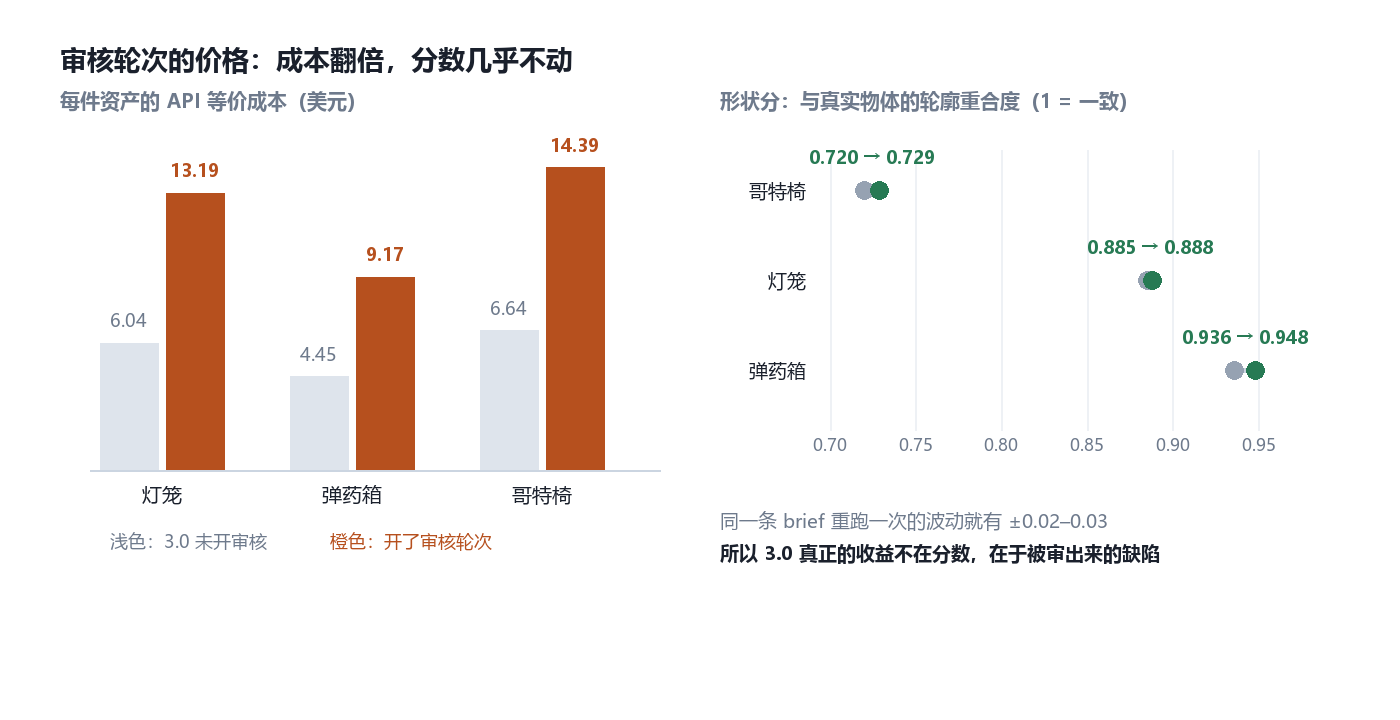
成本几乎翻倍;分数落在重跑一次的波动范围里。
形状分的定义很具体:模型从正面、背面、两侧、顶部渲染,与真实物体的轮廓做重合度平均,1 表示一致——参照物是照片背后那个真实物体的 3D 模型,会话从头到尾见不到它。
| 资产 | 2.2.0 | 3.0(无审核) | 3.0(有审核) | 审核后开销 |
|---|---|---|---|---|
| 飓风灯笼 | 0.900 | 0.885 | 0.888 | $13.19 |
| 弹药箱 | 0.774 | 0.936 | 0.948 | $9.17 |
| 哥特椅 | 0.637 | 0.720 | 0.729 | $14.39 |
三个结论,一个比一个不舒服:
- 审核对分数几乎没有贡献。 0.885 → 0.888、0.936 → 0.948、0.720 → 0.729,而同一条 brief 重跑一次的波动就有 ±0.02–0.03。灯笼跑了 8 轮撞到上限,原因是两个审核者对色调的判断不一致。
- 3.0 在一个 brief 上比 2.2.0 还差。 灯笼从 0.900 掉到 0.885。仓库把这一行留在表里,没有删。
- 真正的收益是缺陷被抓住。 16 个缺陷、反折的膝盖、糊在一起的手指——这些不进分数,但会让资产不能交付。
同一次基准测试里还有一组整体数字:19 条 brief(3.0 扩到 20 条,多了一条修 GLB)全部交付;3.0 的总开销 $54.06 → $75.87,多出约 40%;换成官方 Lab MCP 跑同样 20 条,全部通过,$84.97。
七、打印:从 brief 起就按打印机建模
3D 打印是最能暴露「生成模型 ≠ 交付资产」的场景:游戏模型允许有开放结构和悬空细节,打印件不允许。
kiln 的打印模式和别的分支不一样——它在画第一个基础体之前就按打印机建模:FDM 壁厚至少 0.8 mm、树脂 0.5 mm,闭合实体,平整底面,能避开的悬空在设计阶段就避开,浮雕做成几何,一个件会打到空中时就拆成两件分开摆平。
实测里最漂亮的一个数是 flatten.py 干的事:手工收尾的模型常常有一堆「本该平却没平」的面,还整体歪了一度。它把近似平面压成精确平面、把底面压到床上,风车那个模型的第一层从 629 mm 变成 3,317 mm——同时不碰曲线、倒角、真实斜面,任何顶点移动都不超过容差,输入文件永不覆盖。
检查端是 print_check:开放边与非流形边、法线、悬空与漂浮件、壁厚、最小可缩放比例(风车的主体「不要缩到 40% 以下」),再拿 PrusaSlicer 当第二意见。作者用 Bambu Lab P1S 实际打印了四件——风车(2 件、90 mm)、logo 铁匠炉(3 件、70 mm)、灯塔(50 mm)、卡口盖的 Art Deco 盒子——都是 kiln 导出的原样。
边界也写得很实:
- 只做装饰件,不做机械结构。需要精密配合的,去 OpenSCAD、CadQuery、build123d。
- 只跑 FDM,用 PrusaSlicer 默认配置;没有树脂切片、没有摆放方向搜索、没有支撑生成、没有构建体积检查。
- 零件之间靠胶粘或压配,固定不动。
- 不支持多材料文件:一个颜色要么被画上去,要么单独成一个件。
八、绑定与动画:四条路由,因为一种方法吃不下所有主体
/kiln animate 不是一个模型跑天下,它按主体分路由——这是它和多数「AI 动画」项目不同的地方:
| 主体 | 路由 | 备注 |
|---|---|---|
| 人形 + 现成动作 | presets.py:22 个动作、43 段 Kimodo 动作 | 允许商用,脚落地、手臂不穿身 |
| 双足 / 带翼,从一句话 | UniMate 文生动作,motion_loop.py 收尾 | 权重 CC BY-NC,仅限非商用 |
| 四足,idle 与 walk | quadruped.py:脚本化、带测量 | 四足永远不走 UniMate |
| 可动道具(台灯、宝箱) | 逐件打关键帧,每个旋转方向先量再定 | 没有模型权重 |
四足为什么被单独摘出来?因为实测过:同一套文生动作在猫、柴犬、马和作者自己的机器狗上都不可用,所以四足直接不路由过去。
角色本身是另一种做法:先做成一张皮(一组 metaball 或互相重叠的体,做一次体素重网格),这样肩、髋、颈弯曲时不会有接缝;再用学出来的自动绑定(SkinTokens,MIT,本地跑)把骨架交回来,换 Mixamo 命名、清权重、补眼皮和耳朵骨。
效果是用「弯曲时皮肤穿透皮肤」的比例量的:低模村民 3.15% → 0%,Q 版角色 1.34% → 0%,生成人形 0.74% → 0.45%。作者也照例写了代价:只在两个人形的一个姿势上比过,而且每次跑都不一样;SkinTokens 每个网格要 5.6 GB 磁盘和 7 GB 内存。
九、Kiln Studio:把「你来看一眼」变成一个可执行的输入
AI 生成的东西总得有人看。传统流程是:AI 出模型 → 人开 Blender → 发现问题 → 再回去跟 AI 描述。
Studio 是本地起的一个页面(Python 标准库,绑 127.0.0.1),把这段往返压进一个界面:模型在页面上转,发现提手太小,就在那个位置钉一条批注——它会记录 Blender 坐标、命中的物体和材质、相机、截图和特写——然后点「让 Claude 处理」。
实测的一条批注是「环太小,挂不上去」。Claude 在自己的 Blender 里改、重新导出、在批注上回复,附前后对比:环放大到 1.9 倍,其他地方没动,花了 $0.69 的 API 等价用量(官方 Lab MCP 是 $0.73)。
同一台机器上,手机扫码还能用 AR Quick Look 看模型,只读链接 15 分钟过期。这条链路的价值不在于界面,而在于反馈终于变成了结构化输入,而不是一段「提手有点小」的复述。
十、五条能搬走的设计
- 规则不是提示词,是带编号的约束。 31 条铁律可以互相引用(「见 rule 26」),可以被 CI 检查(
verify_docs.py验证每条被引用的规则真的存在、且说的是被引用的那件事)。 - 确定性的活交给确定性的工具。 边能不能闭合、UV 有没有重叠、壁厚够不够,这些不需要模型判断。模型判断这类事情时只能靠印象,而印象正是不可复现的部分。
- 把评价权和创作权分开。 生成者不给自己签字。这条可以直接搬到代码、文档、PPT 的生产链上。
- 把失败也发表出来。 3.0 在某条 brief 上输给 2.2.0,仓库把这一行留在表里;基准测试的波动范围也写在旁边。这比多一个漂亮数字有用。
- 成本要能被记账。 每一次跑都报 API 等价开销,然后才轮到你判断「多花的 40% 值不值」。
十一、局限
按重要性排:
- 成本翻倍是真的。 单件资产从 $4–6 涨到 $9–14;整轮基准从 $54 涨到 $76。审核轮次是这套流程里最贵的一环。
- 分数会骗人,作者自己承认。 形状分只比轮廓,不比材质和细节;同一条 brief 的波动 ±0.02–0.03,比多数改进都大。
- 许可证有硬边界。 UniMate 权重 CC BY-NC(非商用);Hunyuan3D 的许可证明确排除欧盟、英国、韩国,所以 kiln 只在用户点名时才用;TRELLIS.2 本体是 MIT,但它用的背景移除 RMBG-2.0 是 CC BY-NC、图像编码器 DINOv3 走 Meta 的自有许可。
- 打印只覆盖 FDM 装饰件。 树脂、支撑、摆放方向、多材料,全在范围外。
- 质量仍要人看最后一眼。 审核者也是模型;两个审核者对色调的判断就能吵起来,灯笼那 8 轮就是这么耗掉的。
- 它绑定 Claude Code 与 Blender。 换 Agent、换 DCC 软件都得重写这套 SKILL。
十二、我的判断
kiln 值得读的地方,不是它能把照片变成模型——这件事 2026 年已经有很多人在做。它值得读的地方是:它把「AI 生产」拆成了可以被检查、被记账、被追责的步骤,然后老老实实公布每一步的价格。
我尤其认同两个设计。一个是把审核者做成独立 Agent 并强制换人:这是把软件工程里的 code review 搬进了 3D 生产,而且它解决了 code review 里最难的那部分——评审者不该是作者。另一个是把「不知道」写在明处:哪些数字是量的、哪些是假设、哪条 brief 输了,全在表里。
如果要判断这套方法能不能迁移,我会看三个指标,而不是看 demo 图:同一份 brief 重跑五次的分数分布、审核轮次抓到的缺陷数是否随轮次下降、以及单件成本在多少件资产之后开始摊薄。这三个数,kiln 已经给了一个可复现的模板。
项目与资料
- GitHub:elithril/blender-kiln(MIT,© Nicolas Dolphens)
- 技能定义:plugin/SKILL.md(31 条 iron rules)
- 基准与评分方法:docs/benchmarks.md
- 审核轮次:references/review-rounds.md
- 引用:3DCodeBench, arXiv:2606.01057
本文数据取自仓库 README、plugin/SKILL.md、docs/benchmarks.md 与 review-rounds 参考文档;所有分数与开销为作者在 Blender 5.2.2、Claude Opus 5.5 上的单次运行结果,随版本与模型变化。
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- CineCode:每一帧都是时间的纯函数,所以电影可以被检查
- OhMyGame:AI 生成游戏不难,难的是让它自己发现游戏跑不起来
- GPT-2 的一次前向:一条 768 维的向量,被改写 12 次,变成 50257 个分数
- SAELens:重建得越准,特征越不一定是真的
- TokenEconomizer:Coding Agent 的成本按仓库累积,不按任务计价
- Transformer Explainer:把 GPT-2 塞进浏览器,让模型边算边解释自己
- Boubou:本地语音 AI 缺的不是模型,是一层能借给全屋的运行时
- Hy-MT2:把翻译拆成语言家族分头训练,再蒸馏回一个模型
- NNsight:把干预写进前向传播,让同一段代码在 405B 模型上跑
- Safetensors:用 8 个字节和一段 JSON,重新设计大模型的权重文件