ARC 1.0:让 AI Agent 自己决定用哪个模型、想多深、在哪跑
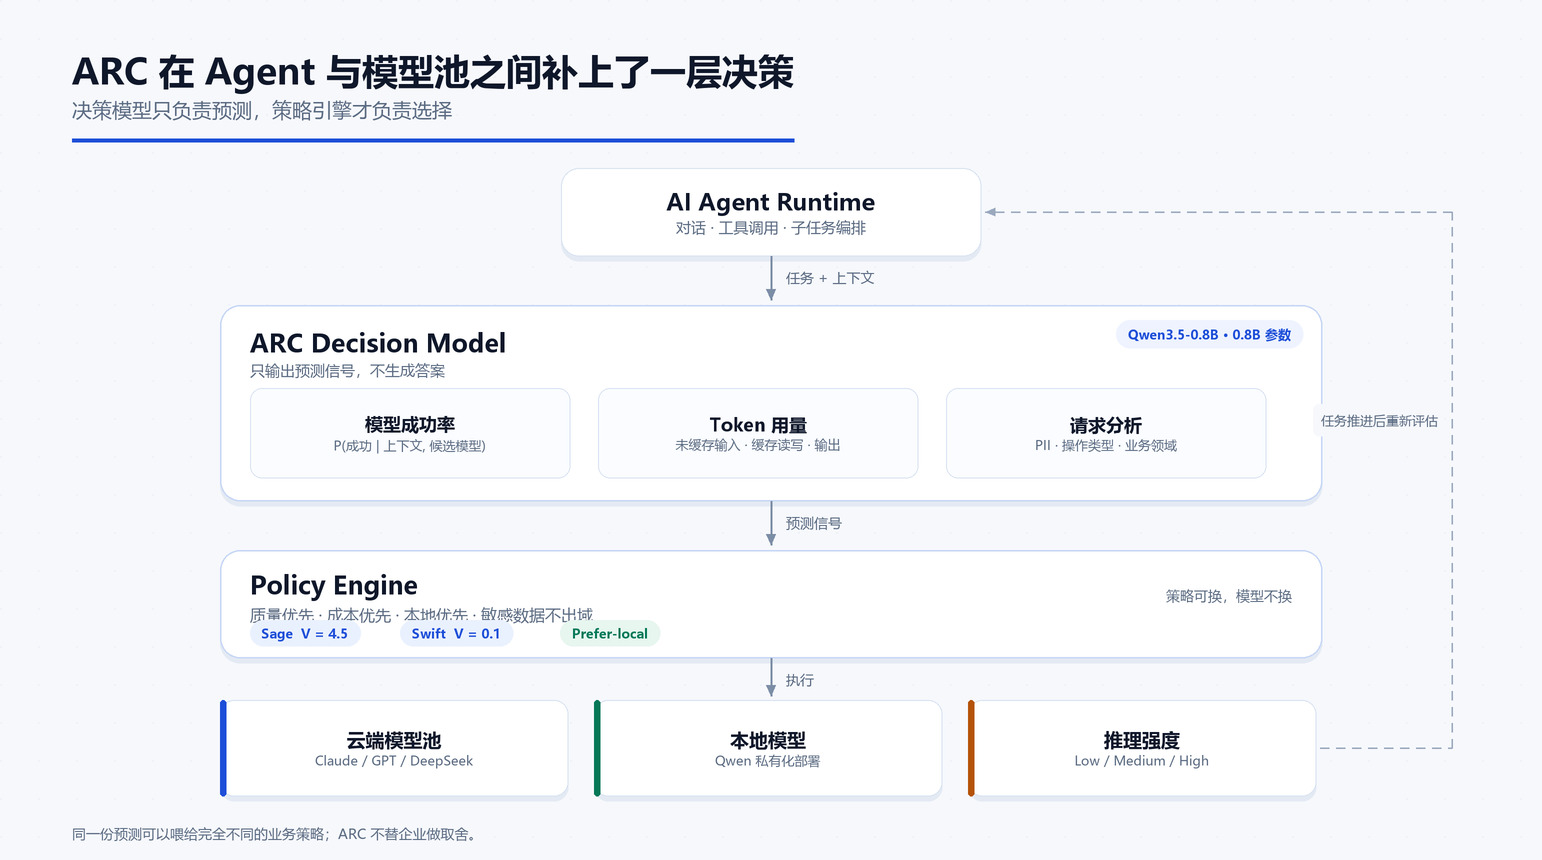
图为本文绘制:ARC 位于 Agent 与模型池之间,只输出预测信号,选择权仍在应用侧。
一个团队同时接入了 Claude、GPT、DeepSeek、Qwen 和 GLM。第一天大家很开心:能力互补,价格有梯度,私有化也有退路。
第一个月结束,问题浮出水面。
默认模型设成最强的,账单翻了三倍,其中一半请求只是把一段文案改得更通顺;默认模型设成最便宜的,复杂重构任务的失败率上升,重试两次之后反而更贵;安全团队要求包含手机号的请求不能出域,工程团队在入口加了一层关键词过滤,误杀率居高不下。
这三件事看起来是选型、成本、合规三个问题。但在系统层面,它们是同一个问题:
当前这一步,应该把任务交给谁、让它想多深、在哪儿执行。
ARC 1.0 想解决的正是这个问题。它的全称是 Adaptive Routing Controller,自适应路由控制器,由 Rayline 发布在 Hugging Face 上。和常见的模型网关不同,它不代理请求,也不生成答案——它是一个经过训练的决策模型,输出的是预测信号,而不是某个模型的名字。
一、路由的本质是预测,不是查表
过去几年,“模型路由”在工程上通常意味着三件事:关键词匹配、规则表,或者一个轻量分类器。
这套做法能工作的前提是:任务类型可枚举、模型能力稳定、价格不变。三个前提现在都在松动。
任务类型不可枚举。 同一个“帮我修个 bug”的请求,可能是改一个拼写错误,也可能是排查五个模块之间的竞态条件。关键词只能看到字面,看不到上下文里已经试过什么、失败在哪里、还剩多少预算。
模型能力不是静态排名。 同一个模型,换一种语言、换一种工具调用格式、上下文从 8K 涨到 200K,成功率都会变。用一份固定榜单决定所有请求,等于假设这些变量不存在。
候选集和价格一直在变。 新增一个供应商、上线一个本地模型、缓存价格调整,规则表就得重写。规则越多,维护成本越高,最后没人敢动。
所以路由真正需要的输出不是“用 Model A”,而是两个数:这个模型在当前上下文下完成任务的概率,以及这次调用大概要花多少钱。
有了这两个数,“选谁”才变成一个可以被业务目标定义的问题,而不是一条拍脑袋的 if-else。
二、ARC 是什么:把预测和策略拆开
一句话概括:ARC 是一个输出决策信号的预测模型,不是一个替你做决定的黑盒。
它读入对话上下文、任务状态、候选模型清单和价格配置,输出一组信号:
- 每个候选模型完成当前任务的成功概率;
- 预计的 Token 消耗;
- 是否需要提高推理强度;
- 请求是否包含敏感个人信息;
- 请求属于什么操作类型、什么业务领域;
- 是否应该优先使用本地模型;
- 开发者自定义问题的答案概率。
这里有一个非常重要的设计选择:预测与决策分离。
ARC 只回答“如果选 A,成功率大概多少、成本大概多少”,不回答“所以应该选 A”。选谁,由应用侧的策略引擎决定。
举个具体的例子。假设 ARC 对三个候选模型给出这样的预测:
Model A:  成功率 95%   预计成本 $0.08
Model B:  成功率 87%   预计成本 $0.01
Model C:  成功率 65%   预计成本 $0.002
一个重视交付质量的团队会选 A;一个跑批量分类、错了也能重跑的团队会选 B;一个做内部草稿工具的团队可能选 C。
同一份预测,可以喂给三套完全不同的策略。
这是我认为 ARC 在架构上最值得借鉴的一点:它把“世界会怎样”和“我们想要什么”分开了。前者适合用模型去学习,后者适合用代码去表达。混在一起,就会得到一个既不准、又改不动的系统。
三、三个模块:预测、选择、时机
ARC 的架构可以拆成三部分。
1. Decision Model:只负责预测
这是那个 0.8B 的模型。它不生成自然语言答案,只做分类、回归和打分:成功率、Token 用量、推理档位收益、PII 类型、操作与领域标签,以及自定义问题的选项概率。
它的输出是结构化的,可以直接进入策略计算——这一点和“让一个大模型用自然语言告诉你该选谁”有本质区别。后者无法审计,也无法稳定复现。
2. Policy Engine:负责把预测变成选择
策略引擎是普通代码,不是模型。它拿到预测信号后,结合业务约束做决策:
- 质量优先:选期望效用最高的模型;
- 成本优先:在成功率低于阈值时直接排除,再选最便宜的;
- 合规优先:PII 命中或数据分级不满足时,只允许本地模型;
- 预算约束:当日预算消耗超过 80% 后,自动降级到更便宜的候选。
这些规则不应该被训练进模型里。 业务策略会变,价格会变,合规要求会变,而模型权重不会跟着变。把策略留在代码里,改一次配置就能生效;训练进模型里,就要重新标注、重新训练、重新评估。
3. Timing Controller:决定什么时候重新决策
第三个模块最容易被忽略,但它决定了系统的实际表现。
ARC 不会在每次 token 生成时都重新决策。它定义了一组触发时机:
- 新任务开始时;
- 用户发来新消息时;
- Agent 启动一个新的子任务时;
- 上下文被压缩或摘要时;
- 缓存失效时;
- 每次实际调用模型前(可选,取决于开销预算)。
这些时机有一个共同点:上下文发生了足够大的变化,之前的决策可能不再成立。
比如一个任务开始时判断“用轻量模型就够”,执行到第三步发现需要跨文件分析依赖关系,这时候上下文已经变了,继续沿用旧决策就是错误的。Timing Controller 的价值,是让“重新评估”成为系统的一等公民,而不是靠开发者记得手动加一行判断。
需要说明的是,重新决策本身也有成本,而且不只是钱:它会增加延迟、消耗上下文窗口、可能引入决策抖动。所以触发时机的设计,本质上是在“决策新鲜度”和“决策开销”之间做权衡。
四、六种信号,各自回答什么问题
1. 成功率预测:不是排行榜,是条件概率
这是 ARC 最核心的能力。给定当前上下文和候选模型,它输出每个模型完成任务的概率。
关键要理解的是:这个概率不是模型的永久能力评分,而是针对当前任务、当前上下文的估计。
同一个模型,在“翻译一段产品文案”上可能拿到 0.97,在“分析一个 Go 项目的并发安全问题”上可能只有 0.72。换一个上下文、换一种语言、换一个代码库,数字又会变。
这让模型路由从“静态能力排名”变成了“上下文感知的动态评估”。但也带来了新的问题:预测概率是否校准?如果 ARC 说 0.9,实际成功率是不是真的接近 90%?这需要企业用自己的业务数据持续验证,而不能只看模型卡上的数字。
2. Token 用量预测:把成本算在调用之前
成本不只看单价,还看用量结构。ARC 把 Token 拆成四段:
| 类型 | 含义 |
|---|---|
| Uncached Input | 未命中缓存的输入 Token |
| Cache Reads | 从缓存读取的 Token |
| Cache Writes | 写入缓存的 Token |
| Output | 模型生成的输出 Token |
为什么要拆这么细?因为四段的单价可能差一个数量级。假设某模型定价为:未缓存输入 $2/M、缓存读取 $0.2/M、缓存写入 $2.5/M、输出 $10/M。
一次调用用了 5K 未缓存输入、15K 缓存读取、2K 缓存写入、1K 输出,成本是:
5K  × $2.0/M  = $0.010
15K × $0.2/M  = $0.003
2K  × $2.5/M  = $0.005
1K  × $10/M   = $0.010
                 ------
总计            $0.028
如果偷懒,把所有输入都按 $2/M 算,会得到 $0.054,几乎翻倍。差别就来自缓存这一段。
更重要的设计是:价格不固化在模型里。 价格由应用在运行时提供,ARC 只预测用量。这样供应商调价、换计费方式、加缓存折扣,都不需要重新训练成本预测器。这是一个很务实的工程决定——把会变的东西放在外面,把稳定的东西放在里面。
3. 推理强度控制:同一个模型,想 10 秒和想 10 分钟是两种产品
传统路由只回答“用哪个模型”。ARC 多问了一层:“这个模型应该用多少推理能力?”
同样是 Claude,翻译一句英文可以用最低档推理,分析复杂算法要用高档推理。模型没变,成本和质量的组合变了。
这意味着模型选择和推理控制可以是两个独立的决策维度:
| 任务 | 模型 | 推理强度 |
|---|---|---|
| 翻译一句英文 | Model A | Low |
| 分析一段复杂算法 | Model A | High |
| 重构大型软件架构 | Model B | High |
把这两个维度合在一起,可选的方案从“几个模型”变成“几个模型 × 几档推理”,策略空间大了一个量级。当然,搜索空间变大也意味着更难评估——这是下一节效用函数要处理的问题。
4. PII 检测:一个闸门,不是一套脱敏系统
ARC 能识别请求中是否存在个人信息,以及属于哪一类:姓名、邮箱、电话号码等。
它的典型用法是做路由闸门:
用户请求
    │
    ▼
PII 检测
    │
    ├── 命中 ──→ 只允许本地模型
    │
    └── 未命中 ─→ 按成本与质量正常路由
这里必须说清楚边界:PII Head 只判断“有没有、是哪类”,不负责定位具体片段,也不负责脱敏。 它不能替代一套完整的数据防泄漏系统。真正落地时,权限控制、字段级脱敏、审计日志、供应商白名单,一个都不能少。
5. 请求分类:给策略提供分组的依据
ARC 会对请求做操作类型和业务领域的多标签分类。比如:
请求:帮我分析这段 Python 代码,并检查其中的数据库安全问题。

Operation:
- Code Analysis
- Security Review

Domain:
- Programming
- Database
- Security
多标签很关键。真实任务很少只属于一个类别,硬塞进单标签会丢信息。有了这些标签,策略就可以做更细的区分:代码任务偏好代码能力强的模型,金融任务只走经过审核的供应商,安全审计任务强制高档推理。
6. 自定义决策信号:把 ARC 变成通用的判断器
这是 ARC 最容易被低估的扩展能力。
开发者可以提供一个问题加一组候选答案,让 ARC 输出每个答案的概率:
Question: 当前任务是否需要更强的模型?
Options:  Yes / No
Output:   Yes 0.87 / No 0.13
也可以问别的问题:
- 当前任务是否需要联网检索?
- 是否需要调用数据库?
- 是否适合交给本地模型?
- 是否需要人工审核?
- 是否应该拆成多个子 Agent 并行?
这让 ARC 不再局限于“选模型”这一个问题,而变成一个可编程的决策信号生成器。对 Agent 平台来说,这个定位比“路由器”大得多。
不过要提醒一句:自定义问题的质量,取决于微调数据覆盖了多少类似场景。问一个训练时没见过的判断,输出的概率可能只是语言模型的直觉,而不是经过校准的估计。
信号汇总
| 信号 | 回答的问题 | 典型用途 |
|---|---|---|
| 成功率 | 这个模型能做成吗? | 候选筛选、效用计算 |
| Token 用量 | 这次调用大概花多少? | 成本预估、预算控制 |
| 推理强度 | 需要想多深? | 质量与成本的二次调节 |
| PII | 数据能不能出去? | 合规闸门、本地优先 |
| 请求分类 | 这是什么类型的任务? | 分组策略、模型白名单 |
| 自定义问题 | 业务关心的判断是什么? | 人工审核、工具调用决策 |
五、模型内部:一个小模型,六个预测头
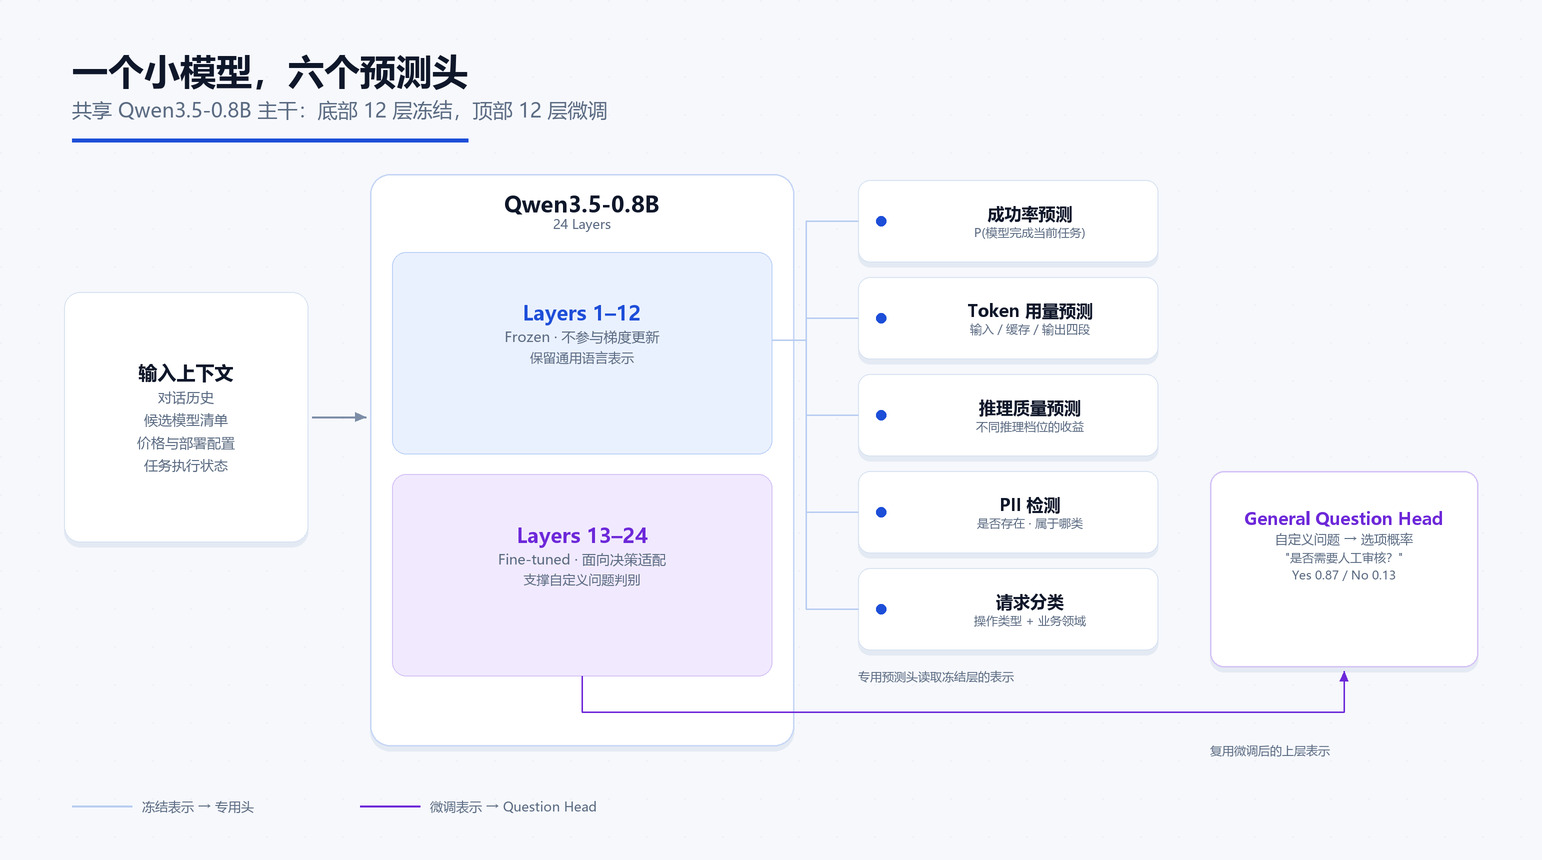
图为本文绘制:共享 Qwen3.5-0.8B 主干,底部 12 层冻结、顶部 12 层微调,分别支撑专用预测头和通用问题头。
ARC 1.0 不是一个从零训练的大模型。它基于 Qwen3.5-0.8B,24 层,采用共享 Backbone 加多个预测头的结构。
底层 12 层保持冻结。 这一部分提供通用的语言表示,专用预测头直接读取它的输出,负责成功率、Token 用量、推理质量、PII 和请求分类。
上层 12 层经过微调。 这一部分主要服务通用 Question Head,让开发者可以提出自定义问题并得到选项概率。
这个切法有明确的工程理由:
- 省。 六个任务共享一次前向传播,不需要为每种能力维护一个完整模型。对路由这种高频、低延迟的调用来说,这是硬约束。
- 稳。 冻结底层可以保留预训练学到的通用表示,减少在小规模决策数据上过拟合的风险。
- 灵活。 把最需要适配业务的部分放在上层,微调成本低,迭代快。
但它也有代价,而且这些代价会直接体现在使用体验上:
底部表示未必包含“成功”这个概念。 Qwen 的预训练目标不是预测任务成功率,冻结层里编码的是语言和语义特征,不是业务上的可行性判断。专用头要从这些特征里“读出”成功率,本质上是在做一个有信息损失的映射。
头部的容量有限。 一个小模型加几个轻量头,能捕捉的交互模式是有限的。任务越接近训练分布,预测越准;越偏离,越容易给出过度自信的分数。
0.8B 不是能力来源,是成本约束下的折中。 它的价值在于足够便宜、足够快,可以放在每次调用的热路径上;而不是在于它比大模型更懂任务。
理解这一点,就不会对它有不切实际的期待:它是一个廉价的先验,不是一个可靠的神谕。
六、决策算法:把质量和成本放到同一个尺度
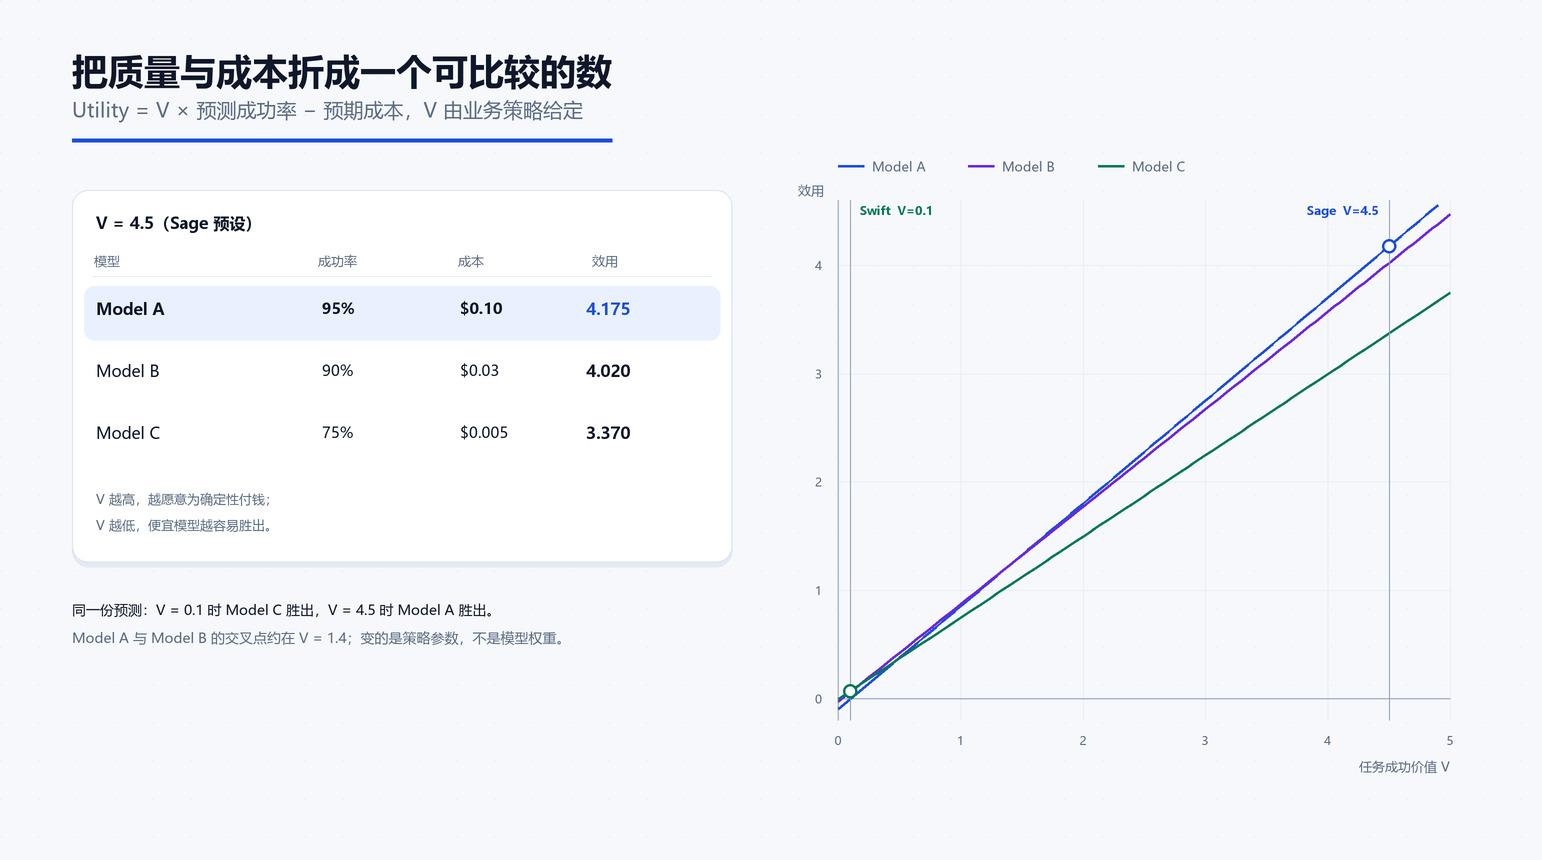
图为本文绘制:同一份预测在不同 V 下会选出不同模型;交叉点来自线性效用函数的算术推导。
ARC 给出的效用函数非常直观:
Utility = V × Predicted Success − Expected Cost
其中 V 是“任务成功值多少钱”,Predicted Success 是预测成功率,Expected Cost 是预计调用成本。策略引擎选择效用最高的候选。
假设三个模型:
| 模型 | 成功率 | 预计成本 | 效用(V = 4.5) |
|---|---|---|---|
| Model A | 95% | $0.10 | 4.175 |
| Model B | 90% | $0.03 | 4.020 |
| Model C | 75% | $0.005 | 3.370 |
计算过程:
A = 4.5 × 0.95 − 0.10 = 4.175
B = 4.5 × 0.90 − 0.03 = 4.020
C = 4.5 × 0.75 − 0.005 = 3.370
在 V = 4.5 时选 A。但 V 稍微一变,结论就会翻转:
- A 与 B 的交叉点在
V = (0.10 − 0.03) / (0.95 − 0.90) = 1.4。V 低于 1.4,B 更优。 - B 与 C 的交叉点在
V = (0.03 − 0.005) / (0.90 − 0.75) ≈ 0.167。V 低于 0.167,C 更优。
也就是说,同一组预测,只改一个标量 V,最优解可以从 A 一路滑到 C。 这就是为什么 ARC 把 V 放在策略层,而不是模型层。
项目提供两档预设:
| 配置 | V | 设计目标 |
|---|---|---|
| ARC Sage | 4.5 | 更重视任务成功 |
| ARC Swift | 0.1 | 更重视成本控制 |
两档配置使用同一个路由模型,区别只在策略参数。这也解释了为什么同一个 ARC 可以在不同团队里表现完全不同——不是模型变了,是“成功值多少钱”变了。
这个公式的优点和局限
优点很明确:线性、可解释、可调参、可审计。任何一次路由决策都能还原成“哪个概率、哪个价格、哪个 V”,出了问题能查。
局限也同样明显:
它是单步短视的。 公式只看当前这一次调用,不考虑失败后的重试成本、不考虑这一步失败会不会让后续五步全部作废。一个更完整的效用应该包含失败惩罚项,比如 P_fail × 返工成本。
它假设成本可以线性叠加。 现实中还有速率限制、并发配额、冷启动延迟,这些不是钱,但同样是成本。
V 很难标定。 “一次成功的代码重构值 4.5 美元”这种话,财务和工程都说不出口。实际落地时,V 往往是通过预算反推出来的:给定月度预算和质量下限,解出一个能接受的 V。
它没有探索机制。 新模型刚加入时,历史数据少,预测方差大,效用函数会系统性地低估它,导致它永远拿不到足够的样本。这是典型的 cold start 问题,需要额外的探索策略,而不是靠公式本身解决。
还有一点值得单独说:Prefer-local 不是效用函数的一部分,而是一个硬约束。
数据不出域、必须本地部署,这类要求不能用“多花点钱”来交换。所以它被实现成阈值判断:本地模型成功率达到阈值就直接用,达不到才走云端。这是策略层的约束,不是效用项。
七、Prefer-local:本地与云端的协同
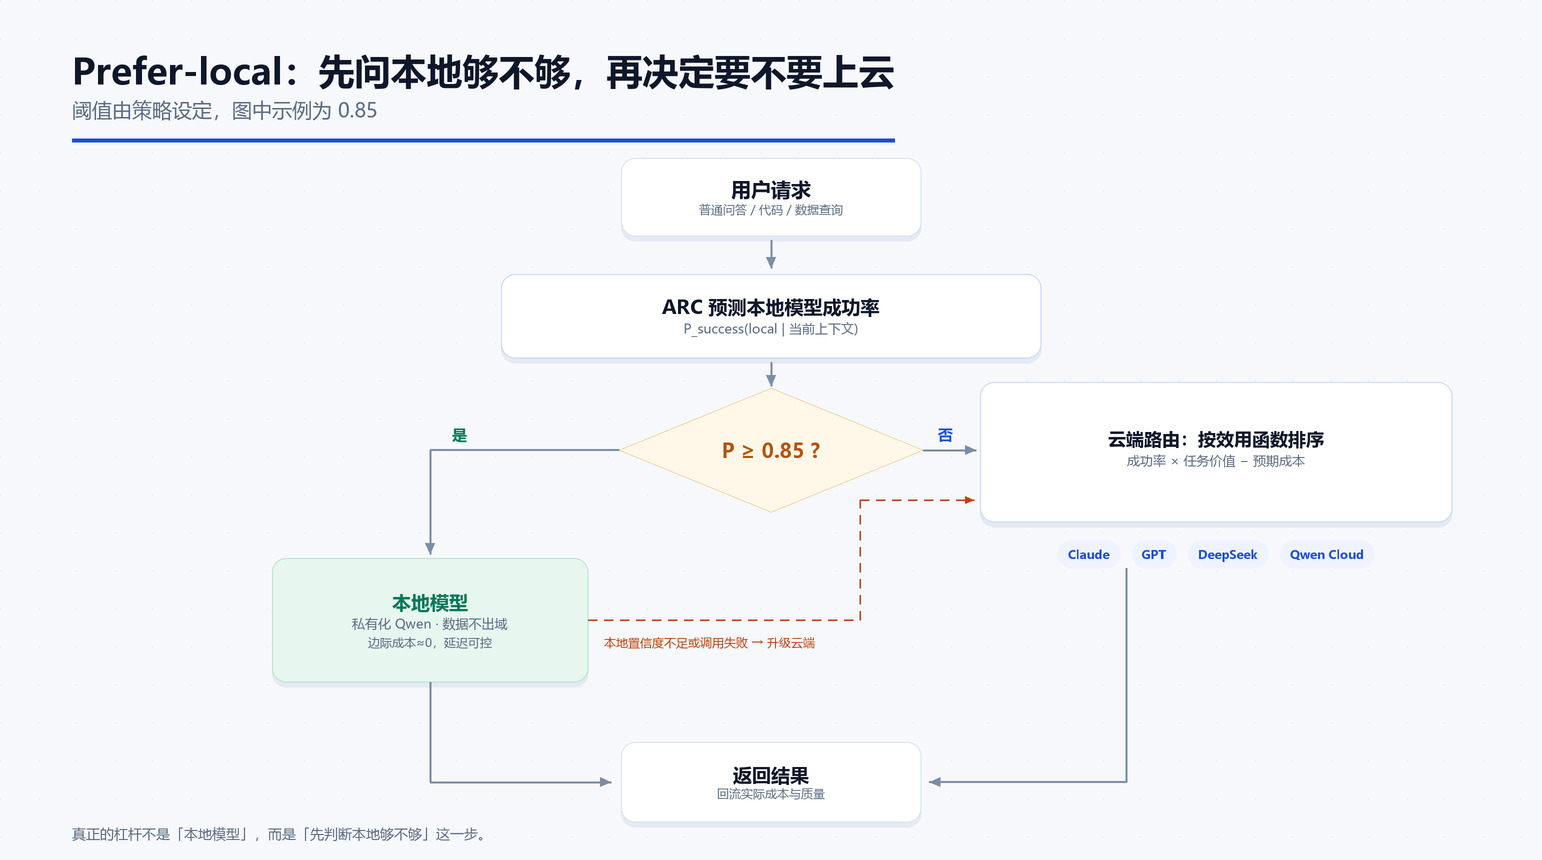
图为本文绘制:先预测本地成功率,达到阈值走本地,否则进入云端路由;失败时还有一条升级路径。
企业部署本地模型,长期卡在两个问题上:本地模型能力不够强;全部走云端又贵、又有数据外流风险。
ARC 的思路是把两者串起来,而不是二选一:
- 请求进来,先预测本地模型的成功率;
- 达到阈值(比如 0.85),直接走本地;
- 达不到,进入云端路由,在候选模型里按效用选一个;
- 本地调用失败或置信度不足,升级到云端重试。
这个流程的价值不在于“用了本地模型”,而在于把“本地够不够”变成了一个可计算的判断。以前这件事靠人工配置:这类请求走本地,那类请求走云端。规则一多就维护不动,而且无法应对任务中途的变化。
项目技术报告给出了一个混合部署实验:在六个基准测试上,边缘加云端的混合方案达到 Opus 5.5 质量的 97.5%,成本降低 92.9%。这个数字基于特定的 DeepSeek V4.1 Flash 与多台 NVIDIA DGX Spark 部署配置,不能直接外推到任意本地模型部署。
落地时真正难的地方
阈值标定。 0.85 不是通用答案。代码补全任务可能 0.7 就够用,金融合规问答可能要 0.95。阈值应该按业务域分别标定,并且用线上数据持续校准。
决策抖动。 如果本地成功率长期在阈值附近波动,请求会一会儿走本地、一会儿走云端,成本和延迟都不可预测。工程上通常要加迟滞(hysteresis):上调阈值和下调阈值不同,避免来回横跳。
本地队列。 本地模型的吞吐是有限的。成功率预测再准,如果本地 GPU 已经排满,用户感受到的还是超时。所以本地优先策略必须和队列深度、超时预算一起考虑。
决策日志。 每次路由都要记录:预测值、实际结果、真实成本、最终选择。没有这份日志,就无法回答“路由到底省了多少钱、有没有变差”。
升级成本。 本地失败后再走云端,等于付了两次成本、等了两次延迟。所以升级路径要设置预算上限,不能无限重试。
八、实验结果怎么读
项目公布了几组评估数据。以下数字均来自项目公开的模型卡和技术报告,属于项目方报告的结果。
1. ARC Sage 与 Opus 5.5 对比
| Benchmark | Opus 5.5 | ARC Sage | ARC 成本占比 |
|---|---|---|---|
| DeepSWE | 69.9% | 68.7% | 7% |
| Terminal-Bench 2.1 | 91.0% | 92.4% | 58% |
| SWE-Atlas QA | 61.6% | 62.4% | 13% |
| MMMU-Pro Vision | 82.2% | 82.9% | 39% |
| GPQA Diamond | 89.9% | 94.1% | 21% |
| Tau3 Banking | 42.8% | 33.2% | 17% |
这张表比“平均分”有信息量得多。
DeepSWE 上只花 7% 的成本拿到接近的分数,说明大部分软件工程任务确实可以由更便宜的模型完成。Terminal-Bench 上成本占比 58%,说明这类任务需要大量调用强模型——路由不是一味省钱,而是在该花钱的地方花钱。
Tau3 Banking 是明显的短板:42.8% 掉到 33.2%。这类任务依赖多轮工具调用和领域知识,候选池里如果没有足够强的模型,路由再怎么选也补不回来。这恰恰说明路由的能力边界:它只能在候选集里做分配,不能凭空创造能力。
2. 与其他路由方案的对比
项目还公布了 RouteBench 的 Model Routing Index:
| Router | DeepSWE | SWE-Atlas QA | Terminal-Bench | Tau3 Banking | MMMU-Pro Vision | Mean |
|---|---|---|---|---|---|---|
| ARC Sage | 9.6 | 9.1 | 10.0 | 7.7 | 10.0 | 9.3 |
| ARC Swift | 9.7 | 8.5 | 10.0 | 7.5 | 10.0 | 9.1 |
| Pareto | 9.9 | 9.1 | 10.0 | 8.0 | 8.9 | 9.2 |
| OpenRouter Auto | 8.8 | 8.6 | — | 9.0 | 8.8 | — |
| Fugu Max | 4.7 | 7.0 | 8.2 | 6.5 | 9.0 | 7.1 |
需要克制地读这张表。
第一,MRI 是一个综合指标,同时考虑质量、速度和成本,不同权重会得出不同排名。它适合看整体水平,不适合推导单个场景的结论。
第二,ARC Sage 的均值 9.3 和 Pareto 的 9.2 只差 0.1,在这个精度上不应该宣称“领先”。
第三,缺失的单元格不能当成 0 分,也不能据此认为 ARC 在所有情况下都优于其他路由系统。
3. PII 检测与请求分类
| 能力 | 指标 | 完整上下文 | 最新消息 |
|---|---|---|---|
| PII Presence | ROC-AUC | 0.919 | 0.960 |
| Operation | F1 | 0.775 | 0.787 |
| Domain | F1 | 0.834 | 0.820 |
一个有趣的细节:PII 检测在“只看最新消息”时反而更准(0.960 vs 0.919)。这符合直觉——历史上下文里可能包含之前已经处理过的敏感信息,把它们一起送进分类器会引入噪声。这也提示了一个工程做法:不同信号可以用不同的上下文窗口,不必强行统一。
九、怎么接入:托管服务与开源权重
ARC 提供两种使用方式。
1. 托管服务
如果只想先验证路由效果,可以用 Rayline 提供的托管模型:
arc-sage-1.0
arc-swift-1.0
通过官方文档接入现有 Agent 即可,不需要自己部署决策模型。
2. 开源权重
ARC 1.0 的权重已经公开在 Hugging Face 上,包含:
- Encoder;
- Model Routing Heads;
- Reasoning Heads;
- Token Usage Heads;
- PII Detection Head;
- Request Classification Head;
- General-purpose Question Head。
但有一个必须提前说明的限制:不能直接用标准 vLLM 命令加载这个模型。
ARC 使用自定义模型架构 ArcImagePolicyForPooling。项目提供的 vLLM ARC 插件仍在开发中,目前主要支持 Encoder 集成和 Stage-1 Scoring,完整的端到端推理、决策策略 API 和调用方接口尚未全部实现。
所以现实的建议是:现阶段想要完整能力,优先用官方托管服务,或者已经集成好的运行时;不要假设“下载权重 + 起一个 vLLM 服务”就能得到完整的路由系统。
一个典型的集成形态
把 ARC 放进 Agent 主循环,逻辑大致是这样:
for each step in agent_loop:
    signals = arc.predict(context, candidates, price_book)
    plan    = policy.select(signals, budget, residency)
    result  = runtime.invoke(plan.model, plan.reasoning)
    policy.observe(result)      # 记录真实成本与成败,用于校准
四个角色各司其职:
- Model Gateway(如 LiteLLM):负责把请求送到正确的供应商,处理鉴权、重试、限流;
- Decision Engine(ARC):负责预测成功率、成本和请求属性;
- Policy Engine:负责把预测转成具体选择;
- Runtime Manager(如 Raydock):负责 Agent 与本地、云端模型之间的连接和生命周期。
这个分层的好处是每一层都可以独立替换。换网关不影响策略,换策略不影响模型,换模型不需要改 Agent 代码。
十、边界:ARC 不能替你做的几件事
第一,预测不等于事实。 成功率是一个估计值,会随着模型版本、任务分布、上下文长度漂移。企业需要用自己的业务数据持续做校准,而不是把模型卡上的数字当成 SLA。
第二,新模型有冷启动问题。 候选池里新增一个模型,ARC 对它的预测缺乏依据,前期可能系统性低估或高估。模型候选集需要被当作一份需要维护的资产,而不是一个随便追加的列表。
第三,路由本身有成本。 每次决策都要读上下文、跑前向、算效用。对特别简单的请求,这笔开销可能超过省下的模型费用。合理的做法是分级:简单请求走固定路由,复杂请求才进入完整决策流程。
第四,本地部署仍有硬件和运行时要求。 ARC 自己是 0.8B 量级,但完整的决策链路还包括模型服务、缓存、Agent 运行时和监控。部署一个小模型,不等于自动获得一套本地与云端调度能力。
第五,安全不能只靠 PII 分类。 PII 检测是数据安全体系里的一个信号,不是全部。权限、脱敏、审计、供应商准入,仍然要单独建设。
第六,你需要一套自己的评估集。 这是最容易被跳过、也最不应该跳过的一步。没有自己的任务集和成本账本,就无法回答“上了路由之后,质量掉了多少、钱省了多少”。别人的 benchmark 只能证明方向可行,证明不了你的场景能省。
十一、和 LiteLLM、Semantic Router 是什么关系
这是理解 ARC 定位的关键。三者经常被放在一起比较,但它们其实不在同一层。
| 维度 | LiteLLM | Semantic Router | ARC |
|---|---|---|---|
| 核心定位 | 统一模型网关 | 智能路由基础设施 | 学习型决策模型 |
| 模型接入 | 强 | 强 | 依赖外部运行时 |
| 规则路由 | 支持 | 支持 | 通过策略实现 |
| 请求分类 | 可集成 | 支持 | 专用预测头 |
| 成功率预测 | 需要额外机制 | 可集成评分机制 | 核心能力 |
| Token 成本预测 | 侧重实际用量与成本管理 | 可集成 | 专门预测 |
| 推理强度控制 | 依赖模型与配置 | 可集成 | 核心能力之一 |
| 本地与云端协同 | 可以实现 | 可以实现 | 提供 Prefer-local 决策 |
它们不是替代关系,而是互补关系:
- LiteLLM 解决“能不能把请求发出去、发得稳”;
- ARC 解决“这一步该发给谁、发多贵的”;
- Semantic Router 解决“按什么规则把请求分到哪条路径”;
- Raydock 解决“Agent 和本地、云端模型之间怎么连”。
一句话:网关负责连通性,决策层负责判断力。 把网关当大脑,它会给出昂贵的平庸;让大脑去干网关的活,它会变得又慢又脆。
十二、结语:从调用模型到调度模型
ARC 1.0 最值得关注的地方,不是它用了 0.8B 的模型,而是它对 Agent 架构提出了一个新的分层:
过去:
用户请求 → 固定模型 → 答案

现在:
用户请求
   │
   ▼
理解任务与上下文
   │
   ▼
预测成功率与成本
   │
   ▼
评估推理需求
   │
   ▼
执行路由策略
   │
   ▼
选择本地或云端模型
   │
   ▼
执行任务
   │
   ▼
根据进展重新决策
这个变化意味着,一个成熟的 Agent 不应该只知道“怎么调用模型”,还应该知道:
- 什么任务该用什么模型;
- 什么时候需要更强的推理;
- 什么时候该省 Token;
- 什么时候该用本地算力;
- 什么时候该升级到云端;
- 什么时候该推翻之前的决策。
模型负责思考,Agent 负责执行,决策控制器负责决定“该怎么想”。
ARC 1.0 展示的正是这个方向。它不完美——预测会偏、成本会飘、候选集会变——但它把“模型路由”从一个配置问题,变成了一个可以训练、可以评估、可以持续优化的决策问题。
对正在搭建多模型 Agent 平台的团队来说,这比任何一个具体数字都更值得研究。
Raydock:github.com/rayline-ai/raydock
vLLM ARC:github.com/rayline-ai/vllm-arc
Enjoy Reading This Article?
Here are some more articles you might like to read next:
- Blender Kiln:AI 建模缺的不是生成能力,是交付前的度量
- CineCode:每一帧都是时间的纯函数,所以电影可以被检查
- OhMyGame:AI 生成游戏不难,难的是让它自己发现游戏跑不起来
- GPT-2 的一次前向:一条 768 维的向量,被改写 12 次,变成 50257 个分数
- SAELens:重建得越准,特征越不一定是真的
- TokenEconomizer:Coding Agent 的成本按仓库累积,不按任务计价
- Transformer Explainer:把 GPT-2 塞进浏览器,让模型边算边解释自己
- Boubou:本地语音 AI 缺的不是模型,是一层能借给全屋的运行时
- Hy-MT2:把翻译拆成语言家族分头训练,再蒸馏回一个模型
- NNsight:把干预写进前向传播,让同一段代码在 405B 模型上跑